#統計 おお! 統計学の講義でP値関数について解説する仲間が増えた。 その場合を #Julia言語...

黒木玄 Gen Kuroki@genkuroki
71 views
Apr 14, 2025
~1 min read
Advertisement
1
#統計 おお!
統計学の講義でP値関数について解説する仲間が増えた。
その場合を #Julia言語 で視覚化してみました。信頼区間はP値がα以上になるモデルのパラメータの範囲になる。
誰でも実行して遊べるColabノートブック
↓
colab.research.google.com/drive/1she_BKS…


統計学の講義でP値関数について解説する仲間が増えた。
その場合を #Julia言語 で視覚化してみました。信頼区間はP値がα以上になるモデルのパラメータの範囲になる。
誰でも実行して遊べるColabノートブック
↓
colab.research.google.com/drive/1she_BKS…
内場 崇之(Takayuki Uchiba)@utaka233
今日は講座『はじめての医療統計』の初回でした。p-値とはなにかをASA声明を基軸に解説し、信頼区間などの併用やp-値関数について説明しました。次回は例数設計や再現性についてお話をします。#すうがくぶんか
2
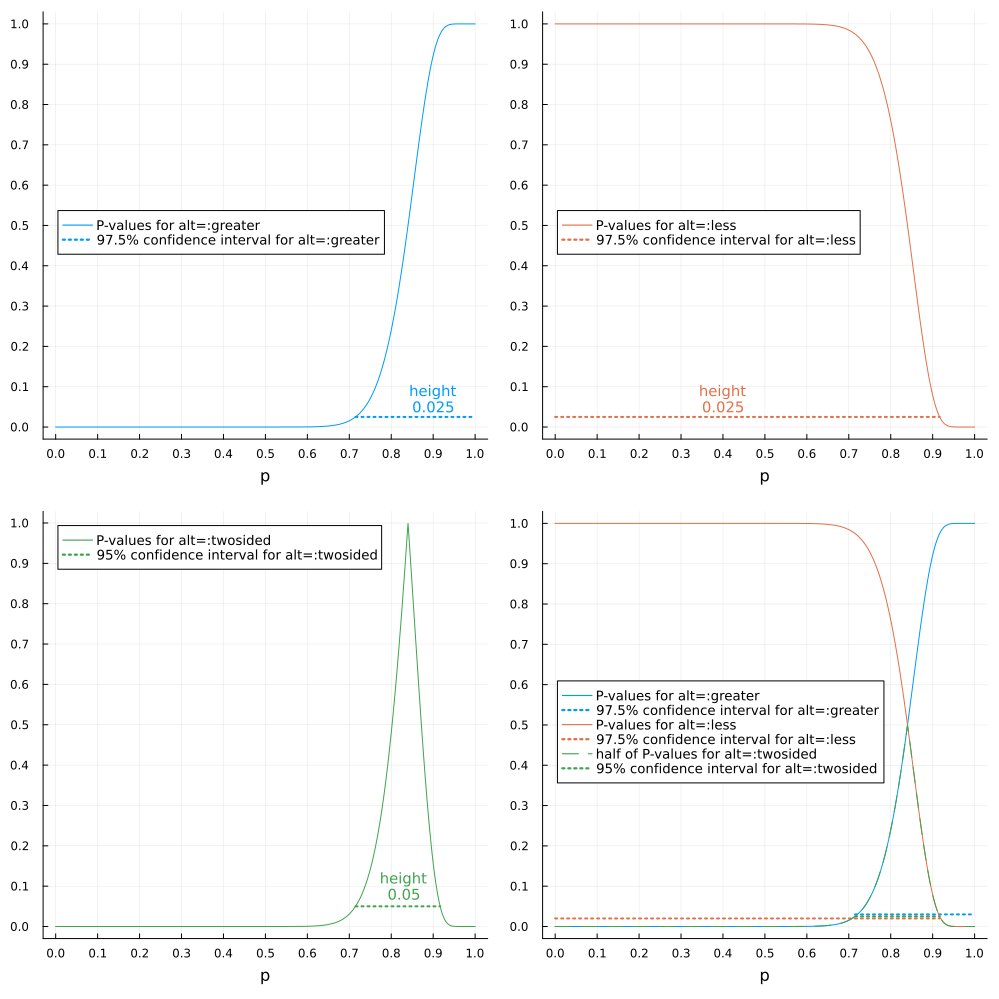
#統計 二項分布モデルの正規分布近似によるP値関数のグラフ。左側のグラフは片側P値関数達と両側P値関数の1/2倍の同時プロットで、右側のグラフは両側P値関数のプロット。
colab.research.google.com/drive/1she_BKS…
colab.research.google.com/drive/1she_BKS…
3
#統計
100(1-α)%信頼区間の定義は「P値≥αとなるパラメータの値の範囲」です。
95%両側信頼区間は、97.5%片側信頼区間達の共通部分になる。
片側P値関数達と両側P値関数の両方の__全体__を同時にプロットしているグラフは珍しいのでちょっと貴重かもしれません。
colab.research.google.com/drive/1she_BKS…
100(1-α)%信頼区間の定義は「P値≥αとなるパラメータの値の範囲」です。
95%両側信頼区間は、97.5%片側信頼区間達の共通部分になる。
片側P値関数達と両側P値関数の両方の__全体__を同時にプロットしているグラフは珍しいのでちょっと貴重かもしれません。
colab.research.google.com/drive/1she_BKS…
4
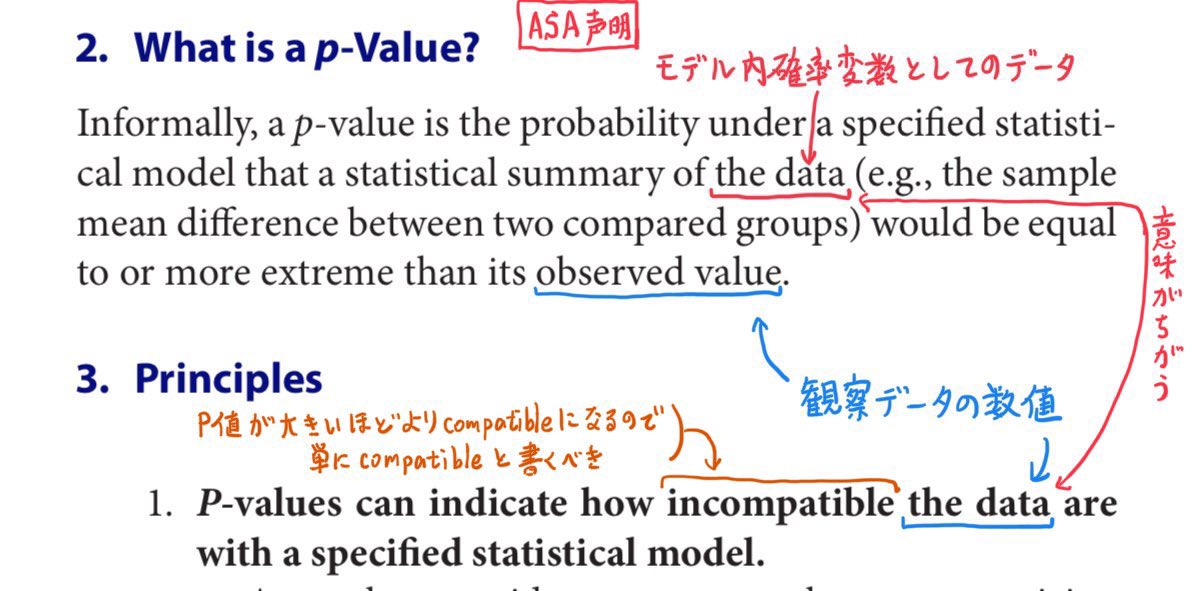
#統計 ASA声明 scholar.google.co.jp/scholar?cluste… でのP値の説明も添付画像のようになっているせいでそのままだとダメなので、講義で使う場合には注意が必要です。
直近の2つの"the data"の意味が異なることをきちんと説明しないと誤解させてしまいます。
あと"incompatible"は"compatible"に直したい。
直近の2つの"the data"の意味が異なることをきちんと説明しないと誤解させてしまいます。
あと"incompatible"は"compatible"に直したい。
内場 崇之(Takayuki Uchiba)@utaka233
今日は講座『はじめての医療統計』の初回でした。p-値とはなにかをASA声明を基軸に解説し、信頼区間などの併用やp-値関数について説明しました。次回は例数設計や再現性についてお話をします。#すうがくぶんか
5
#統計 ASA声明のように不快なP値の説明がなくて、クリアで内容的に一貫している解説にSander Greenlandさんの講演スライド
biostat.ucdavis.edu/sites/g/files/…
があります。
医療関係者はGreenlandさんに従えば統計を安全に使い易くなると思います。スライドの中に引用できる論文のリストがあります。
biostat.ucdavis.edu/sites/g/files/…
があります。
医療関係者はGreenlandさんに従えば統計を安全に使い易くなると思います。スライドの中に引用できる論文のリストがあります。
内場 崇之(Takayuki Uchiba)@utaka233
今日は講座『はじめての医療統計』の初回でした。p-値とはなにかをASA声明を基軸に解説し、信頼区間などの併用やp-値関数について説明しました。次回は例数設計や再現性についてお話をします。#すうがくぶんか
6
#統計 再現性の危機の主な原因がPハッキングの類の不正行為であるかのように語るミスリーディングな説明に注意。
次の論文の内容が科学的常識にフィットしていると思います。
scholar.google.co.jp/scholar?cluste…
Amrhein-Trafimow-Greenland 2019
副題:再現性を期待しなければ再現性の危機は存在しない
次の論文の内容が科学的常識にフィットしていると思います。
scholar.google.co.jp/scholar?cluste…
Amrhein-Trafimow-Greenland 2019
副題:再現性を期待しなければ再現性の危機は存在しない
内場 崇之(Takayuki Uchiba)@utaka233
今日は講座『はじめての医療統計』の初回でした。p-値とはなにかをASA声明を基軸に解説し、信頼区間などの併用やp-値関数について説明しました。次回は例数設計や再現性についてお話をします。#すうがくぶんか
7
#統計 二項分布モデルの下で
(alt=:greaterの片側P値)=(仮説「成功確率はp以下」とデータの数値の相性の良さ)
(alt=:lessの片側P値)=(仮説「成功確率はp以上」とデータの数値の相性の良さ)
(alt=:twosidedの片側P値)=(仮説「成功確率はp」とデータの数値の相性の良さ)
colab.research.google.com/drive/1she_BKS…

(alt=:greaterの片側P値)=(仮説「成功確率はp以下」とデータの数値の相性の良さ)
(alt=:lessの片側P値)=(仮説「成功確率はp以上」とデータの数値の相性の良さ)
(alt=:twosidedの片側P値)=(仮説「成功確率はp」とデータの数値の相性の良さ)
colab.research.google.com/drive/1she_BKS…
内場 崇之(Takayuki Uchiba)@utaka233
今日は講座『はじめての医療統計』の初回でした。p-値とはなにかをASA声明を基軸に解説し、信頼区間などの併用やp-値関数について説明しました。次回は例数設計や再現性についてお話をします。#すうがくぶんか
8
#統計 このようにP値は、
特定のモデルの下での
データの数値と
モデルのパラメータの値に関する仮説
の相性の良さ(compatibility)の程度
を表しています。これがASA声明にあるP値の解釈の仕方の一例になっている。
添付画像は「n=50回中k=42回成功」というデータの数値のP値関数たちのグラフ。

特定のモデルの下での
データの数値と
モデルのパラメータの値に関する仮説
の相性の良さ(compatibility)の程度
を表しています。これがASA声明にあるP値の解釈の仕方の一例になっている。
添付画像は「n=50回中k=42回成功」というデータの数値のP値関数たちのグラフ。
内場 崇之(Takayuki Uchiba)@utaka233
今日は講座『はじめての医療統計』の初回でした。p-値とはなにかをASA声明を基軸に解説し、信頼区間などの併用やp-値関数について説明しました。次回は例数設計や再現性についてお話をします。#すうがくぶんか
9
#統計 ASA声明での「P値はincompatibleな程度だ」の「P値」は正しくは「P値の小ささ」です。
「P値はcompatibleな程度(相性の良さの程度)」だと言う方が直接的で、両側P値が最大になるパラメータの値を「点推定値」と呼ぶこととも整合的です。
このあたりはASA声明よりGreenlandが優れています。
「P値はcompatibleな程度(相性の良さの程度)」だと言う方が直接的で、両側P値が最大になるパラメータの値を「点推定値」と呼ぶこととも整合的です。
このあたりはASA声明よりGreenlandが優れています。
内場 崇之(Takayuki Uchiba)@utaka233
今日は講座『はじめての医療統計』の初回でした。p-値とはなにかをASA声明を基軸に解説し、信頼区間などの併用やp-値関数について説明しました。次回は例数設計や再現性についてお話をします。#すうがくぶんか
10
#統計 おそらく、ASA声明には「小さな世界」の統計学(実践的ではない)や、P値の使用先として帰無仮説有意性検定を主に考えるというような時代遅れの感覚が残っていると解釈すると、P値に関する説明の仕方がいまいちである理由が分かるような気がします。
11
#統計 モデルが現実においても正しいことを当然の前提とする時代遅れの「小さな世界」の統計学の考え方が混じっているならば、"the data"という言葉を直近で異なる意味で使ってしまっても不思議ではありません。

12
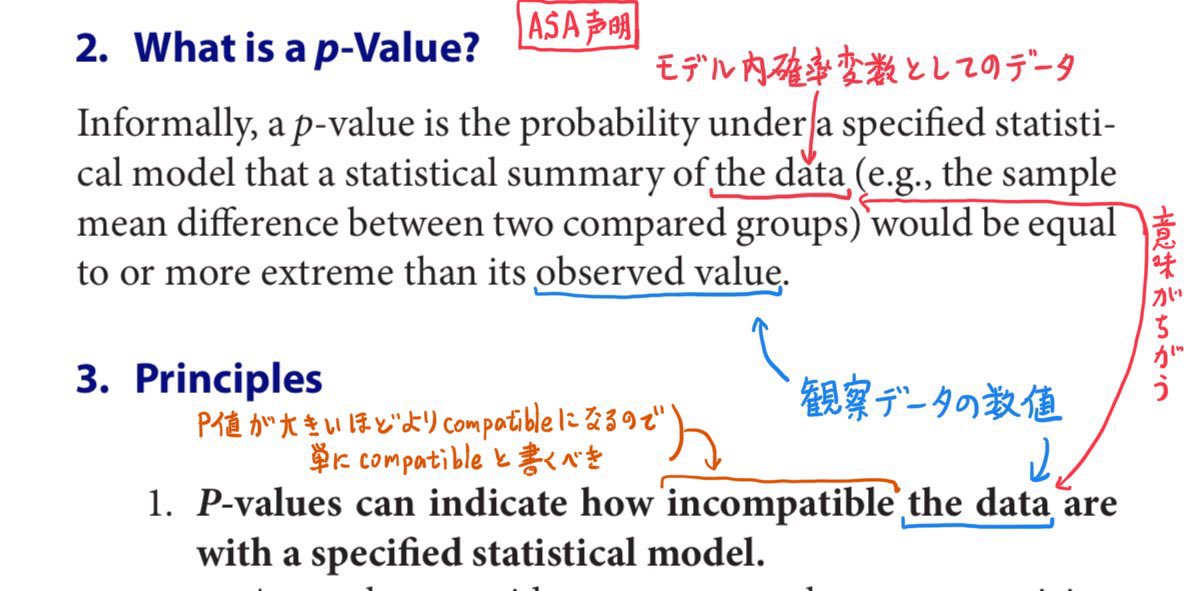
#統計 P値の使い道として、P値がどれだけ小さいかを気にすれば十分な帰無仮説有意性検定だけしか考えていないならば、シンプルに"compatible"と書かずに"incompatible"と書いてしまったことも理解できます。
P値は推定のための道具でもあります。

P値は推定のための道具でもあります。
黒木玄 Gen Kuroki@genkuroki
#統計 お勧めのGreenlandさんの講演スライドより
P値を推定のための道具として扱わない誤りの繰り返しはやめるべき。
「差がない」という帰無仮説のnull P値単体を帰無仮説有意性検定(NHST)で使うだけなのは誤解の主な原因になっている。
biostatistics.ucdavis.edu/sites/g/files/…
P値を推定のための道具として扱わない誤りの繰り返しはやめるべき。
「差がない」という帰無仮説のnull P値単体を帰無仮説有意性検定(NHST)で使うだけなのは誤解の主な原因になっている。
biostatistics.ucdavis.edu/sites/g/files/…
13
#統計 ASA声明でのP値に関する説明の仕方が不快に感じる人はGreenlandさんによる解説を読むとすっきりすると思います。
黒木玄 Gen Kuroki@genkuroki
#統計 ASA声明のように不快なP値の説明がなくて、クリアで内容的に一貫している解説にSander Greenlandさんの講演スライド
biostat.ucdavis.edu/sites/g/files/…
があります。
医療関係者はGreenlandさんに従えば統計を安全に使い易くなると思います。スライドの中に引用できる論文のリストがあります。
biostat.ucdavis.edu/sites/g/files/…
があります。
医療関係者はGreenlandさんに従えば統計を安全に使い易くなると思います。スライドの中に引用できる論文のリストがあります。
14
#統計 Colabノートブック
colab.research.google.com/drive/1she_BKS…
の実行の仕方:
1. ブラウザからGoogleにログインする。
2. そのブラウザで上のURLにアクセスする。
3. ランタイム→すべてのセルを実行(添付画像)
1分程度ですべてが実行されます。少しだけ書き変えて実行すると理解が進む場合がある。
colab.research.google.com/drive/1she_BKS…
の実行の仕方:
1. ブラウザからGoogleにログインする。
2. そのブラウザで上のURLにアクセスする。
3. ランタイム→すべてのセルを実行(添付画像)
1分程度ですべてが実行されます。少しだけ書き変えて実行すると理解が進む場合がある。
15
#統計
colab.research.google.com/drive/1she_BKS…
で #Julia言語 で実装されている信頼区間のコードは、高校数学で習うWaldの信頼区間(二項分布の正規分布近似から素直に得られ__ない__信頼区間)ではなく、Wilsonのスコア信頼区間(二項分布の正規分布近似から素直に得られる信頼区間)です。
ja.wikipedia.org/wiki/%E3%82%A6…
colab.research.google.com/drive/1she_BKS…
で #Julia言語 で実装されている信頼区間のコードは、高校数学で習うWaldの信頼区間(二項分布の正規分布近似から素直に得られ__ない__信頼区間)ではなく、Wilsonのスコア信頼区間(二項分布の正規分布近似から素直に得られる信頼区間)です。
ja.wikipedia.org/wiki/%E3%82%A6…
16
#統計 Wilsonのスコア信頼区間は、Rのprop.testのcorrect=FALSEで実装されている信頼区間です。
Wilsonのスコア信頼区間が優れた性質を持つことについては以下のリンク先で紹介した非常に有名な論文を参照。
Wilsonのスコア信頼区間が優れた性質を持つことについては以下のリンク先で紹介した非常に有名な論文を参照。
黒木玄 Gen Kuroki@genkuroki
#統計 単純に正確な方がよいと誤解している人達は、次のようなタイトルの非常に有名な論文があることも知っておくべき。
scholar.google.co.jp/scholar?cluste…
Approximate is better than “exact” for interval estimation of binomial proportions
A Agresti, BA Coull
1998
scholar.google.co.jp/scholar?cluste…
Approximate is better than “exact” for interval estimation of binomial proportions
A Agresti, BA Coull
1998
17
#統計 P値を「特定のモデルの下での、データの数値とモデルのパラメータに関する特定の仮説の相性の良さ(compatibility)の程度」と解釈することの利点の1つは、ベイズ統計での事後確率も同じように解釈できることです。ただし、ベイズではモデルの構成要素に事前分布が含まれる。
黒木玄 Gen Kuroki@genkuroki
#統計 このようにP値は、
特定のモデルの下での
データの数値と
モデルのパラメータの値に関する仮説
の相性の良さ(compatibility)の程度
を表しています。これがASA声明にあるP値の解釈の仕方の一例になっている。
添付画像は「n=50回中k=42回成功」というデータの数値のP値関数たちのグラフ。
特定のモデルの下での
データの数値と
モデルのパラメータの値に関する仮説
の相性の良さ(compatibility)の程度
を表しています。これがASA声明にあるP値の解釈の仕方の一例になっている。
添付画像は「n=50回中k=42回成功」というデータの数値のP値関数たちのグラフ。
18
#統計 続き。ただし、ベイズでは非 ベイズの場合と違って「データの数値で条件付けられたモデル内条件付き確率分布」をメインの道具として使う。続く
19
#統計 P値の「特定のモデルの下での、データの数値とモデルのパラメータに関する特定の仮説の相性の良さ(compatibility)の程度」という解釈法がベイズの場合にも通用することは、その解釈法が「データが従う真の分布」を仮定しなくても通用することと整合的です。続く
20
#統計 P値の「特定のモデルの下での、データの数値とモデルのパラメータに関する特定の仮説の相性の良さ(compatibility)の程度」という解釈法は、おそろしく弱く、その解釈はそれだけでは現実の問題について強い結論を導きません。モデルを使ったデータの数値の整理の仕方(記述統計)に過ぎません。続く
21
#統計 そういう現実の問題に関する強い結論を導かな解釈がベイズの場合にも通用することは、「データが従う真の分布」の存在を仮定しないとか、事前分布をデータの数値を見てから変更することを絶対にゆるさないなどのこだわりを見せる主観ベイズ主義者が批判される理由にも通じています。続く
22
#統計 主観ベイズ主義者が何を言おうが、事後確率は数学的フィクションであるモデル内事後確率に過ぎず、モデル依存の結果に過ぎません。事後確率達も、モデルを使ったデータの数値の整理の仕方(記述統計)の一種に過ぎない。
「ベイズ推論」という言い方の「推論」は過剰広告だということになります。
「ベイズ推論」という言い方の「推論」は過剰広告だということになります。
23
#統計 モデルを使ったデータの数値の整理の仕方(モデルを使った記述統計)にはそれ自体には現実の問題に関する必要な強さの結論導く力はありませんが、他の研究者や研究グループに結果を整理して伝える力がある。既出の
scholar.google.co.jp/scholar?cluste…
のタイトルは「記述統計としての推論統計」でした。
scholar.google.co.jp/scholar?cluste…
のタイトルは「記述統計としての推論統計」でした。
黒木玄 Gen Kuroki@genkuroki
#統計 再現性の危機の主な原因がPハッキングの類の不正行為であるかのように語るミスリーディングな説明に注意。
次の論文の内容が科学的常識にフィットしていると思います。
scholar.google.co.jp/scholar?cluste…
Amrhein-Trafimow-Greenland 2019
副題:再現性を期待しなければ再現性の危機は存在しない
次の論文の内容が科学的常識にフィットしていると思います。
scholar.google.co.jp/scholar?cluste…
Amrhein-Trafimow-Greenland 2019
副題:再現性を期待しなければ再現性の危機は存在しない
24
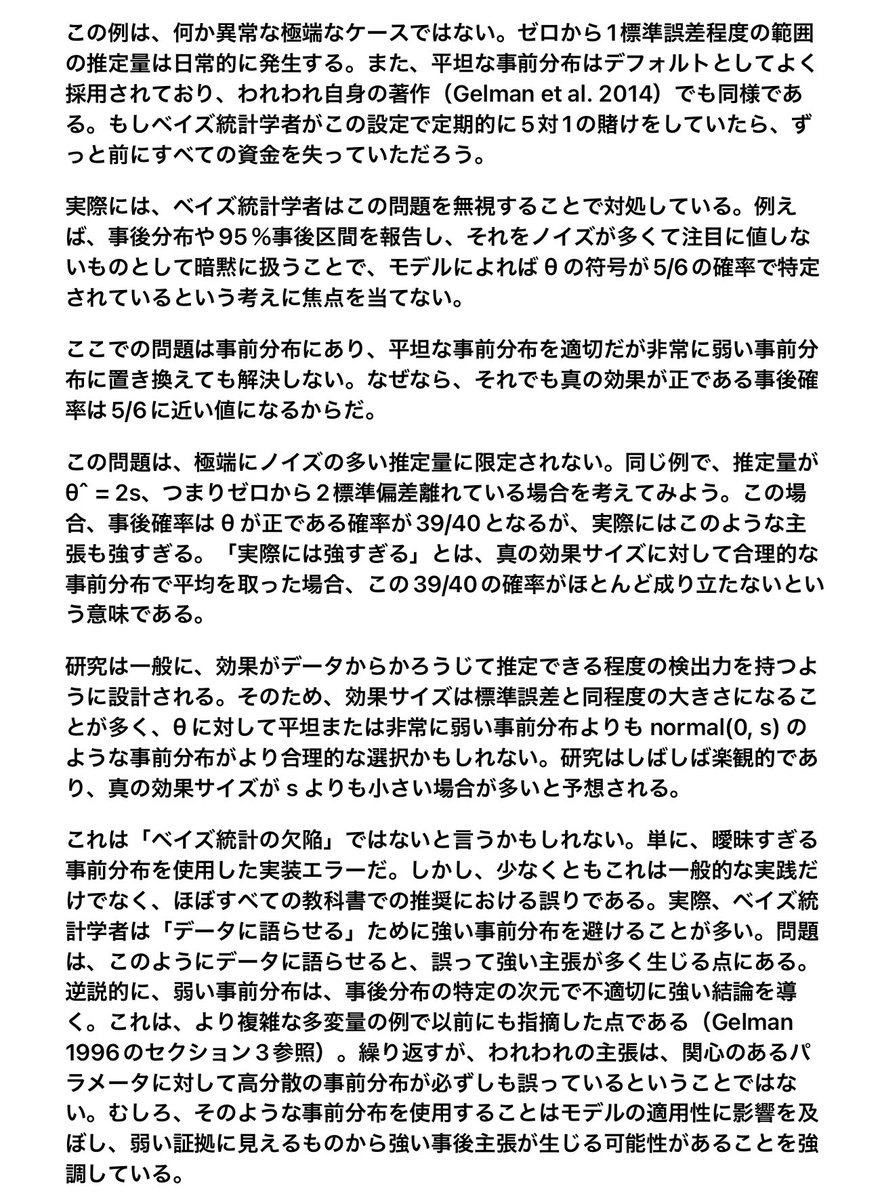
#統計 ピュアな主観ベイズ主義者達に対するベイズ統計のまともな使い方の普及という視点からの批判については、次のGelmanさん達の論文も参照。Gelmanさんのそういう視点はStanの開発でも発揮されており、Stan以外の確率プログラミング言語にも影響を与えていると思います。
scholar.google.com/scholar?cluste…

scholar.google.com/scholar?cluste…
黒木玄 Gen Kuroki@genkuroki
#統計 scholar.google.com/scholar?cluste… の
3. 弱い事前分布が不合理に強い推論をもたらす(事後確率を真剣に考える)
の部分訳。これのベイズ的ABテスト版をよく見る。
ベイズ統計での事後確率はモデル内確率に過ぎず、現実における確率ではないのに、事後確率を信じて「賭ける」行為は破滅を招くだろう。
3. 弱い事前分布が不合理に強い推論をもたらす(事後確率を真剣に考える)
の部分訳。これのベイズ的ABテスト版をよく見る。
ベイズ統計での事後確率はモデル内確率に過ぎず、現実における確率ではないのに、事後確率を信じて「賭ける」行為は破滅を招くだろう。
25
#統計 「データの数値だけから決定的な結果が得られる」のように無理なことを期待すること自体が誤りです。得られたデータの数値以外の情報も使わないと、現実の問題に関する合理的な判断は不可能。
無理な期待を完璧に潰さずに曖昧にふんわり生き残らせることは誰に取って有益なのでしょうかね。
無理な期待を完璧に潰さずに曖昧にふんわり生き残らせることは誰に取って有益なのでしょうかね。
26
#統計 null P値がほぼゼロの状況の人が「宝くじに当たった人」だとか「万馬券を取った人」であることは、データの数値外の情報の典型例。まともな判断のためには必須の情報。
『ロスマンの疫学第2版』(お勧めの本)より
↓
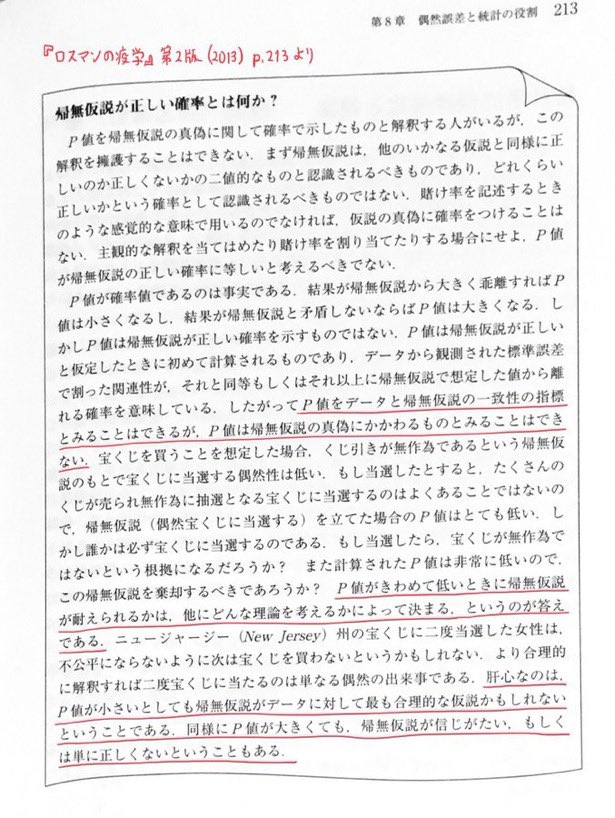

『ロスマンの疫学第2版』(お勧めの本)より
↓
でえもん@GreatDemon1701
多分、宝くじの高額当選者はくじを細工しているし、万馬券的中者は馬に細工しているという結論を出すのでしょう。当人でない人が細工しているかもしれんが。