#統計...

黒木玄 Gen Kuroki@genkuroki
89 views
Jan 27, 2026
~1 min read
Advertisement
1
#統計 フローチャート統計学の教育事例(教科書事例を含む)をしばらく前から収集しています。スレッドの次の投稿で事例集スレッドにリンクを貼ります。
結論: フローチャート統計学は有害!
ただし、その内容自体が間違っているので、初学者にフローチャート統計学を教えることは極めて有害です。続く

結論: フローチャート統計学は有害!
ただし、その内容自体が間違っているので、初学者にフローチャート統計学を教えることは極めて有害です。続く
中西正樹 | データサイエンティスト@nakanishi_ds
統計学やデータサイエンスの分野において、フローチャートを良く見かけるのだけど、結構危険だと個人的に感じる。
のでこのもやもやを頑張って言語化してみる。
特にデータサイエンティストになりたての初学者やフローチャートを参考にしたことがある人は読んでほしい。
例えば
・データが正規分布?->t検定
・対応あり?->対応ありt検定
・3群以上?->ANOVA
みたいなやつ。
もちろん教育的な入り口として一定の価値はあると思う。
各手法の分かりやすい違いが一覧できている、みたいな観点では勉強のきっかけになり得るので良いものではあると思う。
一方で、実務や研究の現場でこの思考法を持ち込むのは、ものすっごい危険。
なので読み手のスタンスとリテラシーがすごい重要で、それにリスクが大きく潜んでいる思う。
前提や仮定、手法の特性について分かってて、かつ解きたい問題についてどういうバイアスが乗りそうでどういうリスクが潜んでいるか、を認識したうえで利用するのであればまだわかる。
(ただ、それを分かっていればそもそもフローチャートを使う必要がそもそもない)
そもそも統計的検定を始めとした効果検証の領域の問題はyes/noの境界を作れるものではないし、無数の切り口と無数の妥当さが存在するんですよね。
例えば、データが正規分布に従う、と仮定する場合は~~~みたいなフロー。何をもって正規分布と仮定するのか、本当に正規分布と仮定して良いのか、って話です。
今回はこういうデータでこういう問題を解いていて、
ドメインからこういう仮定がおけて、
データを観測する限りこれぐらいの誤差がありそうで、
そのリスクは許容できそうだから、
正規分布とみなして問題を解こう、
だからこの手法を使ってよいんだ。
みたいな考え方が大事なんですよね。
フローチャートを使うってことは、判断をyes/noで境界を雑に作っている(分布の仮定、サンプルサイズ、バイアス、...)ってことで、
重要な情報を捨てていて、そのリスクを認識する行為を放棄することと同義です。
なので、ものすごい危険な判断が潜みます。
更に厳しいことを言うと、ちゃんと問題設定を作りこめていれば回帰分析(GLMや階層モデルを含む)の問題に結局は落ち着くことがほとんどで、
これが作れない時点で問題設定から破綻していて、害悪な結果しか生み出さないことが目に見えてます。
つまり問題設定を作り、それを適切にモデリングができるかどうかが重要であって、それができない時点で破綻してるかデータ理解が足りてないんですよね。
フローチャートを実務の問題に適用する時点で、それはもう間違った結果を生み出す可能性が非常に高いと認識したほうが良いです。
データサイエンスってフローチャートやフレームワークを模倣して、理解していない状態で物事を進めるケースが非常に多いです。
データサイエンティストとして最も怖いのは、理解していないことを理解していない状態に陥ること、だからな。
なので、
手抜きをせず、
正しくデータと向き合い、
正しく手法を理解し、
フローチャートではなく自身のロジックと根拠を持って、
誠意をもって問題に立ち向かうんだぞ。
のでこのもやもやを頑張って言語化してみる。
特にデータサイエンティストになりたての初学者やフローチャートを参考にしたことがある人は読んでほしい。
例えば
・データが正規分布?->t検定
・対応あり?->対応ありt検定
・3群以上?->ANOVA
みたいなやつ。
もちろん教育的な入り口として一定の価値はあると思う。
各手法の分かりやすい違いが一覧できている、みたいな観点では勉強のきっかけになり得るので良いものではあると思う。
一方で、実務や研究の現場でこの思考法を持ち込むのは、ものすっごい危険。
なので読み手のスタンスとリテラシーがすごい重要で、それにリスクが大きく潜んでいる思う。
前提や仮定、手法の特性について分かってて、かつ解きたい問題についてどういうバイアスが乗りそうでどういうリスクが潜んでいるか、を認識したうえで利用するのであればまだわかる。
(ただ、それを分かっていればそもそもフローチャートを使う必要がそもそもない)
そもそも統計的検定を始めとした効果検証の領域の問題はyes/noの境界を作れるものではないし、無数の切り口と無数の妥当さが存在するんですよね。
例えば、データが正規分布に従う、と仮定する場合は~~~みたいなフロー。何をもって正規分布と仮定するのか、本当に正規分布と仮定して良いのか、って話です。
今回はこういうデータでこういう問題を解いていて、
ドメインからこういう仮定がおけて、
データを観測する限りこれぐらいの誤差がありそうで、
そのリスクは許容できそうだから、
正規分布とみなして問題を解こう、
だからこの手法を使ってよいんだ。
みたいな考え方が大事なんですよね。
フローチャートを使うってことは、判断をyes/noで境界を雑に作っている(分布の仮定、サンプルサイズ、バイアス、...)ってことで、
重要な情報を捨てていて、そのリスクを認識する行為を放棄することと同義です。
なので、ものすごい危険な判断が潜みます。
更に厳しいことを言うと、ちゃんと問題設定を作りこめていれば回帰分析(GLMや階層モデルを含む)の問題に結局は落ち着くことがほとんどで、
これが作れない時点で問題設定から破綻していて、害悪な結果しか生み出さないことが目に見えてます。
つまり問題設定を作り、それを適切にモデリングができるかどうかが重要であって、それができない時点で破綻してるかデータ理解が足りてないんですよね。
フローチャートを実務の問題に適用する時点で、それはもう間違った結果を生み出す可能性が非常に高いと認識したほうが良いです。
データサイエンスってフローチャートやフレームワークを模倣して、理解していない状態で物事を進めるケースが非常に多いです。
データサイエンティストとして最も怖いのは、理解していないことを理解していない状態に陥ること、だからな。
なので、
手抜きをせず、
正しくデータと向き合い、
正しく手法を理解し、
フローチャートではなく自身のロジックと根拠を持って、
誠意をもって問題に立ち向かうんだぞ。
2
#統計 初学者にとっても極めて有害なフローチャート統計学の教育実践及び教科書記述の事例集をまとめたスレッドへのリンク
続く
続く
黒木玄 Gen Kuroki@genkuroki
#統計 悪しきフローチャート統計学の例
例1
例1
3
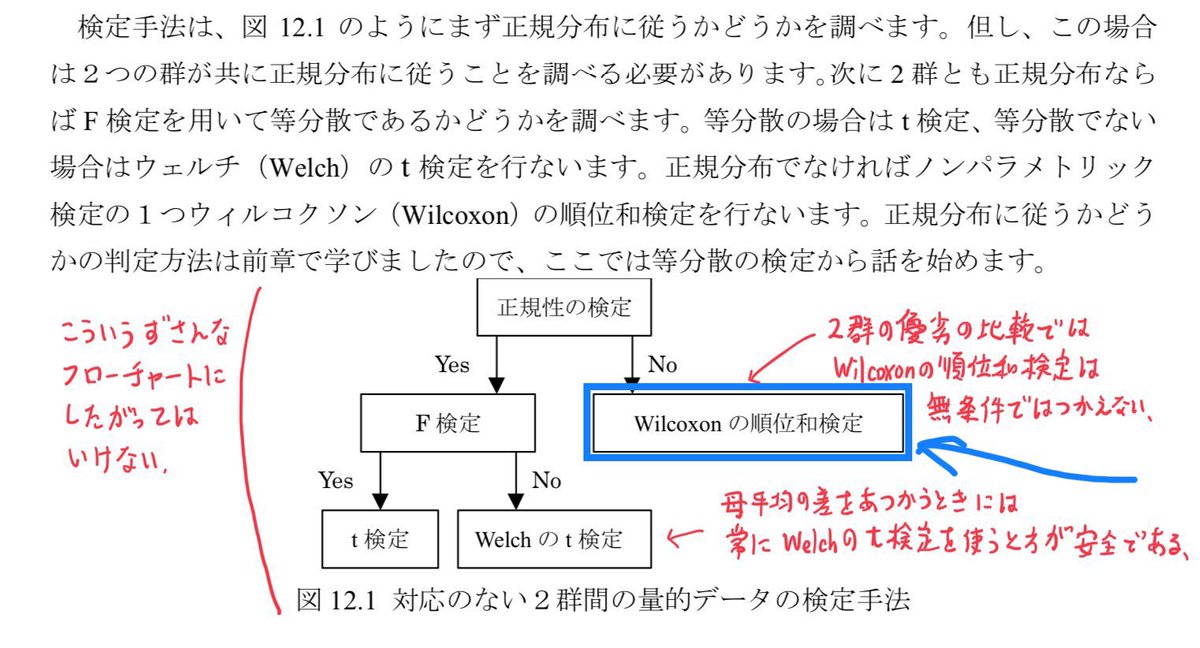
#統計 フローチャート統計学の典型例は添付画像のようなものです。これが本当に酷い。
まず「正規性の検定」で「t検定」と「ノンパラメトリック検定」を使い分けようとしている所からおかしい。
さらに「等分散の検定」で「Studentのt検定」と「Welchのt検定」を使い分けるのも誤りです。
続く


まず「正規性の検定」で「t検定」と「ノンパラメトリック検定」を使い分けようとしている所からおかしい。
さらに「等分散の検定」で「Studentのt検定」と「Welchのt検定」を使い分けるのも誤りです。
続く
黒木玄 Gen Kuroki@genkuroki
#統計 池田郁男著『実験で使うとこだけ生物統計2 キホンのホン 決定版』関連情報。
フローチャート統計学を教えることは社会への負の貢献になるので、負の貢献だときちんと評価されるべき。
負の貢献をしていると評価されずに済んでいるから、何度でも負の貢献をノーリスクで繰り返す。
フローチャート統計学を教えることは社会への負の貢献になるので、負の貢献だときちんと評価されるべき。
負の貢献をしていると評価されずに済んでいるから、何度でも負の貢献をノーリスクで繰り返す。
4
#統計 まず、統計学の基礎をよく理解していない人達は「正規分布でないとt検定を使えない」とよく信じているのですが、それは誤りです。続く
5
#統計 中心極限定理のお陰で、t検定達は正規性からの逸脱について結構頑健。
ただし、左右非対称性が大きく、外れ値が出易い場合には弱い。
しかし、そういう場合は平均値は代表値として不適切である可能性が高いという理由で、母平均の差に関するt検定達は良い方法にはならない可能性が高い。続く
ただし、左右非対称性が大きく、外れ値が出易い場合には弱い。
しかし、そういう場合は平均値は代表値として不適切である可能性が高いという理由で、母平均の差に関するt検定達は良い方法にはならない可能性が高い。続く
6
#統計 不等サンプルサイズの場合のStudentのt検定は等母分散の仮定からの逸脱に脆弱です。
等母分散性検定を使ってStudentとWelchを使い分けると、検出力の弱さの分だけ、不等母分散のよろしくない場合にStudentのt検定を使用することになってしまいます。続く
等母分散性検定を使ってStudentとWelchを使い分けると、検出力の弱さの分だけ、不等母分散のよろしくない場合にStudentのt検定を使用することになってしまいます。続く
7
#統計 データの値を見る前から何か特別な理由があって等母分散だと分かっている場合以外には、不等サンプルサイズのStudentのt検定は不適切な方法とみなして使わずに、Welchのt検定を使うべきです。
等母分散の場合にもWelchで全然問題ない。続く
等母分散の場合にもWelchで全然問題ない。続く
8
#統計 そもそも、初学者に、データの値を見ながら、統計分析の方法を選択する行為を安易に教えること自体が危険行為です。
あらゆる選択肢の分岐全体における確率と、選んだ方法限定での確率の評価は全く異なります。そういうややこしい話を初学者は理解できないでしょう。続く
あらゆる選択肢の分岐全体における確率と、選んだ方法限定での確率の評価は全く異なります。そういうややこしい話を初学者は理解できないでしょう。続く
9
#統計 統計学における「分岐する小道の庭 (Garden of Forking Paths)」の概念は、統計学を教える立場や論文を読んだり仕事で使ったりする立場では重要。
黒木玄 Gen Kuroki@genkuroki
#統計 いやあ、これは勉強になりました。
統計分析の過程での潜在的な分岐を考慮すると意図せずに多重比較の問題が生じているかもしれないという「分岐する小道の庭」の話の整理と具体例。
sites.stat.columbia.edu/gelman/researc…
The garden of forking paths
Gelman-Loken 2013
統計分析の過程での潜在的な分岐を考慮すると意図せずに多重比較の問題が生じているかもしれないという「分岐する小道の庭」の話の整理と具体例。
sites.stat.columbia.edu/gelman/researc…
The garden of forking paths
Gelman-Loken 2013
10
#統計 フローチャート統計学は、脆弱で危険な検定法であるWilcoxonの順位和検定(=Mann-WhitneyのU検定)を勧める傾向が強い。
頑健な代替法のBrunner-Munzel検定について知っていても、等分散ならMann-WhitneyのU検定を安全に使えると誤解していたりする。


頑健な代替法のBrunner-Munzel検定について知っていても、等分散ならMann-WhitneyのU検定を安全に使えると誤解していたりする。
11
#統計 そもそも、初学者に「有意差を出す」という発想で作られた手続きを教え込むこと自体が酷い時代錯誤です。
ASA声明2016やNature 2019に出た統計的有意性の廃止の提案論文の内容を教える側が一切考慮してなかったり、読んだ気配があっても内容を全然理解していなかったりする。
ASA声明2016やNature 2019に出た統計的有意性の廃止の提案論文の内容を教える側が一切考慮してなかったり、読んだ気配があっても内容を全然理解していなかったりする。
12
#統計 帰無仮説有意性検定(NHST)の考え方は極めて有害。
「差がない」のようなゼロ仮説単独のP値が5%未満か否かで「有意差あり/なし」と結論するのがNHSTです。
常識的な科学的素養があれば、こういうやり方を初学者に教え込むことは明らかに非常にまずい。続く
「差がない」のようなゼロ仮説単独のP値が5%未満か否かで「有意差あり/なし」と結論するのがNHSTです。
常識的な科学的素養があれば、こういうやり方を初学者に教え込むことは明らかに非常にまずい。続く
13
#統計 フローチャート統計学は結論が「有意差あり/なし」の形になる帰無仮説有意性検定を教え込むために設計されている。
そのせいで、異なる意味での差の有無を全部ごっちゃにして「有意差あり/なし」にまとめる杜撰さのおまけ付き。
母平均の差(t検定)とP(X<Y)+P(X=Y)/2と1/2の差(BM検定)は違う。
そのせいで、異なる意味での差の有無を全部ごっちゃにして「有意差あり/なし」にまとめる杜撰さのおまけ付き。
母平均の差(t検定)とP(X<Y)+P(X=Y)/2と1/2の差(BM検定)は違う。
14
#統計 これから統計学をどう教えるべきかについては、超大家のSander Greenlandさんの講演スライド2022が非常に分かり易いです。
これと初学者を害するフローチャート統計学の教育事例を比較すると愕然としてしまいます。
これ、特に高等教育の大問題だと思います。

これと初学者を害するフローチャート統計学の教育事例を比較すると愕然としてしまいます。
これ、特に高等教育の大問題だと思います。
黒木玄 Gen Kuroki@genkuroki
#統計 これからやるべき統計学の改革方針の総まとめについては、Sander Greenlandさんの講演スライド2022が非常に分かり易いです。
↓
biostatistics.ucdavis.edu/sites/g/files/…
日本語版
↓
github.com/genkuroki/publ…
↓
biostatistics.ucdavis.edu/sites/g/files/…
日本語版
↓
github.com/genkuroki/publ…
15
#統計 フローチャート統計学に忠実に従うと
①間違った検定法が選択されがちになる。
②「差」の意味の違いに無頓着になる。
③結論が「有意差あり/なし」の二分法に単純化され、不確実性ロンダリングの原因になる。
①だけですでにアウト。他にも科学的にダメになってもらうための要素が満載!
①間違った検定法が選択されがちになる。
②「差」の意味の違いに無頓着になる。
③結論が「有意差あり/なし」の二分法に単純化され、不確実性ロンダリングの原因になる。
①だけですでにアウト。他にも科学的にダメになってもらうための要素が満載!
16
黒木玄 Gen Kuroki@genkuroki
#統計 補足説明
フローチャート統計学は、「差がない」の意味が異なる検定法をまるで互換性があるかのように扱っている点も酷い。差の意味に無頓着に「有意差を出す」という発想をすること自体が酷過ぎる。続く
フローチャート統計学は、「差がない」の意味が異なる検定法をまるで互換性があるかのように扱っている点も酷い。差の意味に無頓着に「有意差を出す」という発想をすること自体が酷過ぎる。続く

17
#統計 生成AIも、初学者にとって特に有害なフローチャート統計学を学習してしまっているっぽい。

黒木玄 Gen Kuroki@genkuroki
#統計 うわっ!Geminiまで、脆弱で危険な検定法であるMann-WhitneyのU検定を勧めて来るのか!しかも悪しきフローチャート統計学のサブセットとしての正規性検定まで勧めている!
最初にどの指標で違いを測ることが適切かについて考えるべき。
詳しくはスレッド全体を参照。
最初にどの指標で違いを測ることが適切かについて考えるべき。
詳しくはスレッド全体を参照。
18
#統計 フローチャート統計学が特に初学者にとって有害な理由は以上で説明したこと以外もある。
添付画像は見つけたらフローチャートの中で最もシンプルだとみなせるものだが、初学者に無駄に複雑な手続きを課しているという点でも迷惑なものになっている。
無駄に複雑であることの解説に続く

添付画像は見つけたらフローチャートの中で最もシンプルだとみなせるものだが、初学者に無駄に複雑な手続きを課しているという点でも迷惑なものになっている。
無駄に複雑であることの解説に続く
中西正樹 | データサイエンティスト@nakanishi_ds
統計学やデータサイエンスの分野において、フローチャートを良く見かけるのだけど、結構危険だと個人的に感じる。
のでこのもやもやを頑張って言語化してみる。
特にデータサイエンティストになりたての初学者やフローチャートを参考にしたことがある人は読んでほしい。
例えば
・データが正規分布?->t検定
・対応あり?->対応ありt検定
・3群以上?->ANOVA
みたいなやつ。
もちろん教育的な入り口として一定の価値はあると思う。
各手法の分かりやすい違いが一覧できている、みたいな観点では勉強のきっかけになり得るので良いものではあると思う。
一方で、実務や研究の現場でこの思考法を持ち込むのは、ものすっごい危険。
なので読み手のスタンスとリテラシーがすごい重要で、それにリスクが大きく潜んでいる思う。
前提や仮定、手法の特性について分かってて、かつ解きたい問題についてどういうバイアスが乗りそうでどういうリスクが潜んでいるか、を認識したうえで利用するのであればまだわかる。
(ただ、それを分かっていればそもそもフローチャートを使う必要がそもそもない)
そもそも統計的検定を始めとした効果検証の領域の問題はyes/noの境界を作れるものではないし、無数の切り口と無数の妥当さが存在するんですよね。
例えば、データが正規分布に従う、と仮定する場合は~~~みたいなフロー。何をもって正規分布と仮定するのか、本当に正規分布と仮定して良いのか、って話です。
今回はこういうデータでこういう問題を解いていて、
ドメインからこういう仮定がおけて、
データを観測する限りこれぐらいの誤差がありそうで、
そのリスクは許容できそうだから、
正規分布とみなして問題を解こう、
だからこの手法を使ってよいんだ。
みたいな考え方が大事なんですよね。
フローチャートを使うってことは、判断をyes/noで境界を雑に作っている(分布の仮定、サンプルサイズ、バイアス、...)ってことで、
重要な情報を捨てていて、そのリスクを認識する行為を放棄することと同義です。
なので、ものすごい危険な判断が潜みます。
更に厳しいことを言うと、ちゃんと問題設定を作りこめていれば回帰分析(GLMや階層モデルを含む)の問題に結局は落ち着くことがほとんどで、
これが作れない時点で問題設定から破綻していて、害悪な結果しか生み出さないことが目に見えてます。
つまり問題設定を作り、それを適切にモデリングができるかどうかが重要であって、それができない時点で破綻してるかデータ理解が足りてないんですよね。
フローチャートを実務の問題に適用する時点で、それはもう間違った結果を生み出す可能性が非常に高いと認識したほうが良いです。
データサイエンスってフローチャートやフレームワークを模倣して、理解していない状態で物事を進めるケースが非常に多いです。
データサイエンティストとして最も怖いのは、理解していないことを理解していない状態に陥ること、だからな。
なので、
手抜きをせず、
正しくデータと向き合い、
正しく手法を理解し、
フローチャートではなく自身のロジックと根拠を持って、
誠意をもって問題に立ち向かうんだぞ。
のでこのもやもやを頑張って言語化してみる。
特にデータサイエンティストになりたての初学者やフローチャートを参考にしたことがある人は読んでほしい。
例えば
・データが正規分布?->t検定
・対応あり?->対応ありt検定
・3群以上?->ANOVA
みたいなやつ。
もちろん教育的な入り口として一定の価値はあると思う。
各手法の分かりやすい違いが一覧できている、みたいな観点では勉強のきっかけになり得るので良いものではあると思う。
一方で、実務や研究の現場でこの思考法を持ち込むのは、ものすっごい危険。
なので読み手のスタンスとリテラシーがすごい重要で、それにリスクが大きく潜んでいる思う。
前提や仮定、手法の特性について分かってて、かつ解きたい問題についてどういうバイアスが乗りそうでどういうリスクが潜んでいるか、を認識したうえで利用するのであればまだわかる。
(ただ、それを分かっていればそもそもフローチャートを使う必要がそもそもない)
そもそも統計的検定を始めとした効果検証の領域の問題はyes/noの境界を作れるものではないし、無数の切り口と無数の妥当さが存在するんですよね。
例えば、データが正規分布に従う、と仮定する場合は~~~みたいなフロー。何をもって正規分布と仮定するのか、本当に正規分布と仮定して良いのか、って話です。
今回はこういうデータでこういう問題を解いていて、
ドメインからこういう仮定がおけて、
データを観測する限りこれぐらいの誤差がありそうで、
そのリスクは許容できそうだから、
正規分布とみなして問題を解こう、
だからこの手法を使ってよいんだ。
みたいな考え方が大事なんですよね。
フローチャートを使うってことは、判断をyes/noで境界を雑に作っている(分布の仮定、サンプルサイズ、バイアス、...)ってことで、
重要な情報を捨てていて、そのリスクを認識する行為を放棄することと同義です。
なので、ものすごい危険な判断が潜みます。
更に厳しいことを言うと、ちゃんと問題設定を作りこめていれば回帰分析(GLMや階層モデルを含む)の問題に結局は落ち着くことがほとんどで、
これが作れない時点で問題設定から破綻していて、害悪な結果しか生み出さないことが目に見えてます。
つまり問題設定を作り、それを適切にモデリングができるかどうかが重要であって、それができない時点で破綻してるかデータ理解が足りてないんですよね。
フローチャートを実務の問題に適用する時点で、それはもう間違った結果を生み出す可能性が非常に高いと認識したほうが良いです。
データサイエンスってフローチャートやフレームワークを模倣して、理解していない状態で物事を進めるケースが非常に多いです。
データサイエンティストとして最も怖いのは、理解していないことを理解していない状態に陥ること、だからな。
なので、
手抜きをせず、
正しくデータと向き合い、
正しく手法を理解し、
フローチャートではなく自身のロジックと根拠を持って、
誠意をもって問題に立ち向かうんだぞ。
19
#統計 無駄に複雑な点①
母平均の差を扱いたいなら、余計なことを考えずにWelchのt検定とそれに付随する母平均の差の信頼区間を使えば良い。
たったそれだけのことなのにフローチャートは無駄で有害な手続きを要求している。特に脆弱なMann-WhitneyのU検定は危険なので初学者に勧めてはいけない。
母平均の差を扱いたいなら、余計なことを考えずにWelchのt検定とそれに付随する母平均の差の信頼区間を使えば良い。
たったそれだけのことなのにフローチャートは無駄で有害な手続きを要求している。特に脆弱なMann-WhitneyのU検定は危険なので初学者に勧めてはいけない。
20
#統計 無駄に複雑な点②
2×2の分割表での独立性について、小さな値のセルがあったら(もしくはサンプルサイズ小さいならば)、Pearsonのχ²検定を使ってはいけないという悪しき慣習を初学者に押し付けて、手続きを煩雑にしている点も酷い。続く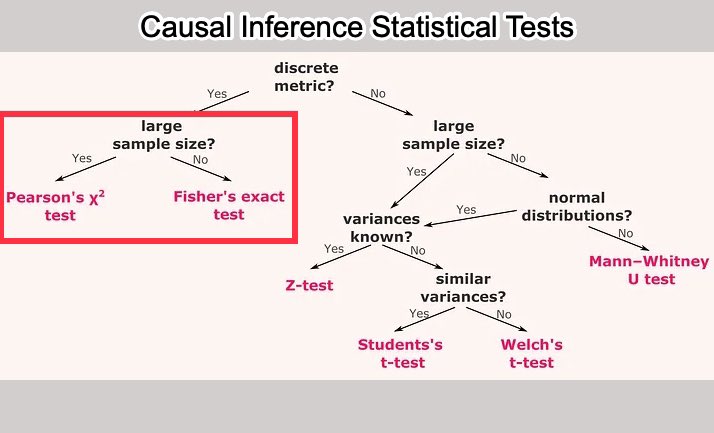


2×2の分割表での独立性について、小さな値のセルがあったら(もしくはサンプルサイズ小さいならば)、Pearsonのχ²検定を使ってはいけないという悪しき慣習を初学者に押し付けて、手続きを煩雑にしている点も酷い。続く
21
#統計 Fisher検定との比較で、連続性補正なしのPearsonのχ²検定のαエラー率は、期待値が小さなセルがあってもαをよちよく近似していることを、コンピュータシミュレーションで容易に確認できます。
Fisher検定は小サンプルではP値が無駄に大きくなる傾向が強く、検出力が犠牲になります。続く
Fisher検定は小サンプルではP値が無駄に大きくなる傾向が強く、検出力が犠牲になります。続く
22
#統計 期待値が小さなセルがあったり、小サンプルであることを理由に、Pearsonのχ²検定の使用を禁止して、Fisher検定を使わなければいけないと、他人に教えて来た人達は、自分が間違っていたことをおおっぴらに認めて反省するべきです。続く
23
#統計 連続性補正されたPearsonのχ²検定は非常に保守的な片側確率の2倍でP値を定義するバージョンのFisher検定の良い近似に過ぎないので、片側確率の2倍版Fisher検定を使用できるならば、使う必要はありません。
シンプルに「Pearsonのχ²検定では連続性補正をしない」と覚えておけば十分です。続く
シンプルに「Pearsonのχ²検定では連続性補正をしない」と覚えておけば十分です。続く
24
#統計 数値実験すれば、連続性補正なしのシンプルなPearsonのχ²検定は、αエラー率がαに近くなり易いという意味では、Fisher検定よりも正確であることが分かります。
だから、初学者を誤解させないためには、Fisher検定をFisherの正確検定と呼ばない方が良いと思います。続く
だから、初学者を誤解させないためには、Fisher検定をFisherの正確検定と呼ばない方が良いと思います。続く
25
#統計 P値が大きくなり易いFisher検定は「αエラー率が確実にα以下になる」という数学的性質を持っています。自分の目的のためにこの条件が重要ならばFisher検定を使うべきです。
そうでないなら、連続性補正なしのPearsonのχ²検定を相当に自由に使っても良いと思います。
続く
そうでないなら、連続性補正なしのPearsonのχ²検定を相当に自由に使っても良いと思います。
続く
26
#統計 「期待値が4以下のセルがあるのにPearsonのχ²検定を使っているので統計学を誤用している」のような内容的にデタラメな警察行為は、初学者に合理性の欠けた萎縮を強いています。
これは極めて有害だと思われます。続く
これは極めて有害だと思われます。続く
27
#統計 シンプルに「Fisher検定も連続性補正なしのPearsonのχ²検定もどちらも概ね自由に使って良いですよ」で良いと思います。
Fisher検定も連続性補正なしのPearsonのχ²検定は互いに異なる利点と欠点を持っていることを理解すれば、さらに良い使い方をできるようになります。
Fisher検定も連続性補正なしのPearsonのχ²検定は互いに異なる利点と欠点を持っていることを理解すれば、さらに良い使い方をできるようになります。
28
#統計 まとめ
* フローチャート統計学は、間違った方法を選択させるだけではなく、無駄に複雑に従うことを強いており、初学者を不合理に萎縮させている点においても有害である。
伝統的なフローチャート統計学は入門的な解説では特に有害なので、きちんと全否定して行った方が良い。
* フローチャート統計学は、間違った方法を選択させるだけではなく、無駄に複雑に従うことを強いており、初学者を不合理に萎縮させている点においても有害である。
伝統的なフローチャート統計学は入門的な解説では特に有害なので、きちんと全否定して行った方が良い。
29
#統計 重要な補足
Fisher検定も(補正なしの)Pearsonのχ²検定も「有意差あり/なし」の型を結論とする帰無仮説有意性検定として使うことは有害なので、初学者にも有害だとはっきり教えるべきです。続く
Fisher検定も(補正なしの)Pearsonのχ²検定も「有意差あり/なし」の型を結論とする帰無仮説有意性検定として使うことは有害なので、初学者にも有害だとはっきり教えるべきです。続く
30
#統計 重要な補足続き
Fisher検定や(補正なしの)Pearsonのχ²検定は、それらと整合的な以下の信頼区間のどれかと一緒に使うべきです。
* リスク差の信頼区間
* リスク比の信頼区間
* オッズ比の信頼区間
整合性は大事。
可能ならばP値関数のグラフも報告した方がよい。
Fisher検定や(補正なしの)Pearsonのχ²検定は、それらと整合的な以下の信頼区間のどれかと一緒に使うべきです。
* リスク差の信頼区間
* リスク比の信頼区間
* オッズ比の信頼区間
整合性は大事。
可能ならばP値関数のグラフも報告した方がよい。
31
#統計 そして、結論を「有意差あり/なし」の安易な二分法で報告することは明瞭に禁止し、
* P値と点推定と区間推定の3点セットを含む情報
* それらが意味する不確実性
について報告するべき。
結論を「有意差あり/なし」の安易な二分法で報告する悪習は現代的には明瞭に禁止されるべき。大迷惑。
* P値と点推定と区間推定の3点セットを含む情報
* それらが意味する不確実性
について報告するべき。
結論を「有意差あり/なし」の安易な二分法で報告する悪習は現代的には明瞭に禁止されるべき。大迷惑。
32
#統計 現代的な報告の仕方のガイドライン(指針)については以下のリンク先スレッドを参照。
黒木玄 Gen Kuroki@genkuroki
#統計 以下の論文が提案したガイドラインの動画解説
scholar.google.co.jp/scholar?cluste…
“Statistical Significance” and Statistical Reporting: Moving Beyond Binary
Blakeley B. McShane, Eric T. Bradlow, John G. Lynch, Robert J. Meyer
2024
クソ分かり易い!
scholar.google.co.jp/scholar?cluste…
“Statistical Significance” and Statistical Reporting: Moving Beyond Binary
Blakeley B. McShane, Eric T. Bradlow, John G. Lynch, Robert J. Meyer
2024
クソ分かり易い!
33
#統計 統計学教育が改善しない理由は、手抜きのために便利という理由で悪しき伝統と権威が維持され続けているから。
教育実践出版のすべてを含む「破壊的なフィードバックループ」が形成されている。
フローチャート統計学は典型例。
Greenlandさんの講演スライド2022より
github.com/genkuroki/publ…
教育実践出版のすべてを含む「破壊的なフィードバックループ」が形成されている。
フローチャート統計学は典型例。
Greenlandさんの講演スライド2022より
github.com/genkuroki/publ…
34
35
#統計 悪しき伝統と従う時代遅れの統計学解説者達の特徴:
①「有意差あり/なし」型の二分法を結論とする帰無仮説有意性検定を初学者に教え込もうとする。
②脆弱で危険なWilcoxon-Mann-Whitney検定やStudentのt検定を初学者に教え込もうとする。(なぜかWelchのt検定を不当な方法でdisる人もいる。)
①「有意差あり/なし」型の二分法を結論とする帰無仮説有意性検定を初学者に教え込もうとする。
②脆弱で危険なWilcoxon-Mann-Whitney検定やStudentのt検定を初学者に教え込もうとする。(なぜかWelchのt検定を不当な方法でdisる人もいる。)
36
#統計 最近知ってびっくりしたことの1つは、ビジュアル的に極めて優れていてよく売れている統計学の入門書に
【P値を得たら、まず0.05と比較する】(←論外!)
と書いてあったこと。この本では脆弱で危険なWilcoxon-Mann-Whitney検定とStudentのt検定について詳しく書いてある。
まさに典型的!

【P値を得たら、まず0.05と比較する】(←論外!)
と書いてあったこと。この本では脆弱で危険なWilcoxon-Mann-Whitney検定とStudentのt検定について詳しく書いてある。
まさに典型的!
黒木玄 Gen Kuroki@genkuroki
#統計 失礼な言い方かもしれませんが、『基礎から学ぶ統計学』の著者を私は怒らせてしまったようです。
私にやれることは私の考えを可能な限り詳しく正確に説明することだと思ったのでそれを実行しました。
そしてやはり「P値を得たら、まず0.05と比較する」と教えるのはやめた方が良いと思います。
私にやれることは私の考えを可能な限り詳しく正確に説明することだと思ったのでそれを実行しました。
そしてやはり「P値を得たら、まず0.05と比較する」と教えるのはやめた方が良いと思います。
37
#統計 結論を「統計的に有意である/ない」としたい教科書では、片側裾確率の2倍のような方法で簡単に導入できるP値を使わずに、面倒な棄却領域の設定にこだわっていたりします。
P値を「有意差あり/なし」の二分法に利用__しない__使い方をする方法の解説
↓
github.com/genkuroki/publ…


P値を「有意差あり/なし」の二分法に利用__しない__使い方をする方法の解説
↓
github.com/genkuroki/publ…
黒木玄 Gen Kuroki@genkuroki
#統計 『基礎から学ぶ統計学』のように棄却域の計算手続きを説明して「有意差あり/なし」の悪名高い二分法に持ち込むよりも、片側の裾確率を計算して2倍するだけで得られる両側P値の計算の仕方(添付画像)を説明する方が生徒にとっては易しいのではないかと思いました。
github.com/genkuroki/publ…
github.com/genkuroki/publ…
38
#統計 悪しきフローチャート統計学は表形式になっていることも多い。
* Welchのt検定ではなく、脆弱なStudentのt検定を進めている
* Brunner-Munzel検定ではなく、脆弱なWilcoxon-Mann-Whitney検定を勧めている。
* Fisher検定とPearsonのχ²検定の使い分けで悪しき伝統に従っている


* Welchのt検定ではなく、脆弱なStudentのt検定を進めている
* Brunner-Munzel検定ではなく、脆弱なWilcoxon-Mann-Whitney検定を勧めている。
* Fisher検定とPearsonのχ²検定の使い分けで悪しき伝統に従っている
黒木玄 Gen Kuroki@genkuroki
#統計 悪しきフローチャート統計学の事例16
添付画像のように表形式になっている場合もある。
専門家が科学研究を害するやり方を積極的に教え続けているという問題がある。
youtu.be/m5j8bjwlIAE?si…
「新谷先生のゼロから極める医療統計シリーズ」
第4回講義のダイジェスト
mMEDICI Channel
添付画像のように表形式になっている場合もある。
専門家が科学研究を害するやり方を積極的に教え続けているという問題がある。
youtu.be/m5j8bjwlIAE?si…
「新谷先生のゼロから極める医療統計シリーズ」
第4回講義のダイジェスト
mMEDICI Channel
39

40
1標本のWilcoxonの符号順位検定の頑健性/脆弱性に関する別スレッド。最終結論はまだ出していない。
黒木玄 Gen Kuroki@genkuroki
@Islay_tr そのあたりのことの解説が見当たらず、査読済み出版論文でも酷いのを見つけたことがあります。よく査読通ったなという感じ。
そういう理由で理解している仲間を増やしたいと思ったので、長々と説明しました。
以上で終わり。
そういう理由で理解している仲間を増やしたいと思ったので、長々と説明しました。
以上で終わり。
41
#統計 伝統的な検定法選択のフローチャートは初学者にとって便利な検定手続きの概略図ではない。
初学者を検定法の間違った選択に誘導する酷い内容になっている。
社会的には、フローチャ統計学に従って統計分析を行って来た人達を「科学的にまともな考え方をできていない人達」扱いする必要がある。
初学者を検定法の間違った選択に誘導する酷い内容になっている。
社会的には、フローチャ統計学に従って統計分析を行って来た人達を「科学的にまともな考え方をできていない人達」扱いする必要がある。
黒木玄 Gen Kuroki@genkuroki
#統計 フローチャート統計学の教育事例(教科書事例を含む)をしばらく前から収集しています。スレッドの次の投稿で事例集スレッドにリンクを貼ります。
結論: フローチャート統計学は有害!
ただし、その内容自体が間違っているので、初学者にフローチャート統計学を教えることは極めて有害です。続く
結論: フローチャート統計学は有害!
ただし、その内容自体が間違っているので、初学者にフローチャート統計学を教えることは極めて有害です。続く
42
「不確実性ロンダリング」関連スレッド
↓
↓
黒木玄 Gen Kuroki@genkuroki
#統計 NotebookLMで作成した動画解説
sites.stat.columbia.edu/gelman/researc…
The Problems With P-Values are not Just With P-Values
Andrew Gelman
2016
P値に関するASA声明へのコメント。
「不確実性ロンダリング」
という秀逸なゲルマンさん用語がこの論文で誕生した。
sites.stat.columbia.edu/gelman/researc…
The Problems With P-Values are not Just With P-Values
Andrew Gelman
2016
P値に関するASA声明へのコメント。
「不確実性ロンダリング」
という秀逸なゲルマンさん用語がこの論文で誕生した。
43
須山さんは実際に普及しているフローチャートを見ていないせいでピントが外れたコメントをしていると思いました。
なぜならば実際に見ているならば、フローチャートの内容自体が間違っていることに気付いていたはずだからです。
AIでも出来るから悪いのではなく、統計学を誤用させているから悪い。

なぜならば実際に見ているならば、フローチャートの内容自体が間違っていることに気付いていたはずだからです。
AIでも出来るから悪いのではなく、統計学を誤用させているから悪い。
須山敦志 Suyama Atsushi@sammy_suyama
これは自分もかなり以前から指摘していますが、昨今ではさらに「フローチャートに従うだけならAIでも出来る」という事実が加わり、ますますアプローチとして無価値になっています
44
以下のリンク先のコメントも的を外しています。
日本に限らず、世界中で有意差の出し方の手続きのフローチャートが教えられており、その内容自体が間違っているせいで、フローチャートに従うと自動的に統計学を初歩的誤用をできるようになっています。
特に初学者にとって有害。社会的に大迷惑。
日本に限らず、世界中で有意差の出し方の手続きのフローチャートが教えられており、その内容自体が間違っているせいで、フローチャートに従うと自動的に統計学を初歩的誤用をできるようになっています。
特に初学者にとって有害。社会的に大迷惑。
須山敦志 Suyama Atsushi@sammy_suyama
今の時代であれば「フローチャート」ではなく「フレームワーク」を使うことをお勧めします。課題やデータに関する情報をフレームワークに従って細かく整理したうえで、試すべき手法に関して言語モデルに聞けばOK。極度に単純化されたフローチャートはお粗末すぎて何の役にも立ちません。
45
再掲: フローチャート統計学の実例を収集しているスレッド
フローチャートなら何でも悪いというような話ではなく、頻繁に出会うフローチャートは主に検定法選択の特定のフローチャートであり、しかもその内容が間違っており、初学者に数十年間ずっと教えられて来たことが問題なのです。
フローチャートなら何でも悪いというような話ではなく、頻繁に出会うフローチャートは主に検定法選択の特定のフローチャートであり、しかもその内容が間違っており、初学者に数十年間ずっと教えられて来たことが問題なのです。
黒木玄 Gen Kuroki@genkuroki
#統計 悪しきフローチャート統計学の例
例1
例1
46
#統計 普及しているフローチャートは、検定法選択の特定のフローチャートであり、実質的に「有意差の出し方のフローチャート」です。
そういうフローチャートは有意差の出し方の説明としても間違っているのですが、そもそも出発点の「有意差の出し方」という考え方自体が有害なので救いようがない。
そういうフローチャートは有意差の出し方の説明としても間違っているのですが、そもそも出発点の「有意差の出し方」という考え方自体が有害なので救いようがない。
47
#統計 つまらない(そして内容的にも間違っている)有意差の出し方のフローチャートの普及に背景には、「統計的に有意/非有意」「有意差あり/なし」のスタイルでの統計学教育があります。
現在では「コインが細工されている/いない」のスタイルで高校1年生にも教えられています。非常に深刻な問題。続く
現在では「コインが細工されている/いない」のスタイルで高校1年生にも教えられています。非常に深刻な問題。続く
48
#統計 さらにそういう深刻な状況を混乱させているのは、ある種のベイズ主義者達が、有用な道具であるP値の使用と帰無仮説有意性検定(もしくは統計的有意性)の使用を不適切に同一視して、P値の使用自体を否定していたりすることです。
色々酷いことになっています。
色々酷いことになっています。
49
#統計 統計学を何も理解していないままで「統計分析」して「報告」を書けるようにする「教育」が、恥知らずなことに大学などで数十年間に渡って堂々と行われて来たことの害が見えて来ているのだと思います。
これは非常に深刻な問題。
これは非常に深刻な問題。
50
#統計 これは世界的な問題で日本特有の問題ではない点も深刻。
51
#統計 添付画像に引用したような言説は、ただでさえ混乱している統計学教育をさらに混乱させる極めて有害な代物です。P値の使用とNHSTを多分同一視している。
信頼区間は「P値が特定の閾値以上になるモデルのパラメータの仮説値の範囲」なのに、信頼区間を「p値以外のアプローチ」扱いしていて酷い。


信頼区間は「P値が特定の閾値以上になるモデルのパラメータの仮説値の範囲」なのに、信頼区間を「p値以外のアプローチ」扱いしていて酷い。
スキル定義委員会 from データサイエンティスト協会@jdss_skill
【今日の1日1スキル👩💼】DS-56
科学的解析の基礎 - 推定・検定 ⭐️⭐️ 🔥必須🔥
p値だけでは仮説やモデルの正しさを評価できないことを理解し、p値以外のアプローチ(信頼区間、信用区間、ベイズファクターなど)と併せて透明性の高いデータ分析や結果の報告ができる
科学的解析の基礎 - 推定・検定 ⭐️⭐️ 🔥必須🔥
p値だけでは仮説やモデルの正しさを評価できないことを理解し、p値以外のアプローチ(信頼区間、信用区間、ベイズファクターなど)と併せて透明性の高いデータ分析や結果の報告ができる
52
#統計 良心的で冷静で合理的な統計学者達が提案しているのは、「P値の廃止」ではなく、「統計的有意性の廃止」(「有意差あり/なしの二分法の廃止」)です。
P値自体の問題ではなく、認知バイアスが原因の誤用が問題なので、P値を信頼区間やベイズ統計で置き換えても問題は何も解決しないわけです。
P値自体の問題ではなく、認知バイアスが原因の誤用が問題なので、P値を信頼区間やベイズ統計で置き換えても問題は何も解決しないわけです。
黒木玄 Gen Kuroki@genkuroki
#統計 統計的有意性の廃止提案論文 nature 2019 の日本語動画解説も作りました。
ポイント: compatibility→相性の良さと訳すと分かり易くなる。
scholar.google.co.jp/scholar?cluste…
Scientists rise up against statistical significance
Valentin Amrhein, Sander Greenland, and Blake McShane
nature 2019
ポイント: compatibility→相性の良さと訳すと分かり易くなる。
scholar.google.co.jp/scholar?cluste…
Scientists rise up against statistical significance
Valentin Amrhein, Sander Greenland, and Blake McShane
nature 2019
53
#統計 「自分は正しいやり方を知っている」と顧客に信じさせたい統計コンサルは「P値はもうダメです。これからは〇〇(例えばベイズ)です」のように言えばうまく行きやすいかもしれませんが、本当に問題なのは顧客の無知と認知バイアスであったりするわけです。耳の痛い話をするのは難しい。
54
#統計 あと、統計学を教えている人にとって、有意差の出し方のフローチャートを過去数十年間勧めて来た人が、自分の尊敬する先輩である場合もあると思います。
そういう人は、有意差の出し方のフローチャートが酷いことを知っていても、自分の先輩を名指しで批判しないかもしれない。
そういう人は、有意差の出し方のフローチャートが酷いことを知っていても、自分の先輩を名指しで批判しないかもしれない。
55
#統計 有意差の出し方のフローチャートは何十年間も実際に使われ続けて来たので、現在では、実際にそうすることに疑問を持たなかった人達が有意差の出し方のフローチャートを後輩に教えるようになっている。
そういう先輩氏は、フローチャートの誤りを指摘されても適切に訂正する能力自体がない。
そういう先輩氏は、フローチャートの誤りを指摘されても適切に訂正する能力自体がない。
56
#統計 有意差の出し方のフローチャートの普及問題は本当に深刻な問題。
せめて次の世代をそういうのに巻き込まれないようにして、科学的に普通にまともな考え方をできるようにして行かないとまずいと思います。
しかし、日本固有の問題ではなく、世界的な問題なので実際にそうするのは非常に大変。
せめて次の世代をそういうのに巻き込まれないようにして、科学的に普通にまともな考え方をできるようにして行かないとまずいと思います。
しかし、日本固有の問題ではなく、世界的な問題なので実際にそうするのは非常に大変。