We ran GPT-6 Astra across 6 agent harnesses (Codex, Claude Code,...

Composio@composio
316 views
Sep 17, 2026
~2 min read
Advertisement
1
We ran GPT-6 Astra across 6 agent harnesses (Codex, Claude Code, OpenCode, Hermes Agent, Pi Agent, Command Code) on 29 challenging agentic tasks.
Most harnesses succeeded at similar rates. But when they failed, they used 3–5x as many tokens, depending on the harness. 🧵🧵🧵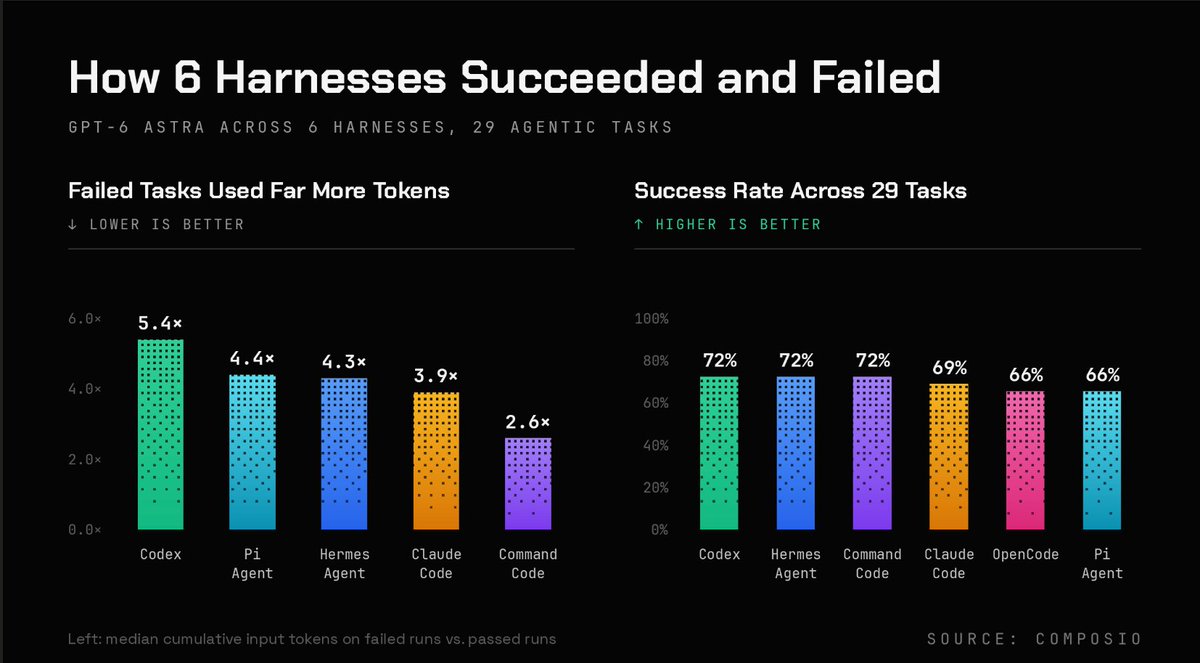
Most harnesses succeeded at similar rates. But when they failed, they used 3–5x as many tokens, depending on the harness. 🧵🧵🧵
2
Here's how all 6 harnesses compared on task success rate:
Codex, Hermes Agent, and Command Code tied for the lead at 21/29. Claude Code was one task behind, while OpenCode and Pi Agent finished at 19/29.
The spread was about 7 percentage points. Only 3 tasks produced different results across harnesses: 18 passed across the board, and 8 tasks also failed across all harnesses.
3
The bigger difference showed up in the failed runs.*
Across the harnesses we tested, a failed task used 3–5x more tokens than a successful one.
So while the final scores were close, failure was consistently expensive.
*OpenCode didn't report the tokens it used for Astra
Across the harnesses we tested, a failed task used 3–5x more tokens than a successful one.
So while the final scores were close, failure was consistently expensive.
*OpenCode didn't report the tokens it used for Astra
4
Does Claude Code’s higher token use mean it was more persistent?
Not exactly.
Claude Code had the highest median tool-call count on BOTH universally passed and failed tasks.
OpenCode was the leanest harness here, making the fewest calls in both groups.
Not exactly.
Claude Code had the highest median tool-call count on BOTH universally passed and failed tasks.
OpenCode was the leanest harness here, making the fewest calls in both groups.
5
How did those tool calls translate into cost?
Estimated cost per successful task ranged from $1.06 with Pi Agent to $2.62 with Claude Code, a 2.5x difference driven solely by harness choice.
Estimated cost per successful task ranged from $1.06 with Pi Agent to $2.62 with Claude Code, a 2.5x difference driven solely by harness choice.
6
What about speed?
Pi Agent, Codex, and Hermes were effectively tied on speed, with median task times of 99, 100, and 102 seconds.
Claude Code took 201 seconds – about twice as long.
Pi Agent, Codex, and Hermes were effectively tied on speed, with median task times of 99, 100, and 102 seconds.
Claude Code took 201 seconds – about twice as long.
7
The takeaway: all six harnesses were much closer in capability than in efficiency.
Success rates were similar, but median completion time varied by 2x and cost per solved task by 2.5x.
With SOTA models like Astra, choosing a harness is as much about efficiency as capability.
Success rates were similar, but median completion time varied by 2x and cost per solved task by 2.5x.
With SOTA models like Astra, choosing a harness is as much about efficiency as capability.
