hace unos días publiqué un gráfico sobre la evolución de los...

pablo@pablogguz_
19 views
Oct 13, 2025
~6 min read
Advertisement
1
hace unos días publiqué un gráfico sobre la evolución de los salarios por grupo de edad y cohortes de nacimiento en españa que tuvo bastante difusión. hoy @kikollan publica en el país un (fantástico) análisis en el que muestra un gráfico similar (elpais.com/espana/2025-06…), utilizando datos de la misma fuente primaria, en el que se muestra una evolución prácticamente plana entre cohortes. esto pareciera contradecir los resultados que resaltaba en mi post original ("los nacidos en los 60 cobraban de media un 20% más en la treintena que los nacidos en los 80").
he intercambiado ideas con kiko estos días y voy a intentar aclarar de dónde salen las diferencias en este post.
el contexto: ¿qué datos tenemos?
en mi post original, trabajé con los microdatos de la encuesta de estructura salarial, que solo están disponibles (públicamente) en años específicos: 1995, 2002, 2006, 2010, 2014, 2018 y 2022. en cada año observamos el salario de trabajadores agrupados en bandas de edad de 10 años (20-29, 30-39, etc.).
para asignar cada observación a una "década de nacimiento", uso el punto medio de la banda de nacimiento correspondiente para cada grupo de edad. por ejemplo, en el año 2022, el grupo 20-29 fueron los nacidos entre 1993-2002 → punto medio 1997.5 → asigno a "1990s". pero esta simplificación genera un problema de solapamiento que da más peso a los nacidos en la mitad de la década.
el problema: solapamiento y ponderación desigual
pensemos en la década de los 80. la media en el grupo 20-29 incluye tres bandas de nacimiento que se solapan parcialmente:
→ 1977-1986 (datos de 2006)
→ 1981-1990 (datos de 2010)
→ 1985-1994 (datos de 2014)
si "expandimos" las bandas de nacimiento, ¿cuántas veces aparece cada año individual? en este caso, los nacidos entre 1977-1980 cuentan 1 vez, los nacidos entre 1981-1985 2 veces, los nacidos en el 1986 3 veces, los nacidos en 1987-1990 2 veces, y los nacidos en 1991-1994 1 vez.
en este caso, los nacidos en 1986 tienen más peso que los nacidos al inicio y final de la década. es decir, que la media de las cohortes está sesgada hacia su centro.
algunos de vosotros os preguntaréis si, adicionalmente, existe un problema de efecto composición por edad. tras romperme la cabeza un par de días (😅) la respuesta es no: al asignar décadas usando el punto medio, cada observación siempre representa el salario medio de personas en el mismo rango de edad.
veámoslo con un ejemplo. cuando calculo el salario de la "década 1990s" en el grupo 20-29:
→ en 2018: observo a nacidos 1989-1998 cuando tienen 20-29 años
→ en 2022: observo a nacidos 1993-2002 cuando tienen 20-29 años
un posible argumento es el siguiente: la década de los 1990 no está capturando a los nacidos a final de década cuando llegan a la parte alta de la banda de edad, mientras que en cohortes más mayores sí los observas. si esto sucede, los más jóvenes dentro de la banda tendrían más peso en cohortes más jóvenes, lo que sesgaría el salario medio a la baja.
pero esta crítica no aplica. la clave está en entender qué define una "década" con el punto medio: por ejemplo, en el caso de la cohorte de los 80 y grupo de edad 20-29, las bandas de nacimiento incluidas son 1977-1986 (año 2006), 1981-1990 (año 2010) y 1985-1994 (año 2014). en este caso, lo que se ganaría al incluir los nacidos tardíos de los 80 en 2014 (relativo a la cohorte de los 90, para los que los nacidos a final de década no se observan todavía) se compensa al incluir los nacidos tempranos de los 90 en edades bajas. en otras palabras, el mix de edades siempre se mantiene constante en cada cohorte.
las diferencias con el gráfico de kiko
en lugar de utilizar los microdatos, se pueden obtener directamente los datos de salario medio por grupo de edad quinquenal de las tablas predefinidas del ine. esto tiene dos ventajas obvias: (i) permite definir los grupos de edad en bandas de 5 años en vez de 10, y (ii) las tablas predefinidas incluyen datos con frecuencia anual a partir de 2008 (para los cuales no hay microdatos públicos disponibles más allá de las encuestas cuatrienales)
es decir, ahora observamos el salario medio para los grupos de edad 20-24, 25-29, etc. en todos los años de la encuesta cuatrienal más en todos los años de 2008 a 2023.
kiko recopila estos datos y opta por lo siguiente: elegir cohortes específicas de 5 años que se pueden seguir completamente en cada banda de edad quinquenal. voy a referirme a esta propiedad como la condición de celdas completas.
veámoslo con el ejemplo de kiko. en su gráfico, muestra las cohortes 1989-1993, 1979-1983, 1969-1973 y 1959-1963. como las cohortes tienen el mismo ancho que los grupos de edad (5 años), cada cohorte se observa exactamente una vez en cada grupo de edad. una forma de visualizarlo es la siguiente:
de esta forma, se elimina el problema de solapamiento y ponderación desigual.
pero (y esto es crucial): hay múltiples combinaciones válidas! existen varios sets de cohortes de 5 años que igualmente cumplen esta condición de celdas completas. por ejemplo:
set a (el de kiko): 89-93, 79-83, 69-73, 59-63
set b: 88-92, 78-82, 68-72, 58-62
set c: 90-94, 80-84, 70-74, 60-64
etc.
todas estas combinaciones tienen la misma propiedad: cada cohorte puede seguirse limpiamente a través de los grupos quinquenales. aquí muestro los resultados seleccionando las cohortes del último ejemplo: en este caso, sí que se ven escalones claros.
mi enfoque: usar todos los datos
para evitar elegir arbitrariamente un set de cohortes determinado, lo más transparente es intentar usar todos los datos disponibles.
para corregir el sesgo de solapamiento, una posible solución es hacer una “expansión lexis”: en lugar de promediar directamente las observaciones, podemos expandir cada banda de nacimiento a observaciones individuales por año. por ejemplo, la banda 1986-1990 con salario medio de €20,000 se convierte en cinco observaciones: una para cada año de nacimiento, cada una con el salario ajustado por edad.
dentro de cada banda de edad, asumo que los salarios crecen aproximadamente 2.5% en términos reales por año. por ejemplo, si el salario medio de una banda 20-24 es €20,000 (asumiendo que corresponde a la edad media 22), las observaciones con edad 24 tendrán un salario 1.025^2 veces superior. para preservar la media original de cada grupo de edad, divido cada salario ajustado por el promedio de los factores de crecimiento dentro de la celda.
después de expandir y ajustar, calculo la media por año de nacimiento (de este modo, cada año cuenta sólo una vez) y luego por década. este método elimina el sesgo de solapamiento mientras mantiene toda la información disponible. los resultados quedan así:
los números no cambian sustancialmente respecto a mi gráfico original. los nacidos en los 80 cobraban, de media, un 20% menos en la treintena que los nacidos en los 60.
por último, quiero agradecer especialmente a @kikollan la conversación y el intercambio de ideas que ha enriquecido este análisis y me ha empujado a profundizar en los aspectos técnicos. naturalmente, cualquier error o imprecisión en este post es responsabilidad exclusivamente mía. si me he colado en algún aspecto del argumento o hay puntos que no he considerado adecuadamente, estoy completamente abierto a críticas y comentarios!
p.d.: estoy intentando conseguir los microdatos con la variable exacta de fecha de nacimiento. esto despejará toda duda metodológica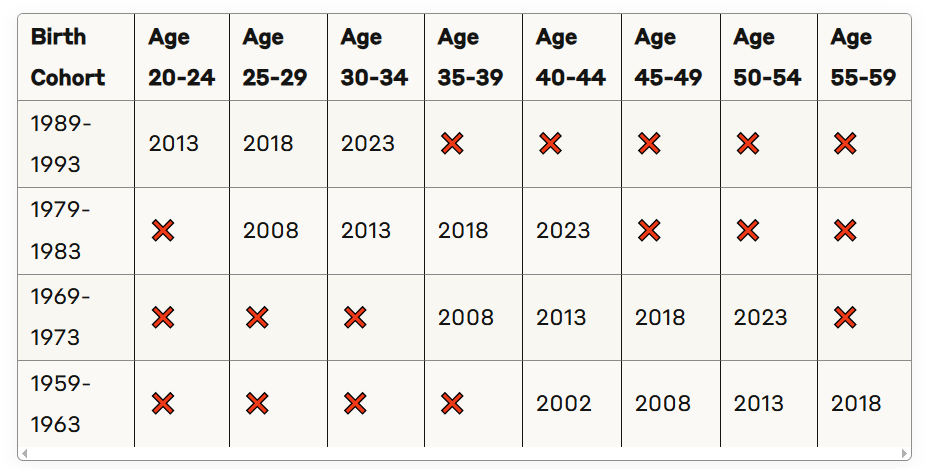


he intercambiado ideas con kiko estos días y voy a intentar aclarar de dónde salen las diferencias en este post.
el contexto: ¿qué datos tenemos?
en mi post original, trabajé con los microdatos de la encuesta de estructura salarial, que solo están disponibles (públicamente) en años específicos: 1995, 2002, 2006, 2010, 2014, 2018 y 2022. en cada año observamos el salario de trabajadores agrupados en bandas de edad de 10 años (20-29, 30-39, etc.).
para asignar cada observación a una "década de nacimiento", uso el punto medio de la banda de nacimiento correspondiente para cada grupo de edad. por ejemplo, en el año 2022, el grupo 20-29 fueron los nacidos entre 1993-2002 → punto medio 1997.5 → asigno a "1990s". pero esta simplificación genera un problema de solapamiento que da más peso a los nacidos en la mitad de la década.
el problema: solapamiento y ponderación desigual
pensemos en la década de los 80. la media en el grupo 20-29 incluye tres bandas de nacimiento que se solapan parcialmente:
→ 1977-1986 (datos de 2006)
→ 1981-1990 (datos de 2010)
→ 1985-1994 (datos de 2014)
si "expandimos" las bandas de nacimiento, ¿cuántas veces aparece cada año individual? en este caso, los nacidos entre 1977-1980 cuentan 1 vez, los nacidos entre 1981-1985 2 veces, los nacidos en el 1986 3 veces, los nacidos en 1987-1990 2 veces, y los nacidos en 1991-1994 1 vez.
en este caso, los nacidos en 1986 tienen más peso que los nacidos al inicio y final de la década. es decir, que la media de las cohortes está sesgada hacia su centro.
algunos de vosotros os preguntaréis si, adicionalmente, existe un problema de efecto composición por edad. tras romperme la cabeza un par de días (😅) la respuesta es no: al asignar décadas usando el punto medio, cada observación siempre representa el salario medio de personas en el mismo rango de edad.
veámoslo con un ejemplo. cuando calculo el salario de la "década 1990s" en el grupo 20-29:
→ en 2018: observo a nacidos 1989-1998 cuando tienen 20-29 años
→ en 2022: observo a nacidos 1993-2002 cuando tienen 20-29 años
un posible argumento es el siguiente: la década de los 1990 no está capturando a los nacidos a final de década cuando llegan a la parte alta de la banda de edad, mientras que en cohortes más mayores sí los observas. si esto sucede, los más jóvenes dentro de la banda tendrían más peso en cohortes más jóvenes, lo que sesgaría el salario medio a la baja.
pero esta crítica no aplica. la clave está en entender qué define una "década" con el punto medio: por ejemplo, en el caso de la cohorte de los 80 y grupo de edad 20-29, las bandas de nacimiento incluidas son 1977-1986 (año 2006), 1981-1990 (año 2010) y 1985-1994 (año 2014). en este caso, lo que se ganaría al incluir los nacidos tardíos de los 80 en 2014 (relativo a la cohorte de los 90, para los que los nacidos a final de década no se observan todavía) se compensa al incluir los nacidos tempranos de los 90 en edades bajas. en otras palabras, el mix de edades siempre se mantiene constante en cada cohorte.
las diferencias con el gráfico de kiko
en lugar de utilizar los microdatos, se pueden obtener directamente los datos de salario medio por grupo de edad quinquenal de las tablas predefinidas del ine. esto tiene dos ventajas obvias: (i) permite definir los grupos de edad en bandas de 5 años en vez de 10, y (ii) las tablas predefinidas incluyen datos con frecuencia anual a partir de 2008 (para los cuales no hay microdatos públicos disponibles más allá de las encuestas cuatrienales)
es decir, ahora observamos el salario medio para los grupos de edad 20-24, 25-29, etc. en todos los años de la encuesta cuatrienal más en todos los años de 2008 a 2023.
kiko recopila estos datos y opta por lo siguiente: elegir cohortes específicas de 5 años que se pueden seguir completamente en cada banda de edad quinquenal. voy a referirme a esta propiedad como la condición de celdas completas.
veámoslo con el ejemplo de kiko. en su gráfico, muestra las cohortes 1989-1993, 1979-1983, 1969-1973 y 1959-1963. como las cohortes tienen el mismo ancho que los grupos de edad (5 años), cada cohorte se observa exactamente una vez en cada grupo de edad. una forma de visualizarlo es la siguiente:
de esta forma, se elimina el problema de solapamiento y ponderación desigual.
pero (y esto es crucial): hay múltiples combinaciones válidas! existen varios sets de cohortes de 5 años que igualmente cumplen esta condición de celdas completas. por ejemplo:
set a (el de kiko): 89-93, 79-83, 69-73, 59-63
set b: 88-92, 78-82, 68-72, 58-62
set c: 90-94, 80-84, 70-74, 60-64
etc.
todas estas combinaciones tienen la misma propiedad: cada cohorte puede seguirse limpiamente a través de los grupos quinquenales. aquí muestro los resultados seleccionando las cohortes del último ejemplo: en este caso, sí que se ven escalones claros.
mi enfoque: usar todos los datos
para evitar elegir arbitrariamente un set de cohortes determinado, lo más transparente es intentar usar todos los datos disponibles.
para corregir el sesgo de solapamiento, una posible solución es hacer una “expansión lexis”: en lugar de promediar directamente las observaciones, podemos expandir cada banda de nacimiento a observaciones individuales por año. por ejemplo, la banda 1986-1990 con salario medio de €20,000 se convierte en cinco observaciones: una para cada año de nacimiento, cada una con el salario ajustado por edad.
dentro de cada banda de edad, asumo que los salarios crecen aproximadamente 2.5% en términos reales por año. por ejemplo, si el salario medio de una banda 20-24 es €20,000 (asumiendo que corresponde a la edad media 22), las observaciones con edad 24 tendrán un salario 1.025^2 veces superior. para preservar la media original de cada grupo de edad, divido cada salario ajustado por el promedio de los factores de crecimiento dentro de la celda.
después de expandir y ajustar, calculo la media por año de nacimiento (de este modo, cada año cuenta sólo una vez) y luego por década. este método elimina el sesgo de solapamiento mientras mantiene toda la información disponible. los resultados quedan así:
los números no cambian sustancialmente respecto a mi gráfico original. los nacidos en los 80 cobraban, de media, un 20% menos en la treintena que los nacidos en los 60.
por último, quiero agradecer especialmente a @kikollan la conversación y el intercambio de ideas que ha enriquecido este análisis y me ha empujado a profundizar en los aspectos técnicos. naturalmente, cualquier error o imprecisión en este post es responsabilidad exclusivamente mía. si me he colado en algún aspecto del argumento o hay puntos que no he considerado adecuadamente, estoy completamente abierto a críticas y comentarios!
p.d.: estoy intentando conseguir los microdatos con la variable exacta de fecha de nacimiento. esto despejará toda duda metodológica