#統計 医療統計の分野では、 ❌正規母集団でなければt検定をつかえない。 という酷い教え方のせいで、...

黒木玄 Gen Kuroki@genkuroki
69 views
Apr 10, 2025
~3 min read
Advertisement
1
#統計 医療統計の分野では、
❌正規母集団でなければt検定をつかえない。
という酷い教え方のせいで、
❌ノンパラメトリック検定ならばいつでも使える。
という極めて有害な誤解に誘導され、実際に安易にノンパラ検定を使って論文を書いてしまう科学的に有害な人達を増やして来た。
大問題。
x.com/kent_sak/statu…
❌正規母集団でなければt検定をつかえない。
という酷い教え方のせいで、
❌ノンパラメトリック検定ならばいつでも使える。
という極めて有害な誤解に誘導され、実際に安易にノンパラ検定を使って論文を書いてしまう科学的に有害な人達を増やして来た。
大問題。
x.com/kent_sak/statu…
2
#統計
best-biostatistics.com/stat-test/w-te… の添付画像の部分を見て、【日本の生物統計の第一人者の大橋靖男先生】について検索してみた。
論理を蔑ろにしてかつ権威に頼る議論の仕方は、非科学的という形容がふさわしいやり方の典型例になる。続く
best-biostatistics.com/stat-test/w-te… の添付画像の部分を見て、【日本の生物統計の第一人者の大橋靖男先生】について検索してみた。
論理を蔑ろにしてかつ権威に頼る議論の仕方は、非科学的という形容がふさわしいやり方の典型例になる。続く
3
#統計 【日本の生物統計の第一人者の大橋靖男先生】については、以下を発見できた。
正規でなければt検定を使えないという誤解によって、常に使用可能なわけではないノンパラメトリック検定に安易に誘導することになる有害なフローチャートを引用していた。
これはアウト!
google.com/search?q=%22%E…
正規でなければt検定を使えないという誤解によって、常に使用可能なわけではないノンパラメトリック検定に安易に誘導することになる有害なフローチャートを引用していた。
これはアウト!
google.com/search?q=%22%E…
4
#統計 他の事例
丹後俊郎『統計学のセンス』(1998)でのWilcoxonの順位和検定(=Mann-WhitneyのU検定)の勧め方(再掲)
Studentのt検定が図の(b)(c)の場合に信頼できなくなったりするという理由でWの順位和検定を勧めている!
これは致命的な誤り!
(b)(c)の場合にWの順位和検定を使ってはいけない。
丹後俊郎『統計学のセンス』(1998)でのWilcoxonの順位和検定(=Mann-WhitneyのU検定)の勧め方(再掲)
Studentのt検定が図の(b)(c)の場合に信頼できなくなったりするという理由でWの順位和検定を勧めている!
これは致命的な誤り!
(b)(c)の場合にWの順位和検定を使ってはいけない。
5
#統計 Welchのt検定を最初から使えば良いのに、等分散性を使うStudentのt検定を持ち出す伝統もあきれたものだと思います。
丹後さんの本では、よりにもよって、等分散でない場合にWilcoxonの順位和検定を勧めるという極めて有害な行為をしている。
これは相当に酷い。
丹後さんの本では、よりにもよって、等分散でない場合にWilcoxonの順位和検定を勧めるという極めて有害な行為をしている。
これは相当に酷い。
6
#統計 粕谷氏曰く【しかし、不等分散のときに好 んでU検定を使っている例がかなりあるようです。】(註:Wilcoxonの順位和検定はMann-WhitneyのU検定に等しい)
kasuya.ecology1.org/stats/utest01.…
おそらく、丹後氏のような致命的な誤解をしている人達がかなりいるのでしょう。
kasuya.ecology1.org/stats/utest01.…
おそらく、丹後氏のような致命的な誤解をしている人達がかなりいるのでしょう。
7
#統計 警告: kasuya.ecology1.org/stats/utest01.… を読むと、
❌等分散であればMann-WhitneyのU検定=Wilcoxonの順位和検定を使える。
と誤解する危険性があるので注意してください。
等分散性は十分条件ではありません。
❌等分散であればMann-WhitneyのU検定=Wilcoxonの順位和検定を使える。
と誤解する危険性があるので注意してください。
等分散性は十分条件ではありません。
8
#統計 Welchのt検定の論文 doi.org/10.1093/biomet… は1947年に出版されているのに、なぜか使用可能条件が厳しいStudentのt検定を紹介する傾向がある。
同様に、Brunner-Munzel検定の論文 researchgate.net/profile/Edgar-… は2000年に出版されているのに、なぜか今もWilcoxonの順位和検定を勧める傾向がある。
同様に、Brunner-Munzel検定の論文 researchgate.net/profile/Edgar-… は2000年に出版されているのに、なぜか今もWilcoxonの順位和検定を勧める傾向がある。
9
#統計 Brunner-Munzel検定の検定統計量は、本質的にMann-WhitneyのU検定(Wilcoxonの順位和検定と同等)の検定統計量と本質的に同じ。違うのは検定統計量の分散の推定の仕方。
MWのU検定では2つの母集団分布が等しいという超絶強い仮定を使って検定統計量の分散を見積もるが、BM検定はそうではない。
MWのU検定では2つの母集団分布が等しいという超絶強い仮定を使って検定統計量の分散を見積もるが、BM検定はそうではない。
10
#統計 Welchのt検定がStudentのt検定の上位互換になっていることと、Brunner-Munzel検定がWilcoxonの順位和検定=Mann-WhitneyのU検定の上位互換になっていることは似ています。
しかし、安易にBM検定を勧めることも科学的に有害。違いの指標選択に無頓着に「有意差を出す」という発想自体が有害。
しかし、安易にBM検定を勧めることも科学的に有害。違いの指標選択に無頓着に「有意差を出す」という発想自体が有害。
11
#統計 母集団分布1,2に従う確率変数をX,Yと書くとき、Welch及びStudentのt検定では
母平均の差 = E[X] - E[Y]
を違いの指標として使います。Brunner-Munzel検定やWilcoxonの順位和検定では
Y側の勝率=P(X<Y)+P(X=Y)/2
と1/2の差を違いの指標として使います。
全然違う「違い」をみています。
母平均の差 = E[X] - E[Y]
を違いの指標として使います。Brunner-Munzel検定やWilcoxonの順位和検定では
Y側の勝率=P(X<Y)+P(X=Y)/2
と1/2の差を違いの指標として使います。
全然違う「違い」をみています。
12
#統計 検定法を変えると異なる「違い」を計測することになるので、検定法を選択する場合には、自分の目的のためにはどのような「違い」を計測することが適切であるかについてよく考えておく必要があります。
こういう当たり前の考え方をせずに、とにかく有意差を出せばよいとするのはおかしいです。
こういう当たり前の考え方をせずに、とにかく有意差を出せばよいとするのはおかしいです。
13
#統計 当たり前の科学的に常識的な考え方を蔑ろにする行為はやめるべきです。
そして、偉くなった先生達が当たり前の科学的に常識的な考え方を蔑ろにしていることを発見したら、言葉を濁さずに明瞭に否定することも必要だと思います。
それをできない人達は権威に負けており、科学的ではない。
そして、偉くなった先生達が当たり前の科学的に常識的な考え方を蔑ろにしていることを発見したら、言葉を濁さずに明瞭に否定することも必要だと思います。
それをできない人達は権威に負けており、科学的ではない。
14
訂正【大橋靖男先生ではなく、大橋靖雄先生】
謝罪
↓

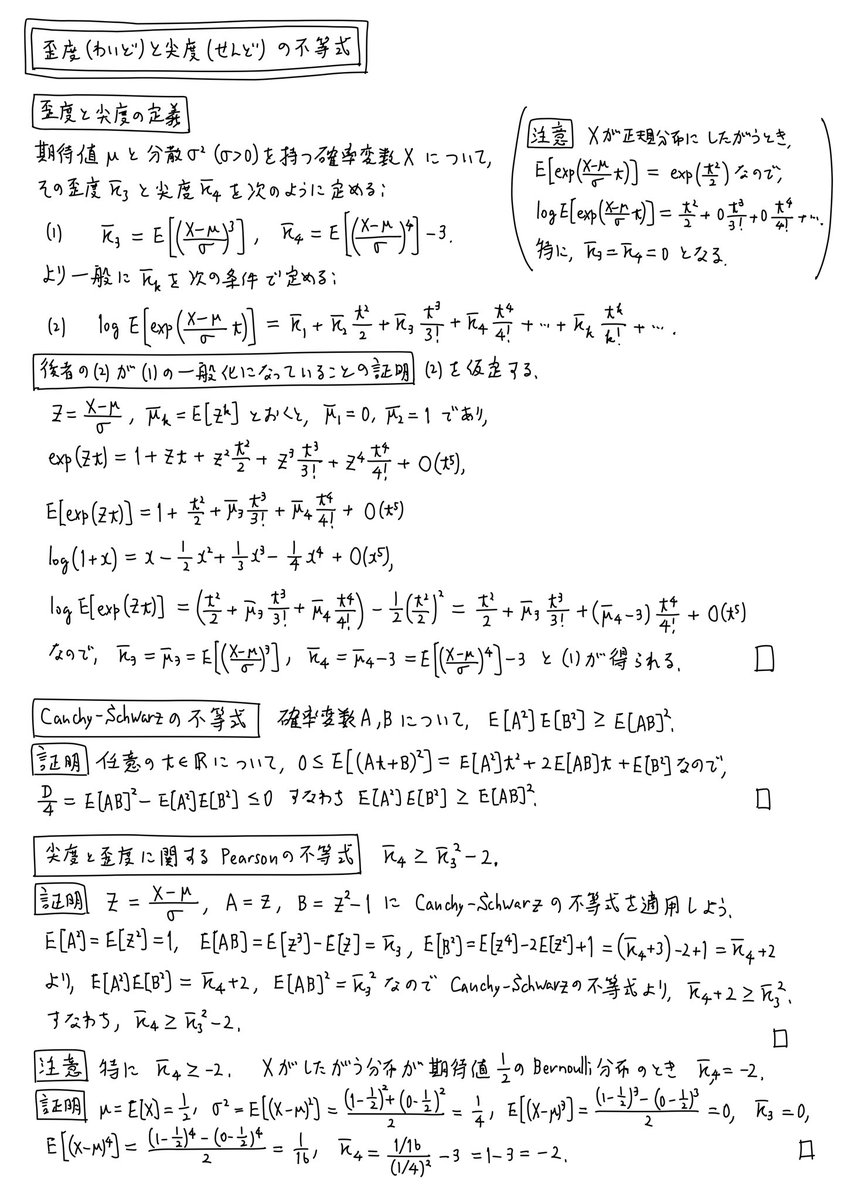
謝罪
↓
黒木玄 Gen Kuroki@genkuroki
@yanami85 謝罪
best-biostatistics.com/stat-test/w-te… (添付画像)
に【大橋靖男先生】と書いてあったのをそのままコピーして使っていたせいで、正しくは大橋靖雄先生であったことに気付いてませんでした。
名前を繰り返し間違って書いてしまったことを大橋先生と読者の皆さんにお詫び致します。ごめんなさい。
best-biostatistics.com/stat-test/w-te… (添付画像)
に【大橋靖男先生】と書いてあったのをそのままコピーして使っていたせいで、正しくは大橋靖雄先生であったことに気付いてませんでした。
名前を繰り返し間違って書いてしまったことを大橋先生と読者の皆さんにお詫び致します。ごめんなさい。
15
#統計 ノンパラメトリック検定に関する解説はおかしなものの方が多数派で、しかもまともに訂正される気配が感じられない。
どうして同業者達が訂正させる方向に動かないのか?
私は誤りを指摘してくれる人達にいつも助けられています。
そういう世界になっていないように見える。
事例
↓
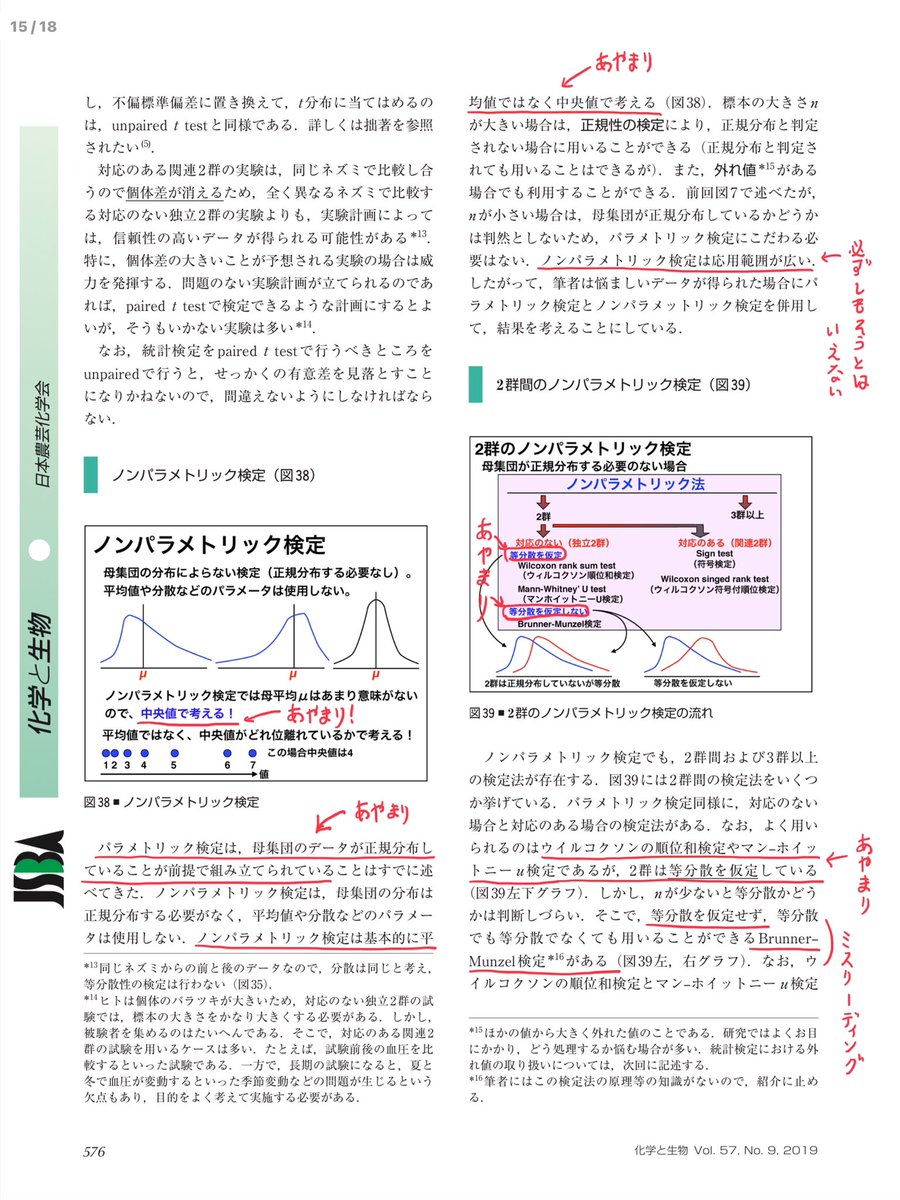
どうして同業者達が訂正させる方向に動かないのか?
私は誤りを指摘してくれる人達にいつも助けられています。
そういう世界になっていないように見える。
事例
↓
黒木玄 Gen Kuroki@genkuroki
#統計
jstage.jst.go.jp/article/kagaku…
改訂増補版:統計検定を理解せずに使っている人のためにII
池田 郁男
化学と生物57 巻 (2019) 9 号
これは3年前なのですが、いつものよく見る誤解がもろに説明されています。
現代でもこういうので統計学入門の勉強をしてしまう人達がいるわけです。非常に残念。続く
jstage.jst.go.jp/article/kagaku…
改訂増補版:統計検定を理解せずに使っている人のためにII
池田 郁男
化学と生物57 巻 (2019) 9 号
これは3年前なのですが、いつものよく見る誤解がもろに説明されています。
現代でもこういうので統計学入門の勉強をしてしまう人達がいるわけです。非常に残念。続く
16
以下の件も訂正される気配が感じられない。
誤りを認め、どこが誤りだったかを正確に説明して、訂正版の文に差し替える、というプロセスを見てみたい。
そもそも誤りだと思っていないのか、誤りだと認識しているが訂正の仕方がわからないのか、全てが不明。
事例
↓
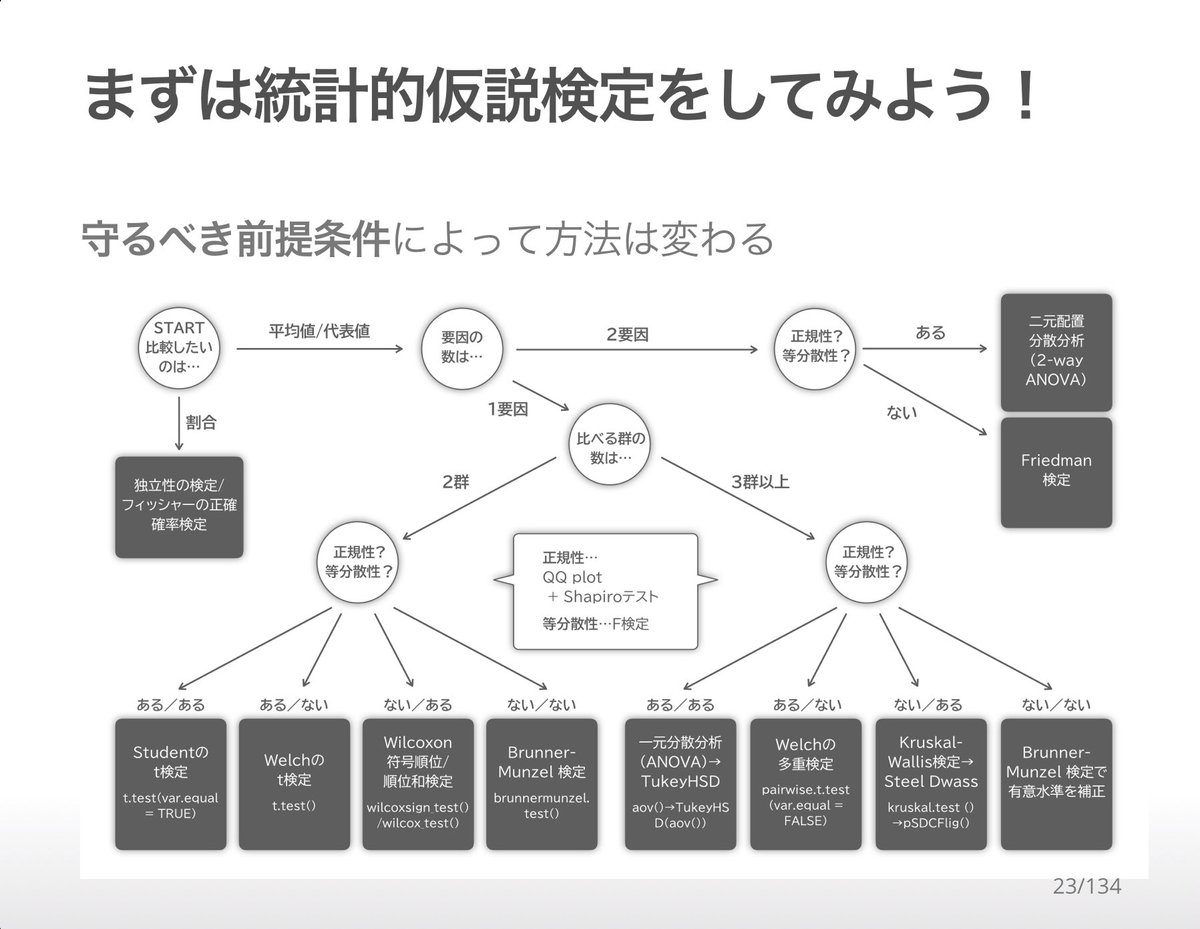
誤りを認め、どこが誤りだったかを正確に説明して、訂正版の文に差し替える、というプロセスを見てみたい。
そもそも誤りだと思っていないのか、誤りだと認識しているが訂正の仕方がわからないのか、全てが不明。
事例
↓
黒木玄 Gen Kuroki@genkuroki
#統計 高等教育機関は、引用したフローチャートに従って統計分析を行う学生には統計学の単位を出すべきではないと私は思います。
なぜならば酷く間違った考え方をしているからです。
以下では「2群」の場合に制限して、具体的にどこが間違っているかを説明します。続く
comicalcommet.github.io/r-training-202…
なぜならば酷く間違った考え方をしているからです。
以下では「2群」の場合に制限して、具体的にどこが間違っているかを説明します。続く
comicalcommet.github.io/r-training-202…
17
#統計 Mann-WhitneyのU検定のU統計量は、
h(x,y)=if x<y then 1 else if x=y then 1/2 else 0
とおいたときの、2つの標本X₁,…,XₘとY₁,…,Xₙに関する
U=Σh(Xᵢ,Yⱼ)
です。このとき、
p̂ = U/(mn)
は
Y側の勝率=P(X<Y)+P(X=Y)/2
の不偏推定量になっている。
h(x,y)=if x<y then 1 else if x=y then 1/2 else 0
とおいたときの、2つの標本X₁,…,XₘとY₁,…,Xₙに関する
U=Σh(Xᵢ,Yⱼ)
です。このとき、
p̂ = U/(mn)
は
Y側の勝率=P(X<Y)+P(X=Y)/2
の不偏推定量になっている。
黒木玄 Gen Kuroki@genkuroki
#統計 母集団分布1,2に従う確率変数をX,Yと書くとき、Welch及びStudentのt検定では
母平均の差 = E[X] - E[Y]
を違いの指標として使います。Brunner-Munzel検定やWilcoxonの順位和検定では
Y側の勝率=P(X<Y)+P(X=Y)/2
と1/2の差を違いの指標として使います。
全然違う「違い」をみています。
母平均の差 = E[X] - E[Y]
を違いの指標として使います。Brunner-Munzel検定やWilcoxonの順位和検定では
Y側の勝率=P(X<Y)+P(X=Y)/2
と1/2の差を違いの指標として使います。
全然違う「違い」をみています。
18
#統計 Mann-WhitneyのU検定では上のUとmn/2の差を扱い、Brunner-Munzel検定ではp̂=U/(mn)と1/2の差を扱います。
このことから、それらの検定は、本質的に、大きな値が勝つ(引き分けなら1/2勝)というルールのゲームでの勝率を扱っていることが分かります。
続く
このことから、それらの検定は、本質的に、大きな値が勝つ(引き分けなら1/2勝)というルールのゲームでの勝率を扱っていることが分かります。
続く
19
#統計 Mann-WhitneyのU検定のU統計量やBrunner-Munzel検定のp̂が何であるか知っていれば、それらの検定について
❌中央値の差の検定である
と言えるはずがない。
⭕️勝率と1/2の差の検定である
のように言いたくなるはず。
MWのU検定を「Uが何であるか」さえ理解せずに使っているのではないか?
❌中央値の差の検定である
と言えるはずがない。
⭕️勝率と1/2の差の検定である
のように言いたくなるはず。
MWのU検定を「Uが何であるか」さえ理解せずに使っているのではないか?
20
#統計 このスレッドの件で印象が悪い点は、t検定やWilcoxonの順位和検定(=Mann-WhitneyのU検定)のような特別に高級な話題とは言えそうもない基本的な事柄について、集団でおかしな考え方を継続的に教え続けていることです。
しかも指摘しても慌てて訂正しようとする人が見当たらない。
しかも指摘しても慌てて訂正しようとする人が見当たらない。
21
#統計 この件について何がつらいか?
Mann-WhitneyのU検定=Wilcoxonの順位和検定に関する解説をチェックするたびに、社会的に統計学の専門家とみなされる立場の人が相当に杜撰な解説をしていると気付いてしまうこと。
見つけた事例を全部紹介しているわけではない。
精神的につらい。
Mann-WhitneyのU検定=Wilcoxonの順位和検定に関する解説をチェックするたびに、社会的に統計学の専門家とみなされる立場の人が相当に杜撰な解説をしていると気付いてしまうこと。
見つけた事例を全部紹介しているわけではない。
精神的につらい。
22
ブロックが原因で文脈をたどり難くなることを防ぐためのスクショによる引用。


黒木玄 Gen Kuroki@genkuroki
#統計 医療統計の分野では、
❌正規母集団でなければt検定をつかえない。
という酷い教え方のせいで、
❌ノンパラメトリック検定ならばいつでも使える。
という極めて有害な誤解に誘導され、実際に安易にノンパラ検定を使って論文を書いてしまう科学的に有害な人達を増やして来た。
大問題。
❌正規母集団でなければt検定をつかえない。
という酷い教え方のせいで、
❌ノンパラメトリック検定ならばいつでも使える。
という極めて有害な誤解に誘導され、実際に安易にノンパラ検定を使って論文を書いてしまう科学的に有害な人達を増やして来た。
大問題。
23
これも文脈をたどり易くするためのリンク。

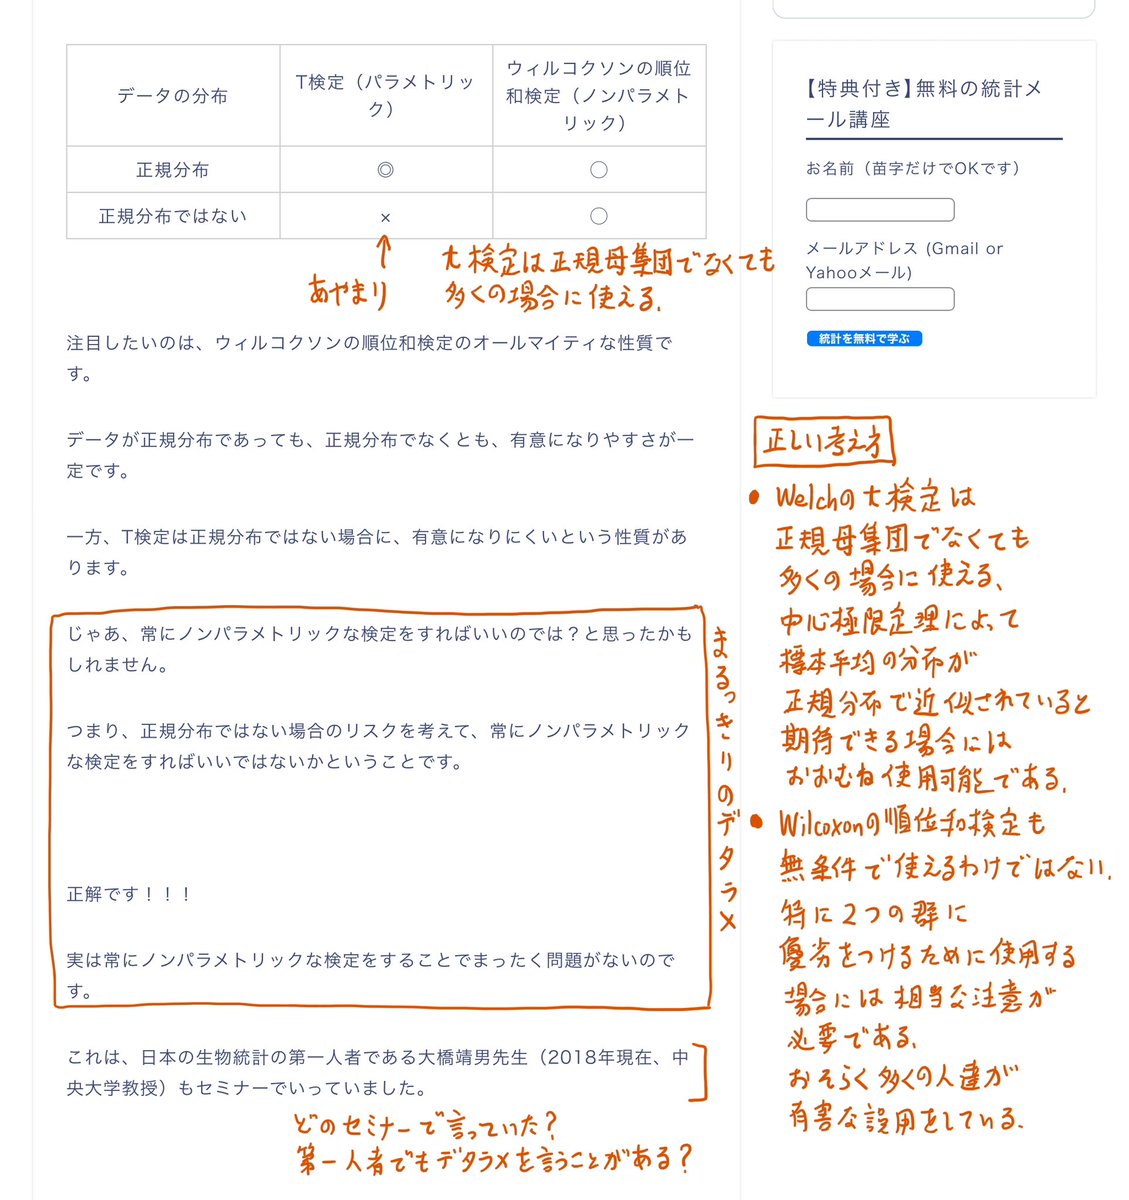
黒木玄 Gen Kuroki@genkuroki
@yanami85 #統計 医療統計の分野で安易にWilcoxonの順位和検定=Mann-WhitneyのU検定を使われてしまうと、再現性がない結果が論文として発表される場合が増えて、長期的には、医学の発展を遅らせて、我々の生活に害を与える可能性があると思いました。
ブロックせずに、誤りを認めて欲しかった。
ブロックせずに、誤りを認めて欲しかった。
24
#統計
❌t検定の前にF検定をやるかどうか
おそらく、そのt検定は等分散の仮定から得られるStudentのt検定のことだと思います。
「F検定→t検定」という流れは多重検定になるので好ましくないです。
⭕️F検定をやらずに、常にWelchのt検定を使う
と良いというのが現代の常識だと思いました。

❌t検定の前にF検定をやるかどうか
おそらく、そのt検定は等分散の仮定から得られるStudentのt検定のことだと思います。
「F検定→t検定」という流れは多重検定になるので好ましくないです。
⭕️F検定をやらずに、常にWelchのt検定を使う
と良いというのが現代の常識だと思いました。
なー💤💙.°@whousedamachine
t検定の前にf検定をやるかどうかって、結局何を基準にすればいいの?多重検定をしてでも等分散性が欲しい時はf検定するってこと?正規性の主張はする必要がないの?正規分布に従わない母集団ってどんなケース?
統計なんもわからんorz
統計なんもわからんorz
25
【正規分布に従わない母集団ってどんなケース?】
現実の母集団は大抵正規分布に従っていません。しかし、
⭕️正規母集団でなくても多くの場合にt検定を使える(使えない場合もある)。
よくある誤解は
❌正規母集団でなければt検定をつかえない。
この誤解は大学の先生がよく広めているので要注意。
現実の母集団は大抵正規分布に従っていません。しかし、
⭕️正規母集団でなくても多くの場合にt検定を使える(使えない場合もある)。
よくある誤解は
❌正規母集団でなければt検定をつかえない。
この誤解は大学の先生がよく広めているので要注意。
なー💤💙.°@whousedamachine
t検定の前にf検定をやるかどうかって、結局何を基準にすればいいの?多重検定をしてでも等分散性が欲しい時はf検定するってこと?正規性の主張はする必要がないの?正規分布に従わない母集団ってどんなケース?
統計なんもわからんorz
統計なんもわからんorz
26
#統計 分岐にリンク
Welchのt検定での自由度について大雑把に説明してすませたければ、
* Welchのt検定で使うt分布の自由度は複雑な式で定義され、2つの標本のサイズがm,nのときmin(m-1, n-1)以上m+n-2以下になる。
のように説明しておけば良いと思う。
min(m-1, n-1)以上になる。
Welchのt検定での自由度について大雑把に説明してすませたければ、
* Welchのt検定で使うt分布の自由度は複雑な式で定義され、2つの標本のサイズがm,nのときmin(m-1, n-1)以上m+n-2以下になる。
のように説明しておけば良いと思う。
min(m-1, n-1)以上になる。
黒木玄 Gen Kuroki@genkuroki
@whousedamachine 以下の特徴を持つ解説は有名な先生が書いたものであっても無視した方が無難です。
❌母平均の差の検定として、Welchのt検定ではなく、Studentのt検定を先に勧めている。
❌正規母集団でなければt検定は使えないと書いてある。
❌正規性検定やF検定を使って検定法を選択することを勧めている。
❌母平均の差の検定として、Welchのt検定ではなく、Studentのt検定を先に勧めている。
❌正規母集団でなければt検定は使えないと書いてある。
❌正規性検定やF検定を使って検定法を選択することを勧めている。
27
#統計
epirhandbook.com/jp/stat-tests.…
疫学のための Rハンドブック
18 基本的な統計的検定
の解説も色々アウト。詳しくは添付画像を参照。
いつもの初歩的な誤りです。
どうしてこういう杜撰なものが出回りまくって訂正されないのかが大問題。

epirhandbook.com/jp/stat-tests.…
疫学のための Rハンドブック
18 基本的な統計的検定
の解説も色々アウト。詳しくは添付画像を参照。
いつもの初歩的な誤りです。
どうしてこういう杜撰なものが出回りまくって訂正されないのかが大問題。
28
これは深刻な問題。
歳を食って頭が硬くなった人が伝統に従って(伝統の内容自体がデタラメであるがゆえに)デタラメな解説を行い続けるということだけなら、そういうこともあるだろうなと思います。
しかし、頭脳がまだ衰えていない若い人達まで悪しき伝統に従ってしまうのはどうしてなのか?
歳を食って頭が硬くなった人が伝統に従って(伝統の内容自体がデタラメであるがゆえに)デタラメな解説を行い続けるということだけなら、そういうこともあるだろうなと思います。
しかし、頭脳がまだ衰えていない若い人達まで悪しき伝統に従ってしまうのはどうしてなのか?
29
#統計 よく見る
❌正規母集団でなければt検定は使えない。
❌Mann-WhitneyのU検定ならいつでも使える。
という説明は初歩的なデタラメ。
Welchのt検定は正規性からの逸脱にかなり頑健だが、MWのU検定は脆弱なので安易に使うと危ない。
世界的に普及している解説の側が酷いデタラメなことに注意!
x.com/4soty6zmydh4bu…
❌正規母集団でなければt検定は使えない。
❌Mann-WhitneyのU検定ならいつでも使える。
という説明は初歩的なデタラメ。
Welchのt検定は正規性からの逸脱にかなり頑健だが、MWのU検定は脆弱なので安易に使うと危ない。
世界的に普及している解説の側が酷いデタラメなことに注意!
x.com/4soty6zmydh4bu…
30
#統計 特に、Mann-WhitneyのU検定を気軽に使う傾向は相当に危ない。
MWのU検定は、「2つの母集団分布は等しい」という帰無仮説の検定なので、母分散、母歪度、母尖度、などのどれかが等しくないと、無用に有意差が出易くなったり、出難くなったりする。
MWのU検定は、「2つの母集団分布は等しい」という帰無仮説の検定なので、母分散、母歪度、母尖度、などのどれかが等しくないと、無用に有意差が出易くなったり、出難くなったりする。
31
#統計 科学的にまともであるためには、権威に頼らずに、論理的に理解している方法だけを使うようにしないとまずい。
統計学の初歩を理解していないなら、初歩的な統計分析であっても使ってはいけない。
科学的にまともであるためには自分で考えて理解しなければいけない。教科書の権威には頼れない。
統計学の初歩を理解していないなら、初歩的な統計分析であっても使ってはいけない。
科学的にまともであるためには自分で考えて理解しなければいけない。教科書の権威には頼れない。
32
#統計 この「教科書に頼れない」という現実は相当に頭が痛い問題だと思います。
インターネットで公開されている解説の初歩的仮説検定の説明もできる限りチェックしているのですが、日本語圏に限らず、酷いものしか見たことがない。
どうしてみんなデタラメを他人に教えたがるのか?
インターネットで公開されている解説の初歩的仮説検定の説明もできる限りチェックしているのですが、日本語圏に限らず、酷いものしか見たことがない。
どうしてみんなデタラメを他人に教えたがるのか?
33
#統計
❌正規母集団でないとt検定は使えない。
とか
❌Mann-WhitneyのU検定のようなノンパラメトリック検定なら無条件で使える。
のような誤解をさせないような解説になっている日本語の入門的な教科書を見たことがないです。続く
❌正規母集団でないとt検定は使えない。
とか
❌Mann-WhitneyのU検定のようなノンパラメトリック検定なら無条件で使える。
のような誤解をさせないような解説になっている日本語の入門的な教科書を見たことがないです。続く
34
#統計
⭕️Studentのt検定やMann-WhitneyのU検定は脆弱で危険な検定であり、それらを使っている報告は過去に遡って問題がないかどうか確認した方が良い。
⭕️Welchのt検定やBrunner-Munzel検定はそれらを代替できるより頑強な検定になっている。
と教科書や入門的解説には書いて欲しい。
⭕️Studentのt検定やMann-WhitneyのU検定は脆弱で危険な検定であり、それらを使っている報告は過去に遡って問題がないかどうか確認した方が良い。
⭕️Welchのt検定やBrunner-Munzel検定はそれらを代替できるより頑強な検定になっている。
と教科書や入門的解説には書いて欲しい。
35
#統計 さらに、
❌等分散性が検定で棄却されなければStudentのt検定を使い、棄却されたらWelchのt検定を使う。
という指示も誤り。正しくは
⭕️母平均の差については常にWelchのt検定を使う。
が正解。
Welchのt検定を理解不足のまま貶す人もいるので要注意。

❌等分散性が検定で棄却されなければStudentのt検定を使い、棄却されたらWelchのt検定を使う。
という指示も誤り。正しくは
⭕️母平均の差については常にWelchのt検定を使う。
が正解。
Welchのt検定を理解不足のまま貶す人もいるので要注意。
黒木玄 Gen Kuroki@genkuroki
#統計 統計学入門書の中には、理解度の低さが原因でWelchのt検定を不当にdisる解説が結構よく見つかる。
理解度の低い解説者達が活躍しているという事実を宣伝する必要がある。
その典型例の1つが、
永田靖『統計的方法のしくみ』(1996)のpp.187-188
の説明。これがかなりひどい。続く
理解度の低い解説者達が活躍しているという事実を宣伝する必要がある。
その典型例の1つが、
永田靖『統計的方法のしくみ』(1996)のpp.187-188
の説明。これがかなりひどい。続く
36
#統計
❌F検定で等分散性の帰無仮説が検定で棄却されなければStudentのt検定を使い、棄却されたらWelchのt検定を使う。
のようなデタラメを教える人達が沢山いるので要注意。
そもそも、帰無仮説が棄却されないときに帰無仮説が正しいと判断するような人は仮説検定のイロハを分かっていない。続く

❌F検定で等分散性の帰無仮説が検定で棄却されなければStudentのt検定を使い、棄却されたらWelchのt検定を使う。
のようなデタラメを教える人達が沢山いるので要注意。
そもそも、帰無仮説が棄却されないときに帰無仮説が正しいと判断するような人は仮説検定のイロハを分かっていない。続く
Hir@Hir68951533
@niyoltsoh @aaaabbb03268022 「決して」煽り等でなく、単なる疑問です。
「検定」に耐えれる実験条件かを見るのも検定の役割と思うのですが・・。例:t検定の前のF検定とか。
どうでしょう?良かったら、教えて下さい。
多くの生物系実験者は検定に悩まされ、今は多くがsoftwareでやってますが、本質を理解してないの多くて・。
「検定」に耐えれる実験条件かを見るのも検定の役割と思うのですが・・。例:t検定の前のF検定とか。
どうでしょう?良かったら、教えて下さい。
多くの生物系実験者は検定に悩まされ、今は多くがsoftwareでやってますが、本質を理解してないの多くて・。
37
#統計 2群の比較のための入門的仮説検定についてはデタラメを教える伝統的がある。
教わる側も批判せずに非科学的な信者になる傾向がある。見分け方のコツ:
❌「t検定」という言葉を等分散性を仮定する「Studentのt検定」の意味で使う人達
は伝統的なデタラメの信者の場合が多い。
教わる側も批判せずに非科学的な信者になる傾向がある。見分け方のコツ:
❌「t検定」という言葉を等分散性を仮定する「Studentのt検定」の意味で使う人達
は伝統的なデタラメの信者の場合が多い。
38
#統計 本当にデタラメであることは、すでにコンピュータを使って統計分析を実行している人であれば、自力で確認できるはずです。コンピュータを使って
①仮想的な母集団分布の標本をランダムに生成
②その標本からP値を計算
③以上を繰り返してP値の分布を確認
を実行すればよい。
①仮想的な母集団分布の標本をランダムに生成
②その標本からP値を計算
③以上を繰り返してP値の分布を確認
を実行すればよい。
39
#統計 以下のリンク先スレッドには、実際に、仮想的な母集団分布に関する各種の検定法のP値の分布の具体的な計算例が沢山あります。
黒木玄 Gen Kuroki@genkuroki
#統計 統計学入門書の中には、理解度の低さが原因でWelchのt検定を不当にdisる解説が結構よく見つかる。
理解度の低い解説者達が活躍しているという事実を宣伝する必要がある。
その典型例の1つが、
永田靖『統計的方法のしくみ』(1996)のpp.187-188
の説明。これがかなりひどい。続く
理解度の低い解説者達が活躍しているという事実を宣伝する必要がある。
その典型例の1つが、
永田靖『統計的方法のしくみ』(1996)のpp.187-188
の説明。これがかなりひどい。続く
40
#統計 等分散性に関するF検定によってStudentのt検定とWelchのt検定を使い分けることがよくないやり方であることを理解するためには、以下のリンク先の計算例を見てください。

黒木玄 Gen Kuroki@genkuroki
#統計 計算例追加
期待値が等しく、標準偏差が1, 1.5の仮想的な正規母集団からそれぞれサイズm=25, n=15の標本を無作為抽出したときのt検定達のP値の累積分布函数のプロット(右側)。
mixed t-testはF検定でStudentとWelchを使い分ける検定法(使用しない方がよい)です。続く
github.com/genkuroki/publ…
期待値が等しく、標準偏差が1, 1.5の仮想的な正規母集団からそれぞれサイズm=25, n=15の標本を無作為抽出したときのt検定達のP値の累積分布函数のプロット(右側)。
mixed t-testはF検定でStudentとWelchを使い分ける検定法(使用しない方がよい)です。続く
github.com/genkuroki/publ…
41
#統計
jspt.or.jp/ebpt_glossary/
日本理学療法学会連合EBPT用語集
をちらっと眺めましたが、杜撰な内容で酷過ぎると思いました。
このスレッドのすぐ上で否定したこと(等分散性の検定によってStudentとWelchのt検定を使い分ける悪しき慣習)がそのまま書いてありました。続く
jspt.or.jp/ebpt_glossary/
日本理学療法学会連合EBPT用語集
をちらっと眺めましたが、杜撰な内容で酷過ぎると思いました。
このスレッドのすぐ上で否定したこと(等分散性の検定によってStudentとWelchのt検定を使い分ける悪しき慣習)がそのまま書いてありました。続く
42
#統計
jspt.or.jp/ebpt_glossary/
日本理学療法学会連合EBPT用語集
が酷い。
Welchのt検定は非正規母集団であっても中心極限定理のお陰で多くの場合に使えます。
等分散であることの強い証拠がある場合を除けば、等分散性の検定をせずに常にWelchのt検定を使うべきです。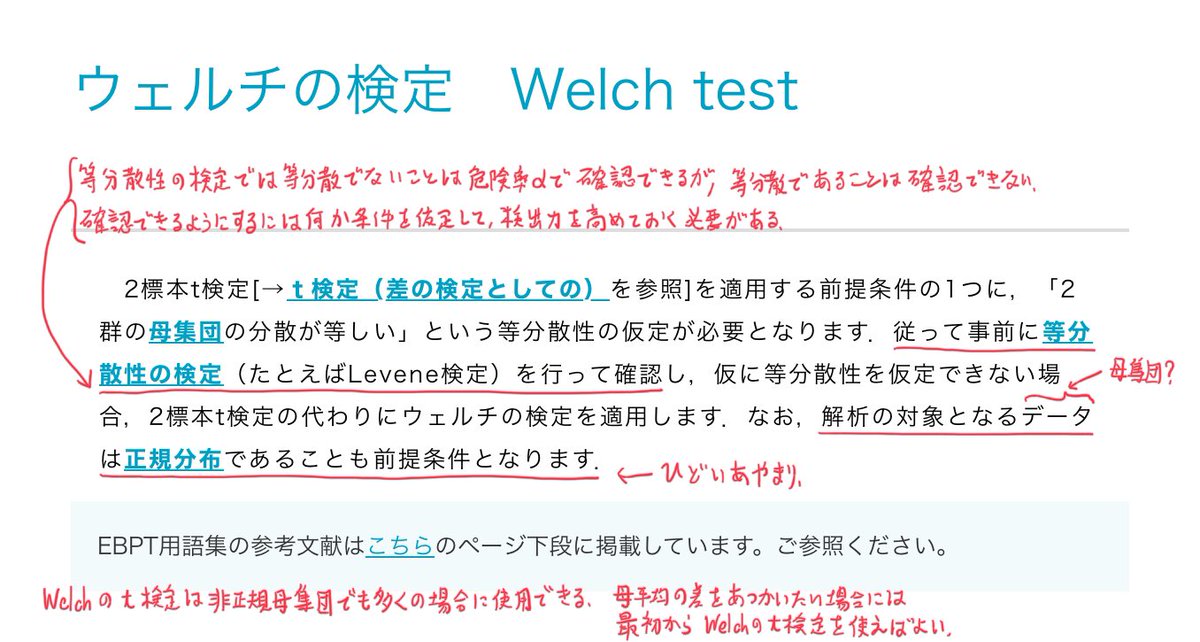
jspt.or.jp/ebpt_glossary/
日本理学療法学会連合EBPT用語集
が酷い。
Welchのt検定は非正規母集団であっても中心極限定理のお陰で多くの場合に使えます。
等分散であることの強い証拠がある場合を除けば、等分散性の検定をせずに常にWelchのt検定を使うべきです。
43
#統計
jspt.or.jp/ebpt_glossary/
日本理学療法学会連合EBPT用語集
が酷い。
引用【歪度が0のときに正規分布しているとみなされます】
は酷すぎる誤りです。
正規分布でなくても、対称な分布であれば歪度は0になります。
何も理解していない人が解説を書いているっぽい。続く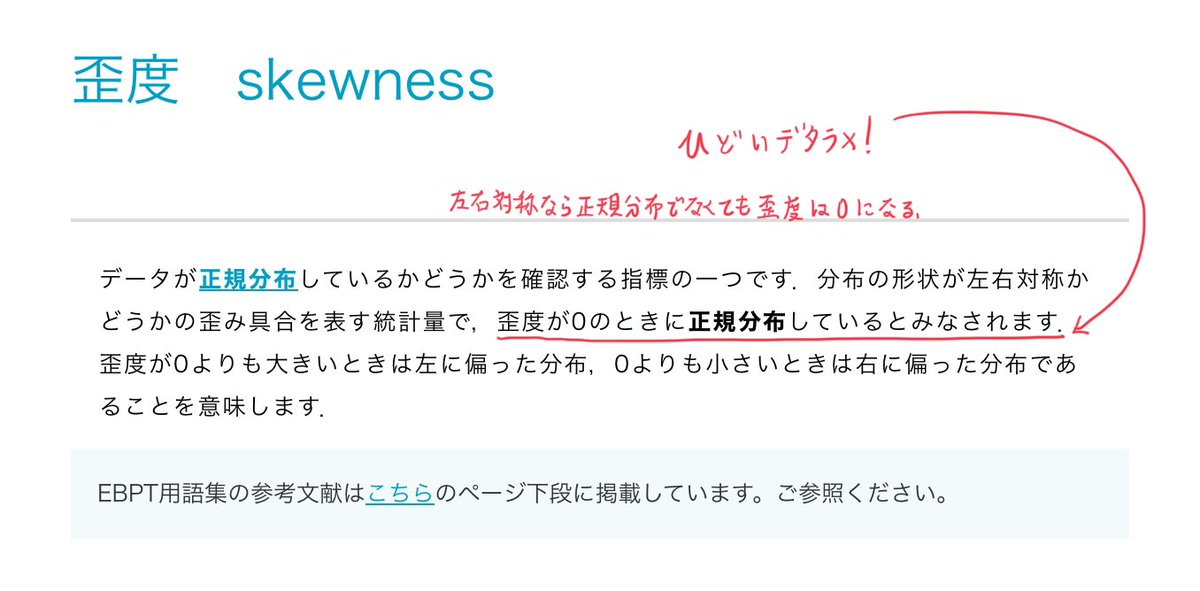
jspt.or.jp/ebpt_glossary/
日本理学療法学会連合EBPT用語集
が酷い。
引用【歪度が0のときに正規分布しているとみなされます】
は酷すぎる誤りです。
正規分布でなくても、対称な分布であれば歪度は0になります。
何も理解していない人が解説を書いているっぽい。続く
44
#統計
jspt.or.jp/ebpt_glossary/
日本理学療法学会連合EBPT用語集
が酷い。歪度の場合と同様に
引用【歪度が0のときに正規分布しているとみなされます】
と書いてある。これも誤りです。続く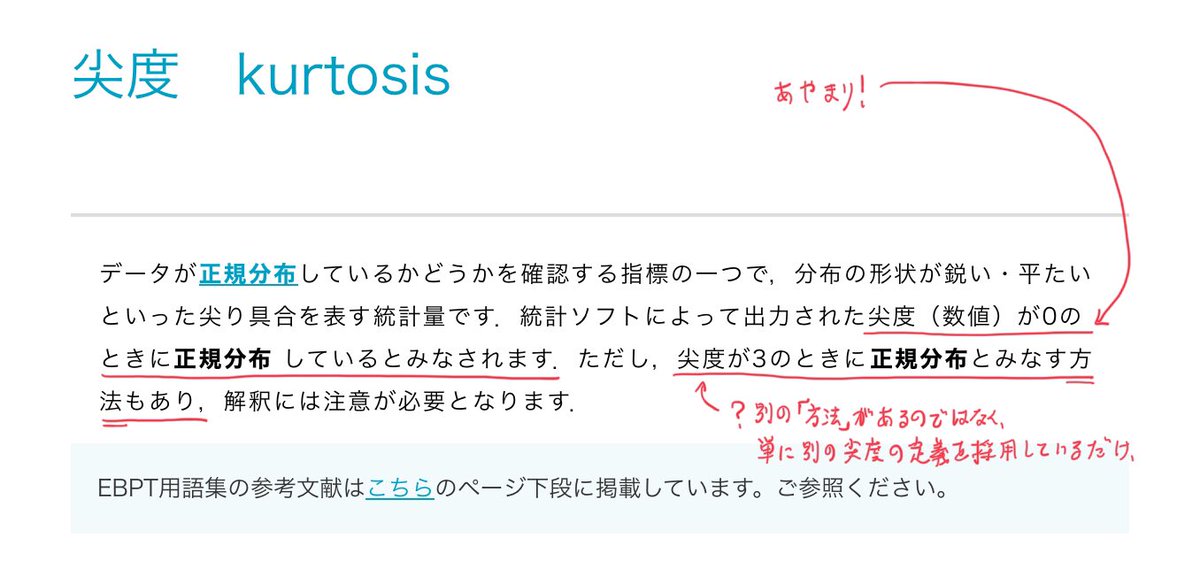
jspt.or.jp/ebpt_glossary/
日本理学療法学会連合EBPT用語集
が酷い。歪度の場合と同様に
引用【歪度が0のときに正規分布しているとみなされます】
と書いてある。これも誤りです。続く
45
#統計
jspt.or.jp/ebpt_glossary/
日本理学療法学会連合EBPT用語集
が酷い。
❌母集団が正規分布しているとみなされるか否かで、パラメトリック検定とノンパラメトリック検定を使い分ける
というよく見る杜撰な説明がここにも書いてある。
どうしてこういうデタラメを平気で書けるのか?続く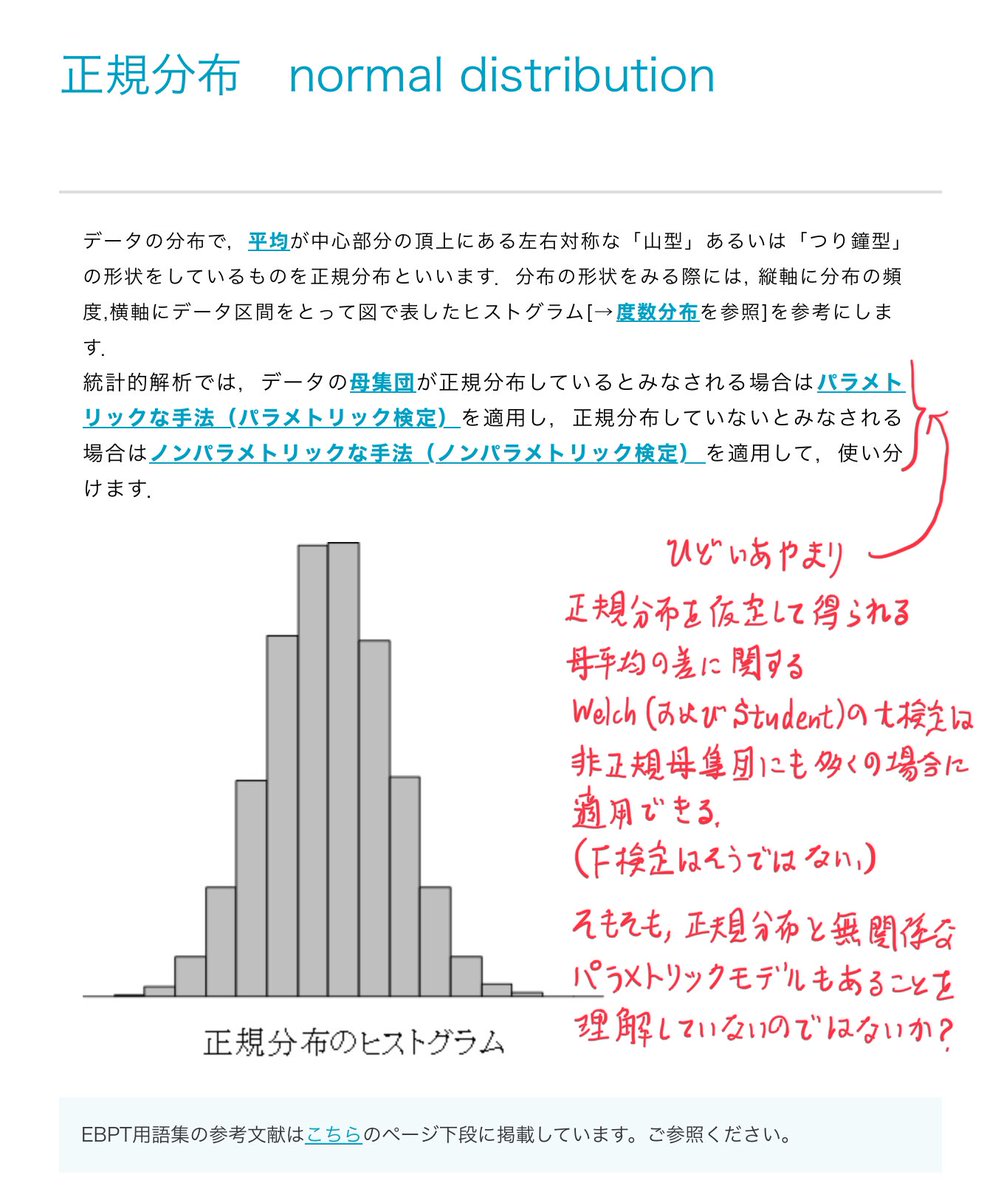
jspt.or.jp/ebpt_glossary/
日本理学療法学会連合EBPT用語集
が酷い。
❌母集団が正規分布しているとみなされるか否かで、パラメトリック検定とノンパラメトリック検定を使い分ける
というよく見る杜撰な説明がここにも書いてある。
どうしてこういうデタラメを平気で書けるのか?続く
46
#統計
jspt.or.jp/ebpt_glossary/
日本理学療法学会連合EBPT用語集
が酷い。正規性の検定について
* p≧0.05のとき、正規分布していないとはいえない(=正規分布している)
と書いてある。
仮説検定のイロハを理解していない!
帰無仮説が棄却されないとき、帰無仮説が正しいとしてはいけない。

jspt.or.jp/ebpt_glossary/
日本理学療法学会連合EBPT用語集
が酷い。正規性の検定について
* p≧0.05のとき、正規分布していないとはいえない(=正規分布している)
と書いてある。
仮説検定のイロハを理解していない!
帰無仮説が棄却されないとき、帰無仮説が正しいとしてはいけない。
47
#統計 以上では日本理学療法学会連のEBPT用語集をチラッと見ただけでデタラメが沢山見つかることを紹介しました。
これは日本理学療法学会連のEBPT用語集だけの問題ではありません。
そういうデタラメな説明が書いてあることの方が普通です(日本語圏に限らない。
これは日本理学療法学会連のEBPT用語集だけの問題ではありません。
そういうデタラメな説明が書いてあることの方が普通です(日本語圏に限らない。
48
#統計
どうしてこんなことになってしまっているのか理解できません。
十分な知性を持つ人達の集団の中には誤りに気付いている人たちが沢山いるはずなのに、酷い誤りが全然訂正されずに、デタラメの側が多数派になっているように見える。
どうしてこんなことになってしまっているのか理解できません。
十分な知性を持つ人達の集団の中には誤りに気付いている人たちが沢山いるはずなのに、酷い誤りが全然訂正されずに、デタラメの側が多数派になっているように見える。
49
#統計 補足説明
正規性検定で「母集団分布は正規分布である」という帰無仮説が棄却されないとき「帰無仮説が正しい」すなわち「母集団分布は正規分布である」と判断してはいけない、ということは仮説検定のイロハを知っていれば分かると思います。
続く
正規性検定で「母集団分布は正規分布である」という帰無仮説が棄却されないとき「帰無仮説が正しい」すなわち「母集団分布は正規分布である」と判断してはいけない、ということは仮説検定のイロハを知っていれば分かると思います。
続く
黒木玄 Gen Kuroki@genkuroki
#統計
jspt.or.jp/ebpt_glossary/
日本理学療法学会連合EBPT用語集
が酷い。正規性の検定について
* p≧0.05のとき、正規分布していないとはいえない(=正規分布している)
と書いてある。
仮説検定のイロハを理解していない!
帰無仮説が棄却されないとき、帰無仮説が正しいとしてはいけない。
jspt.or.jp/ebpt_glossary/
日本理学療法学会連合EBPT用語集
が酷い。正規性の検定について
* p≧0.05のとき、正規分布していないとはいえない(=正規分布している)
と書いてある。
仮説検定のイロハを理解していない!
帰無仮説が棄却されないとき、帰無仮説が正しいとしてはいけない。
50
#統計 一般に、条件Aを帰無仮説とする検定で帰無仮説が棄却されなかったときに「条件Aの下でなら使える検定法を使える」と判断する人は、仮説検定の基本に反する判断をしていることになります。
A=母集団分布は正規分布である
とか
A=等分散である
などで、仮説検定に基本がよく蔑ろにされている。
A=母集団分布は正規分布である
とか
A=等分散である
などで、仮説検定に基本がよく蔑ろにされている。
51
#統計 条件Aを帰無仮説とする検定で帰無仮説が棄却されなかったときには、「条件Aの成立については判断を保留する」が基本になります。
帰無仮説が棄却されないときに、帰無仮説が正しいと判断することは、仮説検定の典型的な誤用になります。
帰無仮説が棄却されないときに、帰無仮説が正しいと判断することは、仮説検定の典型的な誤用になります。
52
#統計
❌t検定を使うときには、正規性検定や等分散性検定を行う必要がある
というデタラメの普及は、本当は
⭕️母平均の差を扱うことが適切な状況ではWelchのt検定を使う
と覚えておけば大過ないシンプルな事柄を、無駄に複雑でしかも有害なルールで上書きしていることになります。
❌t検定を使うときには、正規性検定や等分散性検定を行う必要がある
というデタラメの普及は、本当は
⭕️母平均の差を扱うことが適切な状況ではWelchのt検定を使う
と覚えておけば大過ないシンプルな事柄を、無駄に複雑でしかも有害なルールで上書きしていることになります。
53
#統計 私による普及しているデタラメに対する批判は、
❌余計に難しいことを言っている
のではなく、
⭕️無駄に複雑でかつ従うことが有害なルールを(大学での講義や論文の査読などによって)他人に押し付ける人達の態度を全否定してかつ、よりシンプルな考え方を解説している
ことになっています。
❌余計に難しいことを言っている
のではなく、
⭕️無駄に複雑でかつ従うことが有害なルールを(大学での講義や論文の査読などによって)他人に押し付ける人達の態度を全否定してかつ、よりシンプルな考え方を解説している
ことになっています。
54
#統計
帰無仮説が棄却されなかったときに「対立仮説が棄却された」とは言わないし、「対立仮説が棄却された」と判断することは仮説検定の典型的な誤用になります。
❌F検定の結果を見て使用するt検定を変える
とデタラメを教えている大学の先生達は統計学の基本を理解していないので要注意です。
x.com/techitechifree…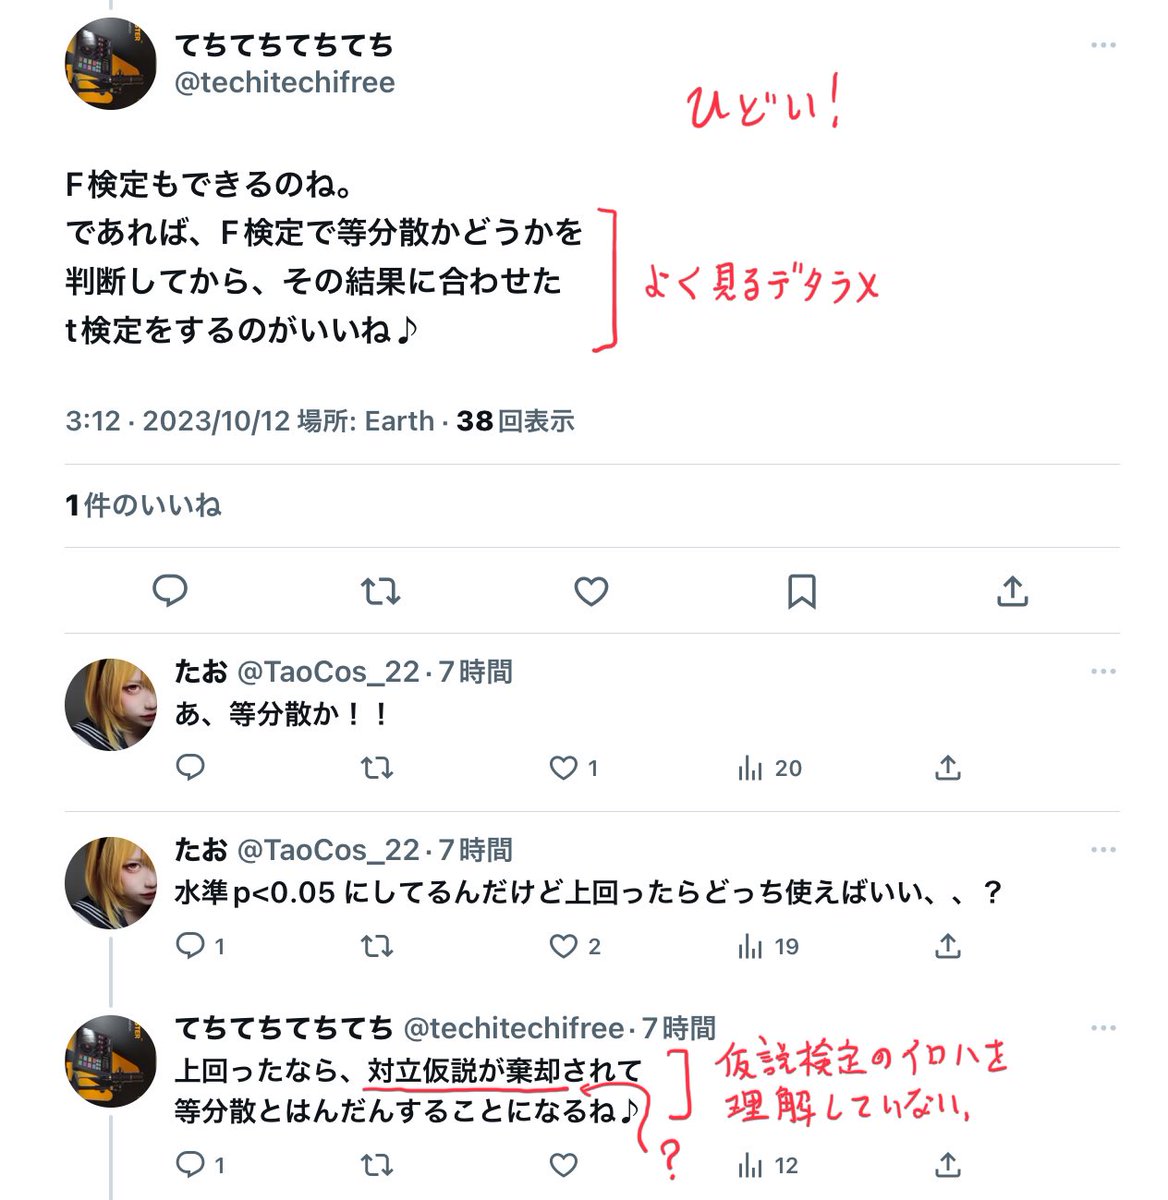
帰無仮説が棄却されなかったときに「対立仮説が棄却された」とは言わないし、「対立仮説が棄却された」と判断することは仮説検定の典型的な誤用になります。
❌F検定の結果を見て使用するt検定を変える
とデタラメを教えている大学の先生達は統計学の基本を理解していないので要注意です。
x.com/techitechifree…
55
#統計 ぺけったーで検索すると、数日おきに、
❌正規性検定や等分散性検定を行ってからt検定を使う
と誤解していたり、誰かからそう習って理解できずに困っている人達が見つかります。
理解できたと思って従うことにした人達はデタラメの信者になったことになるので要注意。
❌正規性検定や等分散性検定を行ってからt検定を使う
と誤解していたり、誰かからそう習って理解できずに困っている人達が見つかります。
理解できたと思って従うことにした人達はデタラメの信者になったことになるので要注意。
56
#統計 以下のリンク先の上側のスレッドは素晴らしい。
ただし、最後に
❌正規分布でなければt検定達を使えない
が誤りであることも強調していれば良かった。
あと、F検定後に使うt検定を変えることの害は、多重検定の害というより、Studentのt検定も確率的に使うことが原因で生じる害です。続く
x.com/pqr37244070/st…
ただし、最後に
❌正規分布でなければt検定達を使えない
が誤りであることも強調していれば良かった。
あと、F検定後に使うt検定を変えることの害は、多重検定の害というより、Studentのt検定も確率的に使うことが原因で生じる害です。続く
x.com/pqr37244070/st…
57
#統計 等標本サイズでも等母分散でもない場合にはStudentのt検定は使うべきはないのですが、等母分散でなくても、F検定によって等母分散の帰無仮説が棄却されない確率が大きい場合には、使うべきではないStudentのt検定も大きな確率で使用されることになって害が生じます。
詳しくは
↓
詳しくは
↓
黒木玄 Gen Kuroki@genkuroki
#統計 計算例追加
期待値が等しく、標準偏差が1, 1.5の仮想的な正規母集団からそれぞれサイズm=25, n=15の標本を無作為抽出したときのt検定達のP値の累積分布函数のプロット(右側)。
mixed t-testはF検定でStudentとWelchを使い分ける検定法(使用しない方がよい)です。続く
github.com/genkuroki/publ…
期待値が等しく、標準偏差が1, 1.5の仮想的な正規母集団からそれぞれサイズm=25, n=15の標本を無作為抽出したときのt検定達のP値の累積分布函数のプロット(右側)。
mixed t-testはF検定でStudentとWelchを使い分ける検定法(使用しない方がよい)です。続く
github.com/genkuroki/publ…
58
#統計 もしも、Welchのt検定を使うことにも大きな害があるなら、Studentのt検定の代わりに常にWelchのt検定を使うべきだと言わない方が良いのですが、Welchのt検定を使うことのデメリットは非常に小さく、Studentのt検定を使う害は大きい。
その辺の判断を誤らせる解説が出回っているので要注意
↓
その辺の判断を誤らせる解説が出回っているので要注意
↓
黒木玄 Gen Kuroki@genkuroki
#統計 統計学入門書の中には、理解度の低さが原因でWelchのt検定を不当にdisる解説が結構よく見つかる。
理解度の低い解説者達が活躍しているという事実を宣伝する必要がある。
その典型例の1つが、
永田靖『統計的方法のしくみ』(1996)のpp.187-188
の説明。これがかなりひどい。続く
理解度の低い解説者達が活躍しているという事実を宣伝する必要がある。
その典型例の1つが、
永田靖『統計的方法のしくみ』(1996)のpp.187-188
の説明。これがかなりひどい。続く
59
#統計
⭕️Studentのt検定を使うことはやめて、Welchのt検定を使うべきである
ことを理解できた人は、ほぼ同様の理由で
⭕️Wilcoxonの順位和検定=Mann-WhitneyのU検定を使うことはやめて、Brunner-Munzel検定を使うべきである
ことも理解できるはずです。
Studentのt検定とWMW検定は脆弱で危険です。
⭕️Studentのt検定を使うことはやめて、Welchのt検定を使うべきである
ことを理解できた人は、ほぼ同様の理由で
⭕️Wilcoxonの順位和検定=Mann-WhitneyのU検定を使うことはやめて、Brunner-Munzel検定を使うべきである
ことも理解できるはずです。
Studentのt検定とWMW検定は脆弱で危険です。
60
#統計
❌Studentのt検定
❌Wilcoxonの順位和検定=Mann-WhitneyのU検定
は伝統的に入門的な教科書や大学の講義などで使用が勧められて検定法です。しかしこれらは脆弱で、無用に有意差が出易くなったり、出難くなったりし易い検定法です。
⭕️Welchのt検定
⭕️Brunner-Munzel検定
の方がずっと頑健。
❌Studentのt検定
❌Wilcoxonの順位和検定=Mann-WhitneyのU検定
は伝統的に入門的な教科書や大学の講義などで使用が勧められて検定法です。しかしこれらは脆弱で、無用に有意差が出易くなったり、出難くなったりし易い検定法です。
⭕️Welchのt検定
⭕️Brunner-Munzel検定
の方がずっと頑健。
61
#統計 さらに
⭕️Welchのt検定 (母平均の差に関する検定)
⭕️Brunner-Munzel検定 (母勝率と1/2の差に関する検定)
Welchのt検定も非正規母集団であっても多くの場合に使える。
これらは母集団分布の違いを異なる基準で測定する方法なので、互換性はありません。何を測りたいかで使う検定を選ぶべき。
⭕️Welchのt検定 (母平均の差に関する検定)
⭕️Brunner-Munzel検定 (母勝率と1/2の差に関する検定)
Welchのt検定も非正規母集団であっても多くの場合に使える。
これらは母集団分布の違いを異なる基準で測定する方法なので、互換性はありません。何を測りたいかで使う検定を選ぶべき。
62
#統計 ここで「母勝率」の定義は、2つの母集団から1つずつ無作為抽出して値の大小で勝ち負けを決めるゲームでの(指定された片側の)勝率のことです。引き分けは0.5勝とみなす。
Brunner-Munzel検定の帰無仮説は「母勝率=1/2」です。
Brunner-Munzel検定の帰無仮説は「母勝率=1/2」です。
63
#統計 2つの母集団分布のサイズm,nの標本Xᵢ,Yⱼについて、Y側の母勝率pの自然な推定量p̂を
p̂ = (1/(mn)) Σ_{i=1}^m Σ_{j=1}^n h(Xᵢ,Yⱼ)
h(x, y) = (x < y なら1、x = y なら0.5、x > y なら0)
と定義できます。これがBrunner-Munzelの検定統計量。
U = mnp̂
はMann-WhitneyのU検定のUに一致。
p̂ = (1/(mn)) Σ_{i=1}^m Σ_{j=1}^n h(Xᵢ,Yⱼ)
h(x, y) = (x < y なら1、x = y なら0.5、x > y なら0)
と定義できます。これがBrunner-Munzelの検定統計量。
U = mnp̂
はMann-WhitneyのU検定のUに一致。
64
#統計 このように、Brunner-Munzel検定とMann-WhitneyのU検定の検定統計量は本質的に同じ式で定義されるのですが、統計モデルが違うのでその分散の推定結果が違います。
MWのU検定では「2つの母集団分布は等しい」という超絶強い条件を仮定して検定統計量の分散を推定するが、BM検定ではそうしない。
MWのU検定では「2つの母集団分布は等しい」という超絶強い条件を仮定して検定統計量の分散を推定するが、BM検定ではそうしない。
65
#統計 Mann-WhitneyのU検定とBrunner-Munzel検定の違いは、Studentのt検定とWelchのt検定の違いが標本平均の差の分散の推定法の違いになっていることとそっくりです。
前者が脆弱で後者が頑健である理由も似ています。
前者が脆弱で後者が頑健である理由も似ています。
66
#統計 優劣を決めるための検定法として、Mann-WhitneyのU検定とStudentのt検定が脆弱な理由はそれぞれ
* 2つの母集団分布は等しい
* 2つの母分散は等しい
という超絶強い条件を仮定して、母勝率の推定量の分散や標本平均の差の分散を推定する方法だからです。
* 2つの母集団分布は等しい
* 2つの母分散は等しい
という超絶強い条件を仮定して、母勝率の推定量の分散や標本平均の差の分散を推定する方法だからです。
67
#統計 2つの母集団分布をそれらの標本を使って比較する検定法は、回帰分析の最も優しい場合だとみなせます。
そのとき、Studentのt検定は、線形回帰に大幅に一般化されます。そういう意味でStudentのt検定には(Welchのt検定との比較で実用的価値は低いが)教育的な価値は十分にあると思います。続く
そのとき、Studentのt検定は、線形回帰に大幅に一般化されます。そういう意味でStudentのt検定には(Welchのt検定との比較で実用的価値は低いが)教育的な価値は十分にあると思います。続く
68
#統計 例えば、
❌最小二乗法による線形回帰の推定結果から得られる残差が正規分布に従っているかどうかを無用に気にすること
は
❌正規母集団でなければStudentのt検定は使えない
という誤解の「一般化」とみなされます。
どちらもおかしな考え方です。続く
❌最小二乗法による線形回帰の推定結果から得られる残差が正規分布に従っているかどうかを無用に気にすること
は
❌正規母集団でなければStudentのt検定は使えない
という誤解の「一般化」とみなされます。
どちらもおかしな考え方です。続く
69
#統計
⭕️Studentのt検定の前提で重要なのは等母分散性である
ことの「一般化」として、
⭕️残差の分布が説明変数によらないこと
を確認する方が重要だと思います。
例えば説明変数xが大きほど残差の分散が大きくなっているように見える場合には不適切な回帰分析をしている可能性が高くなります。
⭕️Studentのt検定の前提で重要なのは等母分散性である
ことの「一般化」として、
⭕️残差の分布が説明変数によらないこと
を確認する方が重要だと思います。
例えば説明変数xが大きほど残差の分散が大きくなっているように見える場合には不適切な回帰分析をしている可能性が高くなります。
70
#統計 2つの母集団での母比率の違いに関する検定法も、ロジスティック回帰を含むより広い範囲の回帰分析の特別な場合とみなせます。
71
#統計 解説を聴いている側が数学強者なら、いきなり一般化された回帰分析の説明から始めても大丈夫だと思いますが、そういう場合は稀でしょう。
2つの母集団分布の比較から入ることは、現実的には仕方がない部分があると思います。続く
2つの母集団分布の比較から入ることは、現実的には仕方がない部分があると思います。続く
72
#統計 あと、一般化された回帰分析のような強力な手段を解説する場合には、誤用による社会的な害についても強く気にする必要が生じるので、パールさん的なスタイルでの因果推論(因果効果推定)の解説も必須になると思います。
回帰分析のやり方だけを説明するのは無責任だと思う。
回帰分析のやり方だけを説明するのは無責任だと思う。
73
#統計 一般化された回帰分析(階層モデルも使う)について教えるなら、社会的責任としてパールさん的スタイルでの因果推論も解説することが必要だと思うし、さらに技術的手段としてベイズ統計の方法の解説も必要。
そういう講義の有名な例がStatistical Rethinking→ github.com/rmcelreath/sta…
そういう講義の有名な例がStatistical Rethinking→ github.com/rmcelreath/sta…
74
#統計 線形回帰に関する誤解訂正しようとした人が、
❌母集団分布ではなく、残差が正規分布であることを確認することが重要。母集団分布自体は正規分布である必要はない。
のように誤解誘導的な発言をするのをよく見る。
「どうしても正規分布にこだわりたい病」が発症している感じ。続く
❌母集団分布ではなく、残差が正規分布であることを確認することが重要。母集団分布自体は正規分布である必要はない。
のように誤解誘導的な発言をするのをよく見る。
「どうしても正規分布にこだわりたい病」が発症している感じ。続く
75
#統計 線形回帰に限らず、点推定の結果だけを見るのはまずくて、最悪でも区間推定もしておきたい。
線形回帰での回帰係数の信頼区間の基礎は、Studentのt検定の場合と同様に、回帰係数の最小二乗推定量の分布の一般化された中心極限定理による正規分布近似です。
中心極限定を意識することは基本的。
線形回帰での回帰係数の信頼区間の基礎は、Studentのt検定の場合と同様に、回帰係数の最小二乗推定量の分布の一般化された中心極限定理による正規分布近似です。
中心極限定を意識することは基本的。
76
#統計 私も統計学はど素人です(←繰り返し言っている)。私より理解していない人はど素人よりも理解していないということになります。この注意は結構重要。
私は任意の分布でよいとは言っていないので、その質問の仕方は奇妙です。私に質問するなら、私の発言を正確に引用して質問して欲しいです。続く
私は任意の分布でよいとは言っていないので、その質問の仕方は奇妙です。私に質問するなら、私の発言を正確に引用して質問して欲しいです。続く
77
#統計 私の主張はこうです。
残差の未知である真の分布と標本サイズの組み合わせが、回帰係数の最小二乗法による推定量の分布が(一般化された)中心極限定理によって正規分布で十分に近似されていると考えても良さそうな状況であれば、回帰係数に関するP値や信頼区間の誤差も十分に小さくなる。
x.com/pqr37244070/st…
残差の未知である真の分布と標本サイズの組み合わせが、回帰係数の最小二乗法による推定量の分布が(一般化された)中心極限定理によって正規分布で十分に近似されていると考えても良さそうな状況であれば、回帰係数に関するP値や信頼区間の誤差も十分に小さくなる。
x.com/pqr37244070/st…
78
#統計 おそらく、Mann-WhitneyのU検定を安易に勧めてしまう人の(間違っている)理屈はこうです。
①正規母集団で無ければt検定を使えない。
②2つの母平均の差に関するt検定は基本的に等母分散でないと使えないStudentのt検定である。
続く
①正規母集団で無ければt検定を使えない。
②2つの母平均の差に関するt検定は基本的に等母分散でないと使えないStudentのt検定である。
続く
79
#統計 続き
③ゆえに、Studentのt検定が使える状況は正規母集団かつ等母分散の場合であり、そのとき等母平均の帰無仮説は、2つの正規母集団分布が等しいことと同値になる。
注意:上の③の前半は誤り。
続く
③ゆえに、Studentのt検定が使える状況は正規母集団かつ等母分散の場合であり、そのとき等母平均の帰無仮説は、2つの正規母集団分布が等しいことと同値になる。
注意:上の③の前半は誤り。
続く
80
#統計
④Mann-WhitneyのU検定の帰無仮説は「正規とは限らない2つの母集団分布は等しい」なので、MWのU検定の方がStudentのt検定よりも適用範囲は広い。しかも検出力が大して落ちないことも証明されている。
注意:この判断は誤り。
試験問題:以上の①~④がどのように間違っているかを説明せよ。
④Mann-WhitneyのU検定の帰無仮説は「正規とは限らない2つの母集団分布は等しい」なので、MWのU検定の方がStudentのt検定よりも適用範囲は広い。しかも検出力が大して落ちないことも証明されている。
注意:この判断は誤り。
試験問題:以上の①~④がどのように間違っているかを説明せよ。
81
#統計
❌正規分布でなければt検定を使えない
というデマを
❌伝統的に教えられ続けている検定法選択のフローチャート
によって広めたことの第一の害は、
優秀で忙しい人達から無駄に時間を奪い続けていること
だと思いました。
広めた(広めている)人達は「間違っていた」と言うべき。

❌正規分布でなければt検定を使えない
というデマを
❌伝統的に教えられ続けている検定法選択のフローチャート
によって広めたことの第一の害は、
優秀で忙しい人達から無駄に時間を奪い続けていること
だと思いました。
広めた(広めている)人達は「間違っていた」と言うべき。
Wasabi@統計勉強/脳神経内科@drhund_jp
初めての学会発表の準備の時、サンプルサイズ300くらいのデータをまとめて事前発表したら、先輩医師から正規性検定したのかと聞かれて、ほぼ徹夜でSPSSの本のフローチャートを開きながらデータを直した事があったけど、中心極限定理の知識があればあんな苦労をする事がなかったな。
82
なぜか、坂巻顕太郎氏にブロックされていますね。
最近出版された本
hws-kyokai.or.jp/publishing/typ…
生物統計学の道標
にも、もしかして、
❌正規母集団でなければt検定は使えない
とか、Studentのt検定を勧める、などの説明がある?
知っている人がいたら教えて下さい。

最近出版された本
hws-kyokai.or.jp/publishing/typ…
生物統計学の道標
にも、もしかして、
❌正規母集団でなければt検定は使えない
とか、Studentのt検定を勧める、などの説明がある?
知っている人がいたら教えて下さい。
黒木玄 Gen Kuroki@genkuroki
#統計 医療統計の分野では、
❌正規母集団でなければt検定をつかえない。
という酷い教え方のせいで、
❌ノンパラメトリック検定ならばいつでも使える。
という極めて有害な誤解に誘導され、実際に安易にノンパラ検定を使って論文を書いてしまう科学的に有害な人達を増やして来た。
大問題。
❌正規母集団でなければt検定をつかえない。
という酷い教え方のせいで、
❌ノンパラメトリック検定ならばいつでも使える。
という極めて有害な誤解に誘導され、実際に安易にノンパラ検定を使って論文を書いてしまう科学的に有害な人達を増やして来た。
大問題。
83
関連スレッド
黒木玄 Gen Kuroki@genkuroki
#統計
jstage.jst.go.jp/article/kagaku…
改訂増補版:統計検定を理解せずに使っている人のためにII
池田 郁男
化学と生物57 巻 (2019) 9 号
これは3年前なのですが、いつものよく見る誤解がもろに説明されています。
現代でもこういうので統計学入門の勉強をしてしまう人達がいるわけです。非常に残念。続く
jstage.jst.go.jp/article/kagaku…
改訂増補版:統計検定を理解せずに使っている人のためにII
池田 郁男
化学と生物57 巻 (2019) 9 号
これは3年前なのですが、いつものよく見る誤解がもろに説明されています。
現代でもこういうので統計学入門の勉強をしてしまう人達がいるわけです。非常に残念。続く
84
#統計 ググってみた。
hws-kyokai.or.jp/publishing/typ…
↓
hws-kyokai.or.jp/images/2022-4.…
Sample: 医療職のための学び直し 第15回 無計画な解析における問題
【各群のアウトカムが分散の等しい正規分布に従うとt検定では仮定していることを確認しておく必要がある】
やはりミスリーディングな説明があった。続く

hws-kyokai.or.jp/publishing/typ…
↓
hws-kyokai.or.jp/images/2022-4.…
Sample: 医療職のための学び直し 第15回 無計画な解析における問題
【各群のアウトカムが分散の等しい正規分布に従うとt検定では仮定していることを確認しておく必要がある】
やはりミスリーディングな説明があった。続く
黒木玄 Gen Kuroki@genkuroki
なぜか、坂巻顕太郎氏にブロックされていますね。
最近出版された本
hws-kyokai.or.jp/publishing/typ…
生物統計学の道標
にも、もしかして、
❌正規母集団でなければt検定は使えない
とか、Studentのt検定を勧める、などの説明がある?
知っている人がいたら教えて下さい。
x.com/genkuroki/stat…
最近出版された本
hws-kyokai.or.jp/publishing/typ…
生物統計学の道標
にも、もしかして、
❌正規母集団でなければt検定は使えない
とか、Studentのt検定を勧める、などの説明がある?
知っている人がいたら教えて下さい。
x.com/genkuroki/stat…
85
#統計 そもそもWelchのt検定ではなく「t検定」=Studentのt検定のような脆弱で危険な検定法がデフォルトになっていることも問題。それを無視しても、
❌非正規分布であればt検定を使えない
という誤解が蔓延しているので、それを打ち消す説明がないと確実にミスリーディングな説明になってしまう。
❌非正規分布であればt検定を使えない
という誤解が蔓延しているので、それを打ち消す説明がないと確実にミスリーディングな説明になってしまう。
86
#統計 正規母集団での検定法や信頼区間での正規分布性の仮定の重要性は、母平均と母分散のどちらを扱っているかで違います。
母平均を扱っている場合には、標本平均に関する中心極限定理と不偏分散に関する大数の法則より、正規性からの逸脱にかなり頑強です。
しかし、母分散の場合には脆弱になる。
母平均を扱っている場合には、標本平均に関する中心極限定理と不偏分散に関する大数の法則より、正規性からの逸脱にかなり頑強です。
しかし、母分散の場合には脆弱になる。
87
#統計 数学的内容がしっかりしている統計学入門の解説であっても、正規母集団の母平均と母分散に関する検定・信頼区間を並行に扱っているだけのものが非常に多い。
正規性からの逸脱について、母平均を扱っている場合は頑強だが、母分散では脆弱にあることもきちんと説明して行くべきだと思います。
正規性からの逸脱について、母平均を扱っている場合は頑強だが、母分散では脆弱にあることもきちんと説明して行くべきだと思います。
88
#統計 上の発言内容は、線形回帰での残差の分布の正規性の話にもそのまま拡張されます。
回帰係数に関する検定や信頼区間であれば、拡張された中心極限定理のお陰で、残差の分布の正規性の仮定からの逸脱について頑強になります。
この点も必ず説明した方が良いと思います。
回帰係数に関する検定や信頼区間であれば、拡張された中心極限定理のお陰で、残差の分布の正規性の仮定からの逸脱について頑強になります。
この点も必ず説明した方が良いと思います。
89
#統計 数学的に正規分布を仮定してそこから検定法や信頼区間を導出する議論を紹介するだけだと、その解説を聴いた人は、
❌その検定法と信頼区間は正規分布でないと使えない
と誤解してしまう可能性が高く、現実にものすごく多くの統計学ユーザーが誤解しています。相当に酷いことになっている。
❌その検定法と信頼区間は正規分布でないと使えない
と誤解してしまう可能性が高く、現実にものすごく多くの統計学ユーザーが誤解しています。相当に酷いことになっている。
90
#統計 正規母集団の統計学の例として解説される母平均の値に関する1標本t検定が正規性の仮定からの逸脱に頑強。
しかし、母分散の値に関するカイ二乗検定は正規性の仮定からの逸脱に脆弱です。その理由は母尖度と標本の不偏分散の関係を理解すれば分かります。
ところが、尖度の解説も一般に酷い。
しかし、母分散の値に関するカイ二乗検定は正規性の仮定からの逸脱に脆弱です。その理由は母尖度と標本の不偏分散の関係を理解すれば分かります。
ところが、尖度の解説も一般に酷い。
91
#統計 母平均の値に関する統計的推論では、標本平均と不偏分散を使います。母平均をμ、母分散をσ²とするとき、サイズnの標本の平均X̅について、中心極限定理によってnが十分大きいなら、(X̅-μ)/√(σ²/n)の分布は標準正規分布で近似されます。
続く
続く
92
#統計 さらに、大数の法則より、nが十分大きいなら未知の母分散σ²は不偏分散S²で近似される。
以上の状況で、
T = (X̅ - μ)/√(S²/n)
の分布は標準正規分布で近似される。
不偏分散S²の確率的揺らぎの効果を保守的に補正するためには、標準正規分布の代わりに自由度n-1のt分布がよく使われる。続く
以上の状況で、
T = (X̅ - μ)/√(S²/n)
の分布は標準正規分布で近似される。
不偏分散S²の確率的揺らぎの効果を保守的に補正するためには、標準正規分布の代わりに自由度n-1のt分布がよく使われる。続く
93
#統計 標準正規分布の代わりにt分布を用いることは、補正の一種だと思っておいた方が誤解が少ないと思います。
母平均に関する統計学的推論の主要な部分は標本平均に関する中心極限定理からやって来る。
だから、母集団分布が正規分布でなくても、母平均について多くの場合に以上の方法を使えます。
母平均に関する統計学的推論の主要な部分は標本平均に関する中心極限定理からやって来る。
だから、母集団分布が正規分布でなくても、母平均について多くの場合に以上の方法を使えます。
94
#統計 母集団分布が正規分布ならば、T=(X̅-μ)/√(S²/n)が自由度n-1のt分布に従うことが、保守的な補正としてt分布を使うことの根拠になっています。
95
#統計
T=(X̅-μ)/√(S²/n)が自由度n-1のt分布に従う設定の下でのμの信頼区間
と
平坦事前分布の下での正規分布モデルのベイズ統計におけるμの信用区間
はぴったり等しくなります。これらを区別することは不可能。
ベイズと非ベイズ水と油であるかのように語ることも酷くミスリーディング。
T=(X̅-μ)/√(S²/n)が自由度n-1のt分布に従う設定の下でのμの信頼区間
と
平坦事前分布の下での正規分布モデルのベイズ統計におけるμの信用区間
はぴったり等しくなります。これらを区別することは不可能。
ベイズと非ベイズ水と油であるかのように語ることも酷くミスリーディング。
96
#統計 ベイズであろうがなかろうが、母平均に関する統計学的推論の主要な部分は標本平均に関する中心極限定理からやって来ると考えられるので、その結果は正規分布の仮定からの逸脱についてかなり頑強になります。
母分散の場合は要注意であることの説明に続く。
母分散の場合は要注意であることの説明に続く。
97
#統計 母平均がμ、母分散がσ²、母尖度がκ̅₄=E[((X-μ)/σ)⁴]-3のとき、サイズnの標本の不偏分散S²も期待値はσ²になり、分散は
σ⁴(κ̅₄/n + 2/(n-1))
になります。正規母集団ではκ̅₄=0となる。
要するに、母尖度は不偏分散の分散を記述する量になっています!明らかにこれは重要です。続く
σ⁴(κ̅₄/n + 2/(n-1))
になります。正規母集団ではκ̅₄=0となる。
要するに、母尖度は不偏分散の分散を記述する量になっています!明らかにこれは重要です。続く
98
#統計 不偏分散S²の分散は
σ⁴(κ̅₄/n + 2/(n-1))
であり、正規母集団で0になる母尖度κ̅₄に依存するので、正規母集団の仮定の下での母分散に関する統計学的推論を、非正規母集団に適用すると、nをどんなに大きくしても、母尖度κ̅₄由来の無視できない誤差が生じます。
母尖度の理解は重要!
σ⁴(κ̅₄/n + 2/(n-1))
であり、正規母集団で0になる母尖度κ̅₄に依存するので、正規母集団の仮定の下での母分散に関する統計学的推論を、非正規母集団に適用すると、nをどんなに大きくしても、母尖度κ̅₄由来の無視できない誤差が生じます。
母尖度の理解は重要!
99
#統計 正規母集団の下でS²/σ²の分布はχ²(n-1)/(n-1)になります(分散は2/(n-1))。
S²/σ²の分布がχ²(n-1)/(n-1)になるという設定でのσ²の信頼区間
と
(μ, log σ²)に関する平坦事前分布の下での正規分布モデルのベイズ統計でのσ²の信用区間
はぴったり一致します。区別不可能。続く
S²/σ²の分布がχ²(n-1)/(n-1)になるという設定でのσ²の信頼区間
と
(μ, log σ²)に関する平坦事前分布の下での正規分布モデルのベイズ統計でのσ²の信用区間
はぴったり一致します。区別不可能。続く
100
#統計 以上の理由から、ベイズであろうがなかろうが、正規分布モデルによるσ²に関する統計学的推論を、非正規母集団に適用すると母尖度κ̅₄の分だけ誤差が生じ、正規分布の仮定からの逸脱に脆弱になります。
こういう話は極めて基本的で、みんな知っておくべきことだと思います。
こういう話は極めて基本的で、みんな知っておくべきことだと思います。
101
#統計 ところが現実には、旧帝大レベルの講義であっても、尖度について、
google.com/search?q=%E5%B…
❌尖度が正の分布は正規分布よりも尖っている
のような酷い説明をしている人達がたくさんいる。
あまりにもレベルが低過ぎて非常に残念に思います。
google.com/search?q=%E5%B…
❌尖度が正の分布は正規分布よりも尖っている
のような酷い説明をしている人達がたくさんいる。
あまりにもレベルが低過ぎて非常に残念に思います。
102
#統計 歪度κ̅₃=E[((X-μ)/σ)³]と尖度κ̅₄=E[((X-μ)/σ)⁴]-3については、Pearsonの不等式
κ̅₄ ≥ κ̅₃² - 2
が成立しています。
分布の非対称性が大きくて歪度κ̅₃の絶対値が大きい場合にも、尖度は大きくなります。
だから、尖度について分布の尖り方の大きさだと説明することは不適切です。続く
κ̅₄ ≥ κ̅₃² - 2
が成立しています。
分布の非対称性が大きくて歪度κ̅₃の絶対値が大きい場合にも、尖度は大きくなります。
だから、尖度について分布の尖り方の大きさだと説明することは不適切です。続く
103
#統計 歪度κ̅₃=E[((X-μ)/σ)³]と尖度κ̅₄=E[((X-μ)/σ)⁴]-3については、妙な説明をすることはやめて、
* Pearsonの不等式
* 中心極限定理による正規分布への収束の速さとの関係
* 標本平均と不偏分散の同時分布の分散共分散行列の記述
について説明するべきだと思います。
* Pearsonの不等式
* 中心極限定理による正規分布への収束の速さとの関係
* 標本平均と不偏分散の同時分布の分散共分散行列の記述
について説明するべきだと思います。
104
#統計 歪度κ̅₃=E[((X-μ)/σ)³]と尖度κ̅₄=E[((X-μ)/σ)⁴]-3は分布の正規分布との違いを測る指標達の中でも非常に基本的なものです。一般に
log E[exp(t(X-μ)/σ)] = t²/2 + κ̅₃ t³/3! + κ̅₄ t⁴/4! + ⋯
で、Xが従う分布が正規分布ならば
log E[exp(t(X-μ)/σ)] = t²/2
となる。
log E[exp(t(X-μ)/σ)] = t²/2 + κ̅₃ t³/3! + κ̅₄ t⁴/4! + ⋯
で、Xが従う分布が正規分布ならば
log E[exp(t(X-μ)/σ)] = t²/2
となる。