#統計 私のフォロワーなので、おそらく「どれだけ酷い本であるか」を確認して批判するために購入したのだと思いました。...

黒木玄 Gen Kuroki@genkuroki
116 views
Oct 21, 2024
~2 min read
Advertisement
1
#統計 私のフォロワーなので、おそらく「どれだけ酷い本であるか」を確認して批判するために購入したのだと思いました。
豊田秀樹『瀕死の統計学を救え!』(以下、豊田瀕死本)によって瀕死なのは豊田さんの信用だと思います。
詳しくは続きを参照。続く
t.co/baxpg4GmBn
豊田秀樹『瀕死の統計学を救え!』(以下、豊田瀕死本)によって瀕死なのは豊田さんの信用だと思います。
詳しくは続きを参照。続く
t.co/baxpg4GmBn
2
#統計 豊田瀕死本関連の情報へのリンクを以下に貼り付けます。
私のツイッターでの発言で、豊田秀樹さんはベイズ統計学に関する最も有害な解説者扱いされています。
↓
twilog.org/genkuroki/sear…
私のツイッターでの発言で、豊田秀樹さんはベイズ統計学に関する最も有害な解説者扱いされています。
↓
twilog.org/genkuroki/sear…
3
#統計 豊田さんが例に出しているphc=「仮説が正しい確率」はP値そのものとみなして問題がないくらいP値をよく近似しているので、豊田さんは
P値の代わりにP値を使うべきである
と主張していることになります。
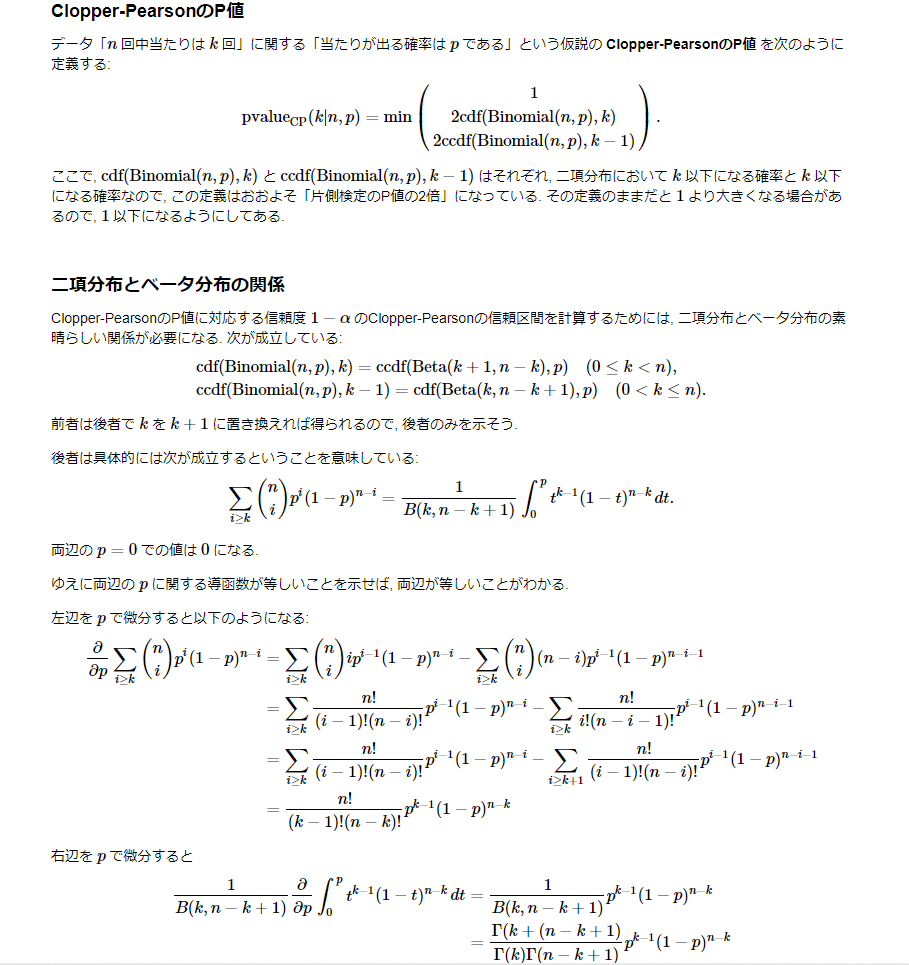
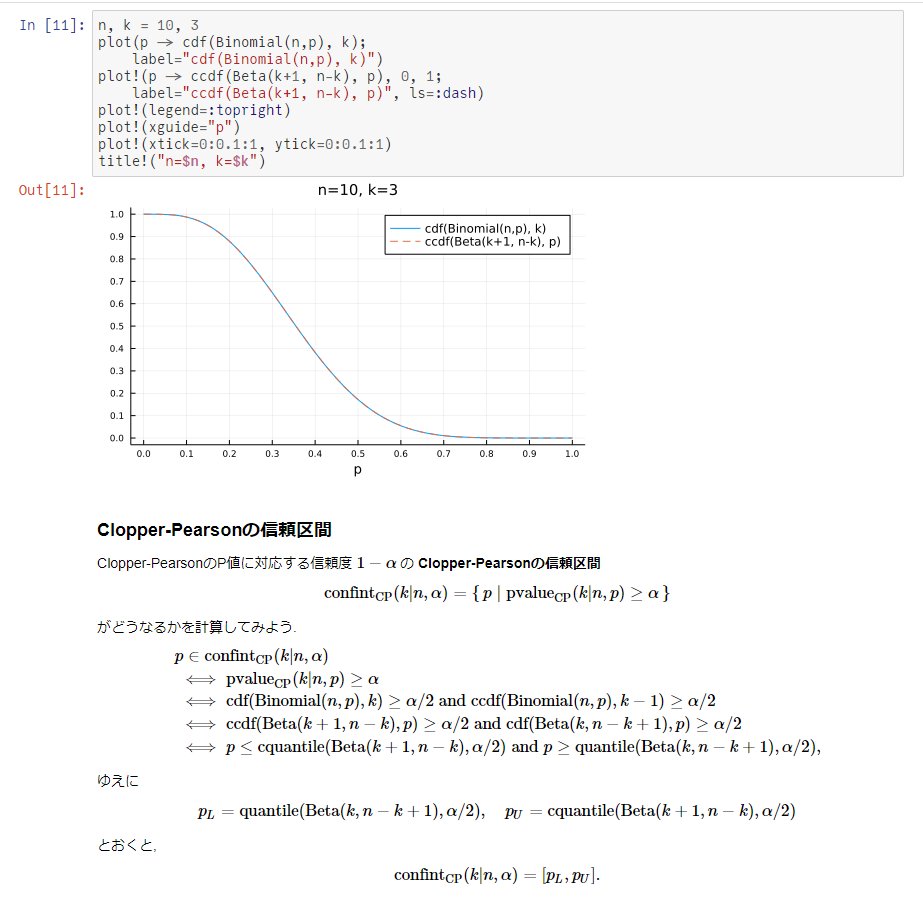
www


P値の代わりにP値を使うべきである
と主張していることになります。
www
黒木玄 Gen Kuroki@genkuroki
例えば豊田『瀕死本』の図5.2, 5.3のphc=「仮説が正しい確率」はそれぞれに対応するP値にほぼぴったり一致しています。
添付画像のグラフとソースコード nbviewer.jupyter.org/gist/genkuroki… を見て下さい。
この一致は偶然ではなく、一般的に成立しています。
添付画像のグラフとソースコード nbviewer.jupyter.org/gist/genkuroki… を見て下さい。
この一致は偶然ではなく、一般的に成立しています。
4
#統計 豊田『瀕死本』でのphcは実質的にP値になっている場合があり、そのことをコンピュータで確認すれば豊田さんのひどさをクリアに理解できます。
私による確認例
↓
nbviewer.org/gist/genkuroki…
豊田『瀕死本』の5.4節について
図5.2,5.3のphcは実質的にP値

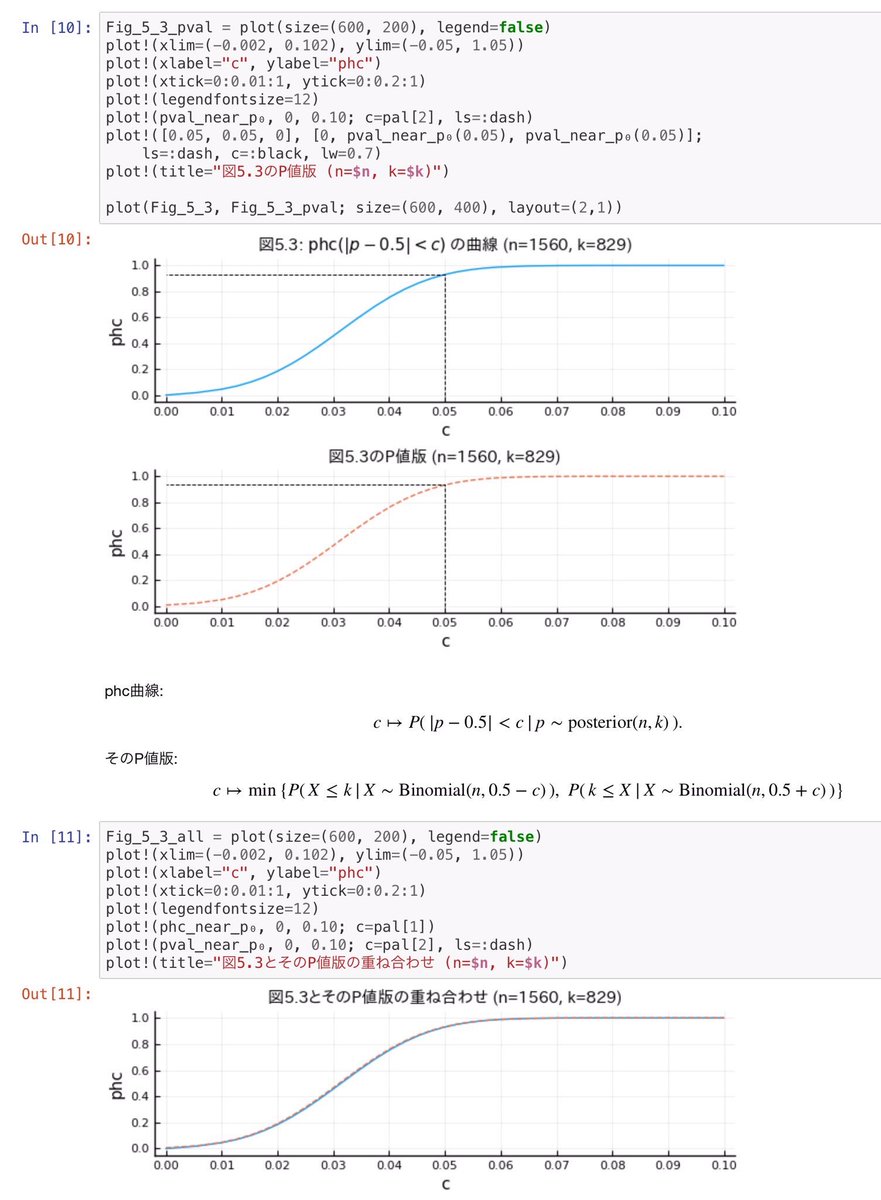

私による確認例
↓
nbviewer.org/gist/genkuroki…
豊田『瀕死本』の5.4節について
図5.2,5.3のphcは実質的にP値
shigepong@shigepong
豊田秀樹先生の
瀕死の統計学を救え!: 有意性検定から「仮説が正しい確率」へ
を読んで感銘をうけ、主張にも賛成して、 PHC という概念、これは流行る。流行るべき。と思い始めていたところに、黒木さんの厳しい批判スレッドに出会ったので、「ちょっと立ち止まってゆっくり考えねば」となってる。
瀕死の統計学を救え!: 有意性検定から「仮説が正しい確率」へ
を読んで感銘をうけ、主張にも賛成して、 PHC という概念、これは流行る。流行るべき。と思い始めていたところに、黒木さんの厳しい批判スレッドに出会ったので、「ちょっと立ち止まってゆっくり考えねば」となってる。
5
#統計 通常の統計学の教科書的にシンプルなモデルで検出力を十分に高めるように標本サイズを大きくした場合には、平坦事前分布またはそれに近い事前分布を使ったベイズ統計の結果と非ベイズ統計の結果は数値的に互いに相手をよく近似するようになり、実践的にはほぼ同じもの扱いすることが妥当になる。
6
#統計 豊田『瀕死本』でのphcは実質的にP値そのものになってしまっており、結果的に豊田『瀕死本』は「P値を使うのを止めて、phcという名前に付け直してP値を使うべきだ」と主張していることになります。
こういう極めて滑稽な話になってしまっている。
こういう極めて滑稽な話になってしまっている。
7
#統計 P値は多くの場合に(常にそうであるわけではない点に注意)、パラメータθを持つモデルにおける仮説θ=a(aは具体的な数値)とデータの数値の相性の良さになっています。
仮説θ=aの数値aを動かせることを忘れると、仮説θ=0や仮説θ=1のP値しか考えないというおかしなことになる。
仮説θ=aの数値aを動かせることを忘れると、仮説θ=0や仮説θ=1のP値しか考えないというおかしなことになる。
8
#統計 仮説θ=aのaにP値を対応させるP値函数を考えると、ベイズ統計におけるパラメータθの事後分布と比較できる情報が得られます。
最尤法が有効な場合には、漸近的に、P値函数と事後分布は同じ情報を持っていることを数学的に示せます。(超大雑把な説明なことに注意!)
最尤法が有効な場合には、漸近的に、P値函数と事後分布は同じ情報を持っていることを数学的に示せます。(超大雑把な説明なことに注意!)
9
#統計 そういう場合に「ベイズ vs 非ベイズ」という対立図式を立てても無意味。豊田さんがここ数年のあいだやっていることはまさにそれで、個人的な意見ではベイズ統計の日本語による解説者として最悪の行為をしていると思います。
10
#統計 「ベイズも非ベイズもどちらも有用な道具だよね」という穏健な立場を捨てて、非論理的で過激なスタイルでおかしなことを述べるのはやめた方がよいと思う。
11
#統計 こういう話題と、natureに掲載された「800人以上の科学者達が統計的有意性に反対した」という有名な記事などとの関係については以下のリンク先スレッドを参照。
その記事の共著者3名のうちの2名がP値函数の使い方の解説を書いていることに注目!
その記事の共著者3名のうちの2名がP値函数の使い方の解説を書いていることに注目!
黒木玄 Gen Kuroki@genkuroki
#統計 その論文たちの共著者達の合計4名のうち3名が、有名な「800人以上の科学者達が統計的有意性に反対している」というnatureの記事 nature.com/articles/d4158… の共著者3名に一致しています。
「統計的有意性」への反対と「P値」の使用への反対は全然違う話なので誤解しないように気をつけて下さい!
「統計的有意性」への反対と「P値」の使用への反対は全然違う話なので誤解しないように気をつけて下さい!
12
#統計 「800人以上の科学者達が統計的有意性に反対した」という有名な記事そのものを見ても、その記事を書いた人達が書いた別の論文を見ても、P値の利用に反対するどころか、P値函数の使い方に関する最良の解説を書いていたりするわけです。
そういう大きな流れから豊田さんは隔絶されています。
そういう大きな流れから豊田さんは隔絶されています。
13
#統計 「統計的有意性」と「P値」の使用を同じだと誤解している人達は最近の論文
journals.sagepub.com/doi/10.1177/02…
のタイトルに "not only on point estimates and null p-values" とあることに注目するとよいと思います。続く
journals.sagepub.com/doi/10.1177/02…
のタイトルに "not only on point estimates and null p-values" とあることに注目するとよいと思います。続く
14
#統計 一般に、統計学的には点推定の結果だけを報告してはダメで、必ずその誤差の大きさの見積もりも報告しなければいけないことになっています。
だから、"not only on point estimates" の部分は常識の範囲内だと思います。続く
だから、"not only on point estimates" の部分は常識の範囲内だと思います。続く
15
#統計 "not only on ~ null P-values"におけるnull P値は「違いがない」や「効果なし」を意味する特殊な帰無仮説単独のP値のことです。
「違いはaである」(aは数値)のような仮説各々のP値をすべて考慮することと、null P値だけしか考慮しないことの違いは大きい。続く
「違いはaである」(aは数値)のような仮説各々のP値をすべて考慮することと、null P値だけしか考慮しないことの違いは大きい。続く
16
#統計 続き。null P値しか考えないことと、仮説θ=a達のP値をすべて考えることの違いが結構重要なことに気付けば、null P値しか使わない「統計的有意性」に反対してかつ「P値」の使用を積極的に進めることの整合性を理解できます。
17
#統計 そして、仮説θ=aの数値aにP値を対応させるP値函数とベイズ統計における事後分布の漸近的な関係を理解していれば、ベイズ統計が漸近的に通常のP値を使う方法の漸近的な上位互換(ただし計算量的にトレードオフがある)だと理解できます。
これはベイズ統計好きの人にとってうれしいボーナス。
これはベイズ統計好きの人にとってうれしいボーナス。
18
#統計 そして、通常のP値を使う統計学の手法を実践的に役立てて来た人達にとって、ベイズ統計を「異なる思想哲学主義に基く、全く別の統計学」だと誤解することなく、普段使っている統計学的手法の延長として正常に理解する道も開けます。
こういう道を潰そうとする行為が横行している。
こういう道を潰そうとする行為が横行している。
19
#統計 「心理学や生物学など p値が 0.05 を下回るか否かで論文の採否が決まりがちな分野において、p値よりもPHCを示す方向に改革すべし」という豊田さんの主張中のphcは実質p値なので、その豊田さんの主張は滑稽な主張扱いが妥当です。
shigepong@shigepong
@genkuroki 僕としては「心理学や生物学など p値が 0.05 を下回るか否かで論文の採否が決まりがちな分野において、p値よりもPHCを示す方向に改革すべし」という豊田主張の中心核の適否を論点にしたいです。
一般に、特定モデルにおける PHC の値が、実質的に P値と一致することがあっても特に問題ないのでは?
一般に、特定モデルにおける PHC の値が、実質的に P値と一致することがあっても特に問題ないのでは?
20
#統計 結構、統計学入門レベルの話(例えば二項分布モデルでの各種のP値の定義とその基本性質)について全然理解できていない状態で、豊田『瀕死本』を読むと、phcがもろにP値と一致している場合が扱われていることに気付かずに騙されてしまいます。
結構基本を理解できていない人は多い。
結構基本を理解できていない人は多い。
21
#統計 二項分布モデルの統計学の基本の1つにClopper-Pearsonの信頼区間をベータ分布を使って計算できるという話があります。そのベータ分布はimproper事前分布の事後分布とみなされるので、ベイズ統計と非ベイズ統計の関係を扱っていることになります。
まずは信頼区間について勉強することが大事。
まずは信頼区間について勉強することが大事。
22
#統計 通常の信頼区間について理解せずに、「ベイズ vs. 頻度論」の悪しき図式を描いて大恥をかいているように見えるケースにJaynes 1976があります。
へたに対立図式を描くと大恥をかくことがあるので、「ベイズも非ベイズも有用な道具だよね」で通した方が無難(笑)


へたに対立図式を描くと大恥をかくことがあるので、「ベイズも非ベイズも有用な道具だよね」で通した方が無難(笑)
黒木玄 Gen Kuroki@genkuroki
#統計 Jaynes(1976) bayes.wustl.edu/etj/articles/c… (doi.org/10.1007/978-94…)のpp.196-198がびっくりするぐらい酷い。
__不適切な__信頼区間の構成法と平坦事前分布のベイズ信用区間を比較して、信頼区間を強くdisり、さらにp.198辺りでそのことについて講演したときの様子を偉そうに説明している。
__不適切な__信頼区間の構成法と平坦事前分布のベイズ信用区間を比較して、信頼区間を強くdisり、さらにp.198辺りでそのことについて講演したときの様子を偉そうに説明している。
23
#統計 豊田さんは特に疫学方面の人達が発展させて来たP値函数の使い方などについて全く無知な様子が見られます。
「800人以上の科学者が統計的有意性に反対した」というnarureの有名な記事の共著者のうちの2人が書いた journals.sagepub.com/doi/10.1177/02… を読んだ方がよいです。
「800人以上の科学者が統計的有意性に反対した」というnarureの有名な記事の共著者のうちの2人が書いた journals.sagepub.com/doi/10.1177/02… を読んだ方がよいです。
shigepong@shigepong
@genkuroki 僕としては「心理学や生物学など p値が 0.05 を下回るか否かで論文の採否が決まりがちな分野において、p値よりもPHCを示す方向に改革すべし」という豊田主張の中心核の適否を論点にしたいです。
一般に、特定モデルにおける PHC の値が、実質的に P値と一致することがあっても特に問題ないのでは?
一般に、特定モデルにおける PHC の値が、実質的に P値と一致することがあっても特に問題ないのでは?
24
#統計 「違いはない」の型の特殊な帰無仮説のP値が5%を切ったかどうかで勝負を決しようとする行為が科学的にバカげていることは当たり前の話で、まともな人であればみんな否定しています。否定できない人は非科学的であると断じて問題ない。
それとP値の使用に反対することは全然別の話になります。
それとP値の使用に反対することは全然別の話になります。
25
#統計 「違いはない」の型の特殊な帰無仮説のP値が5%を切ったかどうかで勝負を決しようとする行為がまともだとみなされていた分野が仮に存在するとすれば、その分野を構成している人達の知的レベルに問題があることになります。
知的レベルが低い人達の問題をP値の問題にしてしまうのは非常にまずい。
知的レベルが低い人達の問題をP値の問題にしてしまうのは非常にまずい。
26
#統計 Clopper-Pearsonの信頼区間がimproper事前分布に対応する事後分布として現れるベータ分布を使って計算できることについては私のツイログ検索を参照
↓
twilog.org/genkuroki/sear…
解説
↓
nbviewer.org/github/genkuro…
ツイログ検索で見つけた
↓

↓
twilog.org/genkuroki/sear…
解説
↓
nbviewer.org/github/genkuro…
ツイログ検索で見つけた
↓
黒木玄 Gen Kuroki@genkuroki
#統計 Rのbinom.testで表示されるP値はSterneのP値で信頼区間はClopper-Pearsonの信頼区間で互いに整合性がありません。個人的な意見ではP値と信頼区間は同じP値函数から作ったものを使うべき。
そして、Clopper-Pearsonの信頼区間では二項分布とベータ分布の関係を使っている。
↓
そして、Clopper-Pearsonの信頼区間では二項分布とベータ分布の関係を使っている。
↓
27
#統計 お勧めの論文 journals.sagepub.com/doi/10.1177/02… に登場するP値函数については、二項分布モデルの場合の定義とグラフが(既出の) nbviewer.org/github/genkuro… にあります。易しい内容なので、これを読んでおけば、論文の内容もすぐに理解できると思います。論文も分かり易く平易に書かれています。
28
#統計 豊田さんの本で扱っているようなシンプルなモデルでは漸近的に違いがなくなることを証明可能。
標本サイズが小さい場合には、信頼区間が広くなり過ぎてダメな場合が多く、ベイズでは事前分布を狭くすれば信用区間も狭くできるが、豊田さんはそういう話はしていない。
標本サイズが小さい場合には、信頼区間が広くなり過ぎてダメな場合が多く、ベイズでは事前分布を狭くすれば信用区間も狭くできるが、豊田さんはそういう話はしていない。
shigepong@shigepong
@genkuroki 当該箇所は「P値に基づく仮説検定を行う際に許容されない論理展開が、PHCを示すさいには許容されるのだ」という主張の適用例ですよね。
PHCとP値が数値的に近過ぎる例なのはこの文脈に影響無いのでは?
P値よりPHCを示すべき、という主張の論拠として、数値の差が大きくなる例が欲しいのは同意。
PHCとP値が数値的に近過ぎる例なのはこの文脈に影響無いのでは?
P値よりPHCを示すべき、という主張の論拠として、数値の差が大きくなる例が欲しいのは同意。
29
#統計 シンプルなモデル+おとなしめの事前分布という豊田さんも採用している設定で、ベイズと非ベイズの結果が数値的によく一致することは昔からよく知られていることです。
わざわざそういう場合を選んで豊田さんはP値の使用を否定しているわけ。
わざわざそういう場合を選んで豊田さんはP値の使用を否定しているわけ。
shigepong@shigepong
@genkuroki 当該箇所は「P値に基づく仮説検定を行う際に許容されない論理展開が、PHCを示すさいには許容されるのだ」という主張の適用例ですよね。
PHCとP値が数値的に近過ぎる例なのはこの文脈に影響無いのでは?
P値よりPHCを示すべき、という主張の論拠として、数値の差が大きくなる例が欲しいのは同意。
PHCとP値が数値的に近過ぎる例なのはこの文脈に影響無いのでは?
P値よりPHCを示すべき、という主張の論拠として、数値の差が大きくなる例が欲しいのは同意。
30
#統計 数学の利用時に注意しなければいけないことは、定義が違っていても、数値的にぴったりまたは近似的(漸近的)に一致することを証明できてしまう場合が珍しくないこと。
定義が違うことにこだわり過ぎると容易にはまる。
定義が違うことにこだわり過ぎると容易にはまる。
31
#統計 豊田さんが好んで説明用に使っている二項分布モデルの場合には、ベイズと非ベイズをフェアに比較すると、相当に小さなnでそれらの結果は数値的によく一致します。
32
#統計 両側検定の文脈ではP値としてWilson's score版を採用すると、平坦事前分布のベイズ版とWilson's score版P値を使った結果はよく一致し、異なるP値の定義どうしよりもベイズ版とWilson's score版の方が近くなります。
異なるP値の定義達を認める立場なら、ベイズ版も仲間に入れざるを得ない。
異なるP値の定義達を認める立場なら、ベイズ版も仲間に入れざるを得ない。
33
#統計 統計学入門の教科書にあるようなシンプルなモデルですむ場合には、ベイズ版と非ベイズ版の違いを強調することはミスリーディングです。
一方、モデルが複雑になった場合にはそもそも非ベイズ版の使用自体が難しくなります。その場合にはベイズ法がお勧めということになります。
一方、モデルが複雑になった場合にはそもそも非ベイズ版の使用自体が難しくなります。その場合にはベイズ法がお勧めということになります。
34
#統計 豊田さんような統計学入門レベルで登場するシンプルなモデルを使った統計分析についてベイズと非ベイズの違いを強調する行為はミスリーディングです。
35
#統計 あと、モデルのパラメータ数が非常に大きい場合(無限個の場合も含む)の場合には、事前分布でパラメータの動く範囲を制限する手法は非常に有効。
ガウス過程回帰はパラメータ空間が無限次元の場合で、その場合にはベイズ的な方法が当然有効で実際にそうなっているわけです。
ガウス過程回帰はパラメータ空間が無限次元の場合で、その場合にはベイズ的な方法が当然有効で実際にそうなっているわけです。
36
#統計 豊田『瀕死本』は、複雑なモデルやパラメータ数が多いモデルでのベイズ法の有用性の話もしておらず、もっぱら、統計学入門の教科書にあるようなシンプルなモデルの場合にもベイズと非ベイズが本質的に違うというようなおかしな話をしています。
37
#統計 現代的なP値の解釈は journals.sagepub.com/doi/10.1177/02… でも紹介されているように、「データの数値と統計モデル+パラメータ値の相性の良さ(compatibility)の指標の1つ」です。
重要なポイントはその解釈によって、P値だけから自信過剰な結論を出すことを防ぐことです。続く
重要なポイントはその解釈によって、P値だけから自信過剰な結論を出すことを防ぐことです。続く
38
#統計 少し考えれば、ベイズ統計の事後分布を使って得た結論についても自信過剰を防いだ方が良いこともわかるはずです。
例えば事後分布におけるθ≥cの確率は「データの数値と統計モデル+事前分布と仮説θ≥cの相性の良さの指標」とみなし、自信過剰な解釈を防ぐのがよいと思います。
例えば事後分布におけるθ≥cの確率は「データの数値と統計モデル+事前分布と仮説θ≥cの相性の良さの指標」とみなし、自信過剰な解釈を防ぐのがよいと思います。
39
#統計 例えば、仮説Cがもっともらしいという結論を得たいときに、AとBとCの相性がよいと分かったとします。
そのとき、AとBが妥当ならば、妥当なAとBの組み合わせと相性の良い仮説Cの妥当性も高まったという結論が得られます。
しかし、AやBを疑うことを常に経由する必要が出て来る!!!(これ重要)
そのとき、AとBが妥当ならば、妥当なAとBの組み合わせと相性の良い仮説Cの妥当性も高まったという結論が得られます。
しかし、AやBを疑うことを常に経由する必要が出て来る!!!(これ重要)
40
#統計 一方、自信過剰な結論を防ぐという統計学の誤用を防ぐために最も重要な観点から見ると、AとBとCの相性がよさの指標でしかない値を「仮説Cが正しい確率」と呼んで広めようとする行為は極めて有害だと思われます。
41
#統計 以上のようなことを考え始めるための最初のステップとして、繰り返し進めている最近の論文(易しく書かれている) journals.sagepub.com/doi/10.1177/02… は非常に有用だと思います。
42
#統計 多くの場合に、データの数値には予想外のバイアスが含まれている危険性を排除できないし、統計モデル(ベイズの場合には事前分布を含む)の妥当性も保証しようがない。
そして、データとモデルの両方の妥当性を疑うことは統計学の応用で最も重要なステップになり、そのことへの配慮が重要。
そして、データとモデルの両方の妥当性を疑うことは統計学の応用で最も重要なステップになり、そのことへの配慮が重要。
43
#統計 この件では具体的な数学的議論や計算例の提示抜きで言葉だけで何を言っても時間の無駄だと思います。くだらない「思想哲学主義」の話になりやすい。
私がソースコード全公開でやっているレベルの数値例を1つ以上示してから私の発言に返答を送って頂きたいと思います。
私がソースコード全公開でやっているレベルの数値例を1つ以上示してから私の発言に返答を送って頂きたいと思います。
shigepong@shigepong
この論点については正直なところ賛否迷うところですが、僕はこの点で豊田先生側にシンパシーがあります。
誤用されやすい概念を誤用されにくい形に加工して広めることができるなら、そうするべき。
統計リテラシ要求水準を高くして、P値警察の利権にするのは嫌。
x.com/genkuroki/stat…
誤用されやすい概念を誤用されにくい形に加工して広めることができるなら、そうするべき。
統計リテラシ要求水準を高くして、P値警察の利権にするのは嫌。
x.com/genkuroki/stat…
44
#統計 私のツイログを検索してみればわかるように、どういう場合にベイズと非ベイズに違いが出るかについても、私も結構色々知っています。
最尤法が破綻する場合についても具体的な例を示していたりします。
そういう知識を前提に「豊田さんはダメだ」と言っているわけです。
最尤法が破綻する場合についても具体的な例を示していたりします。
そういう知識を前提に「豊田さんはダメだ」と言っているわけです。
45
#統計 仮説θ≥cのP値が小さくなっただけで、対立仮説θ<cがもっともらしいと判断するのは、P値の典型的な誤用です。
P値の計算で使ったデータAやモデルBの現実における妥当性は多くの場合に疑う価値がある。続く
P値の計算で使ったデータAやモデルBの現実における妥当性は多くの場合に疑う価値がある。続く
46
#統計 同じように、事後分布で測った仮説θ≥cが成立する確率が大きくなっただけで、仮説θ≥cがもっともらしいと判断するのは、ベイズ統計における事後分布の典型的な誤用になります。
事後分布の計算に使ったデータAやモデルB(事前分布を含む)の妥当性は多くの場合に疑う価値がある。続く
事後分布の計算に使ったデータAやモデルB(事前分布を含む)の妥当性は多くの場合に疑う価値がある。続く
47
#統計 事後分布で測った確率は、数学的なフィクションであるモデル内での、バイアスを含んでいるかもしれないデータの数値による条件付けで得られるモデル内条件付き確率に過ぎません。続く
48
#統計 ベイズ統計の事後分布は
パラメータ付き確率分布とパラメータの事前分布の組で定義されるモデルとパラメータ値
の
相性の良さ
を
データの数値から定まる条件付き確率密度
で測っていると解釈できます。
この解釈は穏健であり、自信過剰な解釈と相性が悪いです。
パラメータ付き確率分布とパラメータの事前分布の組で定義されるモデルとパラメータ値
の
相性の良さ
を
データの数値から定まる条件付き確率密度
で測っていると解釈できます。
この解釈は穏健であり、自信過剰な解釈と相性が悪いです。
49
#統計 自信過剰な解釈は
❌事後分布で測った仮説Cが成立する確率が大きければ、現実において仮説Cが正しい確率が高くなった
と単純に考えることです。これは非常にまずい。
ベイズ統計の事後分布と現実の関係はそういう単純なものではありません。
↑
これ、非常に重要!
❌事後分布で測った仮説Cが成立する確率が大きければ、現実において仮説Cが正しい確率が高くなった
と単純に考えることです。これは非常にまずい。
ベイズ統計の事後分布と現実の関係はそういう単純なものではありません。
↑
これ、非常に重要!
50
#統計 実際、
❌ベイズ版の95%信用区間であれば真の値を95%の確率で含むと考えてよい
のような自信過剰になるための解説をしている困った人達は、ベイズ統計の解説者の中では多数派になっていると思います。
そういう解説を理解できなかった人は論理的に正しいと思います。
❌ベイズ版の95%信用区間であれば真の値を95%の確率で含むと考えてよい
のような自信過剰になるための解説をしている困った人達は、ベイズ統計の解説者の中では多数派になっていると思います。
そういう解説を理解できなかった人は論理的に正しいと思います。
51
#統計 問題にするべきなのは、知的に低レベルでは無さそうに見える人達であっても、
❌ベイズ版の95%信用区間であれば真の値を95%の確率で含むと考えてよい
のようなミスリーディングなことを堂々と言っている場合が珍しくないこと。
おそらく、不幸な歴史に答えがあるのだと思う。
❌ベイズ版の95%信用区間であれば真の値を95%の確率で含むと考えてよい
のようなミスリーディングなことを堂々と言っている場合が珍しくないこと。
おそらく、不幸な歴史に答えがあるのだと思う。
52
#統計 おそらく、これはベイズ統計に関する解説に留まらない問題です。
例えば、統計学入門の教科書で、よく「正規母集団の仮定」を当然であるかのように書いてあることとも関係がある。
データとモデルを疑うことを平気で省略して良いかのような入門的解説が実に多い。
例えば、統計学入門の教科書で、よく「正規母集団の仮定」を当然であるかのように書いてあることとも関係がある。
データとモデルを疑うことを平気で省略して良いかのような入門的解説が実に多い。
53
#統計 「小さな世界」を当然の前提にしているかのような伝統的な解説法が、統計学教育における複数の問題を引き起こしているのではないか?
データ+モデルの組み合わせの妥当性を疑うことを忘れさせないようにしないとまずいのではないか?
データ+モデルの組み合わせの妥当性を疑うことを忘れさせないようにしないとまずいのではないか?
54
#統計 訂正:文字数制限に負けた。正しくは
ベイズ統計の事後分布は
データの数値と
パラメータ付き確率分布と事前分布の組で定義されるモデルと
パラメータ値
の3つ組の
相性の良さ
を
データの数値から定まる条件付き確率密度
で測っていると解釈できる。
ベイズ統計の事後分布は
データの数値と
パラメータ付き確率分布と事前分布の組で定義されるモデルと
パラメータ値
の3つ組の
相性の良さ
を
データの数値から定まる条件付き確率密度
で測っていると解釈できる。
55
#統計 事後分布の密度函数のパラメータ値θ=aにおける値は、
データの数値
と
パラメータ付き確率分布と事前分布の組で定まるモデル
と
パラメータ値θ=a
の3つ組からモデル内条件付き確率密度として決まります。その値はこの3つ組の相性の良さの指標の1つになっている。
データの数値
と
パラメータ付き確率分布と事前分布の組で定まるモデル
と
パラメータ値θ=a
の3つ組からモデル内条件付き確率密度として決まります。その値はこの3つ組の相性の良さの指標の1つになっている。
56
#統計 P値や事後分布だけを見ても、仮説の妥当性に関する情報は得られず、単に妥当かどうかよく分からないものどうしの相性の良さ(compatibility, 両立性)しかわからない。
仮説の妥当性については、P値や事後分布以外を使う議論が必ず必要になります。これは当たり前の話だと思います。
仮説の妥当性については、P値や事後分布以外を使う議論が必ず必要になります。これは当たり前の話だと思います。
57
#統計 そういう当たり前の話を強調せざるを得なくなっている理由は、当たり前の話を当たり前だと思えなくするような解説が溢れているから。
58
#統計 両側検定での仮説θ=aのP値は
データの数値
と
統計モデルと近似計算法
と
仮説θ=aを定める値a
から決まり、この3つ組の相性の良さ(compatibility)の指標の1つになります。
データの数値
と
統計モデルと近似計算法
と
仮説θ=aを定める値a
から決まり、この3つ組の相性の良さ(compatibility)の指標の1つになります。
59
#統計 P値ではなく、尤度(=尤度函数の値)についても同様です。
これによって、データとモデル(+近似計算法)とパラメータ値の3つ組の相性の良さ(compatibility)の互いに異なる指標として、
P値
と
尤度
と
事後分布の密度函数の値
の3つが得られることがわかります。続く
これによって、データとモデル(+近似計算法)とパラメータ値の3つ組の相性の良さ(compatibility)の互いに異なる指標として、
P値
と
尤度
と
事後分布の密度函数の値
の3つが得られることがわかります。続く
60
#統計 compatibilityの3種の指標の間の関係は、対数尤度函数に大数の法則と中心極限定理が十分に効いていると仮定すれば得られます。
その条件は概ね最尤法が有効に使える状況になっているという条件と同じことになります。
統計学入門の教科書にある状況では概ね成立していると考えてよいです。
その条件は概ね最尤法が有効に使える状況になっているという条件と同じことになります。
統計学入門の教科書にある状況では概ね成立していると考えてよいです。
61
#統計 ただし、事前分布として極端に偏ったものを与えた状況でないという仮定は必要です。
ただし、極端に偏った事前分布が妥当だという十分に証拠がある場合は、非ベイズ的方法を使う場合にもそのことを考慮する必要があります。
こういう場合はこのスレッドの文脈では考慮外として良いでしょう。
ただし、極端に偏った事前分布が妥当だという十分に証拠がある場合は、非ベイズ的方法を使う場合にもそのことを考慮する必要があります。
こういう場合はこのスレッドの文脈では考慮外として良いでしょう。
62
#統計 以上の状況では(以下のリンク先の状況では)、P値、尤度、事後分布を使う互いに異なる方法のあいだで近似的に翻訳法を数学的に作ることができ、3つの方法の間に本質的な違いがないことになります。
豊田さんがP値ではなく事後分布を使うべきだと言っているのはそういう場合になっています。
豊田さんがP値ではなく事後分布を使うべきだと言っているのはそういう場合になっています。
63
#統計 豊田『瀕死本』が提案していることは、P値の側に翻訳すると「ゴールをより厳しくすること」に過ぎません。
例えば、θ > 0.5 という条件を θ > 0.7 により厳しくすることは、事後分布を使わずに、P値を使っても同じようにできます。そして、数学的な理由で数値的にもほぼ同じ結果が得られる。
例えば、θ > 0.5 という条件を θ > 0.7 により厳しくすることは、事後分布を使わずに、P値を使っても同じようにできます。そして、数学的な理由で数値的にもほぼ同じ結果が得られる。
64
#統計 有意差検定しかP値の利用法を知らない人は、ゴールをより厳しめにする方法として有意水準を下げることしか思いつかないかもしれませんが、実際には仮説θ>0.5を仮説θ>0.7に強めるというようなこともできます。
まあ、これ、初歩中の初歩の話題に過ぎないのですが。
まあ、これ、初歩中の初歩の話題に過ぎないのですが。
65
#統計 あと仮説θ=aの両側検定のP値に数学的に対応する事後分布での確率は
❌事後分布でθ=aが成立する確率(常に0になる)
ではないという予備知識も必要です。この辺も数学を知らないせいで、誤解してしまっている場合もあると思います。
きちんと漸近論に基いて翻訳の辞書を作る必要があります。
❌事後分布でθ=aが成立する確率(常に0になる)
ではないという予備知識も必要です。この辺も数学を知らないせいで、誤解してしまっている場合もあると思います。
きちんと漸近論に基いて翻訳の辞書を作る必要があります。
66
#統計 実際には、仮説θ=aの両側検定の対立仮説についても多くの人が誤解していると思います。
帰無仮説θ=a
の両側検定について、よく
対立仮説θ≠a
と略記して書くのですが、これを
❌θはaに等しくないという単独の仮説
だと解釈すると誤りになります。続く
帰無仮説θ=a
の両側検定について、よく
対立仮説θ≠a
と略記して書くのですが、これを
❌θはaに等しくないという単独の仮説
だと解釈すると誤りになります。続く
67
#統計 続き。正しくは
⭕️a以外の値bに関する仮説θ=b全体の集合
が両側検定の対立仮説の正しい解釈です。無数の仮説の集合になる。このように解釈できないと、仮説検定に関する数学的理論を理解できなくなります。
この辺は「教科書を読め」という話になる。
⭕️a以外の値bに関する仮説θ=b全体の集合
が両側検定の対立仮説の正しい解釈です。無数の仮説の集合になる。このように解釈できないと、仮説検定に関する数学的理論を理解できなくなります。
この辺は「教科書を読め」という話になる。
68
#統計 仮説θ=a両側検定のP値の事後分布での数学的対応物には漸近的に同値なものが複数あるのですが、1つの取り方は、
⭕️事後分布で測ったθ≥aの確率とθ≤aの確率の小さい方の2倍
です。これは両側検定のP値が片側確率の2倍で定義可能なことの類似になっています。
⭕️事後分布で測ったθ≥aの確率とθ≤aの確率の小さい方の2倍
です。これは両側検定のP値が片側確率の2倍で定義可能なことの類似になっています。
69
#統計 以上で述べたような予備知識は、P値を使った統計分析法とそれに対応するベイズ統計の方法を比較するときの基礎になります。
個人的には、議論をするならば、こういうことを当然の前提にした上で議論をしたいです。
個人的には、議論をするならば、こういうことを当然の前提にした上で議論をしたいです。
70
#統計 ベイズ統計では、事後分布だけではなく、ベイズファクターもよく使います。シンプルなモデルであれば、漸近論+ちょっとした計算によって、
最尤法に基く仮説θ=aのP値
と
θ=aに台を持つ事前分布を使った場合とのベイズファクター
の間の翻訳も作れます。
最尤法に基く仮説θ=aのP値
と
θ=aに台を持つ事前分布を使った場合とのベイズファクター
の間の翻訳も作れます。
71
#統計 ベイズと非ベイズの翻訳の辞書を作るための数学的な基礎は、渡辺澄夫『ベイズ統計の理論と方法』の第3章で学べます。
同書第4章を見れば、ベイズ統計の方法がどのような場合に優れているかを知ることができます。
しかし、豊田さん的な怪しい話には決してなりません。
同書第4章を見れば、ベイズ統計の方法がどのような場合に優れているかを知ることができます。
しかし、豊田さん的な怪しい話には決してなりません。
72
#統計 私のツイログを検索すれば、ベイズと非ベイズの辞書の #Julia言語 による実装と数学的解説を見ることができます。
実装のソースコードまで全部見せてくれている場合は稀だと思います。
例えば、平坦 事前分布 を検索した結果は
↓
twilog.org/genkuroki/sear…
実装のソースコードまで全部見せてくれている場合は稀だと思います。
例えば、平坦 事前分布 を検索した結果は
↓
twilog.org/genkuroki/sear…
73
#統計 続き。それらは、渡辺澄夫『ベイズ統計の理論と方法』の第3章に書いてある漸近論をコンピュータで確認しているだけに過ぎないのですが、n→∞とすることによる近似が有限のnでどこまで有効かは一般論からはわからないので、コンピュータによる確認にも大いに価値があると私は思っています。
74
#統計 あと言うまでもないことですが、平坦事前分布以外の場合も色々計算してあります。