不会写分镜,也能用 Codex + MiniMax H3 / Seedance 2.5 做出第一条 AI 视频

AI 时代,每个人似乎都可以成为“导演”,做出过去需要专业团队才能完成的画面。真正的问题是,一般人不知道第一步该做什么。

我也是一个艺术盲。最近用 AI 做了两条视频,谈不上多好,但至少把流程完整跑通了。我把自己的经验整理出来,算是抛砖引玉。也希望你读完以后,能勇敢迈出第一步:别只临渊羡鱼,先下水捞第一条鱼。
本文的例子都使用我本地的 MiniMax H3。如果你用的是 Seedance 或其它多模态视频模型,具体按钮和能力限制可能不同,但整体制作步骤基本相通。
这篇不要求你会导演、画画或者写专业提示词。你只需要会做选择。视频分析、文案、参考图、提示词和失败检查,都可以交给 Codex 或 ChatGPT 帮你完成。
下面我用“做一条 15 秒左右的穿搭变装视频”作为完整例子。你也可以把题材替换成产品广告、人物短剧、宠物故事或者电影感片段。
一、开始前准备四样东西
第一条视频不用 API,也不用先学剪辑。准备:
第一次建议控制在 10–15 秒、一个主角、一个场景。先把流程跑通,再做 30 秒、多人物和复杂对白。
MiniMax H3 和 Seedance 2.5 不是同一个模型。H3 官方支持最多 15 秒,以及首帧、尾帧和多模态参考;Seedance 2.5 官方支持单次最长 30 秒,并支持更多图片、视频和音频参考。不同产品界面开放的功能可能不完全一样。
二、把参考视频或想法交给 Codex,先不要急着生图
打开一个新任务,把链接和下面这段话一起发给 Codex:
我想学习这条视频的创作结构:
<粘贴视频链接>
目标:做一条原创的 9:16、约 15 秒视频,使用 MiniMax H3 或 Seedance 2.5 生成。
请先不要生成图片和视频提示词。先帮我分析:
1. 这条视频最值得学习的核心玩法是什么;
2. 开始画面是什么,结束时发生了什么变化;
3. 主角、场景、镜头和动作分别需要保持什么;
4. 我需要准备哪些参考图片;
5. 哪三个地方最容易生成失败。

不要复制原视频人物、Logo、文字或音乐。看完后给我一个简单方案,等我确认再继续。
如果你没有参考视频,可以这样写:
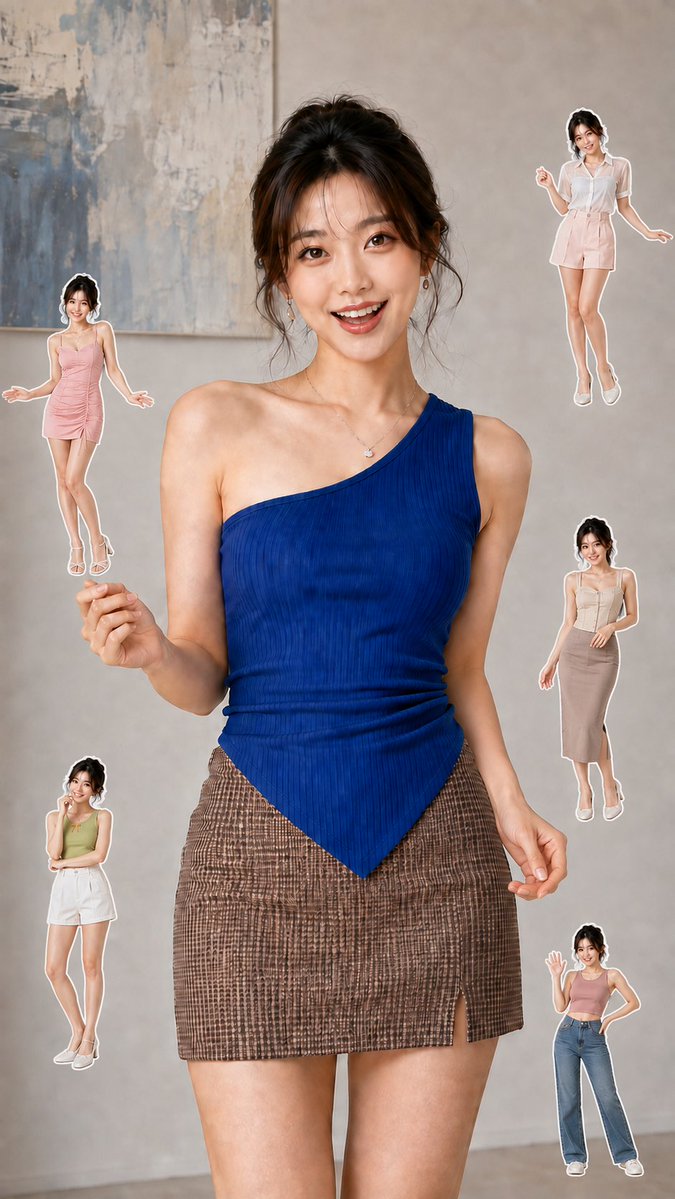
我想做一条 15 秒的竖屏视频:同一位成年女性在房间里跳一段轻松的小舞,周围有五个不同穿搭的小人。鼠标每点击一个小人,主角就快速换成对应衣服。最后五个小人全部消失,主角穿最后一套继续跳舞。

请先帮我补全人物、五套穿搭、场景和节奏,给我两个简单方案。我选择以后再生成图片。
这一轮你只需要判断:这个玩法是不是你想做的,人物和场景是否合适,视频有没有塞太多事情。
三、让 Codex 列一张普通人看得懂的“制作单”
方案确认后,继续问 Codex:
请把它整理成一张制作单。不要使用导演术语,用普通人能看懂的方式列出:
- 要生成几张图;
- 每张图负责什么;
- 图里必须出现什么;
- 什么东西必须保持不变;
- 最后要把哪些素材上传到视频模型。

这一轮仍然不要开始生图,先让我确认制作单。
穿搭例子的制作单其实很简单:
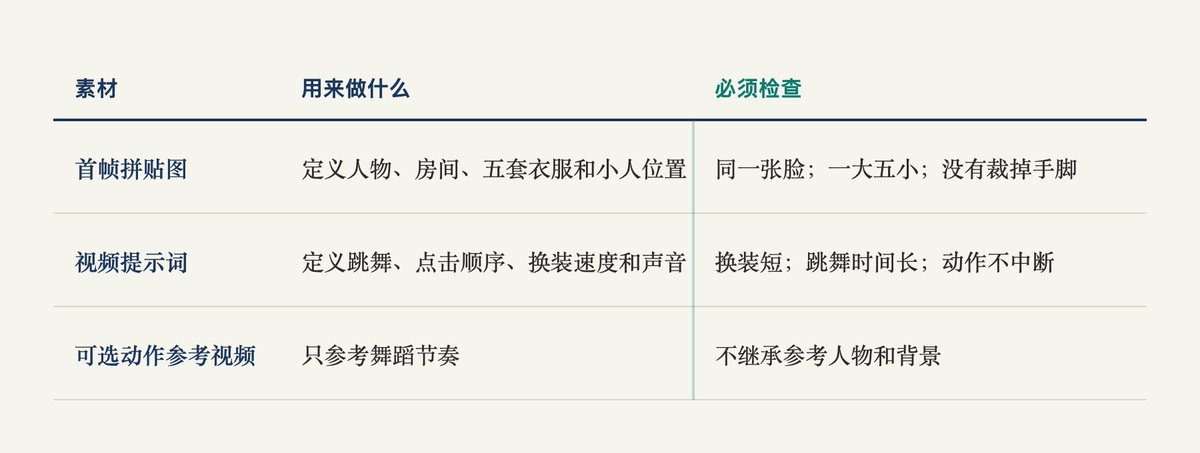
只有结尾必须落在一个精确画面时,才需要第二张尾帧。普通的连续舞蹈先用一张首帧,更容易保持自然动作。
多人物短剧会需要更多素材。例如我在复制Cuimao“牛来”视频时,使用了主角设定、配角阵容、人物站位、场景空镜、道具和四格分镜,后面第九章会具体讲到。第一条视频先不要把这一套全部搬过来。
四、先生成一张测试图,不要一次生成整套素材
制作单确认后,让 Codex 或 ChatGPT 生成首帧:
现在开始生成首帧测试图,一次只生成一张。

要求:
- 9:16;
- 原创中国成年女性,视觉年龄 24–28 岁;
- 房间内固定机位,主角从头到大腿中部,占画面主要位置;
- 周围正好五个较小的完整人物剪影,代表五套穿搭;
- 五个小人的手臂、肩膀和重心略有不同,像连续的舞蹈动作;
- 所有人必须是同一张脸、同一发型和同一身材比例;
- 小人不能挡住主角,头、手、腿和鞋必须完整;
- 不要文字、Logo、水印和鼠标。

先生成,我看完再决定是否修改。
生成后先数人数,再看脸和手脚。不要因为画面第一眼漂亮就直接进入视频。

如果只有一处不对,就告诉模型只改这一处:
右下角穿牛仔裤的小人被底边裁掉了。
只把这个小人缩小约 20%,向上移动,完整露出鞋子和白色轮廓。
人物身份、其它五个人、服装、房间、构图和光线全部保持不变。
如果人物数量、脸和构图同时出错,重新生成通常比连续修补更省时间。
五、让 Codex 根据已经确认的图片写视频提示词
首帧通过以后,把图片交给 Codex,发:
这张首帧已经确认。请为 MiniMax H3 写一段可以直接复制的视频提示词。

视频 14 秒,9:16,固定机位,一个连续镜头。主角从第一秒就开始轻松跳舞。
五次换装分别使用周围五个小人,顺序由你根据位置安排。

每次换装要求:
1. 小鼠标快速点击目标;
2. 小人用约 0.3 秒飞向主角并立刻消失;
3. 接触身体时衣服已经换好;
4. 不要让放大的小人停在主角前面;
5. 主角的手臂、肩膀和重心继续运动;
6. 两次换装之间留出约 1.5–2 秒展示新衣服和跳舞。

请写清:首帧职责、完整时间轴、每段具体动作、声音和针对性禁止项。不要为了显得专业堆砌镜头术语。
六、把素材放进 H3 或 Seedance,先生成一个测试版
使用 H3 做这个穿搭例子时:
七、把生成的视频交回 Codex,让它帮你找具体错误
视频出来以后,先自己正常看一遍。只记录让你明显出戏的地方和大概时间,例如:
2 秒:粉色小人挡住主角太久。
5 秒:脸好像换了。
9 秒:衣服换了,但手突然回到初始位置。
然后把 MP4 发给 Codex:
这是刚生成的视频。请自己读取视频并抽帧检查。

先告诉我它和目标视频最明显的差别,再检查:
1. 人物脸、发型和身材有没有变化;
2. 每次转场实际持续多久;
3. 转场有没有遮住主角;
4. 手臂、重心和视线有没有突然重置;
5. 背景和镜头有没有无故变化;
6. 哪三个问题最影响观感。

区分你直接看到的问题、合理推测的原因和暂时无法确认的原因。先诊断,不要立刻重做全部素材。
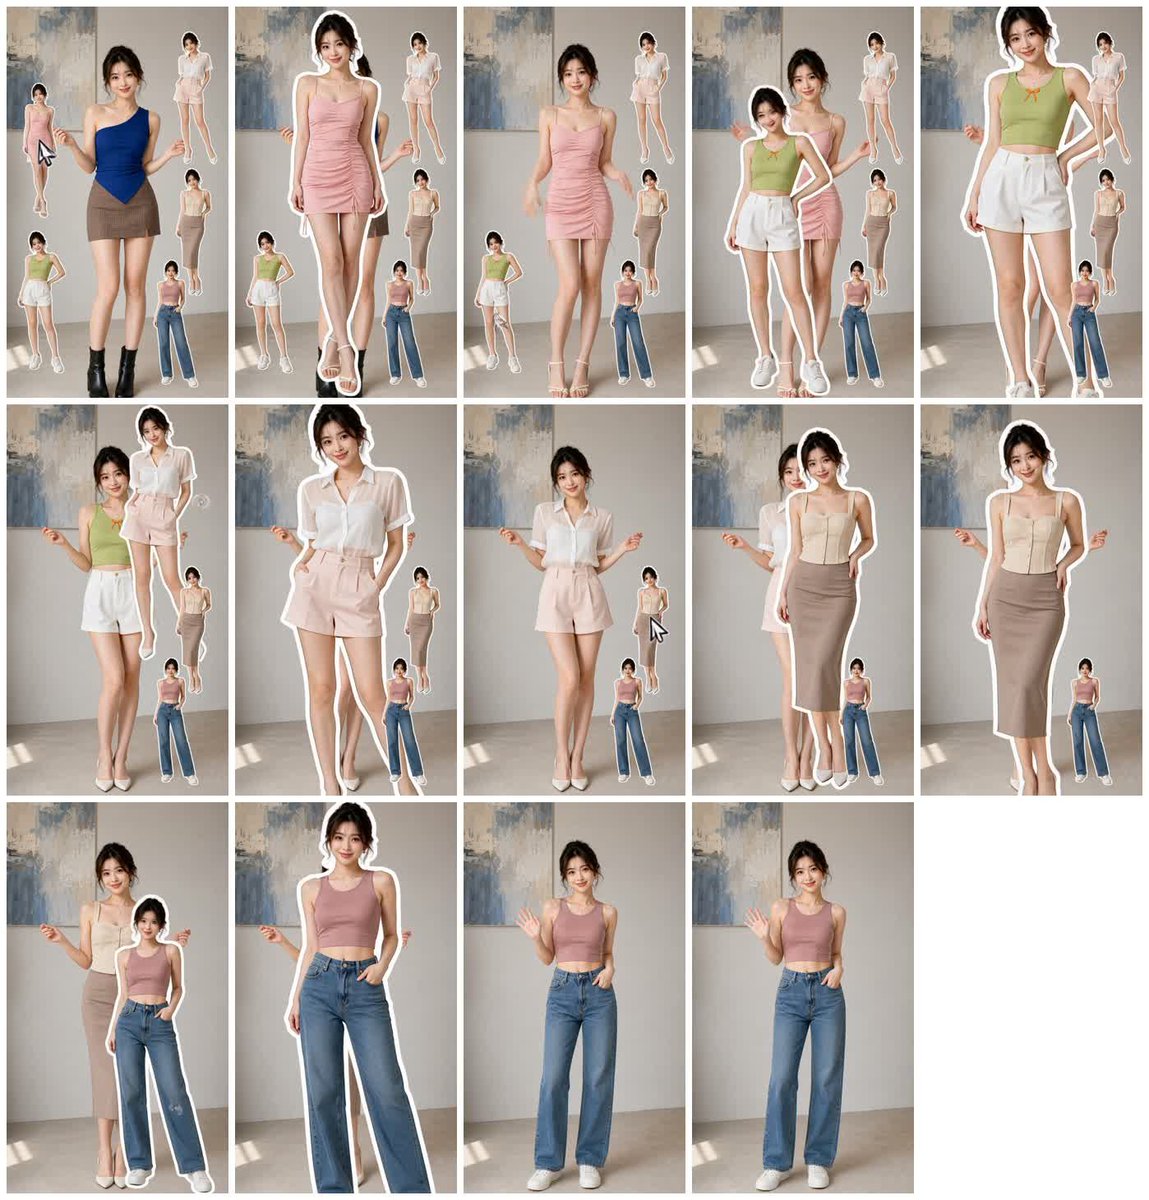
这正是我们检查第一次穿搭结果时看到的情况:小人放大得太大,白色描边停留太久,画面里经常同时存在两个完整人物。
八、一次只修一个主要问题
如果最影响观感的是转场太慢,就先只改转场:
根据刚才的诊断,修改视频提示词。

只修复这三个问题:
- 每次飞入控制在约 0.3 秒;
- 小人接触主角身体时立刻消失;
- 换装前后的跳舞动作连续,不停下来等待对齐。

保留人物、五套服装、场景、镜头、换装顺序和总时长。
请输出一份完整的新提示词,并用三句话说明改了什么。
重新生成后,把两个版本放在一起比较。不要同时更换人物图、动作、镜头、音乐和时长,否则即使变好,也不知道是哪项修改起作用。
如果同一个错误连续出现两次,就回到上游检查首帧和动作设计。不要一直往提示词后面追加“更自然、更稳定、更高质量”。
九、多分镜怎么做
穿搭视频只有一个场景和一个连续镜头。遇到多人物、有对白、需要切换景别的剧情视频,难点会变成:人物换了镜头以后还是不是同一个,手里的东西有没有跳走,前一个镜头的动作能不能接到下一个镜头。下面用 [cuimao_reverse](https://github.com/michaelpersonal/cuimao_reverse) 做完整例子。这个项目拆解的是 @cuimao “牛来”视频开头约 15 秒:一群动物外卖员吃饭,熊猫不断调侃牛,周围角色逐渐笑起来,牛从假装没听见变成准备回应。
这不是Cuimao的原始工程或原始提示词,而是根据公开视频做的教育性重建。项目里的参考图、分镜和提示词都是重新制作的。
9.1 把参考视频交给 Codex,先拆故事变化
普通用户可以先把视频链接和下面这段话交给 Codex:
请分析下面视频的开头 15 秒:
https://x.com/CuiMao/status/2088622639313191396

我想用原创角色学习它的多人物喜剧结构,不复制原角色设计和原始画面。

先不要生成素材。请告诉我:
1. 这 15 秒的故事变化;
2. 有几个主要角色,每个人在做什么;
3. 每次切镜头的原因;
4. 哪些人物、场景、道具和左右关系必须保持一致;
5. 如果用 Seedance 生成,需要哪些参考图片和几个关键分镜。

把结果写成普通人能确认的制作单,等我确认后再继续。
Codex 最后把这段剧情压缩成:
牛低头吃饭、看手机,假装没听见
→ 熊猫进入画面并接管对话
→ 熊猫说完笑话,熊和狐狸延迟加入笑声
→ 牛的身体变紧,准备抬头回应
这条变化比“先中景、再双人镜头、最后特写”更重要。镜头要服务谁正在掌控对话,以及喜剧压力如何升级。
9.2 让 Codex 设计参考素材包
制作单确认后,我们让 Codex 把需要的图片拆成五类:

给 Codex 的请求是:
按照确认后的制作单,为这个 15 秒多人物视频设计参考素材包。

请依次输出:
1. 牛主角角色设定图的生图提示词;
2. 熊猫、狐狸、棕熊和猴子的配角阵容提示词;
3. 所有人物在夜间外卖员休息区的群体站位图提示词;
4. 不含人物的环境空镜提示词;
5. 饭盒、面杯、两双筷子、手机、头盔、背包和外卖车的道具图提示词。

每条提示词都写清它负责锁定什么。角色使用原创设计,不要品牌文字。先生成主角和配角测试图,等我确认身份以后再生成站位图和分镜。
其中牛主角的实际提示词是:
创建一张原创拟人牛外卖员的制作设定图。

同一个角色以正面、四分之三侧面、侧面和背面全身出现,比例和服装完全一致;另外显示平静、压住不耐烦、惊讶和准备反驳四种面部表情。

固定身份:体格宽大的棕色公牛,宽阔口鼻,深色眼睛,稳定的弯角轮廓;黄色外卖头盔和透明面罩,黄色保温外卖夹克,深色裤子,黄色外卖背包。增加拿饭盒、筷子和手机的小动作参考。

中性纯净背景,均匀参考光,不要电影景深,不要姿势互相遮挡,不要改变角的形状、服装或身体比例,不要图片内文字。
所有图片确认后,我们把五类素材排成一张参考素材表。这样在 Seedance 里只需要上传一个 `@Image 1`,但提示词仍然可以按区域说明每种素材的职责。

完整的六组生图提示词在 (https://github.com/michaelpersonal/cuimao_reverse/blob/main/prompts/reference-image-prompts.md)。
9.3 用确认后的素材生成四格分镜
人物身份和场景没有确认以前,不要做分镜。否则分镜很漂亮,但里面的角色可能已经变成另一版。
我们使用四个检查点:
给 Codex 的分镜任务可以直接这样写:
人物参考素材包已经确认。请基于同一套人物、服装、场景、道具和灯光,设计一张 2×2 四格分镜。

Panel 1:中景群像。牛在食物柜台前低头吃饭、看手机;狐狸在左侧,猴子和外卖车在后方。
Panel 2:熊猫从右侧接管画面,形成熊猫/牛双人镜头;牛始终在熊猫左边,棕熊在两人后方。
Panel 3:熊猫中近景笑着说完笑话,熊和狐狸在后方稍晚才开始笑;牛大部分离开左侧画面。
Panel 4:反打牛。牛停下吃饭,抬起视线,身体转向熊猫,准备回应。

四格必须使用已经确认的角色身份。保持牛在熊猫左侧的关系、道具归属、夜间外卖员休息区、柜台和外卖车位置。不要加入分镜文字、箭头或编号。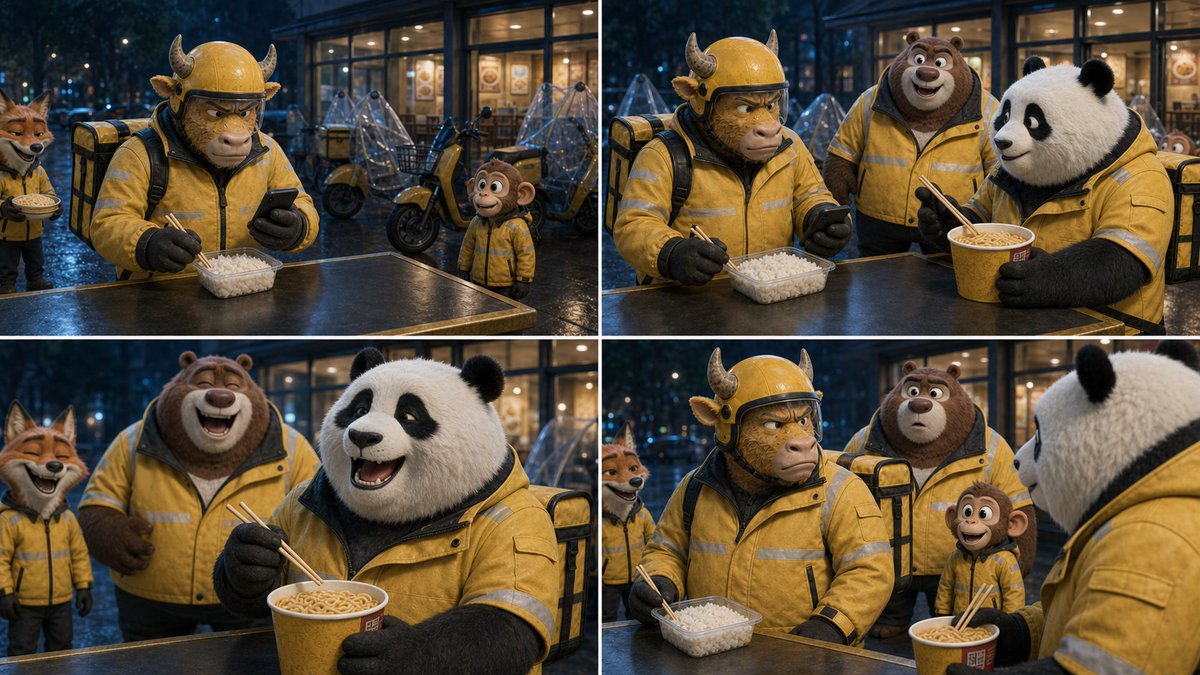
关键是顺序生成:Panel 2 继承 Panel 1,Panel 3 继承 Panel 2。不要让模型从文字独立生成四张毫无关系的漂亮图。
9.4 让 Codex 为每个镜头写开始和结束状态
分镜通过后,把它交回 Codex:
请根据确认后的四格分镜,为 15 秒视频建立 shot state map。

每个镜头写清:
- 时间范围和目的;
- 开始时每个角色的姿势、视线和道具;
- 什么动作触发这一段;
- 眼睛、头、手、身体和表情的动作顺序;
- 镜头结束时的准确状态;
- 下一镜头必须继承的重心、视线、道具位置和情绪;
- 这一个镜头最需要禁止的三项错误。

不要只写“自然地说话”或“保持一致”,要写可以在画面中检查的状态。
第一个镜头实际被写成:
00:00–00:04.4|群体建立

开始:牛坐在柜台前,肩膀收拢,低头看手机;左手拿饭盒,右手拿筷子。熊猫还没有占据前景。

动作链:
稳住饭盒
→ 筷子夹饭
→ 送到嘴边
→ 咀嚼
→ 眼睛回到手机
→ 听到调侃后只出现很小的眼神反应

结束:牛仍然低头,身体略微变紧;熊猫准备从右侧进入前景。

禁止:牛过早抬头、饭盒或手机换手、牛和熊猫左右位置翻转。9.5 让 Codex 编译 Seedance 多参考提示词
参考素材和状态图都通过以后,再生成最终提示词:
现在请把已经确认的参考素材包、四格分镜和 shot state map 编译成一段 Seedance 多参考提示词。

输入:
@Image 1:参考素材包,负责人物身份、服装、相对身高、场景、站位和道具。
@Image 2:四格分镜,负责镜头顺序、构图、姿势检查点、视线和每个镜头的结束状态。

视频:15 秒,16:9,三个连续镜头。
镜头边界:约 4.4 秒和 11.2 秒。
对白使用原项目中已经确认的中文对白。
写清每个镜头的动作链、说话者、延迟反应、道具归属、镜头方向、开始状态和结束状态。

不要把四格边框、箭头或标签生成进视频。牛始终位于熊猫左侧,不得越过对话轴线。最后停在熊猫笑完、牛准备回应的状态,以便下一段继续。
最终提示词首先明确两张图的职责:
@Image 1 是权威参考素材包:
上左定义牛的脸、毛色、角、体型、头盔、面罩、夹克和背包;
上右定义熊猫、狐狸、棕熊和猴子的身份;
中左定义人物站位、相对身高、视线和道具归属;
中右定义店面、柜台、外卖车、雨棚、湿地和灯光;
底部定义饭盒、面杯、筷子、手机、头盔、背包和外卖车。

@Image 2 是四格分镜:
按左到右、上到下读取,只负责镜头顺序、构图、站位、动作检查点、视线、道具位置和每个镜头的结束状态。
不要生成分镜边框、编号、标签或箭头。
然后才写三段时间轴。比如第二段:
00:04.4–00:11.2|熊猫/牛双人镜头

牛保持在左侧,继续吃饭和看手机。熊猫从右侧接管前景,筷子停在面杯上方。

熊猫动作:
筷子停住
→ 眼睛先看向牛
→ 头跟随视线
→ 眉毛抬起
→ 开口调侃
→ 筷子做一个很小的指向动作
→ 手回到面杯附近
→ 说完后开始笑

棕熊在后方慢半拍才靠近。牛没有抬头,只让下巴和肩膀逐渐变紧。

结束:熊猫的问题说完并开始笑;棕熊刚开始反应;牛仍低头,但已经压住怒气。9.6 实际上传到Seedance的顺序
这个项目的快速路径只上传两张图:
@Image 1:reference-pack-contact-sheet.png
@Image 2:storyboard-contact-sheet.png
Prompt:seedance-15s.md 中的完整提示词
时长:15 秒
画幅:16:9
上传后先确认图片编号。提示词把人物身份交给 `@Image 1`,把镜头结构交给 `@Image 2`;编号错了,后面写得再仔细也没有用。
如果使用的平台无法在 15 秒内稳定执行三个镜头,可以只在 4.4 秒或 11.2 秒这种有明确结束状态的边界拆分。下一段需要同时上传上一段成片、最后一帧、人物参考和后续分镜。
9.7 用实际时间点检查成片
生成完成后,把视频交回 Codex:
请读取生成的 15 秒视频,正常播放一次,再在 4.4 秒、11.2 秒和 15 秒附近逐帧检查。

检查:
1. 牛是否始终在熊猫左侧;
2. 牛的饭盒、筷子和手机有没有换手、消失或重置;
3. 熊猫的面杯和筷子是否延续;
4. 谁说话时由谁动嘴;
5. 熊和狐狸是否在熊猫之后才笑;
6. 牛有没有在笑话落地前过早生气;
7. 柜台、外卖车、雨棚和夜景灯光是否保持;
8. 15 秒结束状态能否直接接到牛抬头回应。

列出具体时间和具体错误。区分直接观察、合理推测和未知。先诊断,不要用“更一致”这种泛化建议。
这三个时间点不是随便选的:
9.8 失败以后怎样局部修
如果第二个镜头里牛的头盔和角发生变化,不需要推翻全部素材。可以这样要求:
只修复 00:04.4–00:11.2 的第二个镜头。

保持已经确认的熊猫、牛、背景、构图、对白、时间和道具位置。
牛仍在画面左侧,拿同一个饭盒和手机。
只修复牛的头盔、透明面罩和弯角轮廓,使它们与 @Image 1 完全一致。
不要改变熊猫的动作、镜头位置或场景。
如果多个镜头都出现同一张脸或同一个场景错误,就回到参考素材包修。只有一个边界坏了,才修对应镜头。问题出在哪一层,就回哪一层,不要让模型围着一条坏视频反复“提高质量”。
多分镜视频的核心仍然是这一条:前一个镜头的结束状态 = 后一个镜头的开始状态
人物身份、重心、视线、道具位置、左右关系、光线和残余动作都要一起继承。这样 Codex 才能把复杂剧情拆成普通用户可以逐步确认的几个小决定。
十、第一条视频的完成标准
第一条视频不需要证明你掌握了所有模型。满足下面几项,就算流程跑通:
连续做完两三条以后,再让 Codex 把你已经验证过的流程整理成 Skill。不要第一天就试图自动化一套还没有跑通的方法。