《Holistic Context》写了三个机制,我去开源代码里挨个找了一遍。

兄弟们,大部分技术报告,你只能选择信或者不信。

因为你看不到它跑的东西,论文说"我们设计了一套记忆机制",配一张架构图、一组分数,然后就没有然后了
图里那些方框对应什么代码,没人知道。
MelandLabs 这份《Holistic Context》不一样,它在摘要第一段就写了一句可以被检验的话:
我们提出 Holistic Context,一套在 OpenContext 开源 AI 同事中实现的跨会话上下文框架。
这句话是可验的。melandlabs/opencontext 是公开仓库,Apache 2.0,clone 下来就能读。
那这件事就变得可以做了:论文说它用了三个机制,我去代码里一个个找,看看在不在、叫什么名字、参数是多少。
先把话说死
我核的是「机制在不在代码里」,不是「benchmark 数字对不对」。
这两件事完全不同。97.6% 我没有复现,也复现不了:那需要 LongMemEval-S 全量数据、同样的骨干模型、同样的评审配置,我一样都没有。
我能做的只有一件事:论文说它用了某个机制,我去确认这个机制真的在代码里,参数写的是多少。
这篇就是这件事的记录。
Alloomi 的技术路线分三层—全域上下文、自进化、专业交付。这篇核的是第一层,最后几节会说清楚它在整体里的位置,以及为什么另外两层我核不了。
(版本说明,免得你对不上:两份报告读的都是 2026 年 8 月 12 日的版本,代码核的是 melandlabs/opencontext 的 commit 63a5f63。下面每一处引用都带文件名和行号,你可以自己去查。)
这两件事完全不同。97.6% 我没有复现,也复现不了:那需要 LongMemEval-S 全量数据、同样的骨干模型、同样的评审配置,我一样都没有。
我能做的只有一件事:论文说它用了某个机制,我去确认这个机制真的在代码里,参数写的是多少。
这篇就是这件事的记录。
Alloomi 的技术路线分三层——全域上下文、自进化、专业交付。这篇核的是第一层,最后几节会说清楚它在整体里的位置,以及为什么另外两层我核不了。
(版本说明,免得你对不上:两份报告读的都是 2026 年 8 月 12 日的版本,代码核的是 melandlabs/opencontext 的 commit 63a5f63。下面每一处引用都带文件名和行号,你可以自己去查。)
一、先看报告说了什么
《Holistic Context: A Unified Cross-Session Context Retention Framework for Long-Horizon Autonomous Agents》,MelandLabs。
它要解决的问题用一句话说得清:AI Agent 干活跨天、跨会话、跨平台,而上下文窗口是固定的。窗口外的信息直接消失,窗口内的信息也只是一堆没组织过的 token。
它的主张是:上下文不该被当成一段会过期的 token 序列,而该被当成一份持续维护的状态。
三个基准的成绩:
▍LongMemEval-S (n=500)
  Holistic Context:97.6%
  主要对照:长上下文基线 43.8%、MemGPT 48.7%、Mem0 52.0%、Hindsight 91.4%、Mem0 V3 94.4%
▍LoCoMo (n=10)
  Holistic Context:97.4%
  主要对照:A-MEM 51.29%、Mem0 66.88%、TiMem 75.30%、Hindsight 85.67%、Mem0 V3 92.5%
▍BEAM(128K / 500K / 1M / 10M)
  Holistic Context:72.8 / 75.7 / 76.5 / 67.0%
  主要对照:Hindsight 73.4 / 71.1 / 73.9 / 64.1
BEAM(128K / 500K / 1M / 10M) | 72.8 / 75.7 / 76.5 / 67.0% | Hindsight 73.4 / 71.1 / 73.9 / 64.1数字很好看。但让我愿意继续往下读的,是紧接着的这段—它自己写的限定(摘要原文,以下为我的翻译):
所有 Holistic Context 的格子都是单种子、单骨干(Claude Sonnet 4.5)的点估计;BEAM-128K 那一格跑的是 100K token 子集;LoCoMo 那一格只覆盖十段对话;跨论文的基线行,是那些在不同骨干、不同评审配置下运行的系统已发表的数字。
因此,表头数字应当被读作可行性演示(feasibility demonstration)。
这不是我从角落里挖出来的免责声明—它就写在摘要里,紧挨着那几个漂亮数字。
正文里它又把这句说了一遍:这个比较「不是受控的一对一对照」。BEAM 那一节甚至主动写明,自己在 128K 上比 Hindsight 低 0.6 个百分点。
一份把自己的限定写到这个程度的报告,比只贴分数的可信。它主动告诉你:这些数字能证明什么、不能证明什么。
(同一团队的另一份报告《Self-Evolving Agent》里也是同样的态度—它把自己在公开榜单上的名次标注为「仅作外部参照,不构成框架贡献声明」,理由是榜单第一名的模型在骨干、参数量、训练数据、推理预算上同时不同,不是同类比较。能忍住不用榜单名次做宣传的技术团队,不多。)
所以这篇文章不会去争论 97.6% 是高是低。我想知道的是:撑起这个数字的三个机制,代码里到底怎么写的。
二、这三个机制,用大白话是什么
论文的三个机制名字都挺学术,先翻译一遍。
机制一:applicability-scoped attribution(可适用范围的归属)
大白话:不光记住"张三说预算是 50 万",还要记住"这是他在 3 月那个项目会上说的,只对那个项目有效"。散落在邮件、会议、文档里的碎片,要归到同一个实体上,并且各自带着适用范围。
机制二:tiered forgetting with evidence-preserving deprecation(分层遗忘 + 保留证据的退役)
大白话:过期的东西要能忘掉,但得留个存根——将来还能回答"你当时为什么那么认为"。
机制三:Hebbian relation learning with competition(带竞争的赫布关系学习)
大白话:经常一起出现的东西会互相绑定,久了不用的连接会松掉。名字来自神经科学里那句"一起激发的神经元会连在一起"。
论文自己给了这个机制的工程对应物:Personalized PageRank over co-activation graphs——在共同激活图上跑个性化 PageRank。
记住这句,第五节全靠它。
三、机制一:一处一字不差,一处形状不同
代码里 applicability 这个词出现了 177 处,核心定义在:
代码里 applicability 这个词出现了 177 处,核心定义在:
packages/ai/memory-consolidation/src/graph-contracts.ts
先说对上的
论文说,有一条 scope isolation 不变式:每张记忆图都绑定在一个 (userId, workspaceId, tenantId) 三元组上,跨范围的归属只能走显式关系,绝不默认共享—目的是防止一个私有工作区的事实悄悄泄进另一个的检索结果。
代码第 1 到 5 行:
export interface OwnerScope {
userId: string;
workspaceId?: string;
tenantId?: string;
}
一字不差,一字不差。
这个不用多解释:论文说了个数据隔离的承诺,代码里有个同名同结构的类型在承载它。
再说没对上的
论文把 Applicability Context 定义成一个五元组:
A(f) = ( task(f), conversation(f), channel(f), person(f), [有效区间] )
五个并列的轴,一条记忆同时带这五个属性。
代码第 7 到 15 行:
export type MemoryApplicabilityScope =
"global" | "task" | "conversation" | "channel" | "project" | "custom";
export interface MemoryApplicabilityContext {
scope: MemoryApplicabilityScope;
key?: string;
validFrom?: number;
validUntil?: number;
metadata?: Record<string, unknown>;
}
形状不一样。
不是五个并列的轴,是一个六选一的枚举,选完再用 key 指定具体是哪个任务、哪场对话。而且:
这说明论文造假了吗?没有,我不这么认为。
person 完全可能由上面那个 OwnerScope.userId 承载,或者用 key 字段装。论文写的是概念模型,代码是它的一种落地形式,两者本来就不需要一一对应。
但形状确实不同,而这件事只有把两边摆在一起才看得见。我的结论只到这儿为止,再往前推就是过度解读,我没有证据。
四、机制二:论文只说了方向,代码给了数字
分层遗忘的核心在:
packages/ai/memory-consolidation/src/plan.ts
先说三层
论文说记忆分短、中、长三层。这个在代码里是一个独立的类型,在隔壁文件(evidence-cluster.ts 第 18 行):
export type MemoryEvidenceTier = "short" | "mid" | "long";
短、中、长。用词和论文一模一样,而且有默认值(adapter.ts:193):
const DEFAULT_TIER: MemoryEvidenceTier = "short";
一条新证据进来,默认落在短期层。
分层之外,还有一套动作
plan.ts 第 7 行定义了四个生命周期动作:
export type MemoryConsolidationAction =
"preserve" | "observe" | "decay" | "deprecate";
保留、观察、衰减、退役。
这四个动作和上面那三层是两回事,别混——三层说的是"这条记忆存在哪一层",四个动作说的是"这一轮整理该拿它怎么办"。论文把两者写在同一段里,代码把它们放在两个文件、两个类型里。
决定动作的那组数字,论文里没有
plan.ts 第 64 到 70 行:
const DEFAULT_THRESHOLDS: MemoryConsolidationPlanThresholds = {
preserveScore: 0.6,
preserveEvidence: 3,
decayScore: 0.55,
decayEvidence: 1,
competitionMargin: 0.12,
};
翻译一下:
参数 | 值 | 意思
preserveScore | 0.6 | 想被保留,分数得过 0.6
preserveEvidence | 3 | 而且得有 3 条证据
decayScore | 0.55 | 掉到 0.55 就进入衰减
decayEvidence | 1 | 衰减只需要 1 条证据
competitionMargin | 0.12 | 分差超过 0.12 才算竞争分出胜负
光看阈值容易看岔—我第一遍就看岔了。以为保留要 3 条证据、衰减只要 1 条,是"系统更愿意让东西退役"。
把判定逻辑读完,结论是反的。
plan.ts 第 145 到 196 行,一共六个分支:
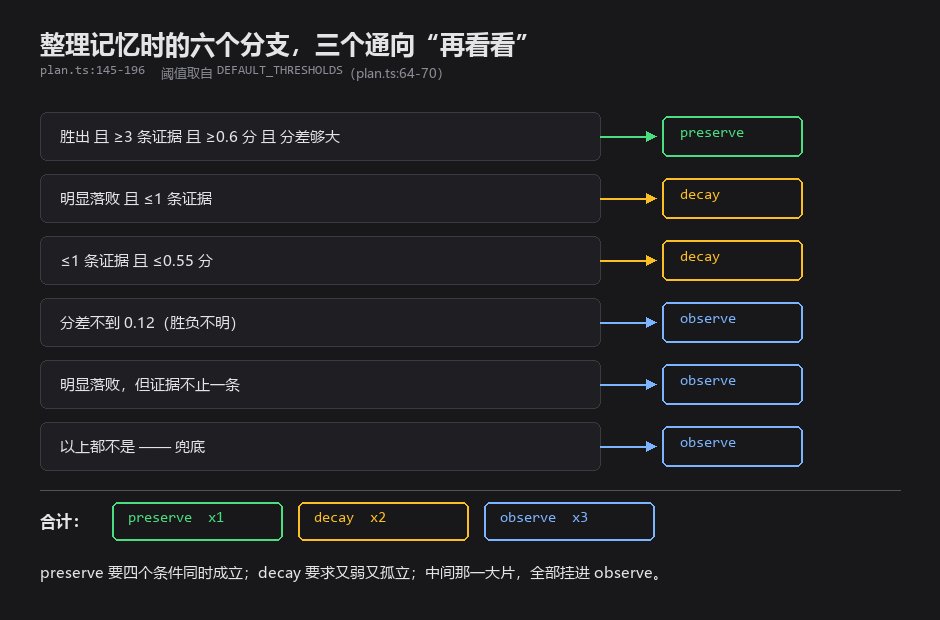
图 1|plan.ts 里六个分支各自的去向。这是我照着代码画的示意图,不是截图——条件、阈值、行号都印在图里,可以对着仓库自己核。
六个分支,三个落在 observe,包括最后那个兜底的。
preserve 要四个条件同时成立—是个高门槛。decay 要求"又弱又孤立"是个窄口子。中间那一大片,全部挂进"再看看"。
所以这套默认值真正的倾向不是保留、也不是退役,而是先不做决定。
对一个记忆系统来说,这是个挺明确的立场:既不囤积,也不过早遗忘,把拿不准的都挂着。
而这件事,论文里读不出来。论文告诉你有分层遗忘这个机制;代码告诉你它在犹豫的时候会怎么办,而真实系统里,大部分时候都是拿不准的时候。
退役之后去哪了
论文强调 evidence-preserving——退役的信念要归档、可审计。
代码里生命周期状态的定义(graph-contracts.ts):
export type MemoryClusterLifecycleStatus =
 "forming"    | "active"           | "stable"
 "decaying" | "superseded" | "audit-only";
最后那个 audit-only:已经不参与检索了,但还在,还能查。
论文说的"归档可审计",落地就是这个终态。对上了。
一个要提醒的地方
ebbinghaus 这个词,在整个代码库里出现 0 次。
论文说衰减是「Ebbinghaus 形状的重要性衰减」,代码里对应的是 decay(95 处)和 halfLife(7 处)。
这不是问题。学术论文用学术名,工程代码用工程名,本来就是两套词汇。但如果你拿着论文去代码里搜关键词,会一无所获—得知道该搜什么。
五、机制三:论文说的规矩,代码用类型钉死了
这一节是我最想写的。
四类边,一字不差
论文说关系有四种:support(支持)、compete(竞争)、related(相关)、supersede(取代)。
graph-contracts.ts 第 19 行:
graph-contracts.ts 第 19 行:
export type MemoryGraphRelationKind =
"support" | "compete" | "related" | "supersede";
四个,同名,连顺序都一样。
但这只是名词对上了。真正让我坐直的是下面这个。
「先竞争,后取代」这条规矩是被类型强制的
论文里有一段讲它怎么处理信念冲突。大意是:
当新信息和已有信念矛盾时,先建一条 compete 边(竞争关系),只有当新信念被证明证据更强之后,才关闭旧信念的有效区间,形成取代。
翻译成大白话:不许一上来就宣布旧的错了。得先并列摆着,等证据分出胜负,才允许替换。
这是个很克制的设计。问题是——代码里真的这么做了吗?
我去找负责判断关系的那段。LLM 读完两条记忆,要输出它们是什么关系。adapter.ts 第 319 行:
relation: "support" | "compete" | "related",三种。没有 supersede。
graph-evolution.ts 第 419 行,同一处约束再写了一遍:
const kind = judgment.relation as "support" | "compete" | "related";
那 supersede 边从哪来?在另一个文件里,graph-lifecycle.ts 第 451 行:
kind: "supersede",
生命周期阶段。
这件事为什么重要
论文提出一个原则,代码不是"大致遵守",而是把它编码进了类型系统。
模型判断那一步,根本拿不到 supersede 这个选项。不是靠提示词叮嘱它别乱用,不是靠事后检查兜底—是类型上就没有,想违反都违反不了。

图 2|同样是我照着代码画的示意图。三处引用的行号都标在图里,可以对着仓库自己核。
这才是"论文和实现对得上"的真正含义。
名词对得上,只能说明写论文的人和写代码的人用了同一份词汇表。约束对得上,才说明论文里那句设计原则是真的在管事。
然后是那个 PageRank
论文说 Hebbian 机制的工程对应物是「Personalized PageRank over co-activation graphs」。
代码里就是这个文件:
packages/insights/src/event-rank.ts
它的几个关键参数:
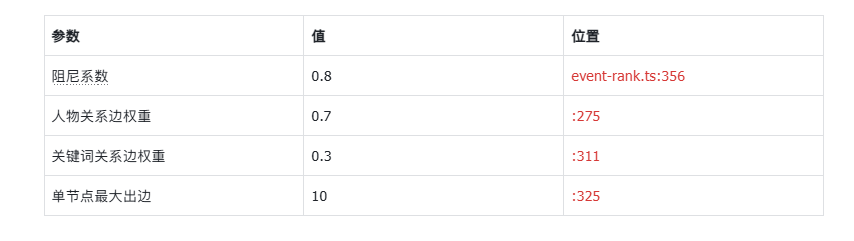
阻尼系数 0.8 意味着:一个节点的分数里,八成来自邻居传过来的,两成来自它自己。这是个偏向"关系"的配置——原始 PageRank 常用 0.85,思路一致。
人物边 0.7、关键词边 0.3,也就是说:「同一个人」这条线索的权重,是「同一个关键词」的两倍多。这是个产品判断,不是数学结论。
一条论文里没有的:超过 200 个节点,图就不跑了
event-rank.ts 第 368 到 381 行:

第 394 行,归零之后发生什么:
if (n > 200 || maxIterations === 0) {
// 直接返回基础分,eventRank: 0
节点超过 200,图传播整个跳过,直接返回基础分。
这不是 bug,是明摆着的性能取舍——注释里写得清清楚楚。迭代次数随规模递减:不到 50 个跑 20 轮,50 到 100 跑 10 轮,100 到 200 跑 5 轮,超过 200 一轮都不跑。
但这条信息,论文里一个字都没有。
论文讲的是机制在概念上怎么工作;代码讲的是它在什么规模下、按什么强度工作。两个都读,你才知道这套东西真实的样子。
如果你的场景里活跃记忆常年在几十条,那 Hebbian 关系学习是完整跑的。如果你打算喂给它几千条,那你拿到的就是基础分排序,图那部分是关着的。
这个边界只有读代码才知道。
六、核对下来的全貌
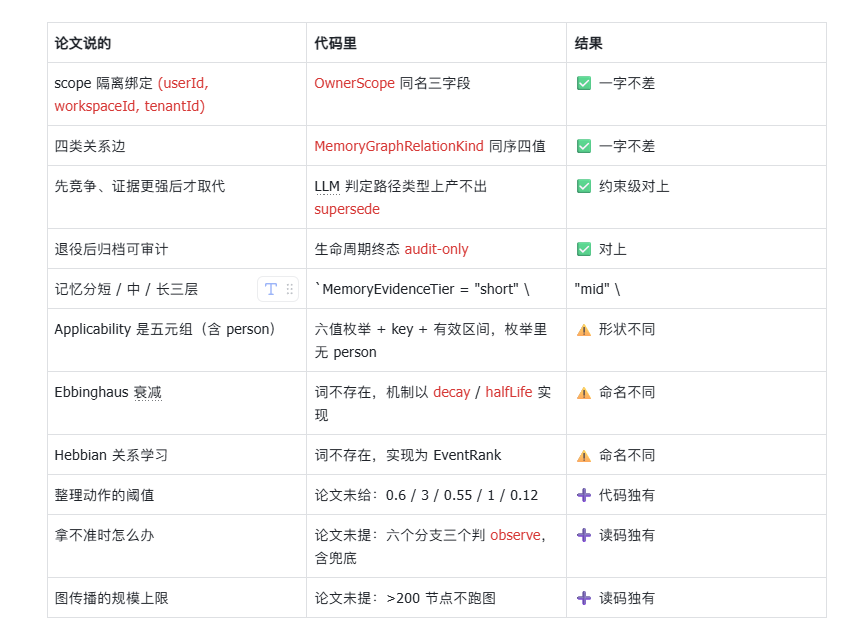
五个对上,三个是命名或形状差异,三个是论文里没有、只能从代码里拿到的。
三处 ⚠️ 里没有一处是"论文说了假话"。命名差异是学术圈和工程圈的常态;五元组那处是概念模型和落地结构的正常距离。
这张表本身就是这篇文章的结论:这份报告描述的东西,可以被外部独立核对到这个颗粒度。大部分技术报告做不到,不是因为不想,是因为代码不公开。
七、我核的这一层,是三层里的第一层
写到这儿要说清楚一件事:上面所有内容,都只是 Alloomi 技术路线的三分之一。
它的路线分三层,九个公开 benchmark,每层三个:
第一层:全域上下文(记得住)
长期记忆和全域上下文—也就是这篇文章从头核到尾的那一层。
基准 | Holistic Context | 对照
LongMemEval-S| 97.6% | 长上下文基线 43.8%、Mem0 V3 94.4%
LoCoMo | 97.4% | Mem0 66.88%、Mem0 V3 92.5%
BEAM 10M | 67.0% | Hindsight 64.1%
第二层:自进化(学得会)
从上下文和反馈里持续学到新东西,这一层在另一份报告《Self-Evolving Agent》里,跑的是 Self-Evolving Agent-mini(Qwen3.6-35B-A3B,35B 参数 / 3B 激活的 MoE)。
数字出自该报告的 Table 3:
▍CL-bench
测的是什么能力:从复杂上下文里学会新规则
对照:21.5(GPT-5.6 SOL)
SEA-mini:47.6%(+26.1,2.21 倍)
▍CL-bench Life
测的是什么能力:跨会话累积经验
对照:22.2(GPT-5.5 High)
SEA-mini:32.1%(+9.9,相对 +44.6%)
▍Cont.L.Bench
测的是什么能力:跨任务迁移、抵抗遗忘
对照:22.3(Claude Sonnet 4.6)
SEA-mini:32.6%(+10.3,相对 +46.2%)
这张表自己带了一条提醒,我照抄过来:这六行「不是严格的同类比较」每一行走的是各自榜单的协议。它还明说,真正代表框架贡献的是同骨干那组对照,不是榜单排名。
又是同一种克制。跟第一节里 Holistic Context 那句「应当被读作可行性演示」是一个路数,把自己数字的适用边界写在数字旁边。
第三层:专业交付(做得成)
学到的东西能不能变成真实交付。
▍SWE-Bench-CL
测的是什么能力:多文件软件工程(273 个任务的时序序列)
对照:73.3(OpenCode + Kimi-K3 + FAISS)
SEA-mini:80.6%(+7.3)
▍GDPval
测的是什么能力:44 种职业的真实经济价值任务
对照:67.3(Claude Opus 5,榜单第一)
SEA-mini:74.2%(+6.9)
▍JobBench†
测的是什么能力:真实专业工作流交付
对照:54.7(Kimi-K3)
SEA-mini:57.5%
这三行,论文给每一行都挂了一个"别这么读"的标签。我一条条搬过来:
· JobBench 那个 †:它用的评审跟官方 JobBench 榜单不同,脚注写明「这个符号是给读者的信号,说明该行不是同类比较」。
· SWE-Bench-CL:作为对照的五行 OpenCode 基线,跟 SEA-mini 同时差着两件事,骨干模型不同,而且没有那套飞轮。真正能把框架贡献单独摘出来的同骨干实验,被论文自己列进了"待办"。它还主动补了一句:+7.3 是对 Kimi-K3 的,要是对最强的那行(Qwen3.8-max,76.4%),只领先 4.2 个点。
· GDPval:两边压根不是一套计分,74.2% 是 OpenAI / Anthropic / Scale 的官方加权评分,67.3% 是榜单快照的归一化百分比。表格标题里直接写着 "different scoring, not directly comparable"。
顺带说一件我注意到的事
从第一节到这里,同一种做法出现了四次:
出处 | 它自己写的限定
Holistic Context 摘要| 表头数字「应当被读作可行性演示」
SEA Table 3 | 这六行「不是严格的同类比较」
SWE-Bench-CL | 隔离框架贡献的那个实验「是待办」,且主动给出更保守的 +4.2
GDPval | 「不同计分方式,不可直接比较」
每给一个数,旁边就标一次这个数不能拿去干什么。
这在技术宣传材料里不常见,我核不了那些分数,但我能看出报数字的人有没有在藏东西,这四处说明它没有。
三层串起来是一个闭环
真实任务轨迹 → 质量筛选 → 专家锚定 → 后训练 → 评测准入 → 版本回滚。
一句话:让 AI 每完成一次交付,就获得一次成长。
但有件事我必须说明
这三层里,我只核验了第一层。
不是我偷懒,是只有第一层有开源实现可查,上下文这一层,机制写在论文里、代码摆在 GitHub 上,我能一行一行对;后两层是模型后训练,没有对应的开源代码,我能做的只有转述它报告里的数字和它自己标的限定。
所以请这样读这篇文章:第一层的判断,是我核过的;后两层的数字,是它自己公布的,我只是把它们和边界一起搬了过来。
八、你想自己核对的话
代码在 github.com/melandlabs/opencontext,Apache 2.0。我跑通的路径:
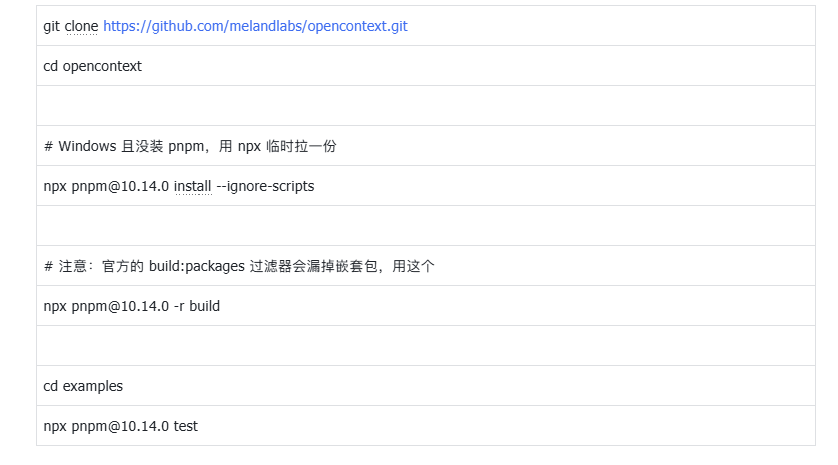
两个坑先说在前面,都是我撞过的:
跑通之后 pnpm test 会出 97 项通过、3 项跳过、0 项失败,和 README 写的一致。
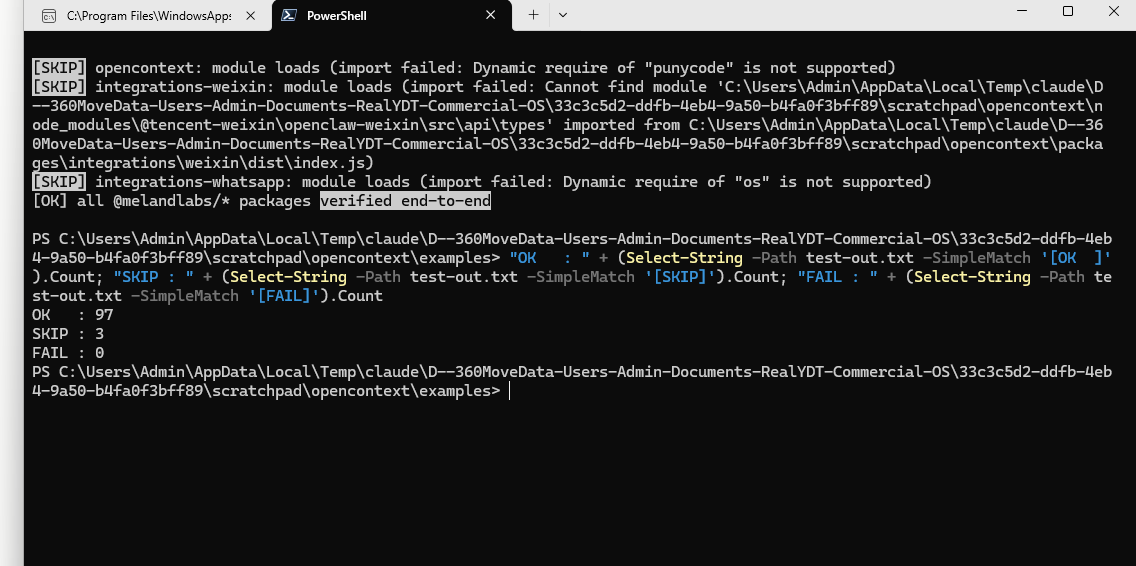
图 3|examples 的检查结果,与 README 承诺的 97/3/0 逐字一致。这张是终端截图,不是示意图。
本文引用的所有文件都在 packages/ai/memory-consolidation/src/ 和 packages/insights/src/ 下,行号基于 commit 63a5f63。
九、最后
再说一遍开头那句,因为它决定这篇能算什么:
我核的是机制在不在代码里,不是 benchmark 数字对不对。
97.6% 我没复现。这篇文章不能用来证明那个数字成立,也不能用来证明它不成立。它只能证明一件事:论文描述的那套机制,确实有一份可以打开来读的实现。
对一份技术报告来说,这已经比大多数同类多了一层。
如果你真的复现了那三个基准,无论结果是什么,欢迎发出来打我的脸,我这篇能验的部分只到代码为止。
论文和代码:
在代码生成场景,Cursor或Devin这类工具通过会话历史和规则文件已能部分记住项目偏好,但跨项目迁移仍弱。真正的经验复利可能需要比当前post-training更细粒度的持续对齐。