#統計 Fisher検定は1通りではない。...

黒木玄 Gen Kuroki@genkuroki
76 views
Sep 06, 2025
~1 min read
Advertisement
1
#統計 Fisher検定は1通りではない。
Rのfisher.testのP値はexact2x2::exact2x2関数でのtsmethod="minlike"と同じ。
Yates補正が非常によく近似しているのは、exact2x2::exact2x2でのtsmethod="central"の側です。これは片側確率の2倍をP値とする方法で非常に保守的です。
関連情報の紹介に続く

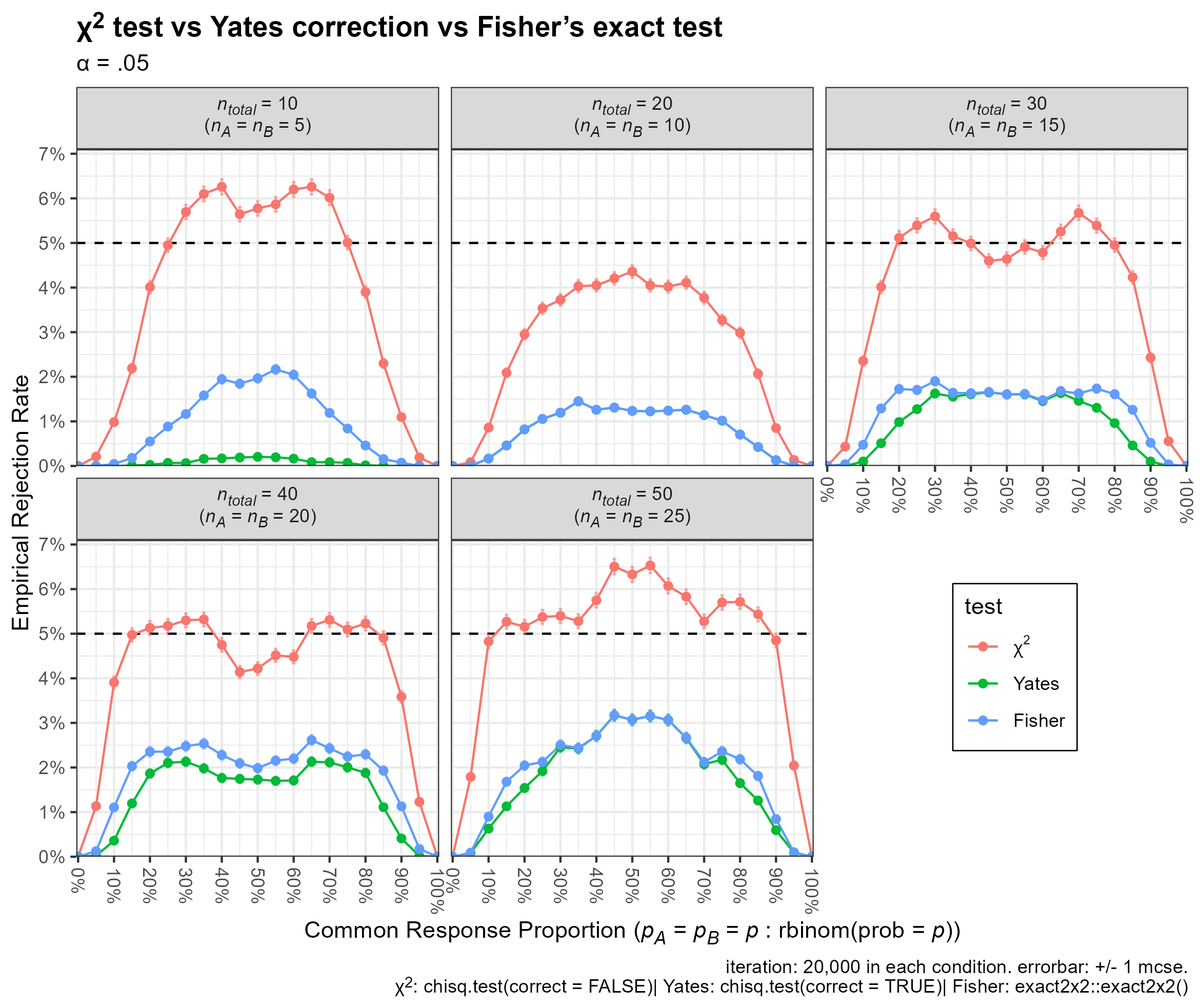
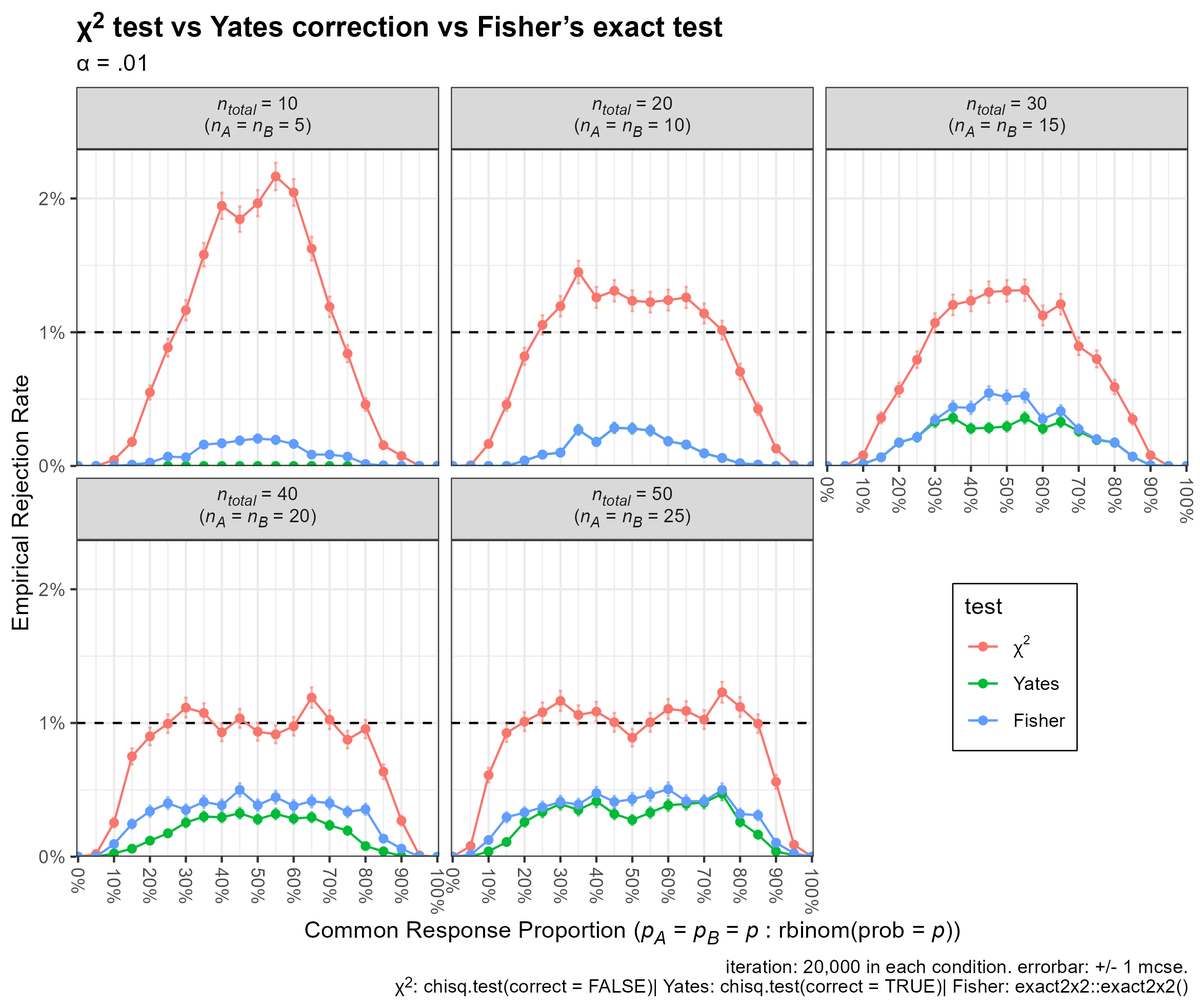
Rのfisher.testのP値はexact2x2::exact2x2関数でのtsmethod="minlike"と同じ。
Yates補正が非常によく近似しているのは、exact2x2::exact2x2でのtsmethod="central"の側です。これは片側確率の2倍をP値とする方法で非常に保守的です。
関連情報の紹介に続く
Takuto SAKAI@tsakai_psych
カイ2乗検定でYates補正とかFisherの直接法が俎上に上がるのはnが少ないときだから、もっとnを少なくしたときもシミュレーション回してみた
指摘されてるようにYatesはかなり保守的
なんならFisherよりも厳しい
指摘されてるようにYatesはかなり保守的
なんならFisherよりも厳しい
2
#統計 Rのexact2x2::exact2x2を使っている様子

黒木玄 Gen Kuroki@genkuroki
#統計 Rのexact2x2ではplot=Tとして使うとP値函数もプロットしてくれる点がfisher.testよりも優れています。さらに、exact2x2ならfisher.testと違って、表示されるP値と信頼区間が整合的です。
fisher.testよりexact2x2::exact2x2の方が優れていると思います。
github.com/genkuroki/publ…
fisher.testよりexact2x2::exact2x2の方が優れていると思います。
github.com/genkuroki/publ…
3
#統計 Rのfisher.testのP値と信頼区間の間には整合性がない。

黒木玄 Gen Kuroki@genkuroki
#統計 Rにおいて、
fisher.test が表示するP値と信頼区間には整合性がない。
P値 < 5% なのに、95%信頼区間が1を含む!😱
exact2x2はfisher.testのP値と整合的な信頼区間を表示してくれる。
github.com/genkuroki/publ…
fisher.test が表示するP値と信頼区間には整合性がない。
P値 < 5% なのに、95%信頼区間が1を含む!😱
exact2x2はfisher.testのP値と整合的な信頼区間を表示してくれる。
github.com/genkuroki/publ…
4
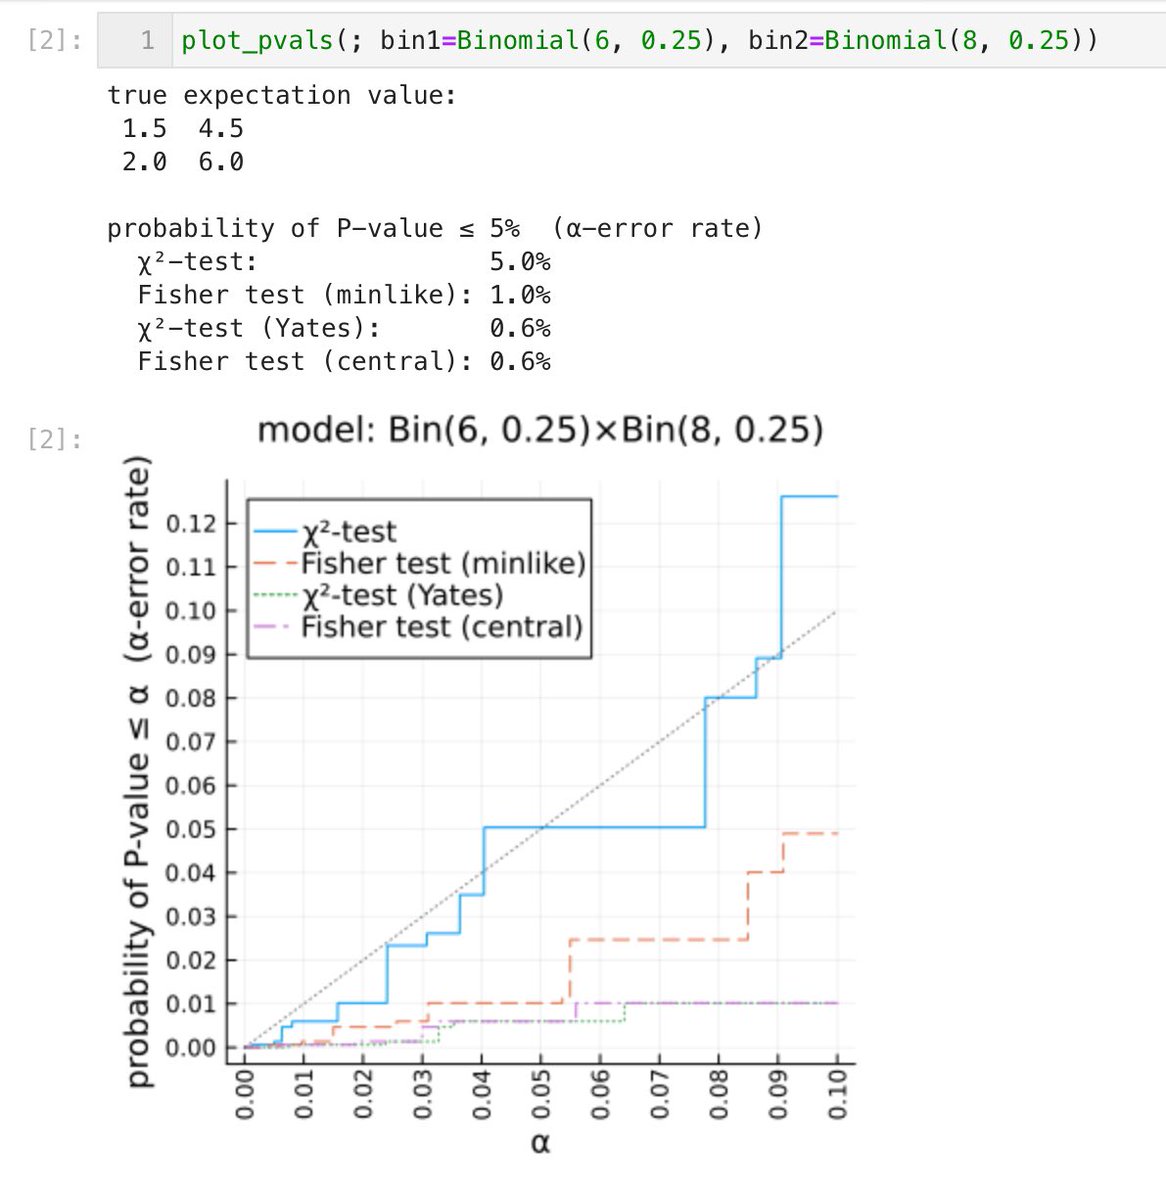
#統計 Fisher検定(minlike, central)、Pearsonのχ²検定(無補正、Yates)の4通りについて、P値がα以下になる確率を求めるシミュレーションの紹介
↓
↓
黒木玄 Gen Kuroki@genkuroki
#統計 添付画像は、(a,c)をBin(6,0.25)×Bin(8,0.25)に従う乱数とし、b=6-a, d=8-cとして、分割表のデータ
a b
c d
をランダムに生成したときの、P値≤αとなる確率のグラフです。このとき分割表の期待値は
1.5 4.5
2.0 6.0
で5未満の値が3つもある。続く
github.com/genkuroki/publ…
a b
c d
をランダムに生成したときの、P値≤αとなる確率のグラフです。このとき分割表の期待値は
1.5 4.5
2.0 6.0
で5未満の値が3つもある。続く
github.com/genkuroki/publ…
5
#統計 よく見るFisher検定やPearsonのχ²検定の実装の致命的な欠点は、差がないことを意味するゼロ仮説(オッズ比=1)のP値しか計算してくれないことです。
ゼロ仮説以外の任意の数値ω>0に関するオッズ比=ωという仮説などのP値も計算してくれるべき。他にもRRやRDについても。

ゼロ仮説以外の任意の数値ω>0に関するオッズ比=ωという仮説などのP値も計算してくれるべき。他にもRRやRDについても。
黒木玄 Gen Kuroki@genkuroki
#統計 データの数値
1 24
5 15
のP値関数のグラフ。横軸はオッズ比。
スコア法(Pearsonのχ²検定の拡張)
Fisher検定(minlike、Rのfisher.test)の拡張
スコア法の連続性補正
Fisher検定(central、片側確率の2倍)の拡張
の4種のP値関数をプロット。
github.com/genkuroki/publ…
1 24
5 15
のP値関数のグラフ。横軸はオッズ比。
スコア法(Pearsonのχ²検定の拡張)
Fisher検定(minlike、Rのfisher.test)の拡張
スコア法の連続性補正
Fisher検定(central、片側確率の2倍)の拡張
の4種のP値関数をプロット。
github.com/genkuroki/publ…
6
#統計 関連
黒木玄 Gen Kuroki@genkuroki
#統計 2つの母比率p,qの違いの程度を測るためのパラメータとして、
オッズ比 OR=(p/(1-p))/(q/(1-q))
が常に適切とは限らず、
リスク比 RR=p/q
や
リスク差 RD=p-q
を使いたい場合にはFisher検定の方法を使えません。他の方法を使う必要があります。これは実践的には結構重要なポイント。
オッズ比 OR=(p/(1-p))/(q/(1-q))
が常に適切とは限らず、
リスク比 RR=p/q
や
リスク差 RD=p-q
を使いたい場合にはFisher検定の方法を使えません。他の方法を使う必要があります。これは実践的には結構重要なポイント。
7
8
#統計 関連
黒木玄 Gen Kuroki@genkuroki
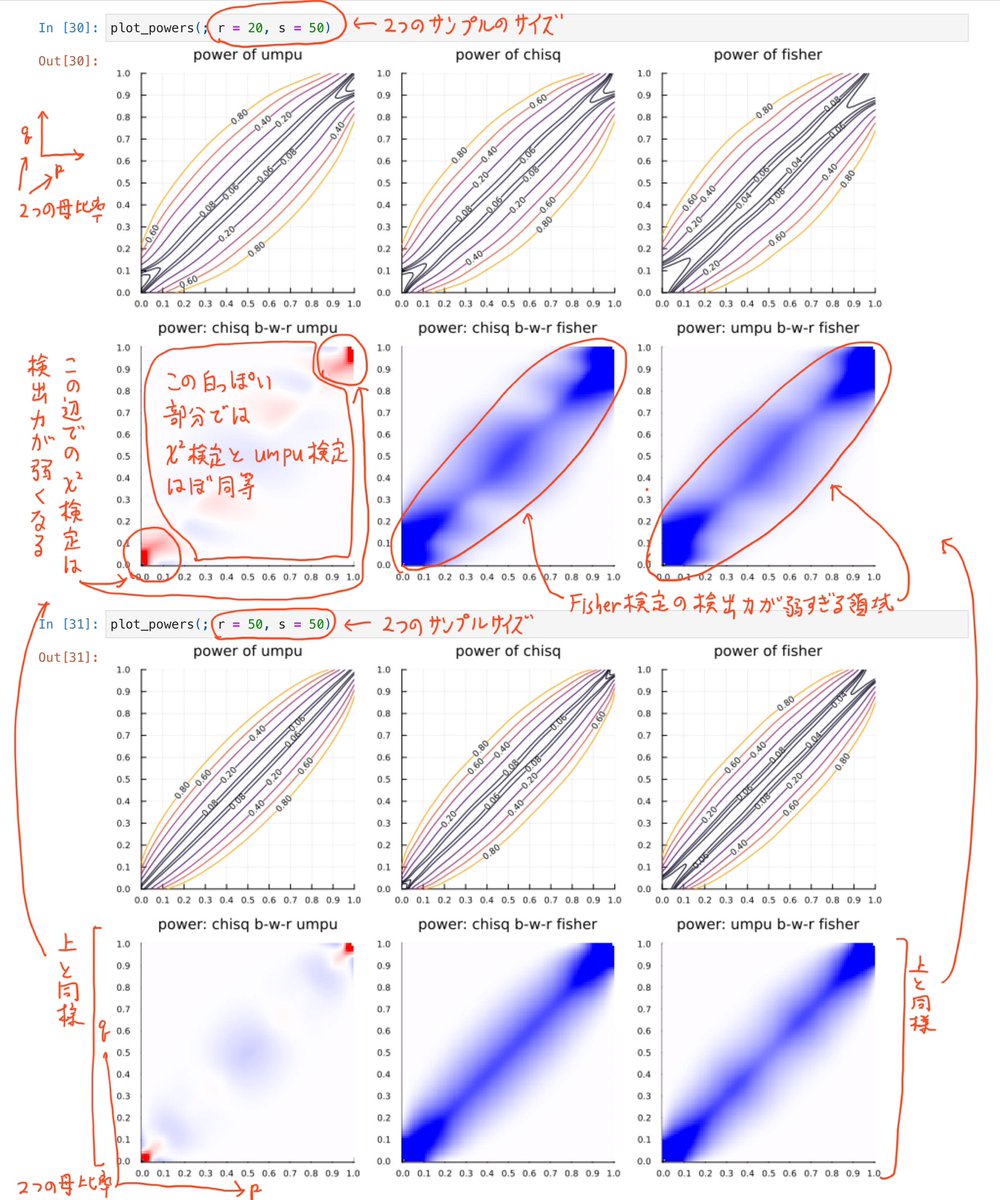
#統計 統計モデルはBinomial(r, p)×Binomial(s, q)
帰無仮説p=q、対立仮説p≠qの有意水準5%の仮説検定の検出力のグラフ。
比較のグラフで白っぽい領域では2つの検定法の検出力はほぼ一致している。そうでない領域では一致していない。
umpu検定に近い検定ほど良い検定とみなせる。
帰無仮説p=q、対立仮説p≠qの有意水準5%の仮説検定の検出力のグラフ。
比較のグラフで白っぽい領域では2つの検定法の検出力はほぼ一致している。そうでない領域では一致していない。
umpu検定に近い検定ほど良い検定とみなせる。
9
#統計 分割表の独立性(差がないというゼロ仮説の1つ)に関するFisher検定もPearsonのχ²検定もどちらも「P値が5%未満ならば有意差があるとみなす」というスタイルで使われる悪名高い帰無仮説有意性検定(NHST)であることに注意が必要です。
P値は以下のリンク先のように使う必要があります。
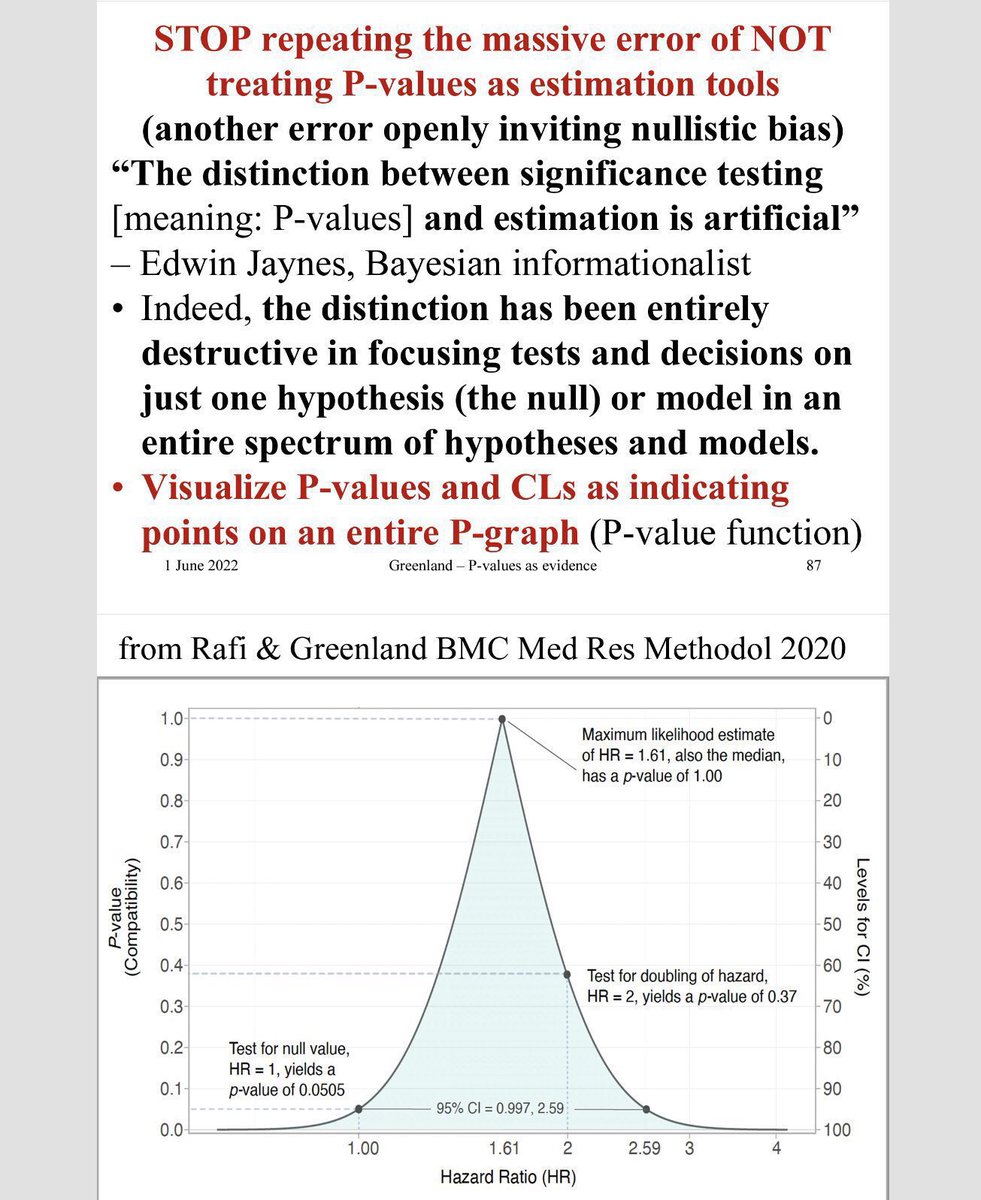
P値は以下のリンク先のように使う必要があります。
黒木玄 Gen Kuroki@genkuroki
#統計 検定仮説θ=cのP値は、特定の統計モデルの下でのデータの数値と仮説θ=cの相性の良さ(compatibility)の指標で、信頼区間は閾値α以上にデータの数値との相性が良いθの値cの範囲であり、点推定値はデータの数値との最も相性が良いθの値と定義できる。
Greenlandさんの説明
biostatistics.ucdavis.edu/sites/g/files/…
Greenlandさんの説明
biostatistics.ucdavis.edu/sites/g/files/…
10
#統計 NHSTとしてのFisher検定やPearsonのχ²検定はミスリーディングなので、以下のようにする必要があります。
* ゼロ仮説以外の仮説のP値も計算するように拡張する。
* P値を有意か否かの二分法のために用いずに、データの値とモデル+仮説の相性の良さ(compatibility)の連続的指標として利用する。
* ゼロ仮説以外の仮説のP値も計算するように拡張する。
* P値を有意か否かの二分法のために用いずに、データの値とモデル+仮説の相性の良さ(compatibility)の連続的指標として利用する。
黒木玄 Gen Kuroki@genkuroki
#統計 ゼロ仮説以外のP値も計算するようにし、P値を、二分法のための道具ではなく、モデル+仮説とデータの値の相性の良さの指標の1つとして使い、S=-log₂(P値)とおいて、「モデル+仮説の立場から見ると、コイン投げでS回続けて表が出たのと同じ程度に意外なデータの値が得られた」と解釈すれば良い。
11
#統計 個人的には、ゼロ仮説以外の仮説のP値も計算するような拡張は必須だと思うのですが、そのような統計ソフトをすぐに使えない場合には、信頼区間を相性区間(compatibility interval)として使うことで代用するという選択肢があります。


黒木玄 Gen Kuroki@genkuroki
#統計 次の論文の機械翻訳
相性の良さ(compatibility)の尺度としてのP値と信頼区間
thelancet.com/journals/lanse…
p-Values and confidence intervals as compatibility measures: guidelines for interpreting statistical studies in clinical research - The Lancet Regional Health - Southeast Asia
相性の良さ(compatibility)の尺度としてのP値と信頼区間
thelancet.com/journals/lanse…
p-Values and confidence intervals as compatibility measures: guidelines for interpreting statistical studies in clinical research - The Lancet Regional Health - Southeast Asia
12
#統計 100(1-α)%信頼区間=100(1-α)%相性区間の定義は「データの値との相性を意味するP値がα以上になるモデルのパラメータの値の範囲」なので、すべての閾値αについて相性区間(compatibility interval)を考えれば、ゼロ仮説以外のすべての仮説のP値を考えたのと同等になります。
13
#統計 信頼区間=相性区間(compatibility interval)を計算するときのカットオフを5%に固定して、「区間が帰無値をまたがないか否か」で「有意か否か」を決定して利用することは、またしても有害な帰無仮説有意性検定(NHST)の使用と同等になるので避けるべきです。
14
#統計 Fisher検定とPearsonのχ²検定のどちらを使うかよりも以上に述べたようなP値を誤用しないようにすることの方が圧倒的に重要。
* ゼロ仮説以外の仮説のP値も計算できなければいけない。(任意のカットオフで信頼区間=相性区間を計算できなければいけない。)
* P値による安易な二分法を避ける。
* ゼロ仮説以外の仮説のP値も計算できなければいけない。(任意のカットオフで信頼区間=相性区間を計算できなければいけない。)
* P値による安易な二分法を避ける。
15
#統計 P値や信頼区間=信用区間(compatibility interval)の計算法としてFisher検定とPearsonのχ²検定のどちらを使うかはP値に要請したい条件によって決めれば良い。
どちらにも一長一短があり、片方が一方的にもう一方よりも優れているわけではない。Fisher検定もcentralとminlikeの2種類以上がある。
どちらにも一長一短があり、片方が一方的にもう一方よりも優れているわけではない。Fisher検定もcentralとminlikeの2種類以上がある。
16
#統計 P値に要請する標準的な条件には次の2つがあります。
(近似的一様分布性) モデル+仮説の確率分布で生成されたデータについて、P値<αとなる確率はαで近似される。
(厳密な保守性) モデル+仮説の確率分布で生成されたデータについて、P値<αとなる確率は常にα以下になる。
(近似的一様分布性) モデル+仮説の確率分布で生成されたデータについて、P値<αとなる確率はαで近似される。
(厳密な保守性) モデル+仮説の確率分布で生成されたデータについて、P値<αとなる確率は常にα以下になる。
17
#統計 厳密な保守性を要求したい場合にはFisher検定を採用するべきです。その代わりに検出力がかなり低下し、信頼区間=相性区間も広くなります。
近似的一様分布性を要求したい場合には補正無しのPearsonのχ²検定の方が優れています。その代わりに厳密な保守性は成立しなくなります。
近似的一様分布性を要求したい場合には補正無しのPearsonのχ²検定の方が優れています。その代わりに厳密な保守性は成立しなくなります。
18
#統計 両側Fisher検定には少なくとも次の2種類があります。
* P値を片側確率の2倍で計算するcentral法
* P値をモデル内においてデータ以下の確率で生じる場合の確率の総和で計算するminlike法
Rのfisher.testはcenteal法で信頼区間を計算し、minlike法でP値を計算しています。整合性がない!

* P値を片側確率の2倍で計算するcentral法
* P値をモデル内においてデータ以下の確率で生じる場合の確率の総和で計算するminlike法
Rのfisher.testはcenteal法で信頼区間を計算し、minlike法でP値を計算しています。整合性がない!
黒木玄 Gen Kuroki@genkuroki
#統計 Rにおいて、
fisher.test が表示するP値と信頼区間には整合性がない。
P値 < 5% なのに、95%信頼区間が1を含む!😱
exact2x2でtsmethod="central"を使うと、fisher.testの信頼区間と整合的なP値を表示してくれる。
github.com/genkuroki/publ…
fisher.test が表示するP値と信頼区間には整合性がない。
P値 < 5% なのに、95%信頼区間が1を含む!😱
exact2x2でtsmethod="central"を使うと、fisher.testの信頼区間と整合的なP値を表示してくれる。
github.com/genkuroki/publ…
19
#統計 有意水準5%の両側検定を、正の効果があるかに関する有意水準2.5%の片側検定として使いたいならば、P値を片側確率の2倍で計算するcenteal法を使うべきなのですが、Rのfisher.testが表示するP値はminlike法での値になっています。
20
#統計 Yates補正されたPearsonのχ²検定のP値は、central法の(片側確率の2倍版の)Fisher検定のP値に良い近似になっています。(Yates補正はRのfisher.testのminlike法によるP値の良い近似にはなっていない。)
だから、Yates補正版χ²検定を使うくらいなら、centeal版Fisher検定を使うべきです。
だから、Yates補正版χ²検定を使うくらいなら、centeal版Fisher検定を使うべきです。
21
#統計 以上のように、分割表に所謂コクランルールはまともな根拠がありません。
現時点においてもコクランルールを他人に強制しようとしている人達はきちんと反省する必要があります。
(((残念ながら反省するつもりがない人達が実に多い)))
現時点においてもコクランルールを他人に強制しようとしている人達はきちんと反省する必要があります。
(((残念ながら反省するつもりがない人達が実に多い)))
22
#統計 分割表での検定法の選択では以下のような合理的な規準を採用するべき。
* P値に関する「厳密な保守性」と「近似的一様分布性」のどちらを優先するか
* 片側検定との整合性は必要か
* 1つの方法が他よりすべての面で優れているとは言えず、トレードオフの関係になっていることを理解しているか
* P値に関する「厳密な保守性」と「近似的一様分布性」のどちらを優先するか
* 片側検定との整合性は必要か
* 1つの方法が他よりすべての面で優れているとは言えず、トレードオフの関係になっていることを理解しているか
黒木玄 Gen Kuroki@genkuroki
#統計 P値に要請する標準的な条件には次の2つがあります。
(近似的一様分布性) モデル+仮説の確率分布で生成されたデータについて、P値<αとなる確率はαで近似される。
(厳密な保守性) モデル+仮説の確率分布で生成されたデータについて、P値<αとなる確率は常にα以下になる。
(近似的一様分布性) モデル+仮説の確率分布で生成されたデータについて、P値<αとなる確率はαで近似される。
(厳密な保守性) モデル+仮説の確率分布で生成されたデータについて、P値<αとなる確率は常にα以下になる。
23
#統計 そして、それ以前の問題として、様々な理由で有害であることがわかっている帰無仮説有意性検定(NHST)のためにP値を使おうとしているならば、Fisher検定とPearsonのχ²検定のどちらを使っても科学的にまともな統計学の使い方をできていないことを自覚するべき。
代替案
↓
代替案
↓
黒木玄 Gen Kuroki@genkuroki
#統計 NHSTとしてのFisher検定やPearsonのχ²検定はミスリーディングなので、以下のようにする必要があります。
* ゼロ仮説以外の仮説のP値も計算するように拡張する。
* P値を有意か否かの二分法のために用いずに、データの値とモデル+仮説の相性の良さ(compatibility)の連続的指標として利用する。
* ゼロ仮説以外の仮説のP値も計算するように拡張する。
* P値を有意か否かの二分法のために用いずに、データの値とモデル+仮説の相性の良さ(compatibility)の連続的指標として利用する。
24
#統計 Fisher検定やPearsonのχ²検定を「ゼロ仮説以外の仮説のP値も計算するように拡張する」ことをできない人達は、「任意の信頼水準でのオッズ比、リスク比、リスク差の信頼区間」で代用できる。
信頼区間なら多くの統計ソフトで実装されている。(しかし、困ったことにP値と整合性がない場合がある)
信頼区間なら多くの統計ソフトで実装されている。(しかし、困ったことにP値と整合性がない場合がある)
黒木玄 Gen Kuroki@genkuroki
#統計 NHSTとしてのFisher検定やPearsonのχ²検定はミスリーディングなので、以下のようにする必要があります。
* ゼロ仮説以外の仮説のP値も計算するように拡張する。
* P値を有意か否かの二分法のために用いずに、データの値とモデル+仮説の相性の良さ(compatibility)の連続的指標として利用する。
* ゼロ仮説以外の仮説のP値も計算するように拡張する。
* P値を有意か否かの二分法のために用いずに、データの値とモデル+仮説の相性の良さ(compatibility)の連続的指標として利用する。
25
#統計 関連