"java es casi tan rápido como c" "javascript es casi tan rápido...

Diario de un picateclas@devruso
13 views
Jul 27, 2025
~18 min read
Advertisement
1
"java es casi tan rápido como c"
"javascript es casi tan rápido como c"
"XYZ es casi tan rápido como c"
Juro por el "C The Programming Language" de K&R (2ª edición) que como lea UNA SOLA VEZ mas algo similar, va a haber sangre, dolor y oscuridad.
DENTRO HILO 🧵
"javascript es casi tan rápido como c"
"XYZ es casi tan rápido como c"
Juro por el "C The Programming Language" de K&R (2ª edición) que como lea UNA SOLA VEZ mas algo similar, va a haber sangre, dolor y oscuridad.
DENTRO HILO 🧵
2
(1/x) Seguro que más de una vez has leído afirmaciones que comparan la velocidad de X o Y lenguaje interpretado con la velocidad de Z lenguaje compilado. Y normalmente esas afirmaciones vienen en pack con palabras como "JIT", "AOT", "VM", "SIMD", "POPO / PIPI" y demás. Y a lo mejor te las crees. A lo mejor, como yo, te pones a invocar a Lucifer para que acabe con media humanidad. Si eres de los primeros, no te preocupes, que aquí estoy para verterte en esa cabezabuque que tienes los conocimientos comprimidos de 2 años de carrera en 40 tuits ;) (dibujos incluidos)
3
(2/x) Para que este hilo sea digerible por todos los públicos, incluidos los frontenders (porque HARTO me tienen con el "js es casi tan rápido como c", a ver si leyendo este hilo dejan de decir la chorradita...), voy a empezar desde lo más básico. También voy a intentar simplificar algunos conceptos, aunque eso suponga no ser técnicamente 100% correcto. No vengas con el "ACKCHYUALLY" que te monto en el primer tren a Siberia, billete de solo ida.
4
(3/x) Que $DEITY me ayude con este hilo porque estoy a punto de explicar fisica cuantica a mil babuinos.
5
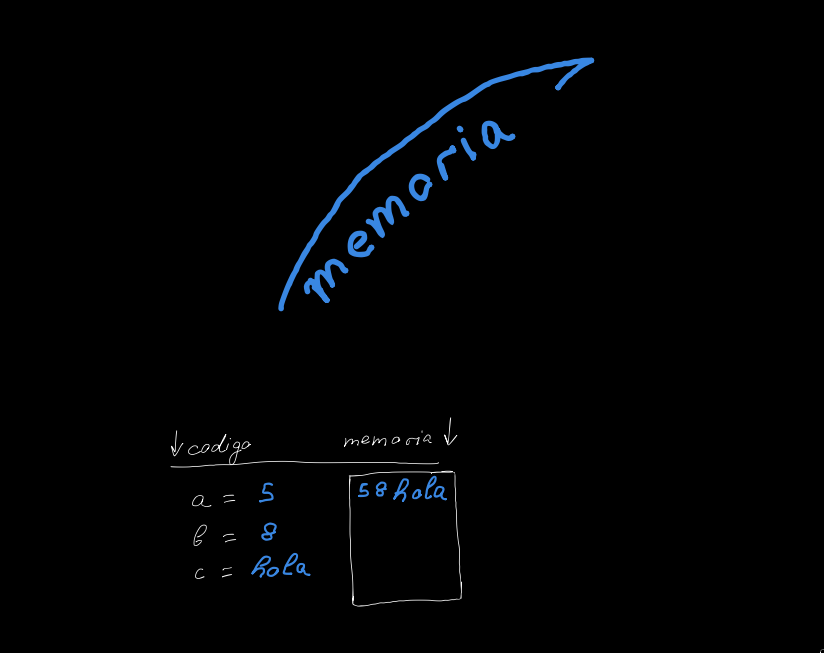
(4/x) Vamos a empezar con pseudocódigo y un lienzo en blanco al que llamaremos "memoria".
Si definimos "variables" en ese pseudocódigo, se van a guardar en la "memoria".
Si definimos "variables" en ese pseudocódigo, se van a guardar en la "memoria".
6
(5/x) Digamos que queremos operar con esas variables.
"a+b" es simple. Operación matemática. "13" como resultado. No tiene mas.
¿Pero y "b+c"? ¿Que debería ocurrir ahí? ¿"8hola"? ¿Error? Si de algo podemos estar orgullosos los informaticos es de tener un campo donde todo es deterministJHAHJAJHAHJAHJAHJAHJA. Cada lenguaje de programación al que preguntemos nos va a dar una respuesta distinta. Pero vamos a ver el "por que" en detalle:
"a+b" es simple. Operación matemática. "13" como resultado. No tiene mas.
¿Pero y "b+c"? ¿Que debería ocurrir ahí? ¿"8hola"? ¿Error? Si de algo podemos estar orgullosos los informaticos es de tener un campo donde todo es deterministJHAHJAJHAHJAHJAHJAHJA. Cada lenguaje de programación al que preguntemos nos va a dar una respuesta distinta. Pero vamos a ver el "por que" en detalle:
7
(6/x) Vamos a dividir el problema en 2 partes: "instrucciones" y "memoria".
"instrucciones" es lo que ejecuta el propio procesador. (véase "CPU")
"memoria" es el almacén que guarda los valores de las variables con las que operamos en nuestro código. (véase "RAM")
(para los avanzados: ni de coña voy a entrar en heap vs stack. os aguantáis)
"instrucciones" es lo que ejecuta el propio procesador. (véase "CPU")
"memoria" es el almacén que guarda los valores de las variables con las que operamos en nuestro código. (véase "RAM")
(para los avanzados: ni de coña voy a entrar en heap vs stack. os aguantáis)
8
(7/x) Vamos con la memoria.
9
(8/x) Como ya sabemos (porque lo sabemos, ¿no? 😒), en la memoria se pueden guardar solo 1s y 0s.
Ej, 1 byte tiene 8 bits; 8 "huecos" donde podemos poner "1" o "0".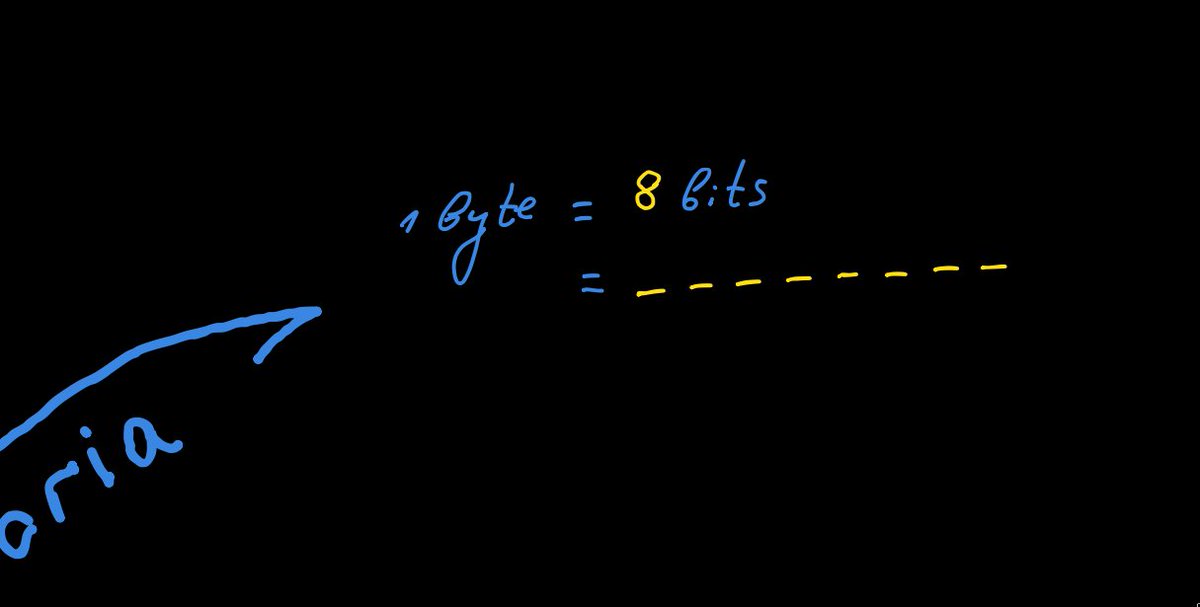
Ej, 1 byte tiene 8 bits; 8 "huecos" donde podemos poner "1" o "0".
10
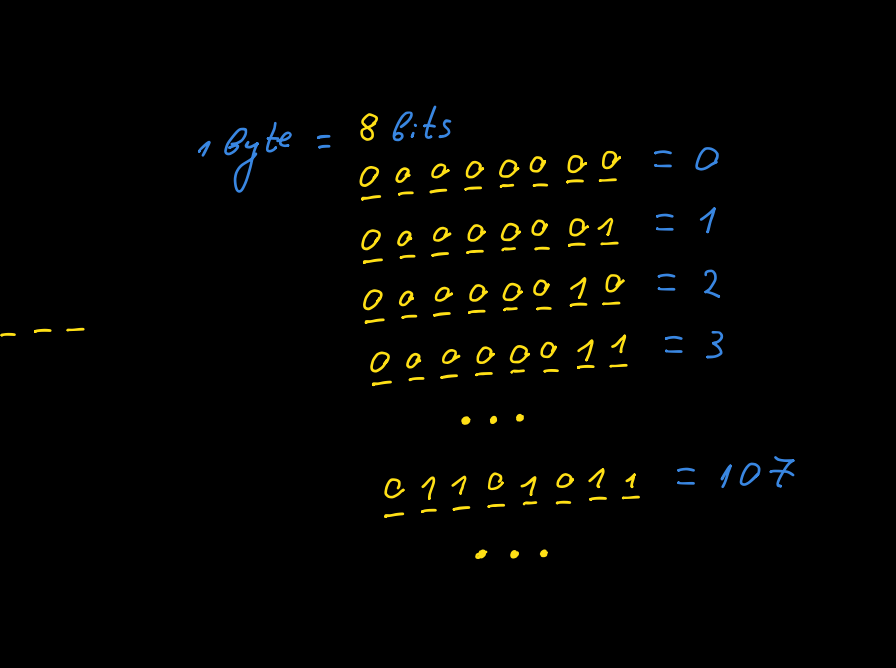
(9/x) El funcionamiento se asemeja al odómetro de los coches. Empieza en "00000000" y se va incrementando con 1 por la derecha (excepto que los digitos no llegan hasta el "9", sino hasta el "1").
11
(10/x) Y los que estáis siguiendo el tren de razonamiento diréis "11111111 es 255, ¿como represento 256?"
Pues añadimos más memoria.
(para los avanzados: no voy a entrar en signed y unsigned porque sino no acabo nunca. no, tampoco voy a entrar en "underflow" y "overflow". que no, copón, no voy a entrar en la esquizofrenia del tamaño de los números dependiendo del compilador, el OS y la fase lunar. os aguantáis)
Pues añadimos más memoria.
(para los avanzados: no voy a entrar en signed y unsigned porque sino no acabo nunca. no, tampoco voy a entrar en "underflow" y "overflow". que no, copón, no voy a entrar en la esquizofrenia del tamaño de los números dependiendo del compilador, el OS y la fase lunar. os aguantáis)
12
(11/x) Vamos a saltar un momento a la parte de "instrucciones".

13
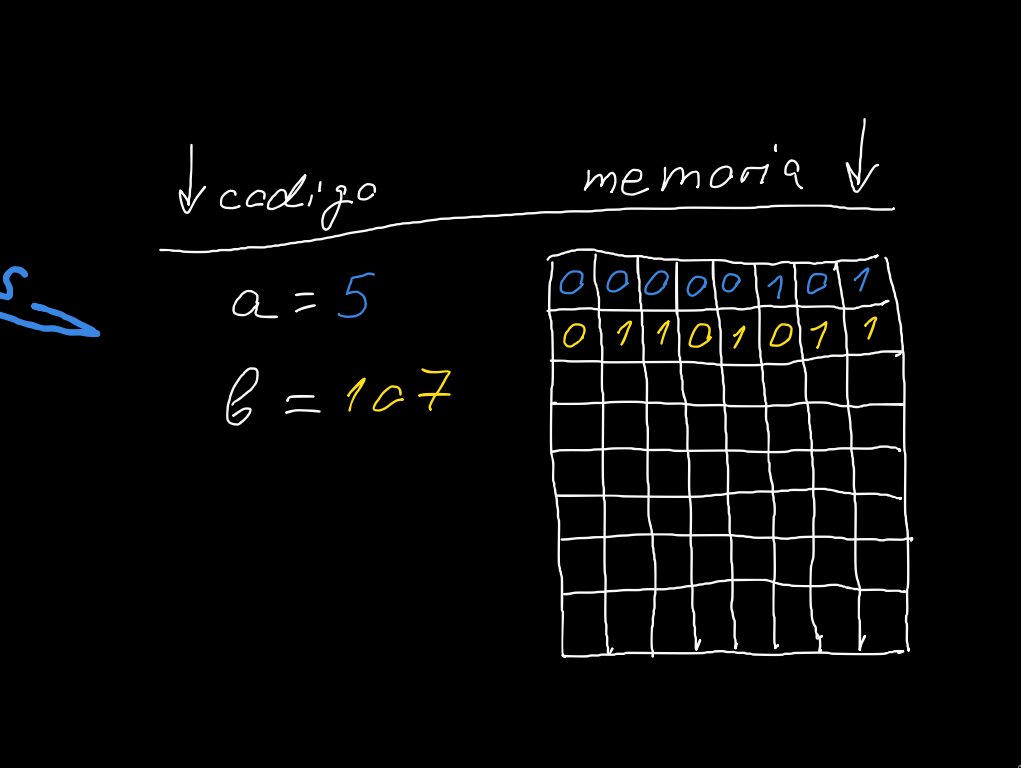
(12/x) Cuando definimos ("definir", quedaros con esta palabra) una variable, lo que ocurre es que le pedimos al sistema operativo que nos de un cachito de memoria en la que guardar ese valor:
14
(13/x) Saltamos de nuevo al apartado de "memoria". Nivel de dificultad 2.
Ya hemos visto como definir variables que apuntan a números, pero ¿y si queremos definir variables con textos?
A ver... ¿habéis visto matrix? pues esto que voy a explicar ahora es como cuando Neo empieza a ver todo en verde y se le bizcan los ojos
Ya hemos visto como definir variables que apuntan a números, pero ¿y si queremos definir variables con textos?
A ver... ¿habéis visto matrix? pues esto que voy a explicar ahora es como cuando Neo empieza a ver todo en verde y se le bizcan los ojos
15
(14/x) No podemos guardar en la memoria otra cosa que no sea 1s y 0s. Y ya hemos visto que si cogemos 1 (o varios) byte y nos ponemos a incrementarlo, lo único que ocurre es que estamos incrementando números. Pero hay una cosa que se llama "tabla ASCII" que nos permite coger números y tratarlos como si fuesen letras.
(para los avanzados: ni de coña me voy a meter en unicode aquí. ya escribí otro hilo sobre el tema, lo buscáis. y os aguantáis).
(para los avanzados: ni de coña me voy a meter en unicode aquí. ya escribí otro hilo sobre el tema, lo buscáis. y os aguantáis).
16
(15/x) Así, por ejemplo, el número 107 (1101011) puede ser también la letra "k" (en minúsculas).

17
(16/x) Saltamos de nuevo a "instrucciones"! Ahora que ya hemos empezado a ver matrix, vamos a volver al problema de antes:

18
(17/x)
"a+b" está claro: 00000101 + 01101011 = 01110000 (o 112).
¿y "b+c"?: 01101011 + 01101011 = 11010110 (o 214)?
no... ¿?... a ver, las opciones eran "107k" o "Error", y ahora resulta que el resultado es "214"? wtf¿?
¿y "c+c"? Esto si que debería ser "kk", no? Porque aquí clarisimamente estamos concatenando 2 letras.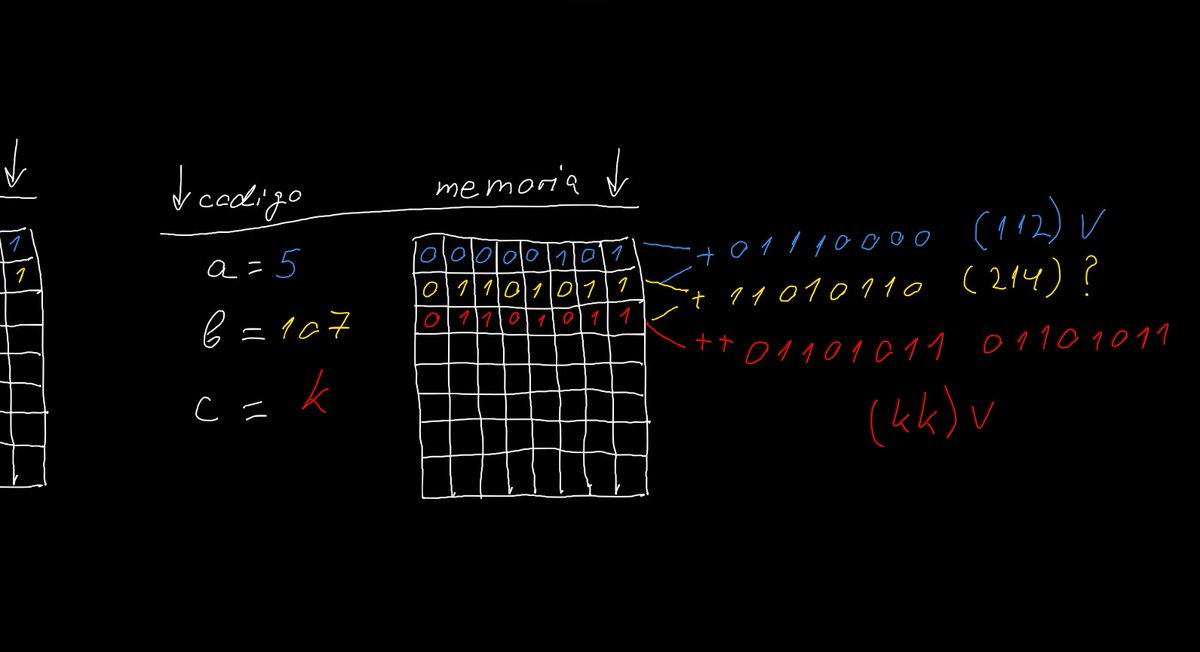
"a+b" está claro: 00000101 + 01101011 = 01110000 (o 112).
¿y "b+c"?: 01101011 + 01101011 = 11010110 (o 214)?
no... ¿?... a ver, las opciones eran "107k" o "Error", y ahora resulta que el resultado es "214"? wtf¿?
¿y "c+c"? Esto si que debería ser "kk", no? Porque aquí clarisimamente estamos concatenando 2 letras.
19
(18/x) Estáis viendo el problema, verdad?
Aunque en un lenguaje de alto nivel (como jabbascript o paiton) el operador "+" nos permita operar sobre variables, a bajo nivel el ordenador debe saber que queremos hacer exactamente. No es lo mismo coger 1 byte y 1 byte y sumarlos como números (en cuyo caso el resultado también es 1 byte), que coger 1 byte y 1 byte y concatenarlos (en cuyo caso el resultado son 2 bytes).
Lo repito. El ordenador debe saber cual es nuestra intención, y lo debe saber sin lugar a ninguna interpretación confusa. Y por ello debemos ser específicos. Debemos ser mas específicos que las instrucciones de nuestra media naranja cuando nos manda a la tienda a comprar cosas, porque sino "compra una botella de leche y si hay huevos, compras media docena" se convierte en 6 botellas de leche y 0 huevos que hemos llevado a casa. Y mal.
Aunque en un lenguaje de alto nivel (como jabbascript o paiton) el operador "+" nos permita operar sobre variables, a bajo nivel el ordenador debe saber que queremos hacer exactamente. No es lo mismo coger 1 byte y 1 byte y sumarlos como números (en cuyo caso el resultado también es 1 byte), que coger 1 byte y 1 byte y concatenarlos (en cuyo caso el resultado son 2 bytes).
Lo repito. El ordenador debe saber cual es nuestra intención, y lo debe saber sin lugar a ninguna interpretación confusa. Y por ello debemos ser específicos. Debemos ser mas específicos que las instrucciones de nuestra media naranja cuando nos manda a la tienda a comprar cosas, porque sino "compra una botella de leche y si hay huevos, compras media docena" se convierte en 6 botellas de leche y 0 huevos que hemos llevado a casa. Y mal.
20
(19/x) Y aquí es donde vamos a bifurcar la categoría "instrucciones" en "instrucciones en lenguajes de alto nivel" y "instrucciones en lenguajes de bajo nivel".

21
(20/x) Vamos con los de bajo nivel.
¿Os acordáis de la palabra que os dije antes? "definir". Cuando se "define" una variable es cuando se le asigna un valor. Pero antes de "definirla", la tenemos que "declarar". Cuando se "declara" una variable es cuando le decimos al lenguaje de programación que tipo de variable estamos creando. Es decir, que es lo que va a contener esa variable (va a ser un valor booleano?, un número?, un carácter?, una cadena de texto?, una turbina de barco?, etc...).
Y esto es muy importante porque significa que el compilador puede analizar de manera estática el 100% de nuestro código y asegurarse que todas las operaciones que estamos haciendo en el código son coherentes (ej, que no estamos intentando multiplicar un seat panda por un campo de trigo y estamos intentando meter el resultado en una lavadora industrial).
¿Os acordáis de la palabra que os dije antes? "definir". Cuando se "define" una variable es cuando se le asigna un valor. Pero antes de "definirla", la tenemos que "declarar". Cuando se "declara" una variable es cuando le decimos al lenguaje de programación que tipo de variable estamos creando. Es decir, que es lo que va a contener esa variable (va a ser un valor booleano?, un número?, un carácter?, una cadena de texto?, una turbina de barco?, etc...).
Y esto es muy importante porque significa que el compilador puede analizar de manera estática el 100% de nuestro código y asegurarse que todas las operaciones que estamos haciendo en el código son coherentes (ej, que no estamos intentando multiplicar un seat panda por un campo de trigo y estamos intentando meter el resultado en una lavadora industrial).
22
(21/x) Otra consecuencia directa es que esto permite (al "compilador") analizar el código que hemos escrito ("código humano") una única vez y convertirlo en "código máquina" (es realmente lo que la CPU entiende).
(¿como represento yo "código máquina" sin entrar en otro pozo sin fondo? 🤔... atpc, voy a poner un jeroglífico. from lost to the river)
(¿como represento yo "código máquina" sin entrar en otro pozo sin fondo? 🤔... atpc, voy a poner un jeroglífico. from lost to the river)
23
(22/x) Es decir, pagamos el precio de convertir el "código humano" a "código máquina" una única vez (es lo que se conoce como "proceso de compilación"), y el resultado final es algún tipo de binario ejecutable (ej los .exe en windows) que nuestra CPU puede ejecutar directamente.
24
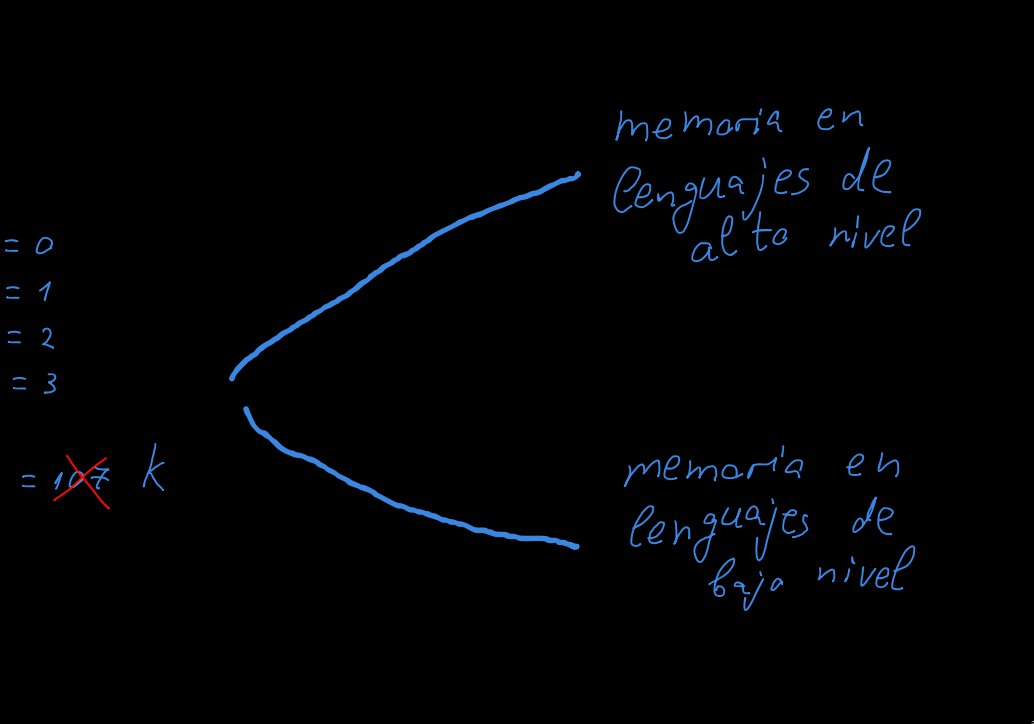
(23/x) Para ver la última consecuencia directa de todo esto nos tenemos que ir un momento a la categoría "memoria" y la tenemos que dividir en "memoria en lenguajes de bajo nivel" y "memoria en lenguajes de alto nivel".
25
(24/x) Esto se declarar y definir variables nos permite no desperdiciar ni 1 byte de memoria. Al declarar el tipo de cada variable, el lenguaje ya puede predecir cuanta memoria necesitamos para cada cosa, reservarla, y colocar todas las variables una al lado de otra, sin nada entre ellas, aka, sin ningún otro tipo de información mas que el propio valor de la variable.
(para los avanzados: no quiero escuchar nada de alineación de estructuras de datos en memoria. ME OIS?? 4 HORAS LLEVO ESCRIBIENDO ESTE HILO. A CALLAR)
(para los avanzados: no quiero escuchar nada de alineación de estructuras de datos en memoria. ME OIS?? 4 HORAS LLEVO ESCRIBIENDO ESTE HILO. A CALLAR)
26
(25/x) "¿Y los lenguajes de alto nivel?"
En los lenguajes de alto nivel no podemos "declarar" variables, solo las podemos "definir". Y por ese motivo el lenguaje debe guardar información adicional para cada variable que, posteriormente ("en tiempo de ejecución"), usará para decidir como operar con ellas. Por ejemplo, el "tipo" de dato. Normalmente se guardan mas cosas, lo cual hace que cada variable ocupe bastantes bytes mas a mayores del tamaño de su propio valor.
(para los avanzados: no quiero escuchar nada de que no-se-que-lenguaje tiene una estructura especial para guardar X tipo de dato que permite no desperdiciar memoria. no voy a entrar en el juego de los edge cases)
En los lenguajes de alto nivel no podemos "declarar" variables, solo las podemos "definir". Y por ese motivo el lenguaje debe guardar información adicional para cada variable que, posteriormente ("en tiempo de ejecución"), usará para decidir como operar con ellas. Por ejemplo, el "tipo" de dato. Normalmente se guardan mas cosas, lo cual hace que cada variable ocupe bastantes bytes mas a mayores del tamaño de su propio valor.
(para los avanzados: no quiero escuchar nada de que no-se-que-lenguaje tiene una estructura especial para guardar X tipo de dato que permite no desperdiciar memoria. no voy a entrar en el juego de los edge cases)
27
(26/x) Esto también significa que no podemos tener un "compilador" como tal. Es imposible analizar nuestro "código humano" de manera estática y producir un binario, ya que no sabemos con antelación los tipos de datos con los que vamos a operar.
Ejemplo simplón en el que es imposible determinar el tipo de dato devuelto por la función "prueba", lo cual hace imposible determinar el tipo de dato de "a", y por lo tanto imposible predecir si la operación "a+b" ha de convertirse en una operación matemática o una operación de concatenación.
Si esto no te parece suficientemente indeterminista, imagínate un bundle de 6mb de incoherencias javascripteras producidas por webpack.
Ejemplo simplón en el que es imposible determinar el tipo de dato devuelto por la función "prueba", lo cual hace imposible determinar el tipo de dato de "a", y por lo tanto imposible predecir si la operación "a+b" ha de convertirse en una operación matemática o una operación de concatenación.
Si esto no te parece suficientemente indeterminista, imagínate un bundle de 6mb de incoherencias javascripteras producidas por webpack.
28
(27/x) Todo esto significa que nuestro "código humano" tiene que analizarse constantemente durante su ejecución. Cada línea de código por la que pasa el flujo de ejecución supone tener que analizar en ese preciso instance el tipo de todas y cada una de las variables que se van a usar en dicha línea y, dependiendo de las reglas que tiene el lenguaje (sumar un número y una letra es error? es concatenación? es ...?), hacer una cosa u otra.

29
(28/x) Esto es infinitamente mas costoso que ejecutar línea por línea (sin tener que convertir nada) lo que el compilador ya nos ha preparado (en el caso de los lenguajes de bajo nivel).
30
(29/x) "Bueno, vale, el código interpretado es mas lento porque cada línea de código se tiene que convertir a código máquina cada vez que se ejecuta. ¿Hay algo mas que haga esos lenguajes mas lentos?"
Oh sweet summer child... Cambiate el dodotis, abrochate el cinto y continuemos derrapando por el autobahn de los tradeoffs que hemos tenido que hacer para que tu, bootcamper de jersey lavado con suavizante Mimosín Azul Cielo y Campo de Tulipanes🌷, puedas permitirte el lujo de no entender como funciona el ordenador y simplemente aporrear el teclado, produciendo ✨ finas y redondas bolitas de jabbascript 🫶 listas para que los escarabajos peloteros puedan divertirse con ellas🌈!! Que no me entere yo que le falta comodidad a mi princeso 💋. oy oy oy oy oy oy oy
Oh sweet summer child... Cambiate el dodotis, abrochate el cinto y continuemos derrapando por el autobahn de los tradeoffs que hemos tenido que hacer para que tu, bootcamper de jersey lavado con suavizante Mimosín Azul Cielo y Campo de Tulipanes🌷, puedas permitirte el lujo de no entender como funciona el ordenador y simplemente aporrear el teclado, produciendo ✨ finas y redondas bolitas de jabbascript 🫶 listas para que los escarabajos peloteros puedan divertirse con ellas🌈!! Que no me entere yo que le falta comodidad a mi princeso 💋. oy oy oy oy oy oy oy
31
(30/x) Algunos lenguajes de alto nivel tienen una cosa que se llama "JIT".
"¿Que es el JIT?"
El JIT es como el ojo de Sauron que todo lo ve. Literalmente, eh. Es un "sistema" que monitoriza todo durante el proceso de ejecución de tu aplicación (el tipo de cada variable, que variables cambian de tipo de dato, cuando lo hacen, que tipo de dato devuelve cada función, el número de veces que se ejecuta cada función, cuanto tarda en ejecutarse, etc...).
"¿Que es el JIT?"
El JIT es como el ojo de Sauron que todo lo ve. Literalmente, eh. Es un "sistema" que monitoriza todo durante el proceso de ejecución de tu aplicación (el tipo de cada variable, que variables cambian de tipo de dato, cuando lo hacen, que tipo de dato devuelve cada función, el número de veces que se ejecuta cada función, cuanto tarda en ejecutarse, etc...).
32
(31/x) Y algunas veces, usando esas estadísticas, el JIT es capaz de decir "mira illo, yo creo que esta función de aquí siempre recibe 2 números y siempre devuelve su suma" (...) y sustituye la función original (la que se tiene que analizar y convertir de código humano a código máquina cada vez que se ejecuta) por una función rápida (compilada a código máquina).
De esta manera nos podemos ahorrar tener que convertir de código humano a código máquina cada vez que ejecutamos esa función, lo cual nos ahorra bastante tiempo.
La función original se queda por ahí porque a veces se recibe algún parámetro que el JIT no había previsto (ej algo que no es un número) y hay que ejecutar la función original con los parámetros recibidos para que ocurra lo que habría ocurrido de no ser por la intervención del JIT.
Pero si la predicción del JIT es buena, el resultado neto es que ganamos tiempo / velocidad de ejecución.
De esta manera nos podemos ahorrar tener que convertir de código humano a código máquina cada vez que ejecutamos esa función, lo cual nos ahorra bastante tiempo.
La función original se queda por ahí porque a veces se recibe algún parámetro que el JIT no había previsto (ej algo que no es un número) y hay que ejecutar la función original con los parámetros recibidos para que ocurra lo que habría ocurrido de no ser por la intervención del JIT.
Pero si la predicción del JIT es buena, el resultado neto es que ganamos tiempo / velocidad de ejecución.
33
(32/x) A veces el JIT puede optimizar solo una parte de una función, a veces una función entera, a veces incluso puede optimizar varias funciones una tras otra, lo cual convierte ese flujo de ejecución entero en un "fast path" (esa parte concreta del código se ejecuta igual de rápido que si estuviese escrita en un lenguaje de nivel bajo).
Hay que destacar que el proceso de compilación ocurre en una máquina, mientras que el proceso de ejecución puede ocurre en otra completamente distinta (ej: te bajaste un .exe de Softonic; el .exe fue compilado en un AMD, pero tu lo estás ejecutando en un Intel). Para que esto sea posible, el compilador debe usar el denominador común del subset de instrucciones que soportan las distintas familias de procesadores para los que se está compilando. Lo cual significa que hay ciertas optimizaciones que el compilador no puede aplicar (sabe como aplicarlas, pero si las aplica, el ejecutable no funcionará en otros procesadores).
Por el contrario, el JIT, al estar funcionando en tiempo real y al "ver" las capacidades del procesador sobre el que se está ejecutando, puede incluso llegar a convertir el código humano en código máquina que usa características avanzadas / adaptadas a ese particular modelo de procesador (algún tipo de operación especial que es más rápida que su equivalente genérico, un registro, más caché, etc...)
Por eso se da la posibilidad de que existan microbenchmarks que comparan X, Y o Z lenguaje con C y los números están a la par o incluso X, Y o Z ganan.
Lo repito para los despistados: Hacer un benchmark entre C y Javascript donde ambos lenguajes invocan una única función que suma números (o hace algún otro tipo de calculo trivial) no tiene ningún sentido porque el JIT es capaz de predecir correctamente como se va a comportar el código y compilarlo. Y eso da como resultado comparar código máquina producido por el compilador de C con código máquina producido por el JIT de JS. Obviamente los resultados van a estar a la par.
Hay que destacar que el proceso de compilación ocurre en una máquina, mientras que el proceso de ejecución puede ocurre en otra completamente distinta (ej: te bajaste un .exe de Softonic; el .exe fue compilado en un AMD, pero tu lo estás ejecutando en un Intel). Para que esto sea posible, el compilador debe usar el denominador común del subset de instrucciones que soportan las distintas familias de procesadores para los que se está compilando. Lo cual significa que hay ciertas optimizaciones que el compilador no puede aplicar (sabe como aplicarlas, pero si las aplica, el ejecutable no funcionará en otros procesadores).
Por el contrario, el JIT, al estar funcionando en tiempo real y al "ver" las capacidades del procesador sobre el que se está ejecutando, puede incluso llegar a convertir el código humano en código máquina que usa características avanzadas / adaptadas a ese particular modelo de procesador (algún tipo de operación especial que es más rápida que su equivalente genérico, un registro, más caché, etc...)
Por eso se da la posibilidad de que existan microbenchmarks que comparan X, Y o Z lenguaje con C y los números están a la par o incluso X, Y o Z ganan.
Lo repito para los despistados: Hacer un benchmark entre C y Javascript donde ambos lenguajes invocan una única función que suma números (o hace algún otro tipo de calculo trivial) no tiene ningún sentido porque el JIT es capaz de predecir correctamente como se va a comportar el código y compilarlo. Y eso da como resultado comparar código máquina producido por el compilador de C con código máquina producido por el JIT de JS. Obviamente los resultados van a estar a la par.
34
(33/x) Pero en el mundo real, eso nunca ocurre porque el lenguaje de alto nivel tiene que ejecutar el propio JIT (que también consume recursos), el JIT nunca va a ser capaz de optimizar el 100% del código, y lo que es más, aunque el flujo de ejecución pase por "funciones rápidas" (compiladas a código máquina por el JIT), eventualmente tiene que pasar también por las funciones "lentas" y por los segmentos de código que el JIT no ha podido convertir a código máquina. Y cuando ocurre eso, la diferencia en el rendimiento entre código nativo y código interpretado es abismal (ordenes de magnitud).

35
(34/x) Ocurre también que todos los lenguajes de alto nivel se ocupan automáticamente de la gestión de memoria.
"¿Que es eso de la gestión de memoria?" te preguntaras.
Volvamos una última vez a la sección de "memoria".
En un lenguaje de bajo nivel, "tu" (el programador) eres el responsable de decidir cuando pedirle memoria al sistema operativo y cuando liberarla.
En el ejemplo de concatenar 2 letras, la operación sería algo parecido a esto:
- oye, OS, dame 2 bytes
+ va, toma
- asias ;)
- oye, OS, toma esos 2 bytes que me diste, que ya no los necesito. Puedes dárselos a otra aplicación que los necesite
+ perfecto, jefe, van directos a un tal chrome.exe que lleva mendigando memoria todo el día
"¿Que es eso de la gestión de memoria?" te preguntaras.
Volvamos una última vez a la sección de "memoria".
En un lenguaje de bajo nivel, "tu" (el programador) eres el responsable de decidir cuando pedirle memoria al sistema operativo y cuando liberarla.
En el ejemplo de concatenar 2 letras, la operación sería algo parecido a esto:
- oye, OS, dame 2 bytes
+ va, toma
- asias ;)
- oye, OS, toma esos 2 bytes que me diste, que ya no los necesito. Puedes dárselos a otra aplicación que los necesite
+ perfecto, jefe, van directos a un tal chrome.exe que lleva mendigando memoria todo el día
36
(35/x) Pero en un lenguaje de alto nivel todo esto ocurre automáticamente.
Y te preguntaras "¿Y donde está lo malo?".
"Lo malo" es que para que eso pueda ocurrir, el lenguaje tiene que llevar una especie de "cuenta" de quien está usando cada variable. Esto es así porque el lenguaje no puede "liberar" la memoria de las variables mientras "alguien" (ej, una función) las está usando. Y para que eso no ocurra, tiene que saber de alguna manera si alguien está usando cada variable.
Cada lenguaje lo hace de una manera distinta. Un ejemplo sería este:
Cada vez que "alguien" usa una variable, se incrementa un contador (que incrementa todavía mas el uso de memoria, porque ya no se está guardando solo el valor de la variable en sí, sino también el tipo y el número de veces que se está usando la variable), y cada vez que alguien deja de usarla, el contador se decrementa.
Y te preguntaras "¿Y donde está lo malo?".
"Lo malo" es que para que eso pueda ocurrir, el lenguaje tiene que llevar una especie de "cuenta" de quien está usando cada variable. Esto es así porque el lenguaje no puede "liberar" la memoria de las variables mientras "alguien" (ej, una función) las está usando. Y para que eso no ocurra, tiene que saber de alguna manera si alguien está usando cada variable.
Cada lenguaje lo hace de una manera distinta. Un ejemplo sería este:
Cada vez que "alguien" usa una variable, se incrementa un contador (que incrementa todavía mas el uso de memoria, porque ya no se está guardando solo el valor de la variable en sí, sino también el tipo y el número de veces que se está usando la variable), y cada vez que alguien deja de usarla, el contador se decrementa.
37
(36/x) Cada cierto tiempo (digamos cada 50ms) el lenguaje ejecuta una cosa llamada Garbage Collector que pausa toda la ejecución de la aplicación y se pone a inspeccionar el numerito de "usado" de cada variable para ver desde cuantos sitios se está usando. Si el numerito está a 0 se considera que esa variable ya no se necesita y que se puede liberar la memoria que ocupa dicha variable.
Por el lado bueno, hemos conseguido no tener que preocuparnos de manejar memoria a mano. Por el lado malo, ahora nuestra aplicación va a trompicones cada 50ms.
Por el lado bueno, hemos conseguido no tener que preocuparnos de manejar memoria a mano. Por el lado malo, ahora nuestra aplicación va a trompicones cada 50ms.
38
(37/x) Si has llegado hasta aquí y has entendido el 30% de lo que he puesto, enhorabuena, ya sabes mas cosas a bajo nivel que el 95% de devs.
Pero lo más importante, ya estás listo para la parte final del hilo: las conclusiones y los lenguajes.
Vamos con un diagrama de Venn:
Los lenguajes compilados son muy rápidos, tienen baja latencia, bajo consumo de memoria, no necesitan un runtime o VM, dependiendo de como compiles el proyecto el compilador puede aplicar optimizaciones muy locas. Pero el tiempo de desarrollo es lento y (y esta es la parte fina) necesitas gente que sepa lo que hace. Estos lenguajes no perdonan la bootcamperia. Aquí no hay ruedines. O sabes lo que haces o no haces nada.
Aquí están (entre otros) C, C++, Rust, Go, Zig y Swift.
Los lenguajes interpretados, en cambio, son lentos o muy lentos (en comparación con los nativos). Tienen un consumo de memoria elevado o muy elevado. Necesitan de algún tipo de runtime o VM, suelen tardar mas en arrancar, tienen una latencia muy alta debido al GC. Pero la parte buena es que para sacar adelante un proyecto en un lenguaje así necesitas media docena de mandriles, babuinos, macacos, langures o básicamente cualquier otro tipo de simio medianamente civilizado (opcional). Y cacahuetes a granel.
"Vale, pero estos 2 circulitos no se solapan"
Veo que tus capacidades deductivas están a la par con las de Sherlock 😏
No se solapan porque no existe un lenguaje que tenga lo de ambos circulitos.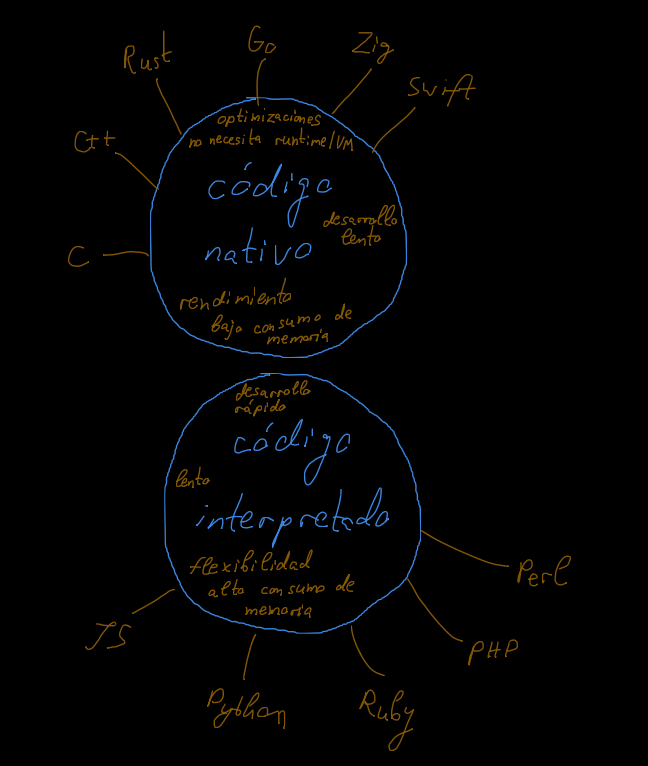
Pero lo más importante, ya estás listo para la parte final del hilo: las conclusiones y los lenguajes.
Vamos con un diagrama de Venn:
Los lenguajes compilados son muy rápidos, tienen baja latencia, bajo consumo de memoria, no necesitan un runtime o VM, dependiendo de como compiles el proyecto el compilador puede aplicar optimizaciones muy locas. Pero el tiempo de desarrollo es lento y (y esta es la parte fina) necesitas gente que sepa lo que hace. Estos lenguajes no perdonan la bootcamperia. Aquí no hay ruedines. O sabes lo que haces o no haces nada.
Aquí están (entre otros) C, C++, Rust, Go, Zig y Swift.
Los lenguajes interpretados, en cambio, son lentos o muy lentos (en comparación con los nativos). Tienen un consumo de memoria elevado o muy elevado. Necesitan de algún tipo de runtime o VM, suelen tardar mas en arrancar, tienen una latencia muy alta debido al GC. Pero la parte buena es que para sacar adelante un proyecto en un lenguaje así necesitas media docena de mandriles, babuinos, macacos, langures o básicamente cualquier otro tipo de simio medianamente civilizado (opcional). Y cacahuetes a granel.
"Vale, pero estos 2 circulitos no se solapan"
Veo que tus capacidades deductivas están a la par con las de Sherlock 😏
No se solapan porque no existe un lenguaje que tenga lo de ambos circulitos.
39
(38/x) Puede que ahora mismo estés pensando: "Vale, todo eso es perfecto, me parece estupendo y maravilloso, pero ¿DONDE HOSTIAS está Java? hijo de cien mil hienas comunistas."
Tranquilidad. Te noto muy tenso. Tomate un cafecito.
Tranquilidad. Te noto muy tenso. Tomate un cafecito.
40
(39/x) ¿Por donde iba? ... hmmm ... ah, si. Java!
Java es un bicho en tierra de nadie (y de ahí que no haya dibujado los 2 círculos del diagrama de Venn con solape). En teoría puede llegar a compilarse a código nativo (con GraalVM), pero en la práctica si usas Reflections, JNI, AWT, Swing, carga dinámica de clases o varias otras características de Java, compilarlo a código nativo va a ser entre muy difícil e imposible.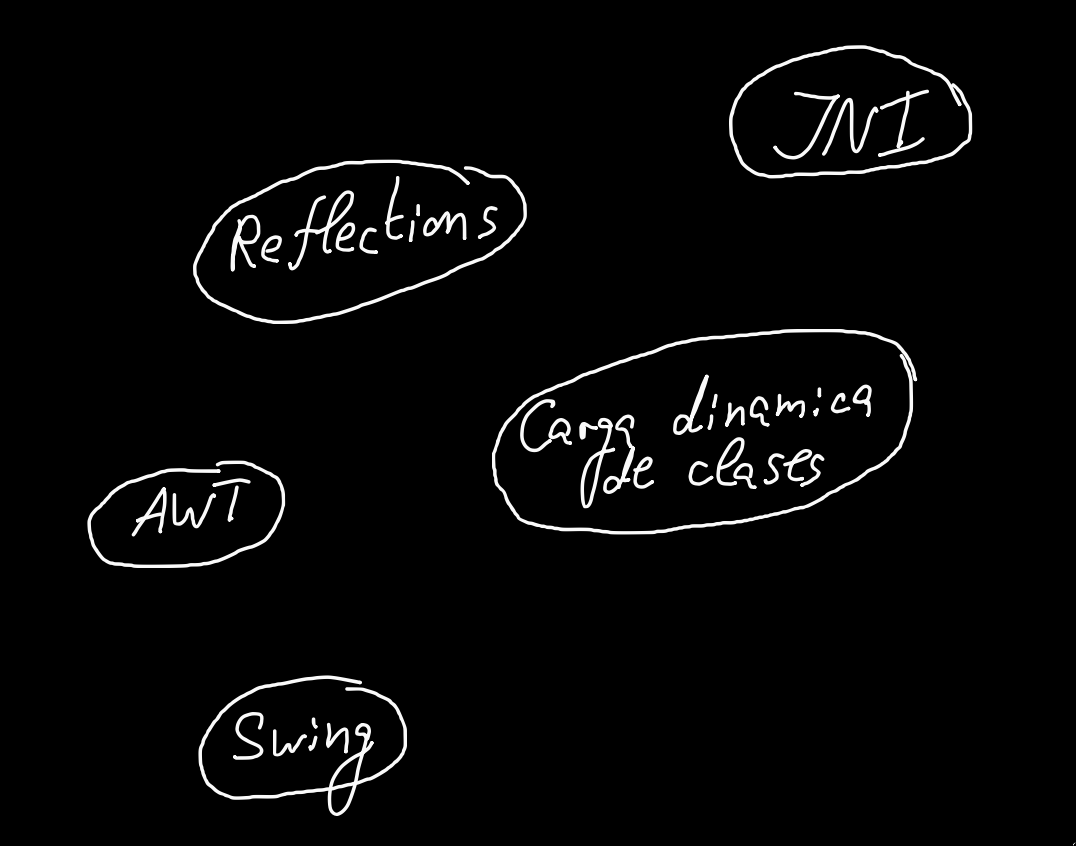
Java es un bicho en tierra de nadie (y de ahí que no haya dibujado los 2 círculos del diagrama de Venn con solape). En teoría puede llegar a compilarse a código nativo (con GraalVM), pero en la práctica si usas Reflections, JNI, AWT, Swing, carga dinámica de clases o varias otras características de Java, compilarlo a código nativo va a ser entre muy difícil e imposible.
41
(40/x) Y aunque lo compiles a código nativo, sigue teniendo GC y sigue tragando un montón de memoria. Y sigue congelándose cada 50ms.
Y no es tan flexible como Paiton o JS. Desde luego no sirve para IA.
Tampoco sirve para ejecutarlo en un navegador (al menos que seas sadomasoquista).
No es el lenguaje que mejor se pague (comparando datos de Manfred). No es el peor tampoco; "del montón". Te asegura un puesto de picateclas en un cubículo deprimente en el sótano de cualquier consultoría en alguna de las 4 torres de Mordor en el paseo de la Castellana).
Su (web)framework mas popular es un mostrenco que no hay por donde agarrarlo, desde luego si lo comparas con sus primos de otros lenguajes sale perdiendo en flexibilidad (java no es mas flexible que ruby), velocidad de desarrollo (java no es más rápido de picar que php), etc...
Del abanico de librerías para cubrir necesidades "enterprise" (data streams, parseo de ficheros, etc...) no estoy del todo seguro. Tras un par de horas de investigación no he podido ver grandes diferencias con lo que ofrece python. A lo mejor no he mirado bien. 🤷♂️
Queda por evaluar la velocidad de ejecución, que, objetivamente, es mejor que la del resto de lenguajes interpretados (aunque esa diferencia es cada vez menor; PHP y Python están haciendo grandes progresos en sus JITs). Pero está lejos de la velocidad que puedes conseguir si te vas a un lenguaje compilado.
¿Entonces por que elegirías Java? La única razón que queda es que tiene tipado fuerte, lo cual te permite comprobar que todo está "bien" en tiempo de compilación. Exceptuando esta diferencia, no consigo verle el atractivo.
En fin, querido lector, déjame en los comentarios tus razones para usar Java. Yo te dejo el resumen gráfico de todo este hilo con mi analisis totalmente objetivo de Java, con mucho amor.
Y no es tan flexible como Paiton o JS. Desde luego no sirve para IA.
Tampoco sirve para ejecutarlo en un navegador (al menos que seas sadomasoquista).
No es el lenguaje que mejor se pague (comparando datos de Manfred). No es el peor tampoco; "del montón". Te asegura un puesto de picateclas en un cubículo deprimente en el sótano de cualquier consultoría en alguna de las 4 torres de Mordor en el paseo de la Castellana).
Su (web)framework mas popular es un mostrenco que no hay por donde agarrarlo, desde luego si lo comparas con sus primos de otros lenguajes sale perdiendo en flexibilidad (java no es mas flexible que ruby), velocidad de desarrollo (java no es más rápido de picar que php), etc...
Del abanico de librerías para cubrir necesidades "enterprise" (data streams, parseo de ficheros, etc...) no estoy del todo seguro. Tras un par de horas de investigación no he podido ver grandes diferencias con lo que ofrece python. A lo mejor no he mirado bien. 🤷♂️
Queda por evaluar la velocidad de ejecución, que, objetivamente, es mejor que la del resto de lenguajes interpretados (aunque esa diferencia es cada vez menor; PHP y Python están haciendo grandes progresos en sus JITs). Pero está lejos de la velocidad que puedes conseguir si te vas a un lenguaje compilado.
¿Entonces por que elegirías Java? La única razón que queda es que tiene tipado fuerte, lo cual te permite comprobar que todo está "bien" en tiempo de compilación. Exceptuando esta diferencia, no consigo verle el atractivo.
En fin, querido lector, déjame en los comentarios tus razones para usar Java. Yo te dejo el resumen gráfico de todo este hilo con mi analisis totalmente objetivo de Java, con mucho amor.