#統計 議論「二項分布のベータ事前分布Beta(a,b)」の解釈の仕方? app.emuyn.net/stats/simulato…...

黒木玄 Gen Kuroki@genkuroki
76 views
Mar 17, 2025
~2 min read
Advertisement
1
#統計 議論「二項分布のベータ事前分布Beta(a,b)」の解釈の仕方?
app.emuyn.net/stats/simulato… では
a=想定される成功数+1
b=想定される失敗数+1
と解釈しているのですが、「+1」は不要なのではないか?
これは事後分布と通常のP値の比較の仕方にもよる問題。続く
app.emuyn.net/stats/simulato… では
a=想定される成功数+1
b=想定される失敗数+1
と解釈しているのですが、「+1」は不要なのではないか?
これは事後分布と通常のP値の比較の仕方にもよる問題。続く

2
#統計 「+1」の有無は些細な問題。しかし、些細な話にも面白い部分があると思うので、自分で考えたことを書きます。
事前に本当に何も情報がない状況は期待値さえ不明になっていると考えられます。
そのような二項分布の事前分布はimproperであると考えられます。第一候補はBeta(0,0)です。続く
事前に本当に何も情報がない状況は期待値さえ不明になっていると考えられます。
そのような二項分布の事前分布はimproperであると考えられます。第一候補はBeta(0,0)です。続く
3
#統計 ベータ分布Beta(0,0)は確率分布としては定義されていません。∫₀¹ p⁰⁻¹(1-p)⁰⁻¹ dp=∞なので全確率=1となるように正規化できない。
しかし、kとn-kが共に正ならば、
∫₀¹ pᵏ(1-p)ⁿ⁻ᵏ×p⁰⁻¹(1-p)⁰⁻¹ dp=B(k, n-k)<∞
となり、事後分布はBeta(k,n-k)として構成可能。続く
しかし、kとn-kが共に正ならば、
∫₀¹ pᵏ(1-p)ⁿ⁻ᵏ×p⁰⁻¹(1-p)⁰⁻¹ dp=B(k, n-k)<∞
となり、事後分布はBeta(k,n-k)として構成可能。続く
4
#統計 そういう意味で使えるimproper事前分布としてなら、Beta(0,0)は意味を持ちます。
improperベータ事前分布Beta(0,0)は「事前に何も情報がないと事前には期待値も含めて本当に何もわからない」ということをうまく表現しているようにも見えます。続く
improperベータ事前分布Beta(0,0)は「事前に何も情報がないと事前には期待値も含めて本当に何もわからない」ということをうまく表現しているようにも見えます。続く
5
#統計 「事前に何も情報がないこと」を「事前に何のデータも得られていなかったこと」とも解釈すると、improperベータ事前分布Beta(0,0)は事前の成功回数aと失敗回数bのデータが何もなくて両方0の状況の数学的表現だとも解釈できます。続く
6
#統計 その立場では区間[0,1]上の一様事前分布Beta(1,1)は、事前に成功回数a=1、失敗回数b=1のデータがすでに得られていた状況を表現していると解釈されます。
その事前分布での成功率の期待値a/(a+b)=1/2は事前の最尤推定値に一致している。続く
その事前分布での成功率の期待値a/(a+b)=1/2は事前の最尤推定値に一致している。続く
7
#統計 一般にベータ事前分布Beta(a,b)は、事前に成功回数a、失敗回数bのデータが得られた状況(もしくはそれと同等な状況)の数学的表現になっていると考えられて、その期待値a/(a+b)は事前のデータからの最尤推定値に一致している。続く
8
#統計 p~Beta(a,b)の密度関数の対数オッズ座標x=log(p/(1-p))での表示は、p(x)=1/(1+e⁻ˣ)とおいたときのp(x)ᵃ(1-p(x))ᵇになり、指数の-1が消えます。
p(x)ᵃ(1-p(x))ᵇは
p(x)=a/(a+b)=(p(x)の期待値)
で最大化されます。続く
p(x)ᵃ(1-p(x))ᵇは
p(x)=a/(a+b)=(p(x)の期待値)
で最大化されます。続く
9
#統計 improperベータ事前分布Beta(0,0)は、対数オッズ座標系x=log(p/(1-p))では、ℝ上のimproper一様分布に一致します。
improperベータ事前分布Beta(0,0)を事前に何もデータがない状況の表現だと解釈する流儀は、対数オッズx=log(p/(1-p))を座標系とする表示と相性が良いです。
improperベータ事前分布Beta(0,0)を事前に何もデータがない状況の表現だと解釈する流儀は、対数オッズx=log(p/(1-p))を座標系とする表示と相性が良いです。
10
#統計 対数オッズx=log(p/(1-p))ではなく、元のpで平坦な事前分布Beta(1,1)を事前に何もデータが得られていないことの表現とみなす立場もあり得ると思いますが、期待値がすでに定義されており、本当に何も情報がない状況の表現としては弱い感じがします。(注意!些細な問題!)
11
#統計 ベータ分布Beta(a,b)の座標pでの密度関数は(a-1)/(a+b-2)で最大化されるので、座標pでの密度関数の最大化でpの点推定値を得る立場での、事前に何も情報が無かった状況を表現する事前分布はBeta(1,1)になると考えられる。
12
#統計 事前分布から、事前の推定値を得る方法には以下がある。
①期待値を求める。
②密度関数を最大化する。これは座標系に依存する。(例えば元のpと対数オッズx=log(p/(1-p))では結果が異なる。対数オッズ座標系でのベータ分布の密度関数を最大化するpは期待値に一致)
③中央値を求める。
①期待値を求める。
②密度関数を最大化する。これは座標系に依存する。(例えば元のpと対数オッズx=log(p/(1-p))では結果が異なる。対数オッズ座標系でのベータ分布の密度関数を最大化するpは期待値に一致)
③中央値を求める。
13
#統計 以上では、①期待値と②密度関数の最大化について少し述べた。③中央値の場合についてはどうなるか?
ベータ分布Beta(a,b)の中央値は(a-1/3)/(a+b-2/3)で近似されることが知られています。この立場での、事前に何も情報がない状況は近似的にBeta(1/3,1/3)に対応していると考ええられます。続く
ベータ分布Beta(a,b)の中央値は(a-1/3)/(a+b-2/3)で近似されることが知られています。この立場での、事前に何も情報がない状況は近似的にBeta(1/3,1/3)に対応していると考ええられます。続く
14
#統計 ベイズ統計のソフトでは、点推定値として中央値を表示して、2.5%と97.5%分位点も合わせて表示して区間推定とするものが多い。
点推定値として中央値として採用する流儀での、事前に何も情報がない状況を近似的に表現する事前分布はBeta(1/3, 1/3)だと考えられます。
点推定値として中央値として採用する流儀での、事前に何も情報がない状況を近似的に表現する事前分布はBeta(1/3, 1/3)だと考えられます。
15
#統計 このように事前に何も情報が無かった状況を表現する事前分布の取り方は、点推定や区間推定をどのように行うとつもりかにも依存するので、一意的には決まらないと考えるのが妥当だと思います。
私はこういう些細な事柄に関する話も結構好きです。
私はこういう些細な事柄に関する話も結構好きです。
16
#統計 注意警告1
密度関数は座標に依存して決まる関数なので、密度関数の最大化も座標の取り方に依存します。
密度関数の最大化による点推定の区間推定への自然な拡張は、最高密度区間(HDI)になります。HDIも座標の取り方に依存する点に注意しないと失敗します。
密度関数は座標に依存して決まる関数なので、密度関数の最大化も座標の取り方に依存します。
密度関数の最大化による点推定の区間推定への自然な拡張は、最高密度区間(HDI)になります。HDIも座標の取り方に依存する点に注意しないと失敗します。
17
#統計 注意警告2
ベイズ統計について「事前の信念をデータによって更新する」という解釈で押し通すことは科学的に有害なのでやめた方がよいです。特に医学的には極めて有害だと思います。
「そのように解釈する人達がいる」という事実を説明して、科学研究には向かないと説明した方が無難。続く
ベイズ統計について「事前の信念をデータによって更新する」という解釈で押し通すことは科学的に有害なのでやめた方がよいです。特に医学的には極めて有害だと思います。
「そのように解釈する人達がいる」という事実を説明して、科学研究には向かないと説明した方が無難。続く
18
#統計 Statistical Rethinking 2nd ed. p.35より【ベイズ推論には、分析者の個人的な信念に基づいて事前分布を選択することを重視する一派がある。この主観的ベイズのアプローチは、一部の統計学、哲学、経済学の分野では盛んに研究されているが、科学の分野ではあまり一般的ではない。】続く

19
#統計 Statistical Rethinkingは主観的ベイズに明瞭に否定的な立場で、私は科学的に常識的な感覚を素直に述べていて好ましいと思います。これを言われたて困りそうな人にはベイズ統計について教わらない方が無難です。
添付画像部分は無料で読めます。
xcelab.net/rmpubs/sr2/sta… のp.35
添付画像部分は無料で読めます。
xcelab.net/rmpubs/sr2/sta… のp.35
20
#統計 Statistical Rethinkingにも書いてあるように、事前分布もモデルの一部分です。科学的な研究者はデータを得た後にモデルを破棄することがよくあります。事前分布もモデルの一部分に過ぎず、破棄する可能性がある対象の1つとして扱われることになります。
これは科学的には当たり前の話です。
これは科学的には当たり前の話です。
21
#統計 事前分布も含めてモデルが信用できない場合であっても通用する事後分布の安全牌的な解釈法は、事後分布を
データの数値
事前分布を構成要素として含むモデル
パラメータの値の設定
の3つのcompatibilityの様子を表していると解釈することです。
P値の場合とほぼ同様です。
データの数値
事前分布を構成要素として含むモデル
パラメータの値の設定
の3つのcompatibilityの様子を表していると解釈することです。
P値の場合とほぼ同様です。
22
#統計 例えば、二項分布モデルで事前分布がBeta(1,1)でデータが「n=10人中k=7人成功」の場合の事後分布のグラフ(添付画像)を見ると、座標pで見たとき、二項分布モデルの下で、データの数値と事前分布の組み合わせに最も相性が良いpの値は0.7だと分かる。これは最尤法の結果に一致する。続く

23
#統計 別の例。二項分布モデルで事前分布がBeta(4,8)でデータが「n=10人中k=7人成功」の場合の事後分布のグラフ(添付画像)を見ると、座標pでの、二項分布モデルの下でデータの数値と事前分布の組み合わせに最も相性が良いpの値は0.5だと分かる。偏った事前分布も含めての相性の様子なので偏る。

24
#統計 どちらの事後分布を見ても、二項分布モデルの下で、p=0.2という仮説と、データの数値「n=10人中k=7人成功」と事前分布(Beta(1,1)またはBeta(4,8))の組み合わせとの相性は悪そうに見える。
しかし、p=0.8との相性の良さは2つの場合で大きく違う。

しかし、p=0.8との相性の良さは2つの場合で大きく違う。
25
#統計 事後分布のグラフを見れば、使用した特定の統計モデルの下での
モデルのパラメータの値に関する仮説
と
データの数値と事前分布の組み合わせ
の相性の良さ(compatibility)の様子が分かります。
これより強い結論が欲しいならば、モデルとデータの数値とは別の情報と専門知識が必要になる。
モデルのパラメータの値に関する仮説
と
データの数値と事前分布の組み合わせ
の相性の良さ(compatibility)の様子が分かります。
これより強い結論が欲しいならば、モデルとデータの数値とは別の情報と専門知識が必要になる。
26
#統計 Greenlandさん達やStatistical RethinkingのMcElreathさんによる「データの数値とモデルのcompatibilityの様子を表している」という解釈の仕方について完全に無知なせいで、前世紀の時代遅れの主観ベイズ主義の解釈を振り回すことは、そろそろ、知的に恥ずかしいことだと認識されるべき。
27
#統計 ベイズの非ベイズの比較はP値関数で行うと楽。ベイズ側のP値関数の1つの作り方は事後分布でp以下になる確率とp以上になる確率の小さい方の2倍(これは中央値を点推定値とすることの拡張)。
事前分布がBeta(1/3,1/3)のとき、そのベイズ版P値とスコア法のP値は添付画像のようによく一致する。
事前分布がBeta(1/3,1/3)のとき、そのベイズ版P値とスコア法のP値は添付画像のようによく一致する。
28
#統計 データのサイズを大きくすると、ベイズ版の両側P値と非ベイズ版の通常のスコア法によるP値はさらによく一致するようになる。
実践的にはここまで一致していれば区別する必要はないだろう。
実践的にはここまで一致していれば区別する必要はないだろう。
29
#統計 多くの人達が以上で示した「無情報事前分布の場合のベイズと非ベイズの近似的な一致」(非常にシンプル)に失敗している理由は、非ベイズ版の両側P値のベイズでの対応物が何であるかを理解していないからだと思われます。
片側P値の対応はもっとシンプル。続く
片側P値の対応はもっとシンプル。続く
30
#統計 通常の「仮説p≤p₀の片側P値」のベイズ版は「事後分布でp≤p₀となる確率」です。無情報事前分布の下でそれらは添付画像のようによく一致します。
二項分布モデル程度のシンプルなモデルでベイズと非ベイズを違うものであるかのように語ることは酷くミスリーディングです。
二項分布モデル程度のシンプルなモデルでベイズと非ベイズを違うものであるかのように語ることは酷くミスリーディングです。
31
#統計 モデルと扱う仮説の組み合わせがシンプルだと、適当な無情報事前分布を選んだとき、ベイズと非ベイズの結果はよく一致します。
モデルと扱う仮説の組み合わせが複雑な場合や偏った事前分布を採用したには、上手に一致させるのが難しくなったり、本質的な違いが生じたりします。
モデルと扱う仮説の組み合わせが複雑な場合や偏った事前分布を採用したには、上手に一致させるのが難しくなったり、本質的な違いが生じたりします。
32
#統計 非ベイズの線形回帰とベイズ版の線形回帰は、事前分布としてβとlog σ²についてのimproper平坦事前分布を採用すると、数学的に誤差なしにぴったり一致するようになります。
線形回帰について、非ベイズとベイズの違いは事前分布の偏りの分しか出ません。
線形回帰について、非ベイズとベイズの違いは事前分布の偏りの分しか出ません。
33
#統計 主観ベイズ主義に偏った時代遅れで科学的に役に立ちそうもない見方でベイズ統計について解説する悪しき慣習のせいで、ベイズ統計の方法(主義思想哲学ではなく方法)を学んだ方が得な人達にベイズ統計が普及し難くなっているという問題が生じていると思います。
34
#統計 Statistical Rethinking 2nd ed. p.58にある以下のリンク先の説明をChatGPTさんに色々教えながら翻訳させてみました。
ベイズであろうがなかろうが、区間推定で得られた95%区間に真の値が95%の確率や割合で含まれていると安易に信じるのは酷い誤り。

ベイズであろうがなかろうが、区間推定で得られた95%区間に真の値が95%の確率や割合で含まれていると安易に信じるのは酷い誤り。


35
#統計 Statistical Rethinkingは、統計学に関する伝統的かつ慣習化された説明の内容について再考し、伝統的説明の多くが科学的に有害な考え方を含んでいるという結論を出して、穏健な代替案を示すことを繰り返しています。
統計学を教えて来た人達は厳しく批判されていることを自覚するべき。
統計学を教えて来た人達は厳しく批判されていることを自覚するべき。
36
#統計 統計学の伝統的な解説者達が広めて来た科学的に有害な考え方をことごとく否定して代替案を示しているStatistical Rethinkingの講義が世界的に大人気であることは非常に喜ばしいことだと思います。それで育った人達が活躍するようになれば、統計学の使われ方が改善されて行くものと思われます。
37
#統計 Statistical Rethinkingの講義の資料と動画は
github.com/rmcelreath/sta…
から閲覧できます。
github.com/rmcelreath/sta… で講義で使われたミーム群に目を通すだけでも楽しめると思います。
例えば
↓
github.com/rmcelreath/sta…
から閲覧できます。
github.com/rmcelreath/sta… で講義で使われたミーム群に目を通すだけでも楽しめると思います。
例えば
↓
38
#統計 翻訳について
この文脈でのcompatibilityをどのように日本語に翻訳するかは難しい問題です。私はChatGPTに、単体のcomparibilityは「相性の良さ」と、compatibility intervalは「良相性区間」と翻訳するように指示を出しました。続く
この文脈でのcompatibilityをどのように日本語に翻訳するかは難しい問題です。私はChatGPTに、単体のcomparibilityは「相性の良さ」と、compatibility intervalは「良相性区間」と翻訳するように指示を出しました。続く
黒木玄 Gen Kuroki@genkuroki
#統計 Statistical Rethinking 2nd ed. p.58にある以下のリンク先の説明をChatGPTさんに色々教えながら翻訳させてみました。
ベイズであろうがなかろうが、区間推定で得られた95%区間に真の値が95%の確率や割合で含まれていると安易に信じるのは酷い誤り。
ベイズであろうがなかろうが、区間推定で得られた95%区間に真の値が95%の確率や割合で含まれていると安易に信じるのは酷い誤り。
39
#統計 95% compatibility intervalは「5%閾値の設定によって、データの数値とcompatibleだとみなされたモデルのパラメータの範囲」という意味で使われる用語なので、compatibleを「相性が良い」と翻訳するならば、compatibility intervalは「良相性区間」のように翻訳するべきだということになります。
40
#統計 この文脈でcompatibilityを「互換性」と翻訳するのは誤訳になるので要注意です。ChatGPTも指示を出さないとそのように誤訳していました。
この文脈ではcompatibilityはconsistencyとほぼ同じ意味で使われています。consistentという単語の使用は統計学の文脈では色々まずい。
この文脈ではcompatibilityはconsistencyとほぼ同じ意味で使われています。consistentという単語の使用は統計学の文脈では色々まずい。
41
#統計 ベイズであろうがなかろうが、データの数値が生成される法則の同時確率分布によるモデル化を考えることは、現代的には不十分で一段劣っている考え方だとみなされます。
同時確率分布によるモデル化は因果関係の情報を捨象する単純化になっているので、因果効果を扱うことをできません。
同時確率分布によるモデル化は因果関係の情報を捨象する単純化になっているので、因果効果を扱うことをできません。
黒木玄 Gen Kuroki@genkuroki
#統計 Statistical Rethinkingの講義の資料と動画は
github.com/rmcelreath/sta…
から閲覧できます。
github.com/rmcelreath/sta… で講義で使われたミーム群に目を通すだけでも楽しめると思います。
例えば
↓
github.com/rmcelreath/sta…
から閲覧できます。
github.com/rmcelreath/sta… で講義で使われたミーム群に目を通すだけでも楽しめると思います。
例えば
↓
42
#統計 ベイズであろうが頻度論であろうが、因果関係の情報を捨象して得られる同時確率分布によるモデル化だけでどうにかしようとすることは、因果推論の立場からは全然ダメなやり方ですよ、という現代的な話が1枚のミームに集約されています。
黒木玄 Gen Kuroki@genkuroki
#統計 Statistical Rethinkingの講義の資料と動画は
github.com/rmcelreath/sta…
から閲覧できます。
github.com/rmcelreath/sta… で講義で使われたミーム群に目を通すだけでも楽しめると思います。
例えば
↓
github.com/rmcelreath/sta…
から閲覧できます。
github.com/rmcelreath/sta… で講義で使われたミーム群に目を通すだけでも楽しめると思います。
例えば
↓
43
#統計 因果推論も伝統的解説のされ方も酷くて普及が遅れてしまっていると思います。ベイズ統計の伝統的解説と似たような感じ。
データの数値だけから客観的な分析を行えるかのように見せようとする説明は酷く有害で、モデル依存の分析をしていることを常に明らかにして行くべきだと思います。続く
データの数値だけから客観的な分析を行えるかのように見せようとする説明は酷く有害で、モデル依存の分析をしていることを常に明らかにして行くべきだと思います。続く
44
#統計 Statistical Rethinkingでは、ベイズ統計についても、因果推論についても、モデルをきちんと設定するところから説明しています。
因果効果推定のためには、変量達の同時確率分布によるモデル化では不十分で、因果関係の情報を補ったモデルを考える必要があります。そういう説明になっています。
因果効果推定のためには、変量達の同時確率分布によるモデル化では不十分で、因果関係の情報を補ったモデルを考える必要があります。そういう説明になっています。
45
#統計 以下のリンク先のグラフは、事前分布がBeta(1/3, 1/3)の二項分布モデルで、「スコア法での仮説p≤p₀の片側P値」と「事後分布でp≤p₀となる確率」がほぼ一致していることをしめしています。
事前分布がBeta(1,1)の場合(続く)
↓
github.com/genkuroki/publ…

事前分布がBeta(1,1)の場合(続く)
↓
github.com/genkuroki/publ…
黒木玄 Gen Kuroki@genkuroki
#統計 通常の「仮説p≤p₀の片側P値」のベイズ版は「事後分布でp≤p₀となる確率」です。無情報事前分布の下でそれらは添付画像のようによく一致します。
二項分布モデル程度のシンプルなモデルでベイズと非ベイズを違うものであるかのように語ることは酷くミスリーディングです。
二項分布モデル程度のシンプルなモデルでベイズと非ベイズを違うものであるかのように語ることは酷くミスリーディングです。
46
#統計 事前分布をBeta(1/3, 1/3)からBeta(1, 1)の変えると、ベイズ法とスコア法のグラフ上でのずれが大きくなるのですが、重要なのはグラフのすそで、例えば、どちらで見ても
仮説p≤0.3とデータの数値「10人中7人成功」の相性が悪そうだ
という結果は保持されています。
github.com/genkuroki/publ…
仮説p≤0.3とデータの数値「10人中7人成功」の相性が悪そうだ
という結果は保持されています。
github.com/genkuroki/publ…
47
#統計 #因果推論
同時分布によるモデル化自体には因果関係の情報が含まれていないこと関連
↓

同時分布によるモデル化自体には因果関係の情報が含まれていないこと関連
↓
黒木玄 Gen Kuroki@genkuroki
#統計
ZがX,Yの共通の原因の場合とXがZ,Yの共通原因の場合とでは大違いなことに注意してください。
変数達の同時確率分布によるモデル化は因果関係の情報を持っていないので、追加の情報無しでは因果効果が定義されない。これがすべての出発点。
実際の計算の仕方は別の問題。
以上のまとめ
↓
ZがX,Yの共通の原因の場合とXがZ,Yの共通原因の場合とでは大違いなことに注意してください。
変数達の同時確率分布によるモデル化は因果関係の情報を持っていないので、追加の情報無しでは因果効果が定義されない。これがすべての出発点。
実際の計算の仕方は別の問題。
以上のまとめ
↓
48
#統計 データの数値の表のイメージで説明するスタイルはモデル依存の分析を「データの数値だけを使う客観的な分析」であるかのような印象を与えるのでやめた方が良いと思う。
例えば欠損値を補う方法もモデル依存であることを強調するべきで、データの数表のイメージでせつめいするべきではない。
例えば欠損値を補う方法もモデル依存であることを強調するべきで、データの数表のイメージでせつめいするべきではない。
黒木玄 Gen Kuroki@genkuroki
#統計 因果推論の解説で分かり難いと感じられるものの典型例は、データの数値の表のイメージを使って説明しようとするもの。
データの数値の表は、変数達の同時確率分布の標本に過ぎず、因果関係の情報を一切持っていないので、そのイメージで因果推論について分かり易く説明するのは苦しい。
データの数値の表は、変数達の同時確率分布の標本に過ぎず、因果関係の情報を一切持っていないので、そのイメージで因果推論について分かり易く説明するのは苦しい。
49
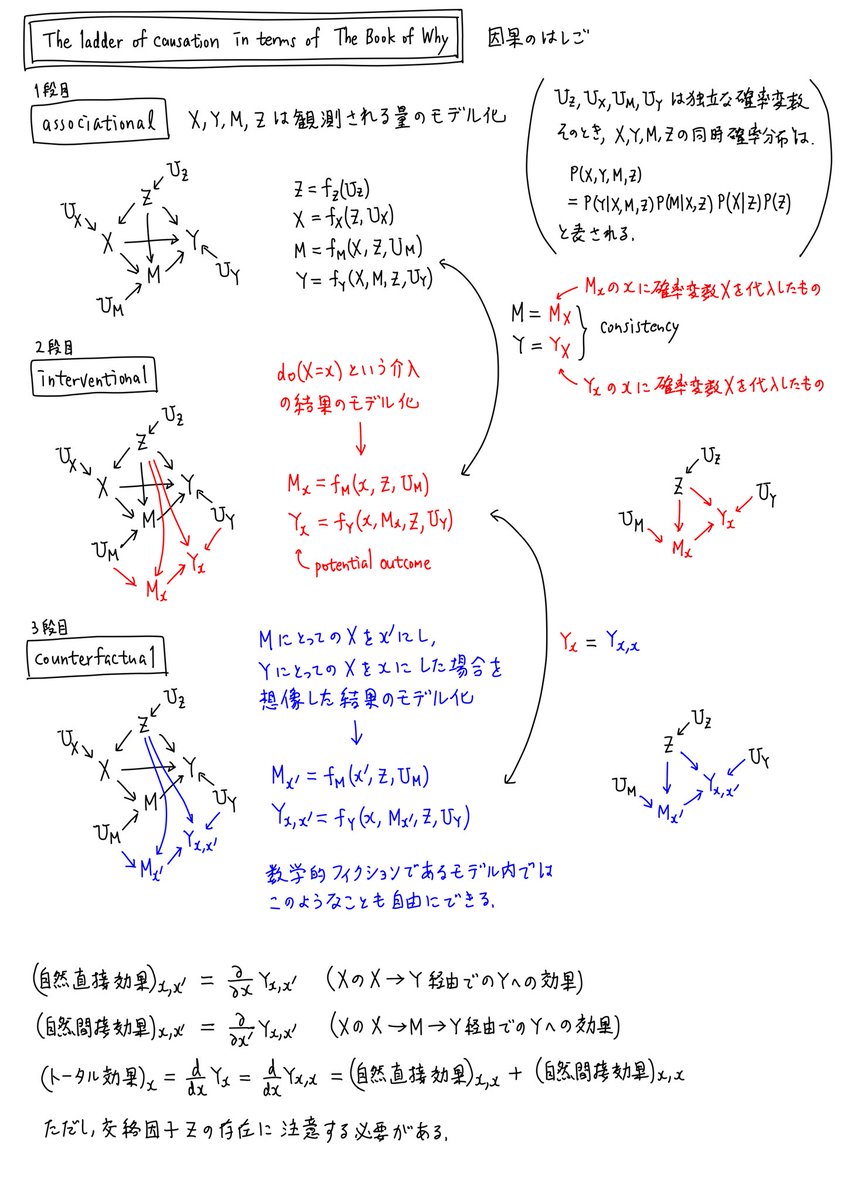
#統計 因果推論関連
50
#統計 因果推論ついて、モデルそのものに基いた理解ではなく、「どの変数で調節するか」のようなスタイルで考えてしまっていると、ベイズ統計の方法で因果効果をどのように扱ったら良いかを難しい問題だと誤解してしまうと思う。
Statistical Rethinkingはベイズ統計で因果推論を行う講義です。
Statistical Rethinkingはベイズ統計で因果推論を行う講義です。
51
#統計 「相関と因果は違う」の一般化の例
xとyの同時分布の密度関数p(x,y)を考えることは、xとyの相関関係を考えることの一般化。
同時分布p(x,y)自体はxとyの間の因果関係の情報を持たない。
p(x,y)の他にx→yやx←yのような因果関係の情報も与えないとモデル内で因果効果を定義できない。
xとyの同時分布の密度関数p(x,y)を考えることは、xとyの相関関係を考えることの一般化。
同時分布p(x,y)自体はxとyの間の因果関係の情報を持たない。
p(x,y)の他にx→yやx←yのような因果関係の情報も与えないとモデル内で因果効果を定義できない。
52
#統計 観察される3変数x,y,zの同時分布p(x,y,z)によるモデル化の場合から話が色々面白くなる。
x→yの因果関係があり、xからyへの因果効果を扱いたいとする。
残りのzとx,yの間の因果関係には様々なパターンがある。
例えば、x→yに追加してx←z→yの因果関係がある場合のzはx→yの交絡因子。続く
x→yの因果関係があり、xからyへの因果効果を扱いたいとする。
残りのzとx,yの間の因果関係には様々なパターンがある。
例えば、x→yに追加してx←z→yの因果関係がある場合のzはx→yの交絡因子。続く
53
#統計 モデル内でのxからyへの因果効果を定義するためには、潜在結果変数
yₓ₌ₐ=(xの原因になる変数達からのxへの影響を廃してxの値をaに設定したときの仮想的なy変数)
が必要になる。潜在結果変数を扱うためにはx,y,zに関するモデルを、yₓ₌ₐ,zに関するモデルに変更する必要がある。続く
yₓ₌ₐ=(xの原因になる変数達からのxへの影響を廃してxの値をaに設定したときの仮想的なy変数)
が必要になる。潜在結果変数を扱うためにはx,y,zに関するモデルを、yₓ₌ₐ,zに関するモデルに変更する必要がある。続く
54
#統計 例えば、x→y, x←z→yという因果関係に対応するx,y,zの同時分布の表示は
p(x,y,z)=p(y|x,z)p(x|z)p(z)
である。zからxへの影響を記述しているp(x|z)を除いてできる
p(yₓ₌ₐ,z)=p(y=yₓ₌ₐ|x=a,z)p(z)
が潜在結果変数yₓ₌ₐと交絡因子zのモデル化の同時確率分布になる。続く
p(x,y,z)=p(y|x,z)p(x|z)p(z)
である。zからxへの影響を記述しているp(x|z)を除いてできる
p(yₓ₌ₐ,z)=p(y=yₓ₌ₐ|x=a,z)p(z)
が潜在結果変数yₓ₌ₐと交絡因子zのモデル化の同時確率分布になる。続く
55
#統計 因果効果の一般的な定義はx=aの値を動かしたときの潜在結果変数yₓ₌ₐへの影響のことである。
平均因果効果はx=aの値を動かしたときの潜在結果変数yₓ₌ₐの期待値への影響だと定義される。
潜在結果変数yₓ₌ₐの定義にはモデルに追加された因果関係の情報が本質的に使われている。続く
平均因果効果はx=aの値を動かしたときの潜在結果変数yₓ₌ₐの期待値への影響だと定義される。
潜在結果変数yₓ₌ₐの定義にはモデルに追加された因果関係の情報が本質的に使われている。続く
56
#統計 例えば、x→y, x←z→yという因果関係に関する潜在結果変数yₓ₌ₐ単体の分布は
p(yₓ₌ₐ)=∫p(y=yₓ₌ₐ|x=a,z)p(z) dz
となり、観察データに関するモデルp(x,y,z)=p(y|x,z)p(x|z)p(z)の部品で表される。続く
p(yₓ₌ₐ)=∫p(y=yₓ₌ₐ|x=a,z)p(z) dz
となり、観察データに関するモデルp(x,y,z)=p(y|x,z)p(x|z)p(z)の部品で表される。続く
57
#統計 最尤法やベイズ法などは観察データに関する同時分布p(x,y,z)の推定法だとみなされる。以上の構成より、p(x,y,z)の推定結果を使えば因果効果の推定も自明に可能。
これは自明だが、因果推論に関するよくある伝統的な解説から「最尤法でもベイズ法でもなんでもよい」までたどり着くことは難しい。
これは自明だが、因果推論に関するよくある伝統的な解説から「最尤法でもベイズ法でもなんでもよい」までたどり着くことは難しい。
58
#統計 Statistical Rethinkingでの因果推論は以上のスタイルになっており、「最尤法でもベイズ法でもなんでもよい」が最初から明らかであり、モデルの推定をStanなどを使って気軽に行う方針なので複雑さが相当に削減されている。
統計モデリングの複雑さに因果関係の情報を追加するだけで終わり!
統計モデリングの複雑さに因果関係の情報を追加するだけで終わり!
59
#統計 以上のスタイルはもっと普及させた方が良い。
ベイズ統計について学ぶときに階層モデルの設計法についても学んだ人達(相当に沢山いる!)は、以上のスタイルであれば非常に小さなコストで因果効果推定(所謂因果推論)についても学ぶことができます。(因果推論の伝統的な解説経由では難しい。)
ベイズ統計について学ぶときに階層モデルの設計法についても学んだ人達(相当に沢山いる!)は、以上のスタイルであれば非常に小さなコストで因果効果推定(所謂因果推論)についても学ぶことができます。(因果推論の伝統的な解説経由では難しい。)
60
#統計 improper事前分布Beta(0, 1)の事後分布でp≤p₀となる確率
cdf(Beta(k, n-k+1), p₀)
は、保守的になるexact版の仮説p≤p₀の片側P値
ccdf(Binomial(n,p₀), k-1)
にぴったり一致します。ベイズとP値がぴったり一致するのはimproper事前分布の場合が多い。
colab.research.google.com/drive/1nkml002…

cdf(Beta(k, n-k+1), p₀)
は、保守的になるexact版の仮説p≤p₀の片側P値
ccdf(Binomial(n,p₀), k-1)
にぴったり一致します。ベイズとP値がぴったり一致するのはimproper事前分布の場合が多い。
colab.research.google.com/drive/1nkml002…
黒木玄 Gen Kuroki@genkuroki
#統計 通常の「仮説p≤p₀の片側P値」のベイズ版は「事後分布でp≤p₀となる確率」です。無情報事前分布の下でそれらは添付画像のようによく一致します。
二項分布モデル程度のシンプルなモデルでベイズと非ベイズを違うものであるかのように語ることは酷くミスリーディングです。
二項分布モデル程度のシンプルなモデルでベイズと非ベイズを違うものであるかのように語ることは酷くミスリーディングです。
61
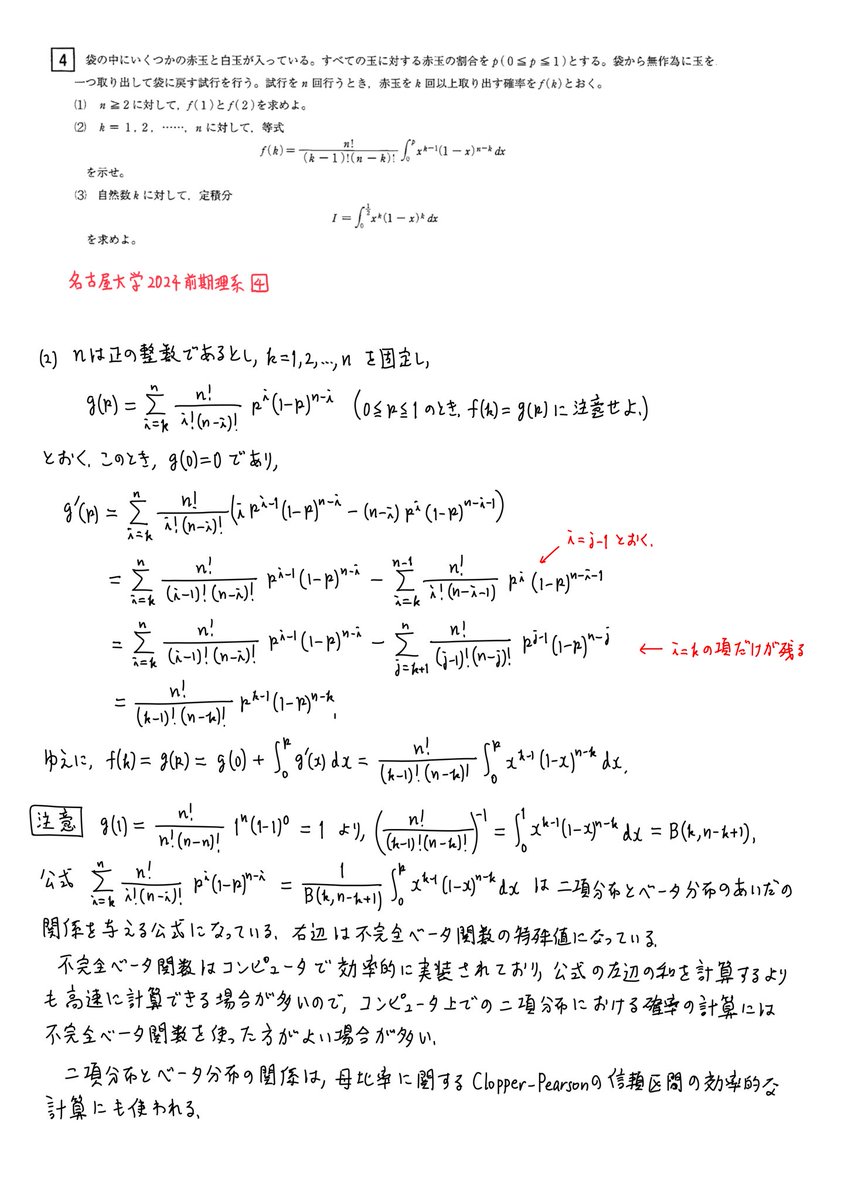
#統計 二項分布モデルでのexactな片側P値と適当なimproper事前分布での事後確率が誤差なしにぴったり一致するという数学的事実は、名古屋大学2024前期理系の入試問題の大問4の(2)で出題されるくらい数学的には優しい話です。
大学生は入学時点で使いこなせて欲しい!😁
大学生は入学時点で使いこなせて欲しい!😁
黒木玄 Gen Kuroki@genkuroki
#統計 名古屋大学2024前期理系大問4の(2)の問題の出し方はちょっと意地悪になっていて、kの関数ではなく、pの関数として扱った方が多分証明は楽です。
繰り返しになりますが、これは、二項分布とベータ分布の関係を与える応用上重要な公式です。
繰り返しになりますが、これは、二項分布とベータ分布の関係を与える応用上重要な公式です。
62
#統計 このように大学入試問題でベイズ法での事後確率と片側P値の一致の証明が出題される時代になっているのに、事後確率を「phc」=「仮説が正しい確率」と呼んで、「P値の代わりにphcを使おう」と提案している(これは実質的に「P値の代わりにP値を使おう」と提案しているのと同じwww)人がいる。
黒木玄 Gen Kuroki@genkuroki
#統計 豊田秀樹さんの『瀕死』本に載っているphc (研究仮説が正しい確率 probability that research hypothesis is correct)の幾つかは所謂「頻度論」的な片側P値によく一致している。
P値を否定してphcを勧める豊田氏は実質的に、P値を否定してP値を勧めていることになります。
余りにもダメすぎ!
P値を否定してphcを勧める豊田氏は実質的に、P値を否定してP値を勧めていることになります。
余りにもダメすぎ!
63
#統計 このスレッドで説明した因果推論の定式化ならば、因果効果の推定を以下の2つのステップに分解できます。
①観察データの数値から同時確率分布p(x,y,z,…)を推定する(統計学や機械学習のあらゆる方法を使える)。
②推定したp(x,y,z,…)と因果関係の記述から潜在結果変数の分布の推定を出す。
①観察データの数値から同時確率分布p(x,y,z,…)を推定する(統計学や機械学習のあらゆる方法を使える)。
②推定したp(x,y,z,…)と因果関係の記述から潜在結果変数の分布の推定を出す。
黒木玄 Gen Kuroki@genkuroki
#統計 「相関と因果は違う」の一般化の例
xとyの同時分布の密度関数p(x,y)を考えることは、xとyの相関関係を考えることの一般化。
同時分布p(x,y)自体はxとyの間の因果関係の情報を持たない。
p(x,y)の他にx→yやx←yのような因果関係の情報も与えないとモデル内で因果効果を定義できない。
xとyの同時分布の密度関数p(x,y)を考えることは、xとyの相関関係を考えることの一般化。
同時分布p(x,y)自体はxとyの間の因果関係の情報を持たない。
p(x,y)の他にx→yやx←yのような因果関係の情報も与えないとモデル内で因果効果を定義できない。
64
#統計 観察データの数値から推定された同時確率分布p(x,y,z,…)は予測分布と呼ばれており、予測分布の精度の大雑把な見積り方は色々あるのですが(AICやWAICは典型的)、因果効果推定で重要なのは潜在結果変数の分布の推定の精度の方なので、その辺についてするべき仕事は沢山残っていると思います。
65
#統計 観察データの生成のされ方に関するモデルから得られる予測分布の精度が高そうなことと、それとは異なる潜在結果変数に関する修正されたモデルから得られる潜在結果に関する予測分布の精度が高そうなことは確かに意味が異なるので、その辺りがどうなっているかに関する理論を作ることが必要です。
66
#統計 ベイズ統計についてよく見るのは以下の悪しき振る舞い。
①事前情報無しだという理由で平坦事前分布の類を採用する。
②事後分布での事後確率をまるでそのまま現実の仕事で使える確率だとみなす。
この場合の事後確率は、多くの場合に実質P値と同類で、場合によっては数値的にほぼ同じです!
①事前情報無しだという理由で平坦事前分布の類を採用する。
②事後分布での事後確率をまるでそのまま現実の仕事で使える確率だとみなす。
この場合の事後確率は、多くの場合に実質P値と同類で、場合によっては数値的にほぼ同じです!
67
#統計 P値についてはASA声明のようにP値の大小をそのまま現実における判断に直結させては行けないと強く繰り返されています。
ところが、ベイズの側では「それ実質P値です!」と言いたくなる事後確率の危険で間違っている使用法を頻繁に見る。
ところが、ベイズの側では「それ実質P値です!」と言いたくなる事後確率の危険で間違っている使用法を頻繁に見る。
68
#統計 例えば、平坦事前分布やそれに近い事前分布を採用しているときに、パラメータθに関するθ≤cの事後確率は、仮説θ≤cの片側P値にほぼ一致する場合が多い。
小さくなって欲しいθ≤cの事後確率が20%なことは、仮説θ≤cの片側P値が20%なのとほぼ同じです!決定的な結果は得られなかったことになる。
小さくなって欲しいθ≤cの事後確率が20%なことは、仮説θ≤cの片側P値が20%なのとほぼ同じです!決定的な結果は得られなかったことになる。
69
#統計 平坦事前分布またはそれに近い事前分布を採用したとき(多くの場合にそうなっている)、ベイズ版の95%信用区間は、実質的に非ベイズの95%信頼区間と同じだとみなせる場合が多いのに、「ベイズ版95%信用区間は真の値を95%の確率で含む」と平気で言えるダメな人達も沢山いる。
70
#統計 Statistical Rethinkingにも書いてあるように、ベイズであろうがなかろうが、区間推定で得られた95%区間に真の値が95%の確率で含まれていると安易に信じるのは酷い誤り。
教科書に、ベイズ版95%信用区間については「95%の確率で真の値を含む」というデタラメが本当に書いてあることが多い。
教科書に、ベイズ版95%信用区間については「95%の確率で真の値を含む」というデタラメが本当に書いてあることが多い。
黒木玄 Gen Kuroki@genkuroki
#統計 Statistical Rethinking 2nd ed. p.58にある以下のリンク先の説明をChatGPTさんに色々教えながら翻訳させてみました。
ベイズであろうがなかろうが、区間推定で得られた95%区間に真の値が95%の確率や割合で含まれていると安易に信じるのは酷い誤り。
ベイズであろうがなかろうが、区間推定で得られた95%区間に真の値が95%の確率や割合で含まれていると安易に信じるのは酷い誤り。
71
#統計 補足
improper事前分布Beta(0,0)は対数オッズ座標x=log(p/(1-p))での一様分布。
仮説p≤p₀の片側検定と相性が良いimproper事前分布Beta(0,1)は対数座標x=log pでの一様分布。
仮説p≥p₀の片側検定と相性が良いimproper事前分布Beta(1,0)は座標x=log(1-p)での一様分布。
improper事前分布Beta(0,0)は対数オッズ座標x=log(p/(1-p))での一様分布。
仮説p≤p₀の片側検定と相性が良いimproper事前分布Beta(0,1)は対数座標x=log pでの一様分布。
仮説p≥p₀の片側検定と相性が良いimproper事前分布Beta(1,0)は座標x=log(1-p)での一様分布。
黒木玄 Gen Kuroki@genkuroki
#統計 improper事前分布Beta(0, 1)の事後分布でp≤p₀となる確率
cdf(Beta(k, n-k+1), p₀)
は、保守的になるexact版の仮説p≤p₀の片側P値
ccdf(Binomial(n,p₀), k-1)
にぴったり一致します。ベイズとP値がぴったり一致するのはimproper事前分布の場合が多い。
colab.research.google.com/drive/1nkml002…
cdf(Beta(k, n-k+1), p₀)
は、保守的になるexact版の仮説p≤p₀の片側P値
ccdf(Binomial(n,p₀), k-1)
にぴったり一致します。ベイズとP値がぴったり一致するのはimproper事前分布の場合が多い。
colab.research.google.com/drive/1nkml002…
72
#統計 分岐スレッド
P値についてもベイズ統計についても伝統的によく見る解説は大体において不適切です。
そういう伝統的な不適切解説の内容を信じて「P値はダメだ」「ベイズ統計はダメだ」のように言ってしまうのは恥ずかしいこと扱いされるべきだと思います。
P値についてもベイズ統計についても伝統的によく見る解説は大体において不適切です。
そういう伝統的な不適切解説の内容を信じて「P値はダメだ」「ベイズ統計はダメだ」のように言ってしまうのは恥ずかしいこと扱いされるべきだと思います。
黒木玄 Gen Kuroki@genkuroki
@LnN5Rp0GT266712 #統計 ベイズ統計も非常に有用な道具です。
一方、ベイズ統計に関する伝統的な解説(多くの場合に不適切)の意味での「ベイズ統計」がダメなものに見えてしまうというパターンはありがちだと思います。伝統的なバカをバカだと見抜けない人はそうなりがち。
一方、ベイズ統計に関する伝統的な解説(多くの場合に不適切)の意味での「ベイズ統計」がダメなものに見えてしまうというパターンはありがちだと思います。伝統的なバカをバカだと見抜けない人はそうなりがち。
73
#統計 関連
ベイズ的A/Bテストの推奨者達が多くの場合に実践的に有害なデタラメを述べていることを指摘している記事。
Bayesian A/B Testing Falls Short by Allon Korem | CEO, Bell Statistics medium.com/data-science-c…
ベイズ的A/Bテストの推奨者達が多くの場合に実践的に有害なデタラメを述べていることを指摘している記事。
Bayesian A/B Testing Falls Short by Allon Korem | CEO, Bell Statistics medium.com/data-science-c…