#統計 「正規分布でなければt検定は使えない」というデマは、にせマナー講師的な制限のせいで方法選択が歪んでいる問題の1つ。...

黒木玄 Gen Kuroki@genkuroki
76 views
May 30, 2025
~3 min read
Advertisement
1
#統計 「正規分布でなければt検定は使えない」というデマは、にせマナー講師的な制限のせいで方法選択が歪んでいる問題の1つ。
別のにせマナー講師的言説で有名なのは、「期待度数が5未満ならばχ²検定ではなく、Fisher検定を使わなければいけない」です。これも結構猛威をふるっている感じ。続く
別のにせマナー講師的言説で有名なのは、「期待度数が5未満ならばχ²検定ではなく、Fisher検定を使わなければいけない」です。これも結構猛威をふるっている感じ。続く
黒木玄 Gen Kuroki@genkuroki
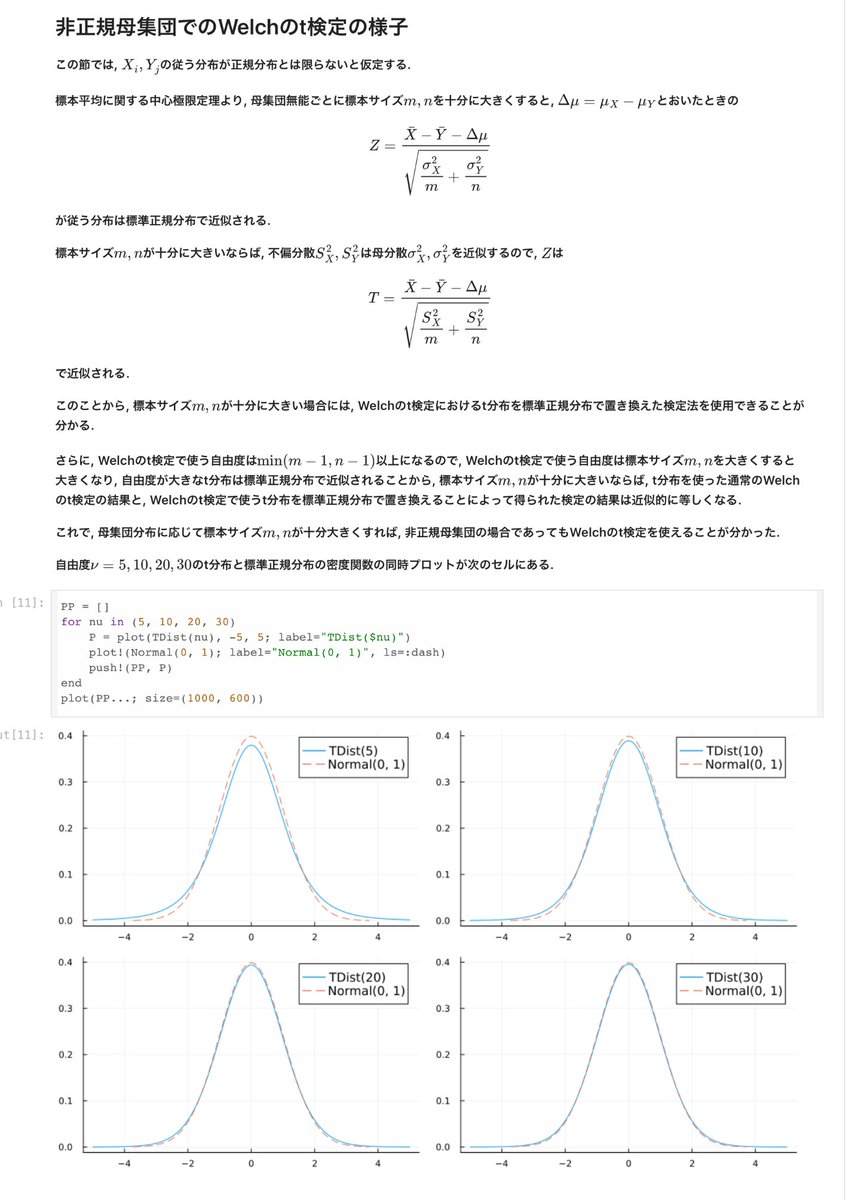
#統計 Welchのt検定が非正規母集団であっても結構多くの場合に使える理由について理解していない人が今でも多いように感じたので簡単な解説を書きました。
中心極限定理が本質的です。
github.com/genkuroki/publ…
(Welchのt検定の導出の概略も解説しています)
中心極限定理が本質的です。
github.com/genkuroki/publ…
(Welchのt検定の導出の概略も解説しています)
2
#統計 2×2の分割表での検定法(母比率の違いに関する検定法)について気になっている問題は2つ。
(1) 「期待度数が5未満ならばχ²検定ではなく、Fisher検定を使うべきである」というデマの普及
(2) 検定仮説を「母比率は等しい」から「母比率の違いはθ=aである」に拡張しない悪しき流儀の普及
(1) 「期待度数が5未満ならばχ²検定ではなく、Fisher検定を使うべきである」というデマの普及
(2) 検定仮説を「母比率は等しい」から「母比率の違いはθ=aである」に拡張しない悪しき流儀の普及
3
#統計 (2)補足
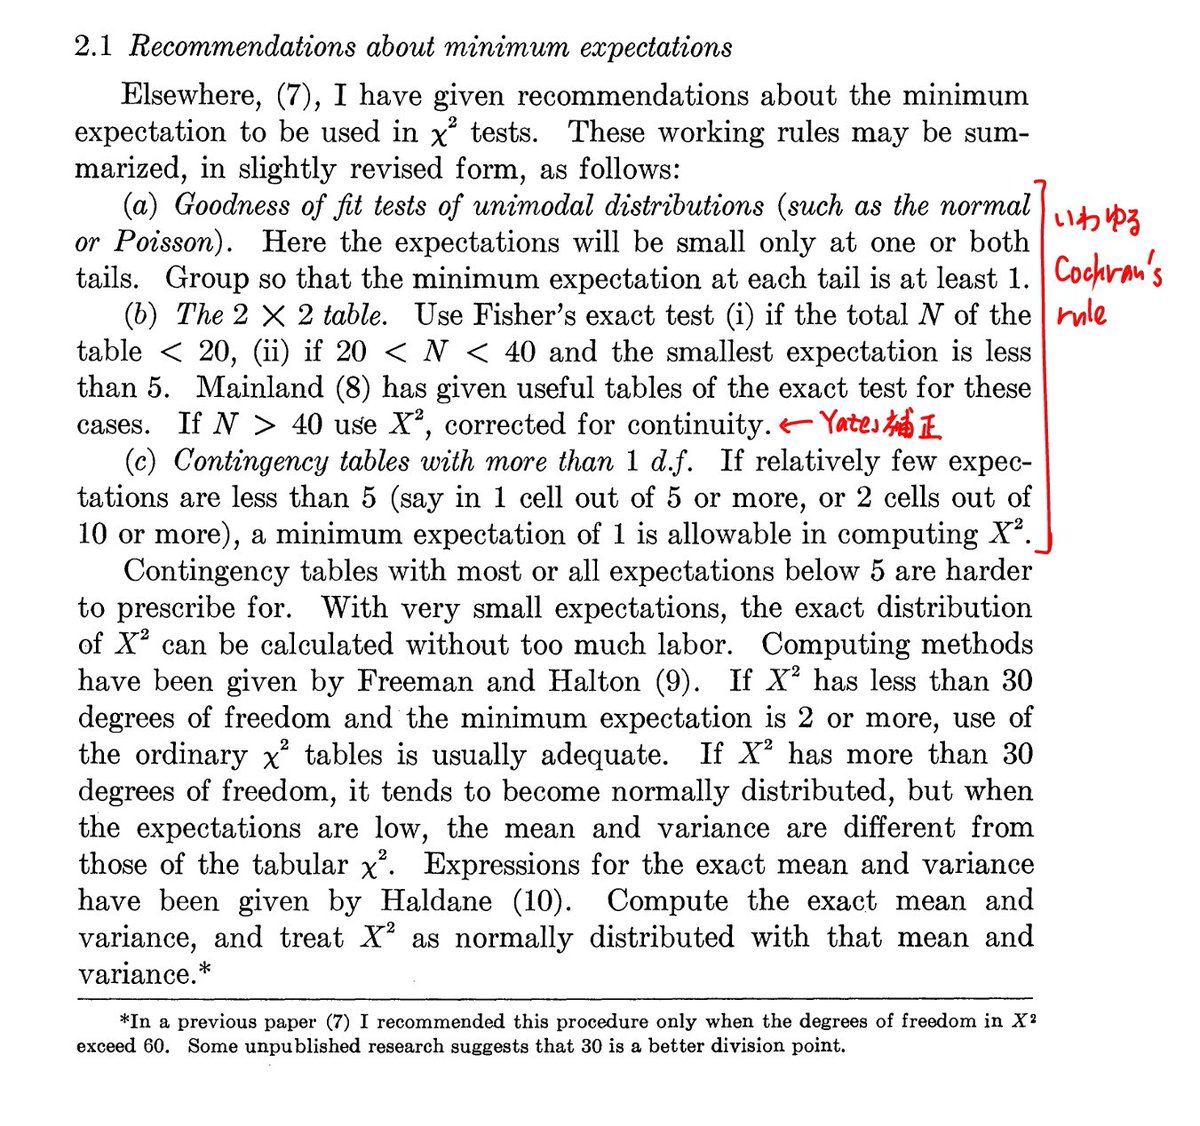
2つの母比率をp,qと書くとき、検定仮説をp=qに固定してしまうと、違いの程度を定量化できなくなります。検定仮説について以下のような拡張を行いたい。具体的数値aに関する
* 仮説p-q=a
* 仮説p/q=a
* オッズ比OR=(p/(1-p))/(q/(q-q))に関する仮説OR=a
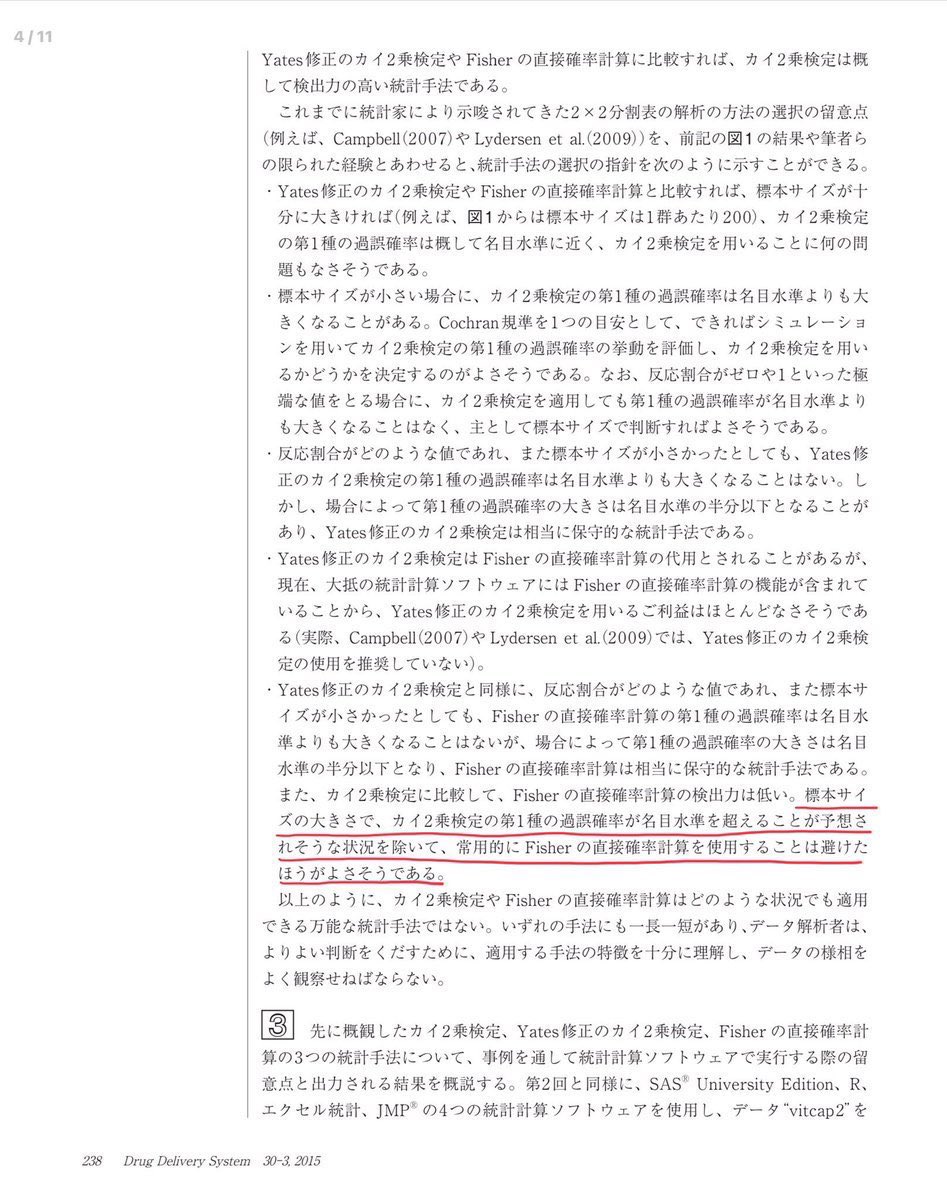
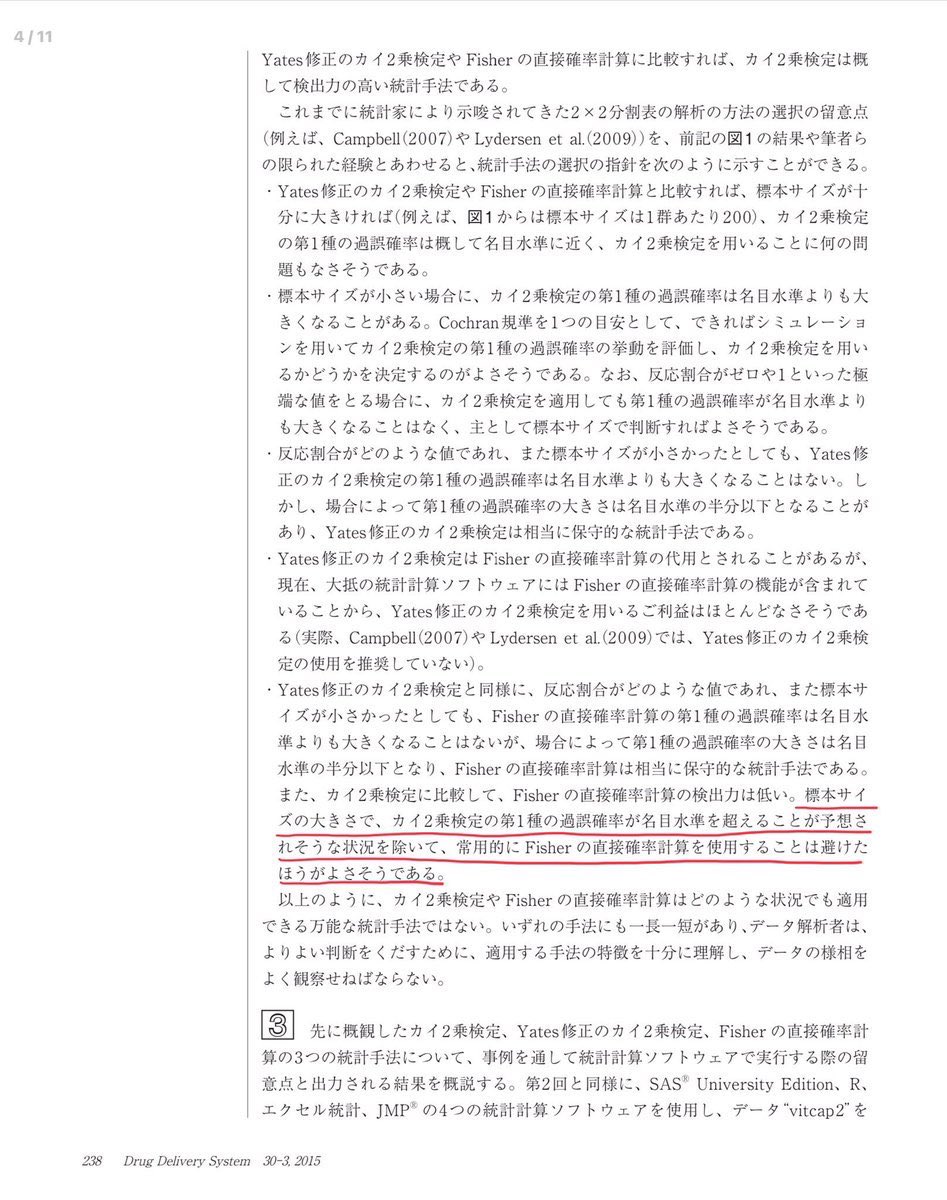
2つの母比率をp,qと書くとき、検定仮説をp=qに固定してしまうと、違いの程度を定量化できなくなります。検定仮説について以下のような拡張を行いたい。具体的数値aに関する
* 仮説p-q=a
* 仮説p/q=a
* オッズ比OR=(p/(1-p))/(q/(q-q))に関する仮説OR=a
4
#統計 まず、
(1) 「期待度数が5未満ならばχ²検定ではなく、Fisher検定を使うべきである」というデマの普及
について説明します。このデマは「コクランルール」と呼ばれ、広く普及しており、非常に残念なことに標準的な考え方扱いされています。続く
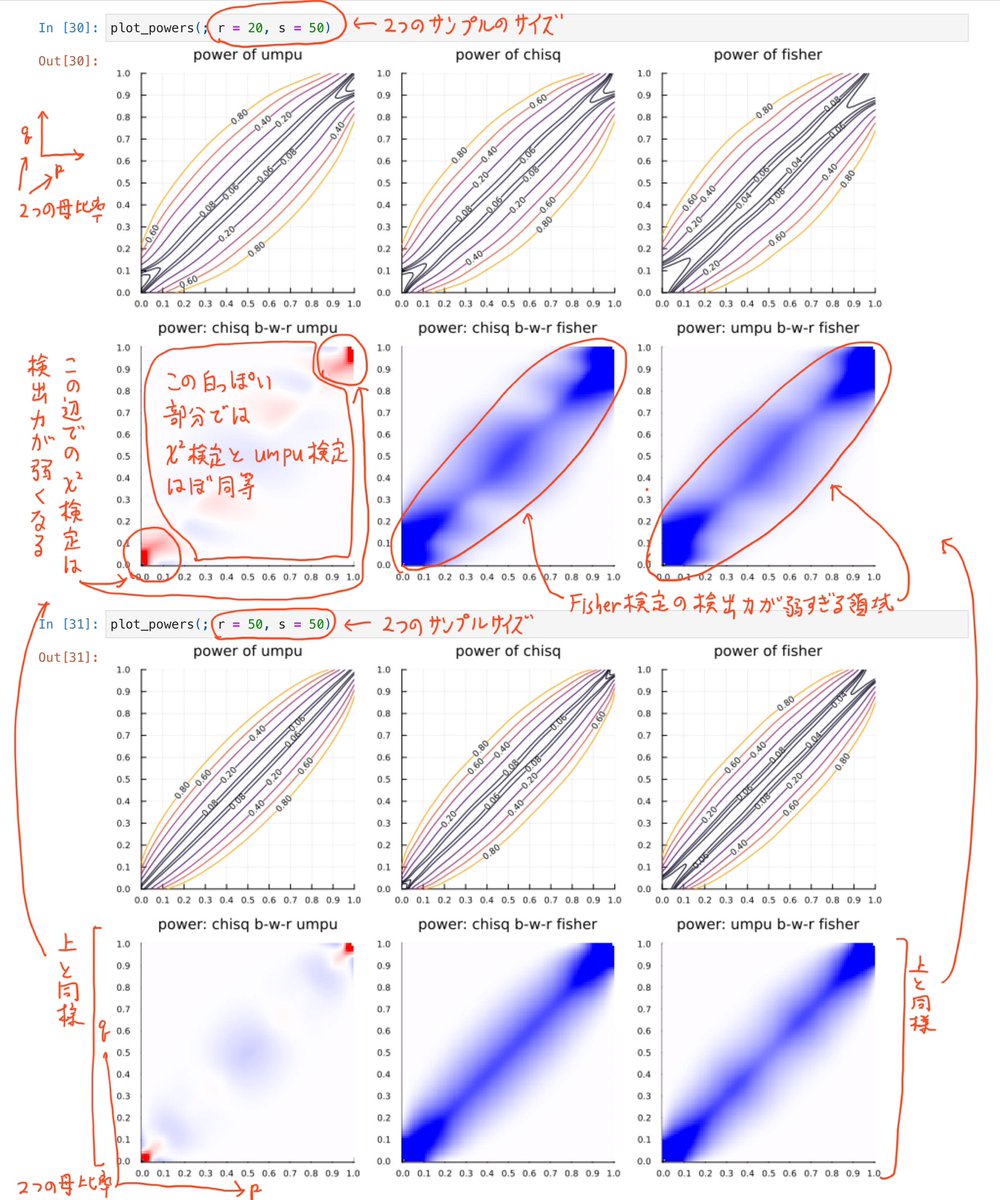
(1) 「期待度数が5未満ならばχ²検定ではなく、Fisher検定を使うべきである」というデマの普及
について説明します。このデマは「コクランルール」と呼ばれ、広く普及しており、非常に残念なことに標準的な考え方扱いされています。続く
5
#統計 しかし、小標本でのFisher検定には「保守的過ぎる」(P値が大きくなり過ぎる)という欠点があり、χ²検定とFisher検定の選択はトレードオフの問題になるので、小標本ではFisher検定の側を必ず選択しなければいけないという考え方は明瞭に間違っています。
6
#統計 トレードオフに基く正しい判断の仕方は以下の通り。
* 小標本での検出力の低下を受け入れて、αエラー率を確実にα以下にしたいならば、Fisher検定を使う。
* αエラー率が近似的にはαになるが、αを少し超える場合が出て来ることを受け入れて、検出力にも気を使いたいならばχ²検定を使う。
* 小標本での検出力の低下を受け入れて、αエラー率を確実にα以下にしたいならば、Fisher検定を使う。
* αエラー率が近似的にはαになるが、αを少し超える場合が出て来ることを受け入れて、検出力にも気を使いたいならばχ²検定を使う。
7
#統計 小標本であればあるほど、Fisher検定とχ²検定の違いは大きくなり、Fisher検定の過剰に保守的な傾向が強くなるので、小標本の場合には特にFisher検定の欠点の側も気にする必要があります。
「小標本ならば常にFisher検定の側を使え」と教えて来た人達は間違った教育をして来たことになります。
「小標本ならば常にFisher検定の側を使え」と教えて来た人達は間違った教育をして来たことになります。
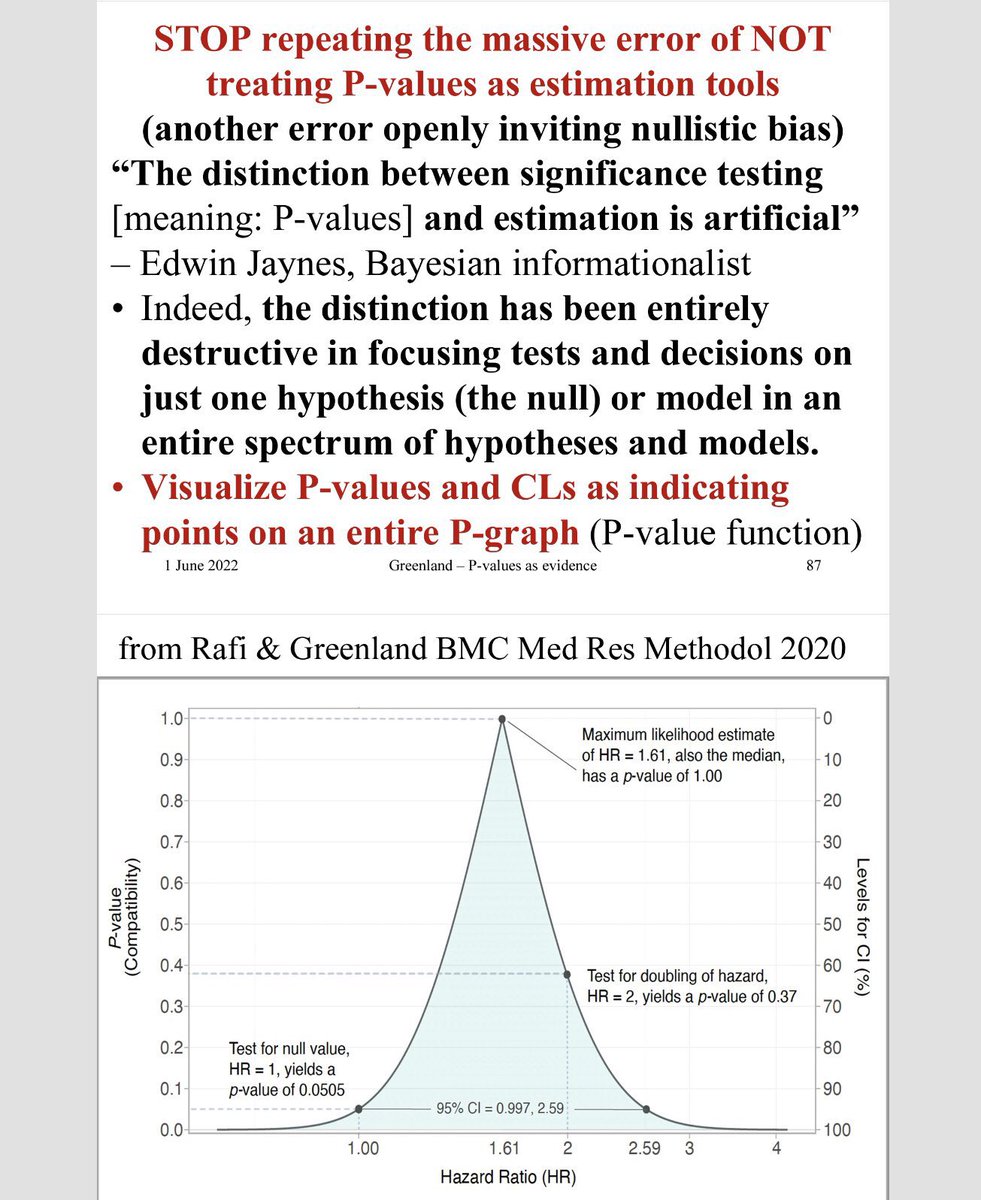
8
#統計 理解不足を認めずに、論理と証拠ではなく、伝統的な権威に従う人達は、以上の指摘を苦々しく感じ、無視したいと感じるでしょうが、そのように感じている時点で、あなたは非科学的な考え方をしている人になってしまっています。
科学を大事にしたいなら、誤りを認めることから出発するべき。続く
科学を大事にしたいなら、誤りを認めることから出発するべき。続く
9
#統計 Fisher検定が小標本で過剰に保守的になること(P値が大きくなり過ぎること)は、コンピュータシミュレーションによって誰でも簡単に確認できます。
①テストサンプルをランダムに大量に生成してP値を計算する。
②P値≤αとなる割合を計算する。
たったこれだけ。誰でもできる。続く
①テストサンプルをランダムに大量に生成してP値を計算する。
②P値≤αとなる割合を計算する。
たったこれだけ。誰でもできる。続く
10
#統計 添付画像は、(a,c)をBin(6,0.25)×Bin(8,0.25)に従う乱数とし、b=6-a, d=8-cとして、分割表のデータ
a b
c d
をランダムに生成したときの、P値≤αとなる確率のグラフです。このとき分割表の期待値は
1.5 4.5
2.0 6.0
で5未満の値が3つもある。続く
github.com/genkuroki/publ…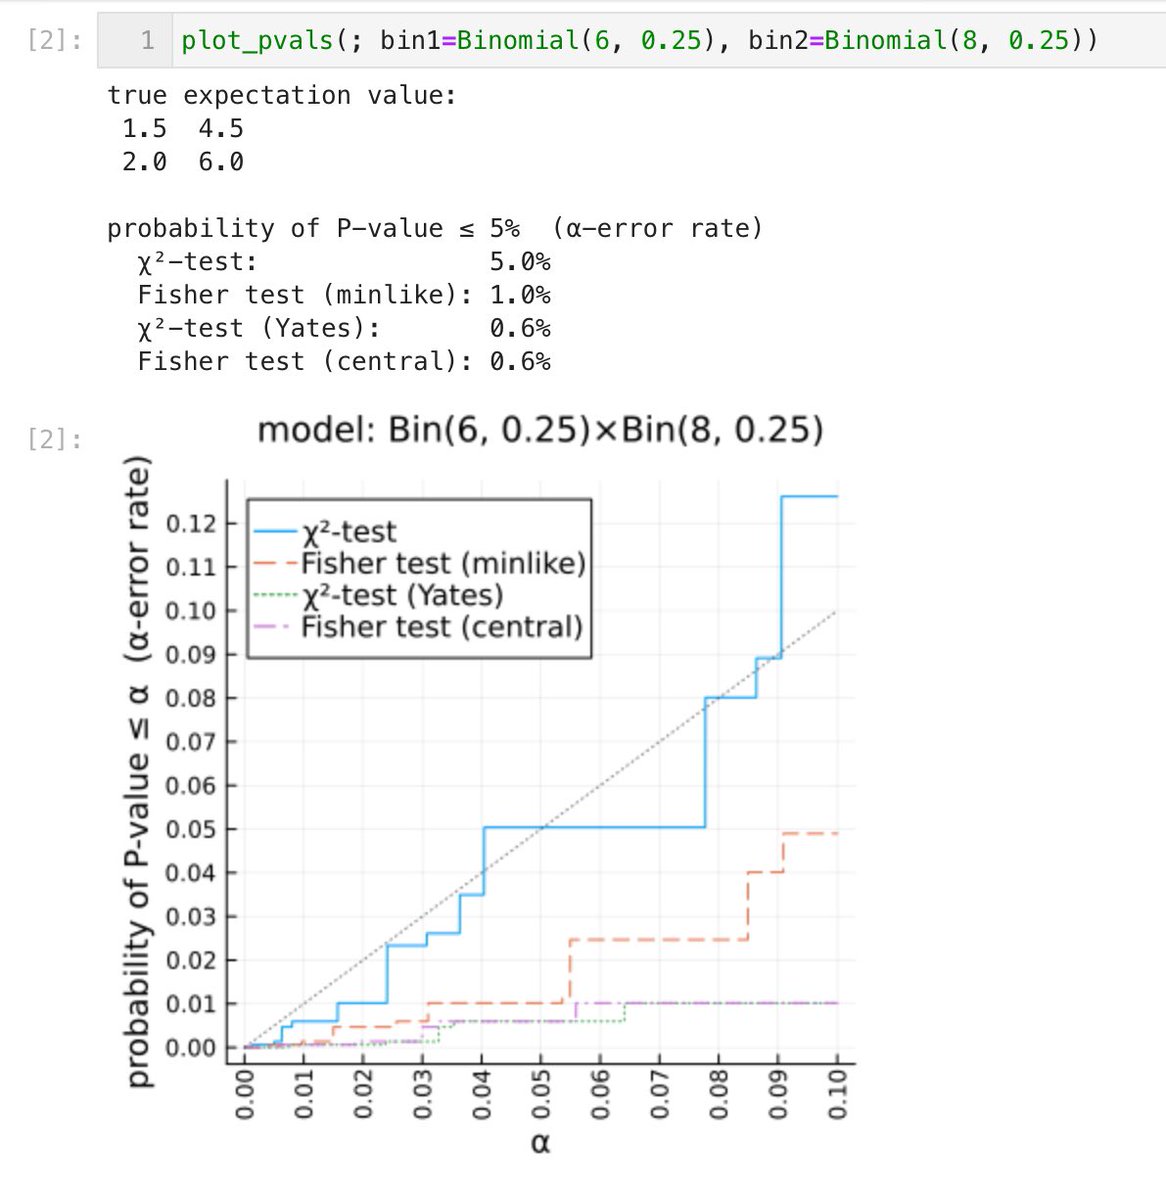
a b
c d
をランダムに生成したときの、P値≤αとなる確率のグラフです。このとき分割表の期待値は
1.5 4.5
2.0 6.0
で5未満の値が3つもある。続く
github.com/genkuroki/publ…
11
#統計 P値は4種類の方法で計算しました。
* 補正無しχ²検定
* Fisher検定(minlike法、Rのfisher.testの方法)
* Yatesの連続補正版のχ²検定
* Fisher検定(central法、片側確率の2倍でP値を計算)
グラフは「P値≤αとなる確率」のグラフです。続く
github.com/genkuroki/publ…
* 補正無しχ²検定
* Fisher検定(minlike法、Rのfisher.testの方法)
* Yatesの連続補正版のχ²検定
* Fisher検定(central法、片側確率の2倍でP値を計算)
グラフは「P値≤αとなる確率」のグラフです。続く
github.com/genkuroki/publ…
12
#統計 Bin(6, 0.25)×Bin(8, 0.25)は2つの母比率が0.25で等しい場合なので、
* P値≤αとなる確率はα以下であって欲しい
という保守的な要求と、
* P値≤αとなる確率はαで近似されていて欲しい
という検出力も気にする要求の2通りの要求が考えられます。
github.com/genkuroki/publ…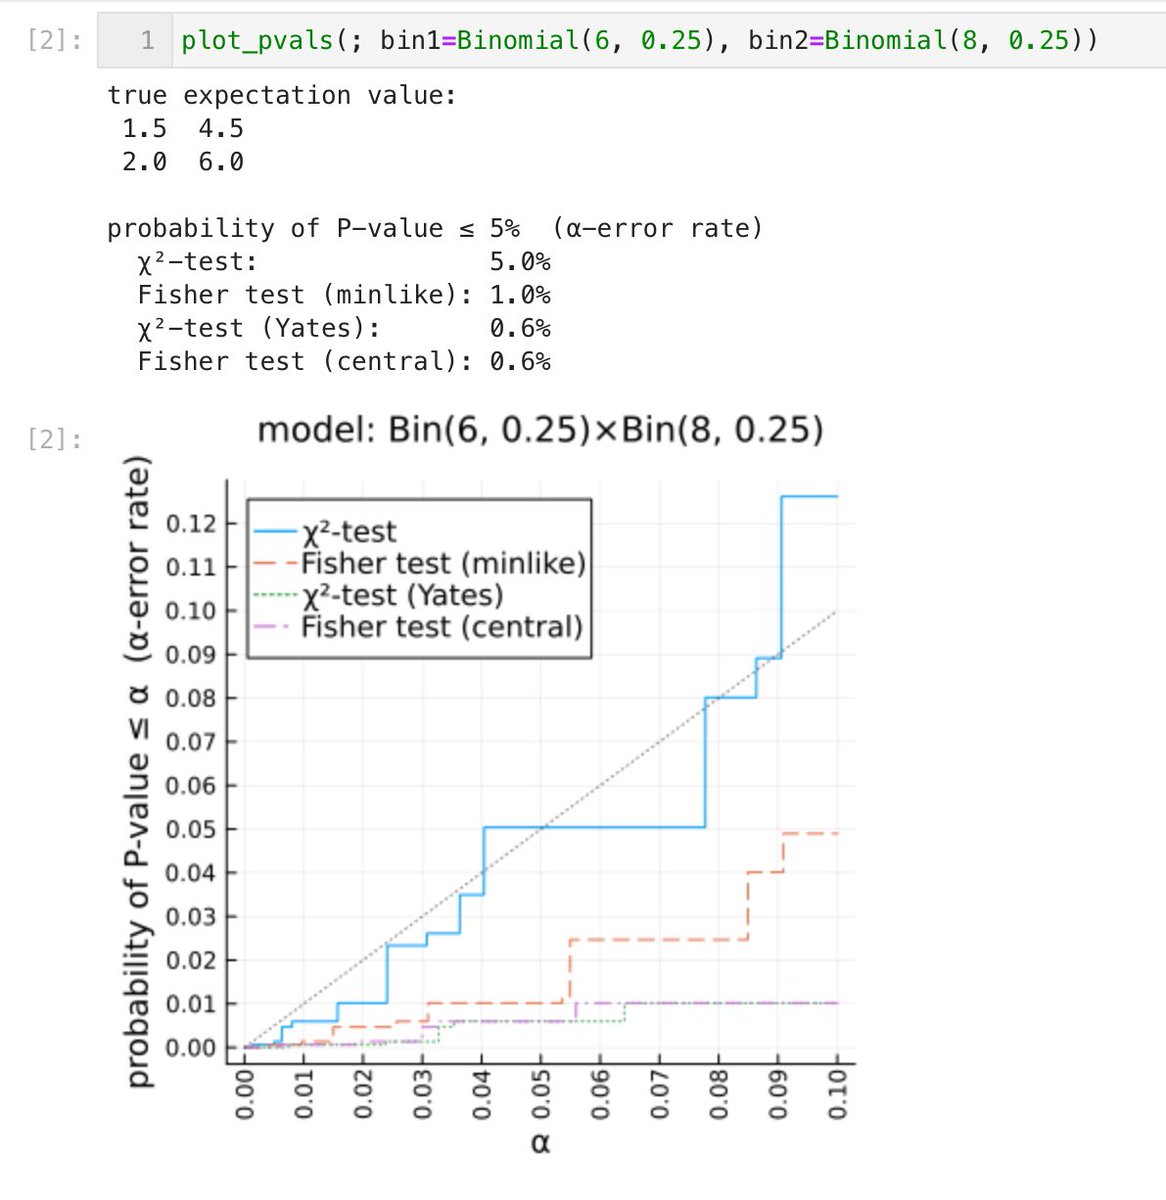
* P値≤αとなる確率はα以下であって欲しい
という保守的な要求と、
* P値≤αとなる確率はαで近似されていて欲しい
という検出力も気にする要求の2通りの要求が考えられます。
github.com/genkuroki/publ…
13
#統計 保守的な要求は、Fisher検定(minlike)とFisher検定(central)では常に満たされていることを数学的に容易に証明できます。
Yates版のχ²検定は保守的度合いが強いFisher検定(central)の良い近似になっているので、実践的には保守的要求を満たすと考えて良いです。続く
github.com/genkuroki/publ…
Yates版のχ²検定は保守的度合いが強いFisher検定(central)の良い近似になっているので、実践的には保守的要求を満たすと考えて良いです。続く
github.com/genkuroki/publ…
14
#統計 数値実験を沢山すれば、補正無しのχ²検定は「帰無仮説下のモデルの確率分布についてP値≤αとなる確率はαで近似されて欲しい」という要求をかなりよく満たしていることが分かります。
ただし、P値≤αとなる確率のグラフが45度線を上側に超える部分も生じてしまいます。
github.com/genkuroki/publ…
ただし、P値≤αとなる確率のグラフが45度線を上側に超える部分も生じてしまいます。
github.com/genkuroki/publ…
15
#統計 印象的なのは、Fisher検定達とYates版χ²検定が小標本で過剰に保守的なことです。添付画像の場合にそれらは、P値≤5%となる確率が、好ましい5%よりも大幅に小さい1%や0.6%になってしまっています。続く
github.com/genkuroki/publ…
github.com/genkuroki/publ…
16
#統計 添付画像は、帰無仮説が満たされていない
Bin(6,0.25)×Bin(8,0.8)
の場合。母比率が0.25と0.8で大幅に違う。
P値≤5%となる確率(検出力)は大きい方がよい。補正無しχ²検定では63%なのに、Fisher検定達とYates版χ²検定では40%未満になっています。
github.com/genkuroki/publ…
Bin(6,0.25)×Bin(8,0.8)
の場合。母比率が0.25と0.8で大幅に違う。
P値≤5%となる確率(検出力)は大きい方がよい。補正無しχ²検定では63%なのに、Fisher検定達とYates版χ²検定では40%未満になっています。
github.com/genkuroki/publ…
17
#統計 このように、小標本においては、Fisher検定達やその保守的な側の良い近似になっているYatesの連続性補正版χ²検定は、補正無しχ²検定との比較で検出力が大幅に低下するという欠点を持ちます。
この事実は古くから知られており、繰り返し指摘されて来ました。続く
github.com/genkuroki/publ…
この事実は古くから知られており、繰り返し指摘されて来ました。続く
github.com/genkuroki/publ…
18
#統計 Fisher検定は、帰無仮説下のモデルの確率分布Bin(m,q)×Bin(n,q)そのものでの正確な確率を計算する方法ではありません。マージンをすべて固定して得られるその条件付き確率分布(超幾何分布になる)における確率を計算する方法になっています。続く
19
#統計 一般に、離散分布モデルにおいて確率を正確に計算することによって構成されたP値は、出て来る確率の値の離散性によって、過剰に大きな値になり易い。
Fisher検定では条件付き確率分布への移行で可能な場合の数が大幅に減り、その問題が悪化することになります。続く
Fisher検定では条件付き確率分布への移行で可能な場合の数が大幅に減り、その問題が悪化することになります。続く
20
#統計 補正無しのχ²検定ではその問題が大幅に緩和されており、帰無仮説下のモデルの確率分布でP値≤αとなる確率はαでうまいこと近似されるようになっています。
ただし、その確率がαを少し超える場合が出て来ることは受け入れる必要がある。続く
ただし、その確率がαを少し超える場合が出て来ることは受け入れる必要がある。続く
21
#統計 現代においてはコンピュータ資源が十分に使えるので、補正無しのχ²検定の利点を捨てて、特に保守的な片側確率の2倍版のFisher検定の良い近似になるYatesの連続性補正を使う意味はないと思います。そうするくらいなら最初から片側確率の2倍版のFisher検定を使えばよい。
22
#統計 Fisher検定達やYates版χ²検定の過剰に保守的な傾向は標本サイズを結構大きくしても残ります。
添付画像は帰無仮説を満たすBin(120,0.25)×Bin(160,0.25)の場合。P値≤αとなる確率のグラフは45度線に近い方がよいのだが、Fisher検定達やYates版χ²検定は45度線より下。
github.com/genkuroki/publ…
添付画像は帰無仮説を満たすBin(120,0.25)×Bin(160,0.25)の場合。P値≤αとなる確率のグラフは45度線に近い方がよいのだが、Fisher検定達やYates版χ²検定は45度線より下。
github.com/genkuroki/publ…
23
#統計 帰無仮説を満たさないBin(120, 0.25)×Bin(160,0.38)の場合の検出力でも差がグラフで容易に確認できます。
(((まあこの程度の違いなら気にする必要はないとおもいますが)))
github.com/genkuroki/publ…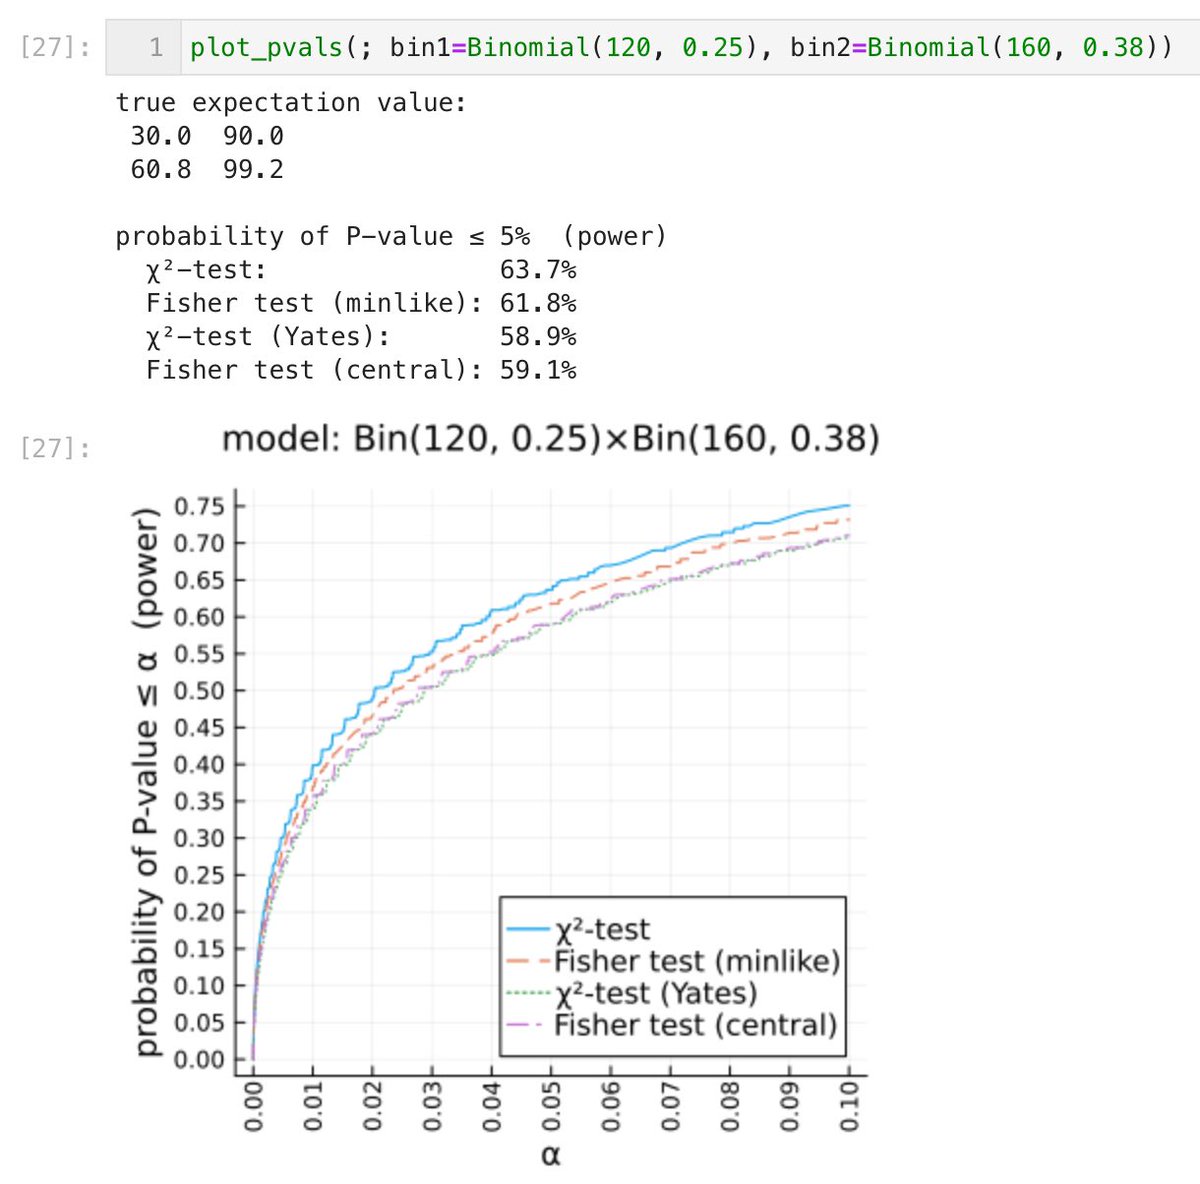
(((まあこの程度の違いなら気にする必要はないとおもいますが)))
github.com/genkuroki/publ…
24
#統計 帰無仮説を満たすBin(120,0.025)×Bin(160,0.025)の場合。分割表の期待値は
3 117
4 156
でコクランルールならχ²検定の使用が(不当にも)禁止される場合。
やはり、Fisher検定達とYates版χ²検定の過剰な保守性が目立ちます。
github.com/genkuroki/publ…
3 117
4 156
でコクランルールならχ²検定の使用が(不当にも)禁止される場合。
やはり、Fisher検定達とYates版χ²検定の過剰な保守性が目立ちます。
github.com/genkuroki/publ…
25
#統計 帰無仮説を満たさないBin(120,0.025)×Bin(160, 0.090)の場合。Fisher検定達とYates版χ²検定の過剰な保守性による検出力低下が目立つ。
この場合にはYatesの連続補正版のχ²検定の検出力低下が著しい。やはり、Yatesの連続補正版のχ²検定は使わない方がよいだろう。
github.com/genkuroki/publ…
この場合にはYatesの連続補正版のχ²検定の検出力低下が著しい。やはり、Yatesの連続補正版のχ²検定は使わない方がよいだろう。
github.com/genkuroki/publ…
26
#統計 「期待度数が5未満ならばχ²検定を使うな」というルールはよく「コクランルール」と呼ばれており、Cochran (1954)) scholar.google.co.jp/scholar?cluste… がよく引用されています。しかし、その論文でCochran先生自身はそのルールは過剰に保守的過ぎると正しい意見を述べています。


黒木玄 Gen Kuroki@genkuroki
#統計 所謂コクランルールの正当化のために常に引用されている論文
scholar.google.co.jp/scholar?cluste…
Cochran (1954)
はその所謂コクランルールに関する十分な根拠を与えていません。
コクラン先生自身は過剰に保守的だと思っていると断っています。
scholar.google.co.jp/scholar?cluste…
Cochran (1954)
はその所謂コクランルールに関する十分な根拠を与えていません。
コクラン先生自身は過剰に保守的だと思っていると断っています。
27
#統計 つまり、Cochran (1954)) scholar.google.co.jp/scholar?cluste… を引用しながら、「期待度数が5未満ならばχ²検定を使うな」というルールを「コクランルール」と呼ぶ輩は、コクラン生成自身が「過剰に保守的」と評しているルールにコクラン生成の名前を付けていることになります。
これは酷いと思います。
これは酷いと思います。
黒木玄 Gen Kuroki@genkuroki
#統計 所謂コクランルールの正当化のために常に引用されている論文
scholar.google.co.jp/scholar?cluste…
Cochran (1954)
はその所謂コクランルールに関する十分な根拠を与えていません。
コクラン先生自身は過剰に保守的だと思っていると断っています。
scholar.google.co.jp/scholar?cluste…
Cochran (1954)
はその所謂コクランルールに関する十分な根拠を与えていません。
コクラン先生自身は過剰に保守的だと思っていると断っています。
28
#統計 関連スレッド
黒木玄 Gen Kuroki@genkuroki
厳密性にこだわるあまり、
実践的には無用に厳しい制限
を付けて、
優秀で忙しい人達に無駄に時間を使わせた
上に、
検出力を大幅に下げる害悪
をもたらせていることの例として、分割表の独立性に関するPearsonのχ²検定に関する
「コクランの規則」=「コクランルール」
があります。
実践的には無用に厳しい制限
を付けて、
優秀で忙しい人達に無駄に時間を使わせた
上に、
検出力を大幅に下げる害悪
をもたらせていることの例として、分割表の独立性に関するPearsonのχ²検定に関する
「コクランの規則」=「コクランルール」
があります。
29
#統計 Haviland 1990では片側確率の2倍版のFisher検定を近似するYatesの連続補正版のχ²検定の過剰な保守性を指摘しているのですが、それに対する批判が教科書を読めていないレベルで間違っていたという話については以下のリンク先を参照。
そういうレベルの批判は編集者レベルでブロックして欲しい。

そういうレベルの批判は編集者レベルでブロックして欲しい。
黒木玄 Gen Kuroki@genkuroki
#統計 Statistics in Medicine twilog.togetter.com/genkuroki/sear… ネタの追加。
europepmc.org/article/MED/15…
Peritz, E. 1992, Letter to the editor
これはHaviland 1990の内容が間違っているという主旨のデタラメな内容のレター。よく掲載したなという感じの内容。Havilandさんのreplyの方が長い。
europepmc.org/article/MED/15…
Peritz, E. 1992, Letter to the editor
これはHaviland 1990の内容が間違っているという主旨のデタラメな内容のレター。よく掲載したなという感じの内容。Havilandさんのreplyの方が長い。
30
#統計 Fisher検定にも欠点があることを
jstage.jst.go.jp/article/dds/30…
連載 第3回
医学データの統計解析の基本 2つの割合の比較
朝倉こう子・濱﨑俊光
も指摘しています。こういう文献で学ぶ人が増えて、伝統的な誤り(所謂「コクランルール」のこと)を訂正して行くようになると良いと思います。
jstage.jst.go.jp/article/dds/30…
連載 第3回
医学データの統計解析の基本 2つの割合の比較
朝倉こう子・濱﨑俊光
も指摘しています。こういう文献で学ぶ人が増えて、伝統的な誤り(所謂「コクランルール」のこと)を訂正して行くようになると良いと思います。
黒木玄 Gen Kuroki@genkuroki
#統計 (連続性補正無し)χ²検定との比較でFisher検定を無条件で勧めることが誤りであることについては、例えば、日本語で書かれたものには
連載 第3回
医学データの統計解析の基本 2つの割合の比較
朝倉こう子・濱﨑俊光
jstage.jst.go.jp/article/dds/30…
があります。
連載 第3回
医学データの統計解析の基本 2つの割合の比較
朝倉こう子・濱﨑俊光
jstage.jst.go.jp/article/dds/30…
があります。
31
#統計 「差がない」や「効果なし」を意味する帰無仮説(ゼロ仮説)のみに関する検定法は、違いや効果の大きさの指標パラメータの値に関する仮説の検定法に拡張するべきだという(2)の論点については例えば以下のリンク先を参照。
黒木玄 Gen Kuroki@genkuroki
#統計 「検定から推定へ」の好ましいスローガンに従うためには、どのパラメータを扱っているのか決まっていない検定法については、あるパラメータを扱うように拡張したものをきちんと扱うのが良いと思います。複数の有力な拡張があるなら全部実装して解説する。
32
#統計 まとめ
* 「期待度数の中に5未満のものがあればχ²検定ではなくFisher検定を使うべきである」という考え方は間違っている。方法の選択はトレードオフで決めるべき。
* 2×2の分割表では、ゼロ仮説だけではなく、リスク差、リスク比、オッズ比の値に関する一般的な検定仮説のP値を扱うべき。
* 「期待度数の中に5未満のものがあればχ²検定ではなくFisher検定を使うべきである」という考え方は間違っている。方法の選択はトレードオフで決めるべき。
* 2×2の分割表では、ゼロ仮説だけではなく、リスク差、リスク比、オッズ比の値に関する一般的な検定仮説のP値を扱うべき。
33
#統計 追加
この話は、よくある統計学警察による「〇〇だと誤用になる」の類の指摘ではなく、「5未満の期待度数があるならばχ²検定を使ってはいけない」という「〇〇だと誤用になる」という指摘の側を否定している。
統計学ユーザー教育におけるにせマナー講師的言説の否定になっている。

この話は、よくある統計学警察による「〇〇だと誤用になる」の類の指摘ではなく、「5未満の期待度数があるならばχ²検定を使ってはいけない」という「〇〇だと誤用になる」という指摘の側を否定している。
統計学ユーザー教育におけるにせマナー講師的言説の否定になっている。
黒木玄 Gen Kuroki@genkuroki
「コクランの規則」とあの保守的過ぎるルールを呼ぶ慣習はCochran先生の名誉を傷付ける行為にもなっています。
よく引用されている Cochran (1954) scholar.google.co.jp/scholar?cluste… には添付画像のように、コクラン先生の "my opinion" として「保守的過ぎる」という見解が載っています。
よく引用されている Cochran (1954) scholar.google.co.jp/scholar?cluste… には添付画像のように、コクラン先生の "my opinion" として「保守的過ぎる」という見解が載っています。
34
#統計 再度強調
Cochran 1954 scholar.google.co.jp/scholar?cluste… を引用して「ある期待度数が5未満ならばχ²検定を使うな」というルールを「コクランルール」と呼ぶのはどうかしている。コクラン先生自身は「それだと過剰に保守的で検出力を大幅に下げる場合が出て来る」と述べていたことにも触れないとまずい。
Cochran 1954 scholar.google.co.jp/scholar?cluste… を引用して「ある期待度数が5未満ならばχ²検定を使うな」というルールを「コクランルール」と呼ぶのはどうかしている。コクラン先生自身は「それだと過剰に保守的で検出力を大幅に下げる場合が出て来る」と述べていたことにも触れないとまずい。
35
#統計 コクラン先生自身は過剰に保守的だと正しく警告している論文を引用して、そういうルールを「コクランルール」と平気で呼んでしまう慣習の存在は、統計学ユーザー界がどれだけ病的であるかを示す典型的な事例。
統計学ユーザー界の場合には、定番の有名論文の引用も証拠の提出扱いできない。
統計学ユーザー界の場合には、定番の有名論文の引用も証拠の提出扱いできない。
36
#統計 論文自体は一流の人が慎重な態度で書き上げていても(コクラン先生も某ルールを過剰に保守的だと正しく指摘している)、それをよってたかって引用している側は、理解度がおそろしく低くて、おかしな引用の仕方を集団でしている場合がある。そして誤りを指摘しても理解できないので訂正もできない。
37
#統計 学術誌にYatesの連続補正版χ²検定とFisher検定が過剰に保守的になる場合があることを指摘する論文を書いたら(Haviland 1990)、同雑誌に「Lehmannの教科書でFisher検定は一様最強力不偏検定だと証明されている」というデタラメなコメントが掲載されたりもする。教科書をまともに読めていない。

黒木玄 Gen Kuroki@genkuroki
#統計 ところが、Peritz 1992はそれらの数学的事実を否定するために
❌Lehmann 1959, Chap.5はFisher検定はuniformly most powerfully unbiasedだと証明している。
とデタラメを述べている。
Lehmannさんはそんなことを証明していません。Fisher検定はumpu検定から数値的にかけ離れた検定です。
❌Lehmann 1959, Chap.5はFisher検定はuniformly most powerfully unbiasedだと証明している。
とデタラメを述べている。
Lehmannさんはそんなことを証明していません。Fisher検定はumpu検定から数値的にかけ離れた検定です。
38
#統計 2×2の分割表での独立性に関する一様最強力不偏(umpu)検定の私による実装が
nbviewer.org/github/genkuro…
にあります。リンク先の画像の場合には、Fisher検定よりも補正無しχ²検定の方がumpu検定に近いという結果が得られています。
nbviewer.org/github/genkuro…
にあります。リンク先の画像の場合には、Fisher検定よりも補正無しχ²検定の方がumpu検定に近いという結果が得られています。
黒木玄 Gen Kuroki@genkuroki
#統計 統計モデルはBinomial(r, p)×Binomial(s, q)
帰無仮説p=q、対立仮説p≠qの有意水準5%の仮説検定の検出力のグラフ。
比較のグラフで白っぽい領域では2つの検定法の検出力はほぼ一致している。そうでない領域では一致していない。
umpu検定に近い検定ほど良い検定とみなせる。
帰無仮説p=q、対立仮説p≠qの有意水準5%の仮説検定の検出力のグラフ。
比較のグラフで白っぽい領域では2つの検定法の検出力はほぼ一致している。そうでない領域では一致していない。
umpu検定に近い検定ほど良い検定とみなせる。
39
#統計 私は、査読済み論文の引用が証拠の提出に全然なっていない場合を他にも見付けています。
『生物統計学の道標』(2023)
第15回 無計画な解析における問題(坂巻顕太郎)
で引用されている
9) Fagerland and Sandvik 2009
onlinelibrary.wiley.com/doi/10.1002/si…
の内容は間違ってます。

『生物統計学の道標』(2023)
第15回 無計画な解析における問題(坂巻顕太郎)
で引用されている
9) Fagerland and Sandvik 2009
onlinelibrary.wiley.com/doi/10.1002/si…
の内容は間違ってます。
黒木玄 Gen Kuroki@genkuroki
#統計 査読済みの出版論文になってしまうと、内容を理解せずに信用して引用する人が出て来てしまう。
『生物統計学の道標』(2023)
第15回 無計画な解析における問題(坂巻顕太郎)
で引用されている
onlinelibrary.wiley.com/doi/10.1002/si…
の数表はまちがっているし、さらにシミュレーションの仕方も不適切。
『生物統計学の道標』(2023)
第15回 無計画な解析における問題(坂巻顕太郎)
で引用されている
onlinelibrary.wiley.com/doi/10.1002/si…
の数表はまちがっているし、さらにシミュレーションの仕方も不適切。
40
#統計 「統計学の使い方の解説」という分野は相当におかしなことになっているように見える。
* 多くの教科書に書いてあることであっても信用してはいけない。
* 定番の有名査読済み論文を引用していても信用してはいけない。
* 内容的に間違っている査読済み論文を引用している場合もある。
* 多くの教科書に書いてあることであっても信用してはいけない。
* 定番の有名査読済み論文を引用していても信用してはいけない。
* 内容的に間違っている査読済み論文を引用している場合もある。
41
#統計 一方、コンピュータの利用環境が数十年前とは比較にならないほど良くなっているのは良いことです。
このスレッドの内容も、#Julia言語 によるコンピュータシミュレーションが元になっている。
伝統に根付いてしまったおかしな慣習を否定するためにコンピュータは非常に役に立ちます。
このスレッドの内容も、#Julia言語 によるコンピュータシミュレーションが元になっている。
伝統に根付いてしまったおかしな慣習を否定するためにコンピュータは非常に役に立ちます。
42
#統計 具体的にどういう解説を批判しているかを明確にするために、「コクランルール」の不適切な解説の典型例を紹介しよう。
drmagician.exblog.jp/22086293/ では、添付画像のように、データの数値が
1 24
5 15
の場合(表を転置していることに注意)には、χ²検定を使ってはいけないと解説している。続く
drmagician.exblog.jp/22086293/ では、添付画像のように、データの数値が
1 24
5 15
の場合(表を転置していることに注意)には、χ²検定を使ってはいけないと解説している。続く
43
#統計 drmagician.exblog.jp/22086293/ は【コクラン・ルール】についてCochran 1954 を引用して、【期待数のマス目のうち20%以上で期待数が5未満のマスがあるとχ2乗検定を用いてはならない】と述べており、Cochran 1954には「過剰に保守的」だと書いてあることには触れていない(この時点でアウト)。

44
#統計 添付画像は drmagician.exblog.jp/22086293/ の「期待数」が期待値になるようにデータの数値が生成されているときの、P値≤αとなる確率(αエラー率)のグラフである。
χ²検定のα=5%でのαエラー率は5.2%で5%に非常に近いので、χ²検定を用いてもよい場合だと考えられる。続く
github.com/genkuroki/publ…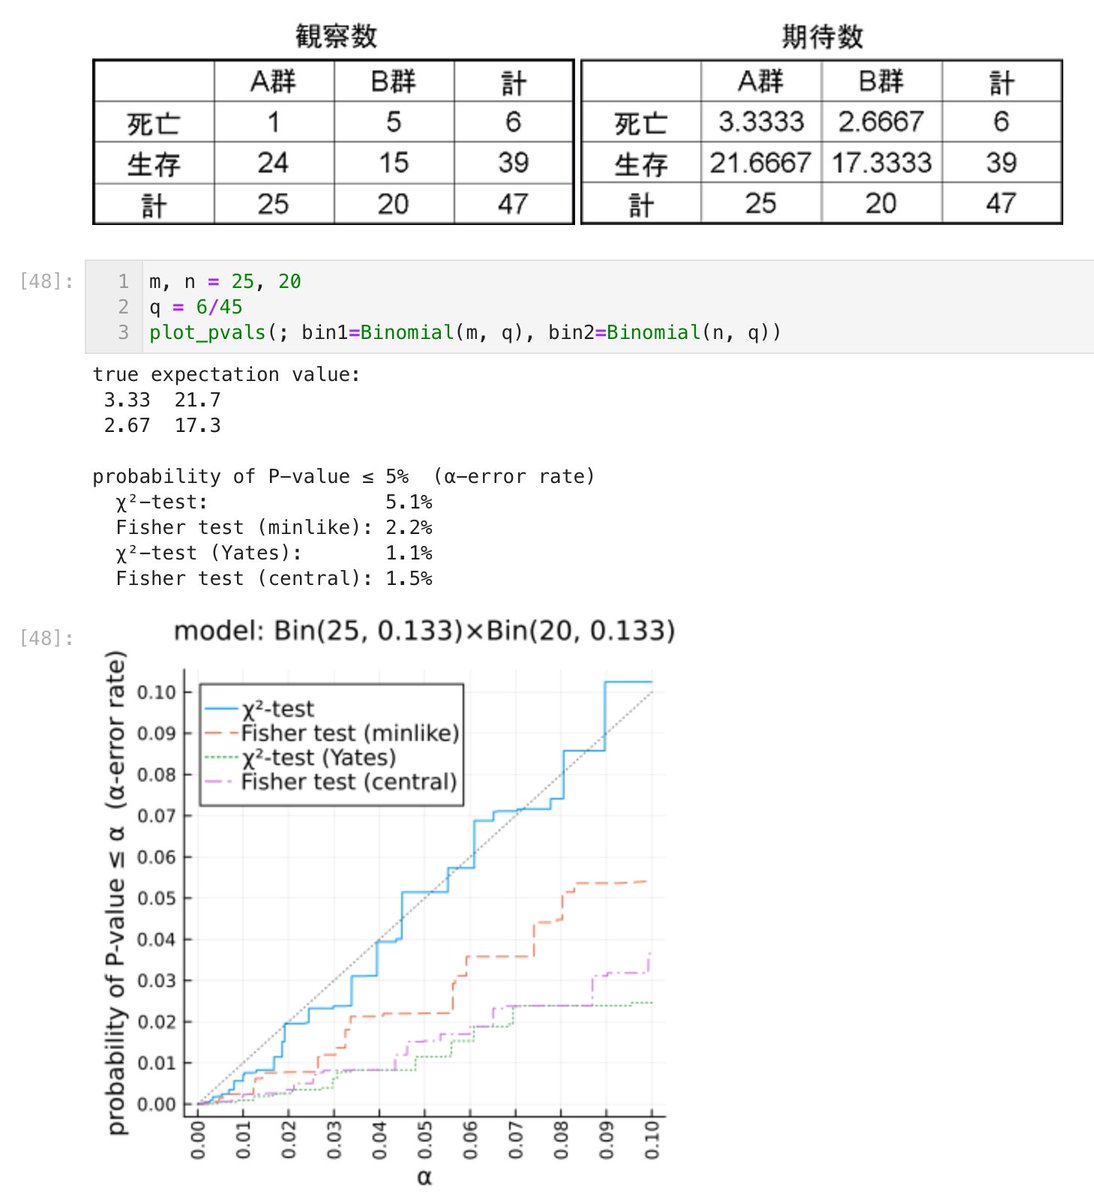
χ²検定のα=5%でのαエラー率は5.2%で5%に非常に近いので、χ²検定を用いてもよい場合だと考えられる。続く
github.com/genkuroki/publ…
45
#統計 添付画像は drmagician.exblog.jp/22086293/ の「観察数」が期待値になるようにデータが生成されているときの、P値≤5%となる確率(検出力)のグラフである。
Fisher検定達の検出力は補正無しχ²検定よりもずっと小さくなってしまっている。続く
github.com/genkuroki/publ…
Fisher検定達の検出力は補正無しχ²検定よりもずっと小さくなってしまっている。続く
github.com/genkuroki/publ…
46
#統計 コクラン先生はCochran 1954において、期待度数が5未満という基準は保守的過ぎる(検出力低下の原因になる)ことを警告してくれているのですが、 drmagician.exblog.jp/22086293/ において説明用に使われている
1 24
5 15
の例はまさにそういう場合になっているのです。
1 24
5 15
の例はまさにそういう場合になっているのです。
黒木玄 Gen Kuroki@genkuroki
#統計 再度強調
Cochran 1954 scholar.google.co.jp/scholar?cluste… を引用して「ある期待度数が5未満ならばχ²検定を使うな」というルールを「コクランルール」と呼ぶのはどうかしている。コクラン先生自身は「それだと過剰に保守的で検出力を大幅に下げる場合が出て来る」と述べていたことにも触れないとまずい。
Cochran 1954 scholar.google.co.jp/scholar?cluste… を引用して「ある期待度数が5未満ならばχ²検定を使うな」というルールを「コクランルール」と呼ぶのはどうかしている。コクラン先生自身は「それだと過剰に保守的で検出力を大幅に下げる場合が出て来る」と述べていたことにも触れないとまずい。
47
#統計 drmagician.exblog.jp/22086293/ のように、発言力がある人による解説によって、本当は問題がないχ²検定の使い方まで非難の対象になることによって、
萎縮
無駄な手間の増加
検出力の低下
のような実害が広く発生している疑いがあると私は考えています。
萎縮
無駄な手間の増加
検出力の低下
のような実害が広く発生している疑いがあると私は考えています。
48
#統計 データの数値
1 24
5 15
のP値関数のグラフ。横軸はオッズ比。
スコア法(Pearsonのχ²検定の拡張)
Fisher検定(minlike、Rのfisher.test)の拡張
スコア法の連続性補正
Fisher検定(central、片側確率の2倍)の拡張
の4種のP値関数をプロット。
github.com/genkuroki/publ…
1 24
5 15
のP値関数のグラフ。横軸はオッズ比。
スコア法(Pearsonのχ²検定の拡張)
Fisher検定(minlike、Rのfisher.test)の拡張
スコア法の連続性補正
Fisher検定(central、片側確率の2倍)の拡張
の4種のP値関数をプロット。
github.com/genkuroki/publ…
49

50

51
#統計 P値関数については以下のリンク先スレッドを参照。
P値や信頼区間ユーザーが、有意水準や信頼水準などの縛りをなくして行ったときに何を報告したらよいかについて考えると自然にP値関数の概念に至ります。
P値関数はnull P値、点推定値、信頼区間のすべての情報を含む。

P値や信頼区間ユーザーが、有意水準や信頼水準などの縛りをなくして行ったときに何を報告したらよいかについて考えると自然にP値関数の概念に至ります。
P値関数はnull P値、点推定値、信頼区間のすべての情報を含む。
黒木玄 Gen Kuroki@genkuroki
#統計 バージョンアップ
P値関数に至る道を具体例で説明
データの数値「n=20回中5回成功」が得られたときに、報告内容の制限を外して行くと、自然にP値関数の報告というアイデアに到達する。
添付画像はP値経路。続く
github.com/genkuroki/publ…
P値関数に至る道を具体例で説明
データの数値「n=20回中5回成功」が得られたときに、報告内容の制限を外して行くと、自然にP値関数の報告というアイデアに到達する。
添付画像はP値経路。続く
github.com/genkuroki/publ…
52
#統計 健全なP値と信頼区間の使い方についてはGreenlandさんの講演スライド2022が決定版の解説。
「統計的に有意」という言い方はミスリーディングなので廃止されるべき。
5%のような閾値を設けない場合はP値関数のグラフ全体の様子を利用するとよい。
「統計的に有意」という言い方はミスリーディングなので廃止されるべき。
5%のような閾値を設けない場合はP値関数のグラフ全体の様子を利用するとよい。
黒木玄 Gen Kuroki@genkuroki
#統計 Greenlandさんの講演スライド
biostat.ucdavis.edu/sites/g/files/…
は100ページ以上あって、全部読むのは大変なのですが、P値がどういう使い方をするべき道具であるかについては、pp.87-88に以下のように書いてあります。
P値は全然統計的有意差を出すための道具扱いされていない。
biostat.ucdavis.edu/sites/g/files/…
は100ページ以上あって、全部読むのは大変なのですが、P値がどういう使い方をするべき道具であるかについては、pp.87-88に以下のように書いてあります。
P値は全然統計的有意差を出すための道具扱いされていない。
53
#統計 補足
リンク先添付画像のhypothetical odds ratioはモデル内での分割表の確率分布の期待値が
κ λ
μ ν
のときの
OR = κν/(λμ)
のことです。オッズ比にはヒトにとって直観的な解釈が難しいという欠点があります。
2つのリスクκ/(κ+λ)とμ/(μ+ν)の差や比の方がヒトは直観的に理解し易い。続く
リンク先添付画像のhypothetical odds ratioはモデル内での分割表の確率分布の期待値が
κ λ
μ ν
のときの
OR = κν/(λμ)
のことです。オッズ比にはヒトにとって直観的な解釈が難しいという欠点があります。
2つのリスクκ/(κ+λ)とμ/(μ+ν)の差や比の方がヒトは直観的に理解し易い。続く
黒木玄 Gen Kuroki@genkuroki
#統計 データの数値
1 24
5 15
のP値関数のグラフ。横軸はオッズ比。
スコア法(Pearsonのχ²検定の拡張)
Fisher検定(minlike、Rのfisher.test)の拡張
スコア法の連続性補正
Fisher検定(central、片側確率の2倍)の拡張
の4種のP値関数をプロット。
github.com/genkuroki/publ…
1 24
5 15
のP値関数のグラフ。横軸はオッズ比。
スコア法(Pearsonのχ²検定の拡張)
Fisher検定(minlike、Rのfisher.test)の拡張
スコア法の連続性補正
Fisher検定(central、片側確率の2倍)の拡張
の4種のP値関数をプロット。
github.com/genkuroki/publ…
54
#統計 2つの母比率(もしくはリスク)pとqの違いを測るためのパラメータとしてオッズ比ORではなく、リスク比p/qを採用した場合のP値のグラフが以下のリンク先にあります。
P値はスコア法で構成したもので、χ²検定のP値の1パラメータ拡張になっています。続く
P値はスコア法で構成したもので、χ²検定のP値の1パラメータ拡張になっています。続く
55
#統計 リンク先のグラフは、スコア法の下での、観察数のデータの数値とリスク比の値に関する仮説の相性の良さ(compatibility)を表しています。
データの数値と最も相性が良いのはA群の死亡率がB群の0.16倍に小さくなるという仮説。
相性の良さ(=P値)が5%以上なのは0.03倍から1倍弱程度。
データの数値と最も相性が良いのはA群の死亡率がB群の0.16倍に小さくなるという仮説。
相性の良さ(=P値)が5%以上なのは0.03倍から1倍弱程度。
56
#統計 上のようにリスク比(A群の死亡率/B群の死亡率)をリスクの違いのパラメータに採用すると、P値によって、死亡率が何倍に減るかに関する仮説とデータの数値の相性の良さが分かる。
以下のリンク先のグラフはリスク差(A群とB群の死亡率の差)を横軸に採用。差もヒトにとって理解し易いです。
以下のリンク先のグラフはリスク差(A群とB群の死亡率の差)を横軸に採用。差もヒトにとって理解し易いです。
57
#統計 ある研究グループが得たデータの数値と、死亡率の削減に関する仮説達の相性の良さの様子をP値関数のグラフの形式で要約して報告することは、新たな結果を他の研究グループと分かり易く共有ために役に立ちます。
5%の閾値の設定にこだわるよりもそういう科学的貢献の方を優先するべき。
5%の閾値の設定にこだわるよりもそういう科学的貢献の方を優先するべき。
58
#統計 データの数値と死亡率の削減の大きさに関する仮説達の相性の良さを分かり易く報告することが大事であるということからも、少々不自由なFisher検定にこだわることは得策ではないという結論が出ます。
このスレッドで扱った問題(1)と(2)はこのように関係しています。
このスレッドで扱った問題(1)と(2)はこのように関係しています。
黒木玄 Gen Kuroki@genkuroki
#統計 2×2の分割表での検定法(母比率の違いに関する検定法)について気になっている問題は2つ。
(1) 「期待度数が5未満ならばχ²検定ではなく、Fisher検定を使うべきである」というデマの普及
(2) 検定仮説を「母比率は等しい」から「母比率の違いはθ=aである」に拡張しない悪しき流儀の普及
(1) 「期待度数が5未満ならばχ²検定ではなく、Fisher検定を使うべきである」というデマの普及
(2) 検定仮説を「母比率は等しい」から「母比率の違いはθ=aである」に拡張しない悪しき流儀の普及
59
#統計 このスレッドで詳しく解説したように、添付画像の説明はよく見る伝統的かつ慣習化された誤り。
Fisher検定を小標本に使うと検出力のロスが大きくなります。検定法選択はトレードオフに配慮して行うべき。
あと、モデルにパラメータを入れてP値を拡張するべき。null P値だけを見るのは不健全。
x.com/tororo__ph/sta…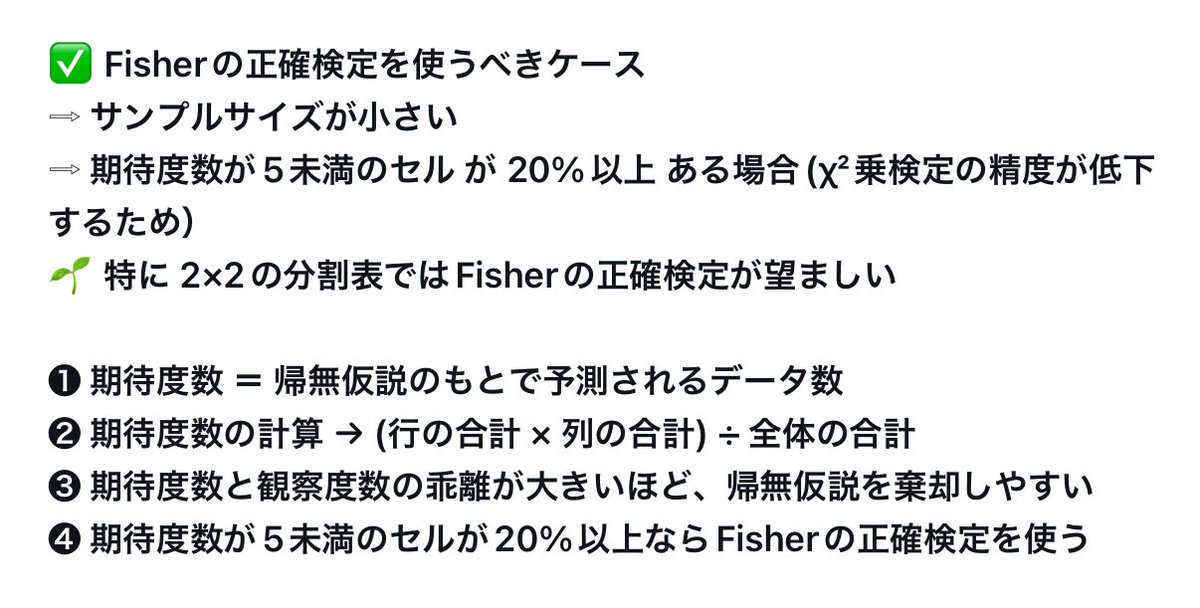
Fisher検定を小標本に使うと検出力のロスが大きくなります。検定法選択はトレードオフに配慮して行うべき。
あと、モデルにパラメータを入れてP値を拡張するべき。null P値だけを見るのは不健全。
x.com/tororo__ph/sta…
60
#統計 小サンプルの場合に機械的にFisher検定を推奨することは、伝統的かつ慣習的な誤り。Fisher検定は小サンプルで過剰に保守的で検出力が下がる。
詳しくはスレッド全体を参照。


詳しくはスレッド全体を参照。
けん爺@kohto2
【041】フィッシャーの正確確率検定
フィッシャーの正確確率検定は、少数の観察データでも有効なカテゴリカルデータの独立性を検証する手法。
•利点: 小さなサンプルサイズで信頼性のある結果を提供
•使用場面: 2×2のクロス集計表で特に有効
•応用: 医学研究、臨床試験
#統計学 #データ分析
フィッシャーの正確確率検定は、少数の観察データでも有効なカテゴリカルデータの独立性を検証する手法。
•利点: 小さなサンプルサイズで信頼性のある結果を提供
•使用場面: 2×2のクロス集計表で特に有効
•応用: 医学研究、臨床試験
#統計学 #データ分析
61
#統計 小サンプルの場合に機械的にχ²検定ではなくフィッシャー検定を使うべきだとすることは伝統的かつ慣習化された誤りです。Fisher検定が過剰に保守的であることを無視している。
よく見る誤りなのでスレッド化して詳しく解説しておきました。

よく見る誤りなのでスレッド化して詳しく解説しておきました。
柴田真司@ShinjiSHIBATA11
T が 20 以下または期待度数の最小値 min(t11, t12, t21, t22) が 5 以下のときには近似が悪くなるため χ^2 検定の代わりにフィッシャー検定を使う。
マクネマー検定は対応のある 2 値 (陽性, 陰性) データの比率の差を検定する。
22 / 28
マクネマー検定は対応のある 2 値 (陽性, 陰性) データの比率の差を検定する。
22 / 28
62
#統計 小標本の場合に機械的にχ²検定の使用を禁止することは、伝統的かつ慣習化された誤りです。コクラン先生は原論文でそのルールは過剰の保守的だと評しています。コクラン先生が批判しているルールをみんな「コクランルール」と呼んでいる不思議。
詳しくはスレッド全体を読んで下さい。

詳しくはスレッド全体を読んで下さい。
杉山大介@sugiyama5525
フィッシャー検定とカイ二乗検定の違いわかりますか?
フィッシャー検定はp値を直接正確に計算するので,データ数が5以下のセルが一つでもある場合には、フィッシャー検定が推奨される.手計算だと計算の限界があり,データ数が多い場合はカイ二乗検定で近似するとしておこなわれてきた.
フィッシャー検定はp値を直接正確に計算するので,データ数が5以下のセルが一つでもある場合には、フィッシャー検定が推奨される.手計算だと計算の限界があり,データ数が多い場合はカイ二乗検定で近似するとしておこなわれてきた.
63
#統計 その手のルールでχ²検定を使うことを機械的に禁止してフィッシャー検定を勧めることは伝統的かつ慣習化された誤りです。
これについてはおかしなことを言っている人達の方が圧倒的多数派。にせマナー講師に騙される人達の問題に似ている。
詳しくはスレッド全体を参照。

これについてはおかしなことを言っている人達の方が圧倒的多数派。にせマナー講師に騙される人達の問題に似ている。
詳しくはスレッド全体を参照。
mof@yellowspongers
分からないことをメモ
・サンプルについて、「セルの20%以上が5以下の場合はFisher正確確率検定を」というのをよく見かけるけど、「期待値について」というのも見た。
どっち?どっちもかな。
・サンプル数が少ない場合は値の誤差が大きい/サンプル数が少ない場合はFisherでっ、て。
どうすれば…
・サンプルについて、「セルの20%以上が5以下の場合はFisher正確確率検定を」というのをよく見かけるけど、「期待値について」というのも見た。
どっち?どっちもかな。
・サンプル数が少ない場合は値の誤差が大きい/サンプル数が少ない場合はFisherでっ、て。
どうすれば…
64
#統計 おそらく「P値<5%」による二分法的な判断を機械的に行なって良いと思っている科学的に問題がある人達が想像以上にたくさんいるという問題ともこのスレッドで指摘したχ²検定とFisher検定に関する「マナー講師」問題は密接に関係している。
65
#統計 「正規分布でなければt検定は使えない」や「Mann-WhitneyのU検定なら無条件で使える」は悪しきフローチャート統計学が含む典型的な誤りです。
それとは別に「正規性が棄却されないならば正規性を仮定する検定を使える」も誤りです。正規性が棄却されないことは正規性を保証しません。続く
x.com/tororo__ph/sta…
それとは別に「正規性が棄却されないならば正規性を仮定する検定を使える」も誤りです。正規性が棄却されないことは正規性を保証しません。続く
x.com/tororo__ph/sta…
66
#統計 悪しきフローチャート統計学の呪縛はかなりひどいことになっており、「赤信号みんなで渡れば怖くない」のような状況になっているように見えるので、若い人達は否定して行かなければいけないことに注意が必要です。
今まで悪しきフローチャート統計学を教えて来た先生達は責任を取るべき。
x.com/tororo__ph/sta…
今まで悪しきフローチャート統計学を教えて来た先生達は責任を取るべき。
x.com/tororo__ph/sta…
67
#統計 補足
Welchのt検定は非正規性と非等分散性の両方について頑健なのですが、Mann-WhitneyのU検定は脆弱で危険な検定法なので、正規性検定で正規性が棄却されたという理由でMann-WhitneyのU検定を使うと余計にまずいことになる可能性が高くなります。
Welchのt検定は非正規性と非等分散性の両方について頑健なのですが、Mann-WhitneyのU検定は脆弱で危険な検定法なので、正規性検定で正規性が棄却されたという理由でMann-WhitneyのU検定を使うと余計にまずいことになる可能性が高くなります。
68
#統計 Studentのt検定は、非正規性には頑強なのですが、不等標本サイズの場合に不等分散性について脆弱なので、デフォルトの方法として使うべきではありません。代替のより安全な検定法はWelchのt検定。
脆弱なMann-WhitneyのU検定の代替となり得るより安全な方法はBrunner-Munzel検定。
脆弱なMann-WhitneyのU検定の代替となり得るより安全な方法はBrunner-Munzel検定。
69
#統計 2つの母集団の違いをどのような指標で測るのが自分の目的にとって適切であるかによって、検定法と区間推定法の組み合わせを選ぶべきで、「とにかく有意差を出したいから」のように考えるのも誤りです。
「有意差を出す」という発想自体が有害だと思います。Greenlandさん達に私は賛成です。
「有意差を出す」という発想自体が有害だと思います。Greenlandさん達に私は賛成です。
70
#統計 Mann-WhitneyのU検定やBrunner-Munzel検定では、違いを測るための指標の選択が複数あることに注意が必要です。
p=P(X<Y)+P(X=Y)/2と1/2の差を違いの指標として採用できるだけではなく、P(X<Y+a)+P(X=Y+a)/2=1/2となるaを違いの指標として採用することもできます。
p=P(X<Y)+P(X=Y)/2と1/2の差を違いの指標として採用できるだけではなく、P(X<Y+a)+P(X=Y+a)/2=1/2となるaを違いの指標として採用することもできます。
71
#統計 Mann-WhitneyのU検定の統計ソフトでの実装ではP(X<Y+a)+P(X=Y+a)/2=1/2となるaの信頼区間に対応済みなことが多いのですが、Brunner-Munzel検定の場合にはそうではないので自分で実装する必要が出て来ます。
P(X<Y+a)+P(X=Y+a)/2=1/2となるaは、母平均の差のノンパラ類似で分かり易いと思う。
P(X<Y+a)+P(X=Y+a)/2=1/2となるaは、母平均の差のノンパラ類似で分かり易いと思う。
72
#統計 正値のデータに対数変換を施してからWelchのt検定を使用すると、違いを測るための指標が「母平均の差」から「母平均の比」もしくは「母平均の対数の差」に変更されたことに注意する必要があります。
違いを測るためのどの指標が自分の目的にとって適切かどうかで方法を選択する必要があります。
違いを測るためのどの指標が自分の目的にとって適切かどうかで方法を選択する必要があります。
73
#統計 「検定から推定へ」は合理的な考え方なのですが、それを「P値ではなく、信頼区間を使う」のように解釈するのは酷い誤りです。
Greenlandさん達がいつも強調しているように、違いの指標となるパラメータθと数値cに関する検定仮説θ=cのP値達を全部考えればP値達は推定のための道具になります。
↓
Greenlandさん達がいつも強調しているように、違いの指標となるパラメータθと数値cに関する検定仮説θ=cのP値達を全部考えればP値達は推定のための道具になります。
↓
黒木玄 Gen Kuroki@genkuroki
#統計 Greenlandさんの講演スライド
biostat.ucdavis.edu/sites/g/files/…
は100ページ以上あって、全部読むのは大変なのですが、P値がどういう使い方をするべき道具であるかについては、pp.87-88に以下のように書いてあります。
P値は全然統計的有意差を出すための道具扱いされていない。
biostat.ucdavis.edu/sites/g/files/…
は100ページ以上あって、全部読むのは大変なのですが、P値がどういう使い方をするべき道具であるかについては、pp.87-88に以下のように書いてあります。
P値は全然統計的有意差を出すための道具扱いされていない。
74
#統計 「効果」を扱う伝統的な統計学のハウツー解説では
* 「有意差があるか否か」と「効果量」の確認を別々に行うと説明。
* 「効果量」の報告は点推定なのか区間推定なのか曖昧。
* フローチャート的な説明をしている。
となっていて酷いのですが、おそらくその酷さはほとんど認識されていない。
* 「有意差があるか否か」と「効果量」の確認を別々に行うと説明。
* 「効果量」の報告は点推定なのか区間推定なのか曖昧。
* フローチャート的な説明をしている。
となっていて酷いのですが、おそらくその酷さはほとんど認識されていない。
75
#統計 そういう悪しき教育を受けた人たちは「有意差が出たならば効果の存在は証明されたことになる。しかし、効果が微小過ぎて意味がない値でないことを効果量を見て確認する必要がある」(補足: 効果量は点推定値)のような杜撰でダメな考え方をするようになります。
これ、あまりにも頻繁に見る。
これ、あまりにも頻繁に見る。
76
#統計 標本サイズが小さい場合には「有意差あり」と「効果量が大きい」は数学的にほぼ同値になります。だから、有意差があってかつ効果量が大きいことが実践的に良い結果(臨床的に良い結果)だとみんな信じてしまうと、「小標本サイズ+有意差有り+大きな効果量」な報告が増えるバイアスが生じる。
77
#統計
sites.stat.columbia.edu/gelman/researc…
Selecting on statistical significance and practical importance is wrong
Blakeley B. McShane and Andrew Gelman
2022
sites.stat.columbia.edu/gelman/researc…
Selecting on statistical significance and practical importance is wrong
Blakeley B. McShane and Andrew Gelman
2022
78
#統計
「再現性の危機」言説に関する見方の決定版の論文
↓
scholar.google.co.jp/scholar?cluste…
Inferential statistics as descriptive statistics: There is no replication crisis if we don't expect replication
V Amrhein, D Trafimow, S Greenland
The American Statistician, 2019
「再現性の危機」言説に関する見方の決定版の論文
↓
scholar.google.co.jp/scholar?cluste…
Inferential statistics as descriptive statistics: There is no replication crisis if we don't expect replication
V Amrhein, D Trafimow, S Greenland
The American Statistician, 2019
79
#統計 既出の scholar.google.co.jp/scholar?cluste… や biostat.ucdavis.edu/sites/g/files/… などでGreenlandさん達が強調していることは、inferential statisticsを「現実の母集団の様子に関する推測推論推定」だとみなさずに、「特定のモデルの下でデータの数値がどのように見えるかの記述」とみなすことです。続く
80
#統計 コンピュータがアウトプットするinferential statistics関連の計算結果を安易に「現実の母集団の様子に関する推測推論推定」だとみなすと、その結果を過信してしまう誤りを犯しがち。続く
81
#統計 しかし、inferential statisticsの計算結果が「特定のモデルの下でデータの数値がどのように見えるかの記述」でしかないことをわきまえていれば、そこから複雑な現実に関する結論を出すためには追加の情報と研究の必要性に正直に触れざるを得なくなります。科学的まともさのために非常に重要。
82
#統計 inferential statisticsの計算結果が「特定のモデルの下でデータの数値がどのように見えるかの記述」でしかないことは、inferential statisticsの計算結果は「データの数値と特定のモデルのcompatibility(相性の良さ)の様子の記述」に過ぎないという形式で主張されることもあります。
83
#統計 inferential statisticsの計算結果は「データの数値と特定のモデルのcompatibility(相性の良さ)の様子の記述」に過ぎないという安全な見方は、ベイズ統計の場合にもそのまま拡張されることにも注意。
84
#統計 「データの数値と特定のモデルのcompatibility(相性の良さ)の様子の記述」という易しいシンプルな見方をできるようになると、統計学のハウツー解説の多くが統計ソフトの出力結果を過信させるような危険な方向にバイアスがかかっていることがよく分かります。
85
#統計 ベイズ統計に関するハウツー解説はもっと酷くて、「ベイズ版95%信用区間には真の値が95%の確率で含まれる」というミスリーディングで有害な説明が標準的になっています。
「ベイズ統計ならば好きな所でデータ取得を止められるし、多重性の問題も気にしなくて良い」というデマも標準的。
「ベイズ統計ならば好きな所でデータ取得を止められるし、多重性の問題も気にしなくて良い」というデマも標準的。
86
#統計 「事前の信念がデータの数値によって事後の信念に更新される」という主観ベイズ主義的なベイズ統計の解釈での事後確率は単に信念の強さの指標に過ぎず、現実の研究や仕事でのリスクの指標ではなく、
「お前がそう思うんならそうなんだろうな お前ん中ではな」
的な指標に過ぎません。


「お前がそう思うんならそうなんだろうな お前ん中ではな」
的な指標に過ぎません。
イブニング@eveningmagazine
#イブニング名シーン
『お前がそう思うんならそうなんだろう お前ん中ではな』
様々なコラ画像に姿を変え愛されてきましたが
こちらが本家本元🏯
そして実は名シーン✨
自分を見失った練を諭すシゲルがカッコいいんです❗
元ネタ知らなかった人は読んでみてね😊
『#少女ファイト』1巻4話より
『お前がそう思うんならそうなんだろう お前ん中ではな』
様々なコラ画像に姿を変え愛されてきましたが
こちらが本家本元🏯
そして実は名シーン✨
自分を見失った練を諭すシゲルがカッコいいんです❗
元ネタ知らなかった人は読んでみてね😊
『#少女ファイト』1巻4話より
87
#統計 主観主義的な解釈をしない場合の事後確率は、事前分布を含むベイズ的な統計モデルとデータの数値の相性の良さの様子の記述の一部分に過ぎません。
P値や信頼区間の被覆確率もモデルとデータの相性の良さの様子の記述の一部分に過ぎません。
この場合は「お前ん中ではな」=「モデルん中ではな」

P値や信頼区間の被覆確率もモデルとデータの相性の良さの様子の記述の一部分に過ぎません。
この場合は「お前ん中ではな」=「モデルん中ではな」
イブニング@eveningmagazine
#イブニング名シーン
『お前がそう思うんならそうなんだろう お前ん中ではな』
様々なコラ画像に姿を変え愛されてきましたが
こちらが本家本元🏯
そして実は名シーン✨
自分を見失った練を諭すシゲルがカッコいいんです❗
元ネタ知らなかった人は読んでみてね😊
『#少女ファイト』1巻4話より
『お前がそう思うんならそうなんだろう お前ん中ではな』
様々なコラ画像に姿を変え愛されてきましたが
こちらが本家本元🏯
そして実は名シーン✨
自分を見失った練を諭すシゲルがカッコいいんです❗
元ネタ知らなかった人は読んでみてね😊
『#少女ファイト』1巻4話より
88
#統計 P値や信頼区間であろうが、ベイズ統計であろうが、それらのユーザー達が興味があるのは現実における問題です。
しかし、それらが提供してくれる計算結果は、現実についてではなく、モデルとデータの数値の相性の良さの記述の一部分の情報だけなのです。モデルの存在が見えていないとアウト。
しかし、それらが提供してくれる計算結果は、現実についてではなく、モデルとデータの数値の相性の良さの記述の一部分の情報だけなのです。モデルの存在が見えていないとアウト。
89
#統計 複雑な現実に対処するためには、本当は正しいかどうか分からないモデルであっても、そのモデルを使ってデータの数値を整理要約して見せることは役に立つ。
モデルを裏に隠して、現実に関する仮説に関する判断をP値や信頼区間やベイズ的な事後確率だけでできるかのように説明するのはアウト。
モデルを裏に隠して、現実に関する仮説に関する判断をP値や信頼区間やベイズ的な事後確率だけでできるかのように説明するのはアウト。
90
#統計 主観ベイズ主義的なベイズ統計の「合理性」は「意思決定論」の言葉で語られることが多いのですが、その内容はもろに
お前がそう思うんならそうなんだろうな
__お前ん中__ではな
的であることは常に強調されるべきです。解説に続く

お前がそう思うんならそうなんだろうな
__お前ん中__ではな
的であることは常に強調されるべきです。解説に続く
イブニング@eveningmagazine
#イブニング名シーン
『お前がそう思うんならそうなんだろう お前ん中ではな』
様々なコラ画像に姿を変え愛されてきましたが
こちらが本家本元🏯
そして実は名シーン✨
自分を見失った練を諭すシゲルがカッコいいんです❗
元ネタ知らなかった人は読んでみてね😊
『#少女ファイト』1巻4話より
『お前がそう思うんならそうなんだろう お前ん中ではな』
様々なコラ画像に姿を変え愛されてきましたが
こちらが本家本元🏯
そして実は名シーン✨
自分を見失った練を諭すシゲルがカッコいいんです❗
元ネタ知らなかった人は読んでみてね😊
『#少女ファイト』1巻4話より
91
#統計 主観ベイズ主義的なベイズ統計の解釈では
事前分布は事前の主観的信念を表し、
データの数値によって、
それが事後分布で表される事後の主観的信念に更新される
のように考えます。ベイズ的な意思決定論ではさらに適当なリスク関数を設定して、
期待リスクの最小化
を行います。続く
事前分布は事前の主観的信念を表し、
データの数値によって、
それが事後分布で表される事後の主観的信念に更新される
のように考えます。ベイズ的な意思決定論ではさらに適当なリスク関数を設定して、
期待リスクの最小化
を行います。続く
92
#統計 その期待リスクは、事前分布を構成的要素として含むベイズ的な統計モデルの確率分布で計算された期待値になります。
それによって、主観内部の確率分布の下でのリスクの期待値を最小化する処方箋がベイズ統計の仕組みで得られるわけです。続く
それによって、主観内部の確率分布の下でのリスクの期待値を最小化する処方箋がベイズ統計の仕組みで得られるわけです。続く
93
#統計 主観ベイズ主義的な意味で最小化される期待リスクは主観内部の確率分布で計算されたリスクの期待値に過ぎない。
主観的確率分布が現実のモデルとして不適切である場合のリスクについては一切考えない。これがベイズ的な意思決定論が勧める処方箋の実態です。
まさに「お前ん中ではな」!
主観的確率分布が現実のモデルとして不適切である場合のリスクについては一切考えない。これがベイズ的な意思決定論が勧める処方箋の実態です。
まさに「お前ん中ではな」!
94
#統計 注意警告: ベイズ的な期待リスク最小化の考え方自体には罪がないことに注意!様々な最適化問題に関する数学的な理論を作っておくことには大いに価値があります。ベイズ的な意思決定論によってベイズ統計の特別な合理性を主張したりする困った人達がいる点が問題なのです。
95
#統計
関連の別の話題
↓
関連の別の話題
↓
黒木玄 Gen Kuroki@genkuroki
#統計 「P値=5.1%」と「P値=4.9%」はほぼ同等の結果です。
5%の人為的な閾値を使って機械的に二分法を適用すること自体が誤りです。
我々は、こういう当たり前の話を当たり前だと思えなくなるような統計学教育をずっと続けて来てしまった。
5%の人為的な閾値を使って機械的に二分法を適用すること自体が誤りです。
我々は、こういう当たり前の話を当たり前だと思えなくなるような統計学教育をずっと続けて来てしまった。
96
#統計 実践的には事前分布として平坦もしくは平坦に近いものが採用されていることが多く、さらにモデルがシンプルならば、パラメータθについて
(仮説θ≤cの成立の事後確率)≈(仮説θ≤cの片側P値)
という近似が成立しており、結果的にベイズなのにP値を使っているのと同じになります。続く
(仮説θ≤cの成立の事後確率)≈(仮説θ≤cの片側P値)
という近似が成立しており、結果的にベイズなのにP値を使っているのと同じになります。続く
黒木玄 Gen Kuroki@genkuroki
#統計 例えば、平坦事前分布やそれに近い事前分布を採用しているときに、パラメータθに関するθ≤cの事後確率は、仮説θ≤cの片側P値にほぼ一致する場合が多い。
小さくなって欲しいθ≤cの事後確率が20%なことは、仮説θ≤cの片側P値が20%なのとほぼ同じです!決定的な結果は得られなかったことになる。
小さくなって欲しいθ≤cの事後確率が20%なことは、仮説θ≤cの片側P値が20%なのとほぼ同じです!決定的な結果は得られなかったことになる。
97
#統計 そういう場合には、パラメータθについて
(ベイズ版95%信用区間)≈(通常の95%信頼区間)
という近似が成立しており、ベイズ版95%信用区間についても、通常の95%信頼区間と同じ注意(色々面倒)をすべて適用する必要があります。続く
(ベイズ版95%信用区間)≈(通常の95%信頼区間)
という近似が成立しており、ベイズ版95%信用区間についても、通常の95%信頼区間と同じ注意(色々面倒)をすべて適用する必要があります。続く
98
#統計 ミスリーディングなベイズ統計の解説者達の得意技は、「信頼区間と違って、ベイズ版95%信用区間であれば真の値が95%の確率で含まれていると考えてよい」と平気で言うことです。
「95%信用区間」の「95%」も「真の値」も現実ではなく主観内またはモデル内限定のフィクションでしかありません。
「95%信用区間」の「95%」も「真の値」も現実ではなく主観内またはモデル内限定のフィクションでしかありません。
99
#統計 ベイズ統計による計算結果も意思決定論的な解釈も
「お前がそう思うんならそうなんだろうな お前ん中ではな」
(「お前」は「主観」または「事前分布も含むベイズ的なモデル」)
的な結果だとみなされるべき。
「お前ん中ではな」的な結果を現実に繋げることは非自明な問題になります。
「お前がそう思うんならそうなんだろうな お前ん中ではな」
(「お前」は「主観」または「事前分布も含むベイズ的なモデル」)
的な結果だとみなされるべき。
「お前ん中ではな」的な結果を現実に繋げることは非自明な問題になります。
100
#統計 関連別スレッド
101
誤解を防ぐための注意警告
↓
↓