¿Puedes encontrar el patrón del siguiente puzzle? Este es un...

Carlos Santana@DotCSV
24 views
Dec 09, 2024
~2 min read
Advertisement
1
¿Puedes encontrar el patrón del siguiente puzzle?
Este es un ejemplo de los numerosos puzzles del benchmark ARC-AGI que a tantas IAs se le atraganta
En mi último vídeo probé a evaluar a o1-pro y los resultados no fueron bueno, pero ahora cambiando el enfoque la cosa mejora 🧵👇
Este es un ejemplo de los numerosos puzzles del benchmark ARC-AGI que a tantas IAs se le atraganta
En mi último vídeo probé a evaluar a o1-pro y los resultados no fueron bueno, pero ahora cambiando el enfoque la cosa mejora 🧵👇
2
Al probar o1-pro mi hipótesis fue que el modelo fallaba por sus problemas de visión. Al pasarle una captura de pantalla los fallos de no entender perfectamente la imagen se agregaban a los posibles errores de razonamiento.
Ahora estoy probando a pasarle el problema en texto.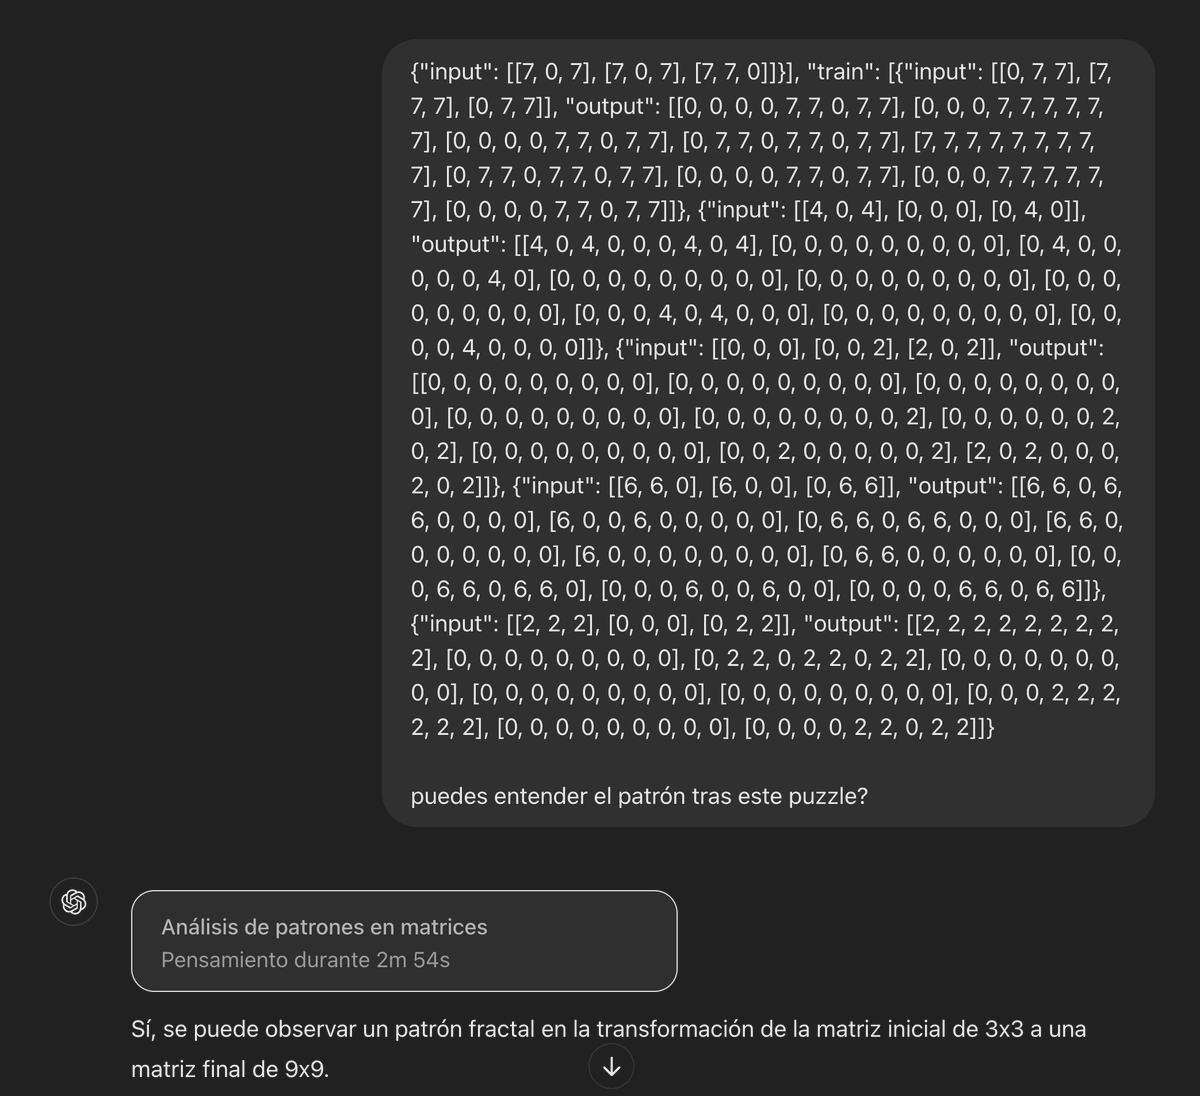
Ahora estoy probando a pasarle el problema en texto.
3
El resultado es que o1-pro sí consigue entender la lógica que hay en los ejemplos input/output, que para mi es la parte más difícil de los problemas ARC-AGI.
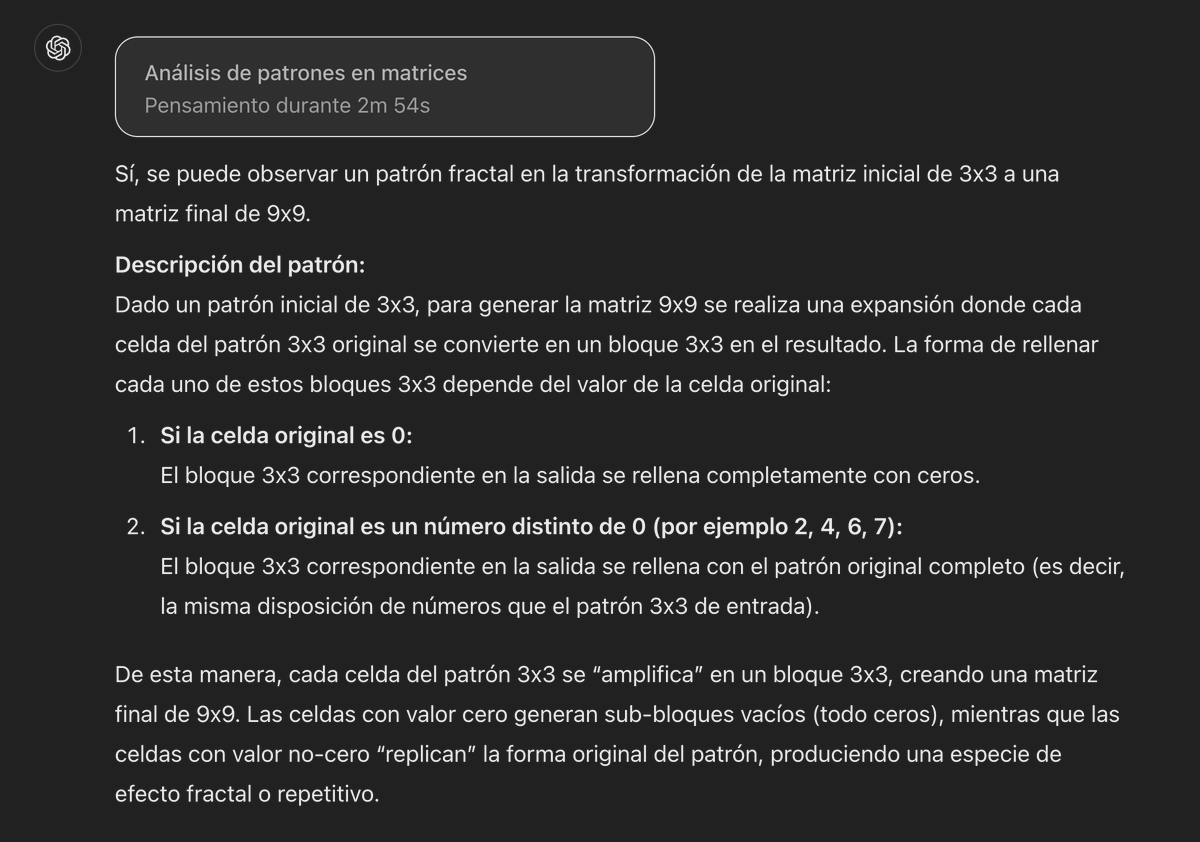
4
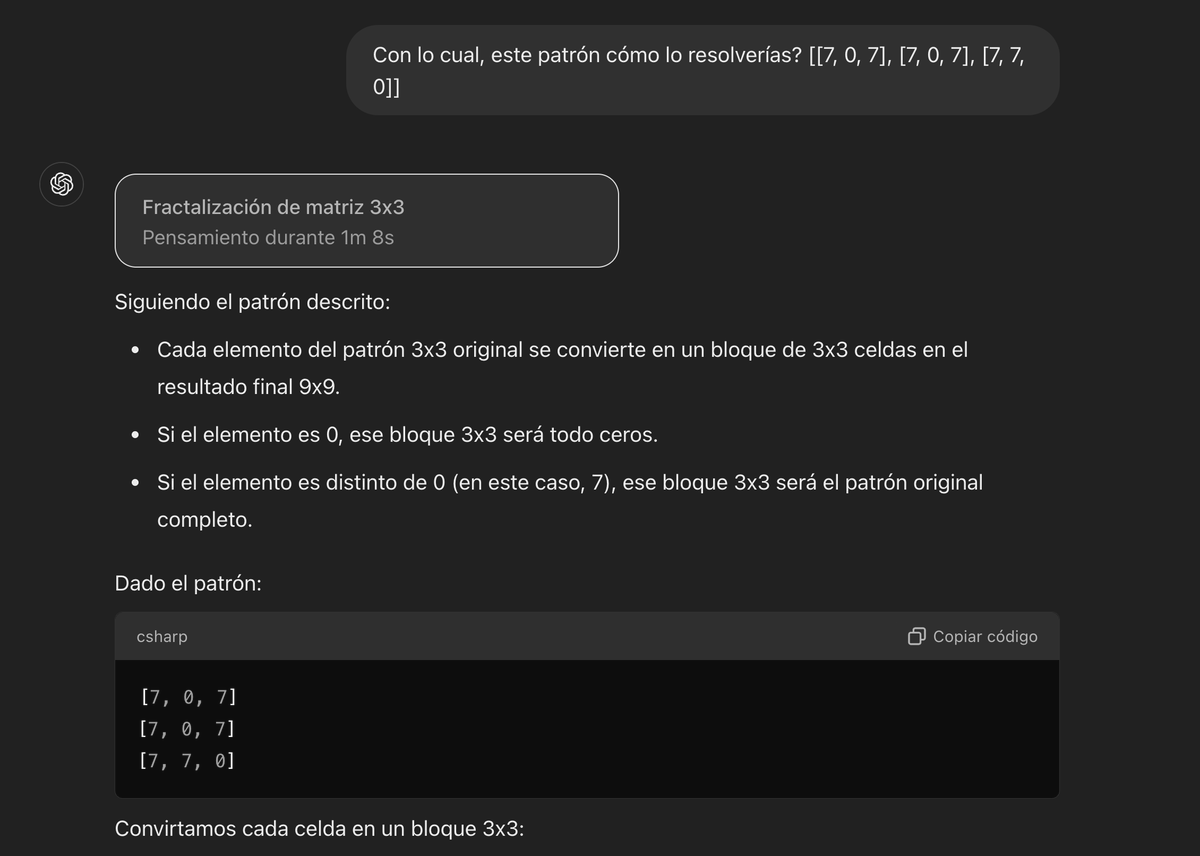
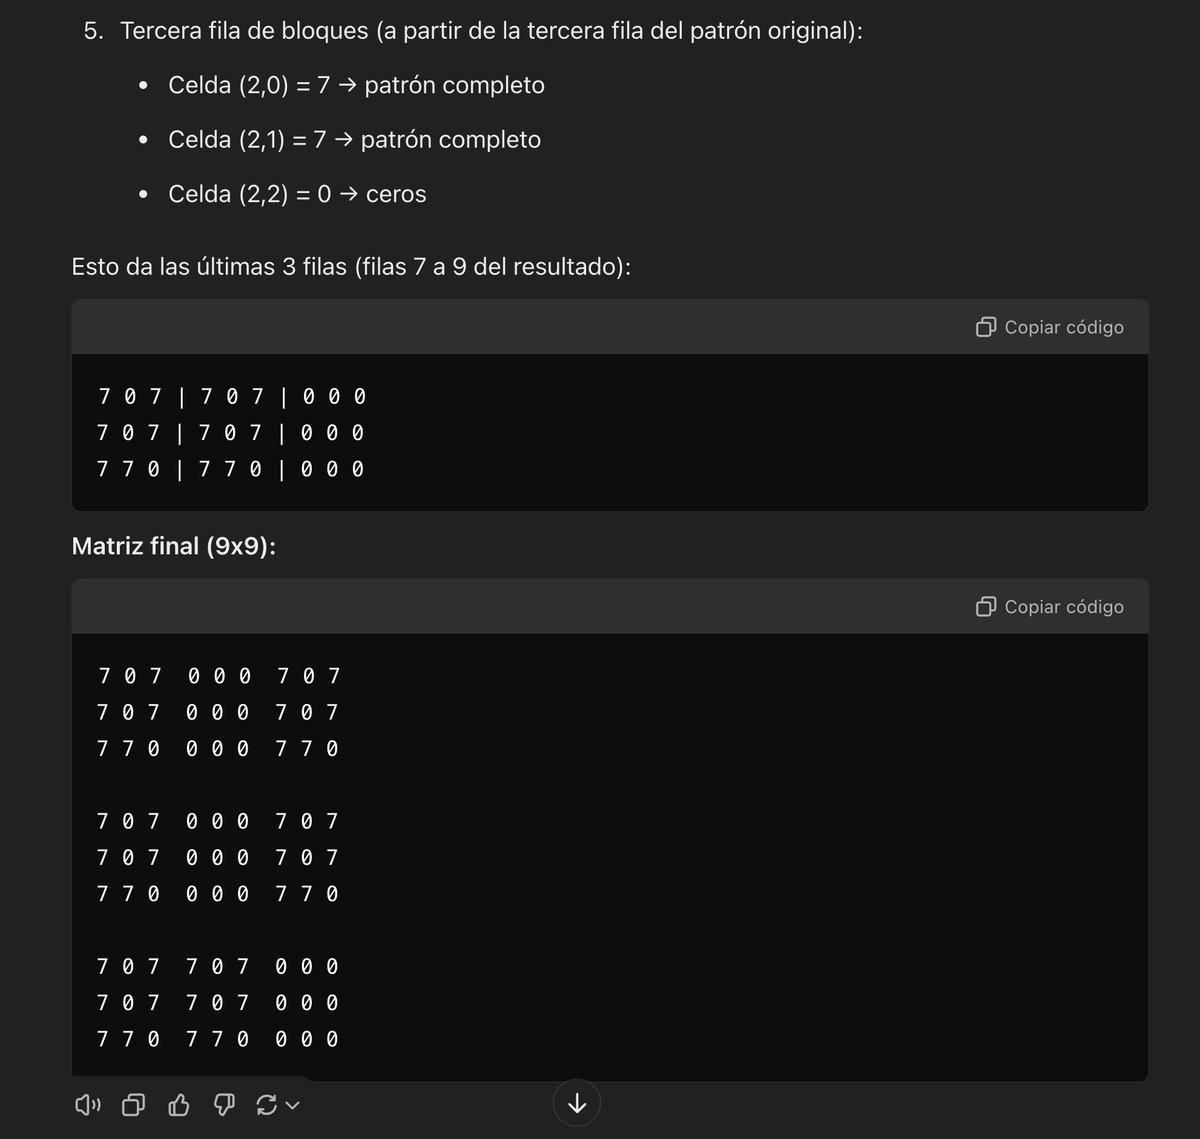
Y con ello, ahora le podemos pasar el input de test para que aplique la transformación que ha descubierto en el paso anterior. En este caso sería correcta.
5
Siendo así he seguido probando con el siguiente test. En este caso con una lógica a descubrir completamente diferente al primero...
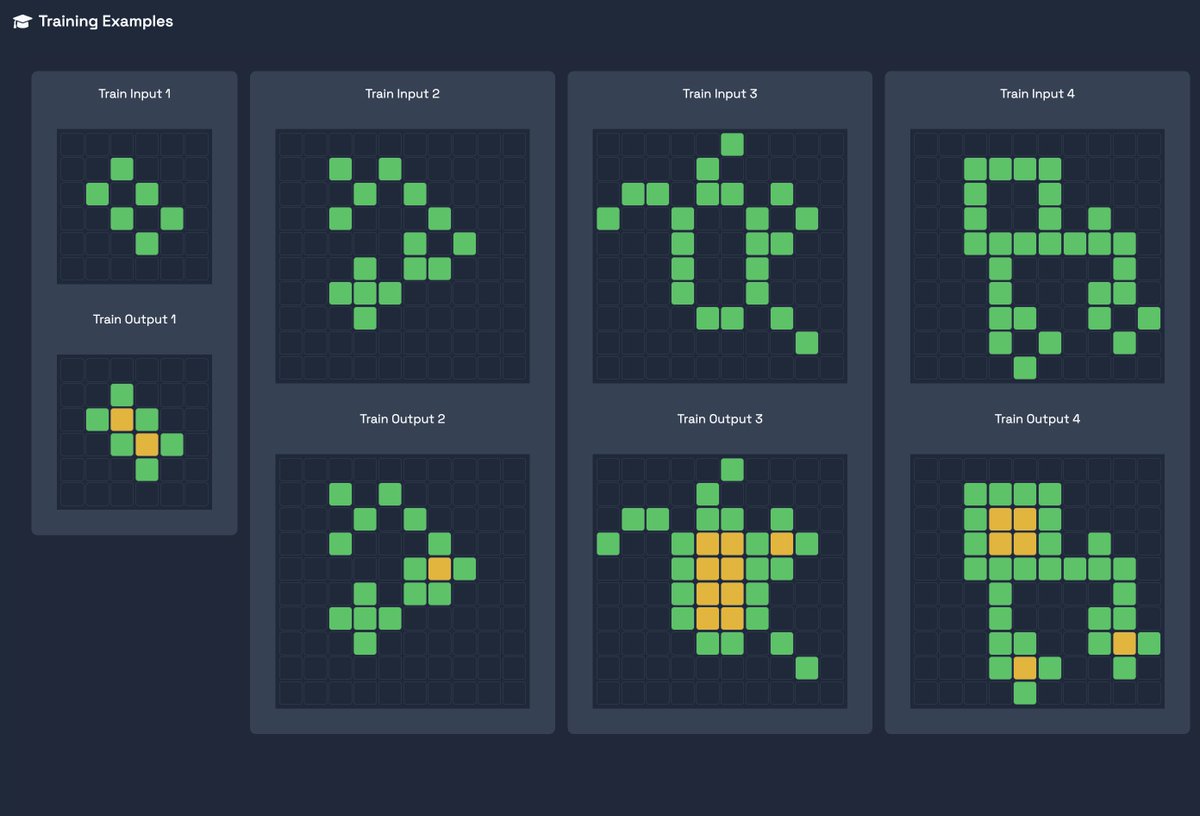
6
Y de nuevo, tras 24 segundos, el modelo parece haber encontrado la lógica de este puzzle. Recordemos, a partir de la representación en texto de la cuadrícula.
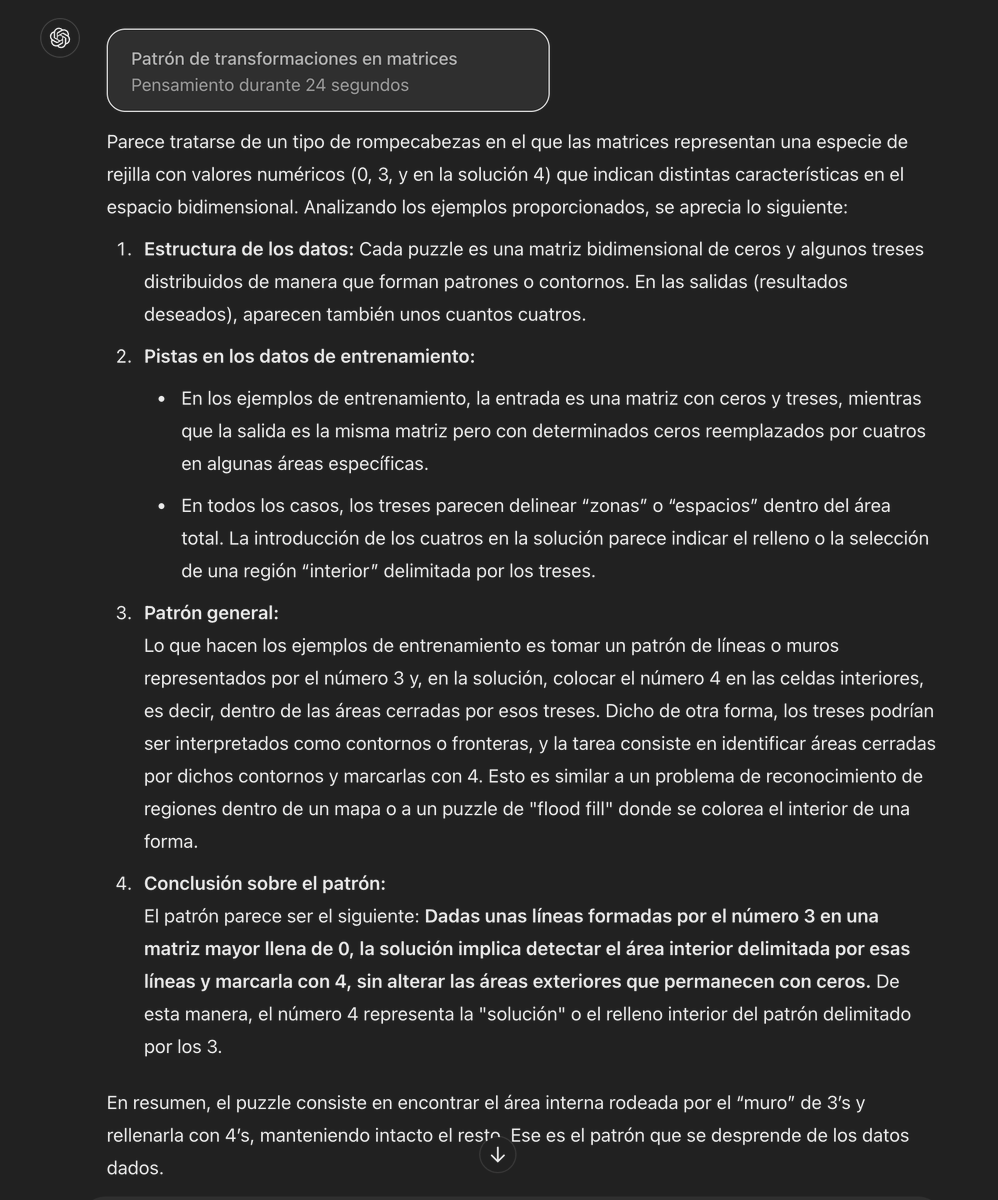
7
Lo curioso es que en este caso el modelo no ha sido capaz de resolver bien el puzzle aplicando la lógica que ha deducido, dejando algunos espacios cerrados sin rellenar.
Imagino que al requerir la solución tener una visión bidimensional del problema, esto de pie a errores.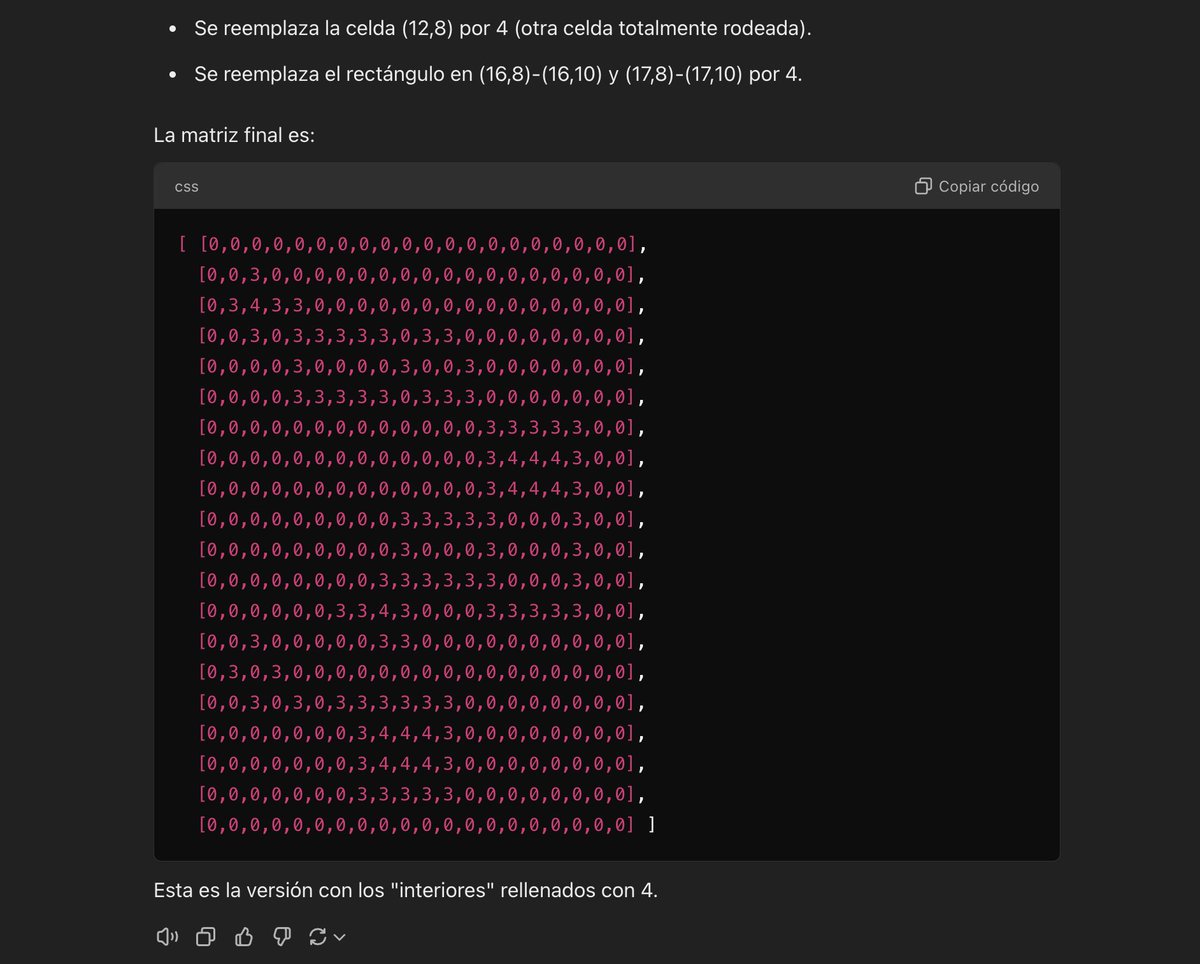
Imagino que al requerir la solución tener una visión bidimensional del problema, esto de pie a errores.
8
Peeeeero siendo la lógica correcta, algo que podemos hacer para circunvalar este último error es pedirle que programe un script que implemente esa lógica, similar a cómo le pedimos a los LLMs que computen en código las operaciones matemáticas para evitar fallos en los cálculos.
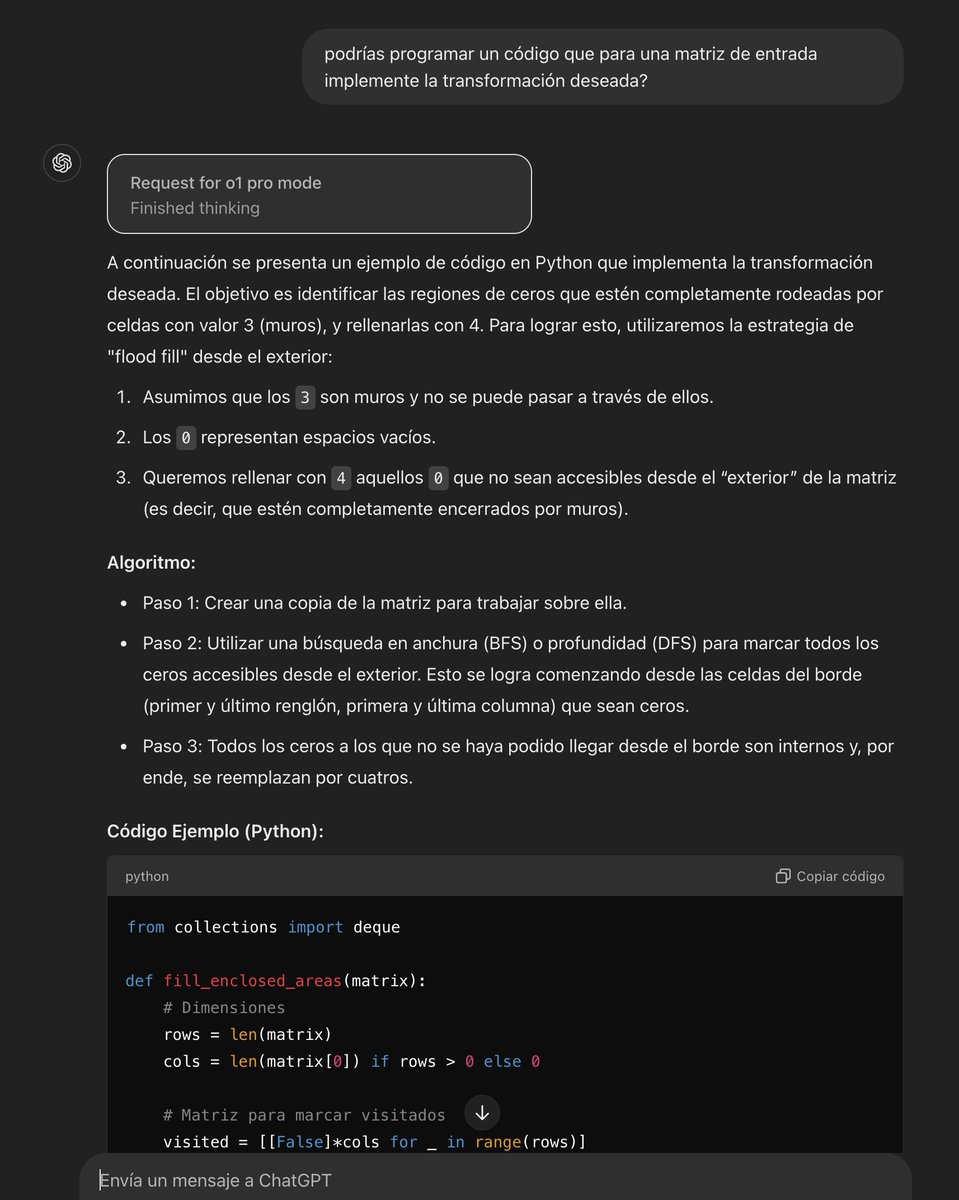
9
Y ahora sí, ejecutando el script que nos ha dado, tenemos de nuevo la solución correcta.
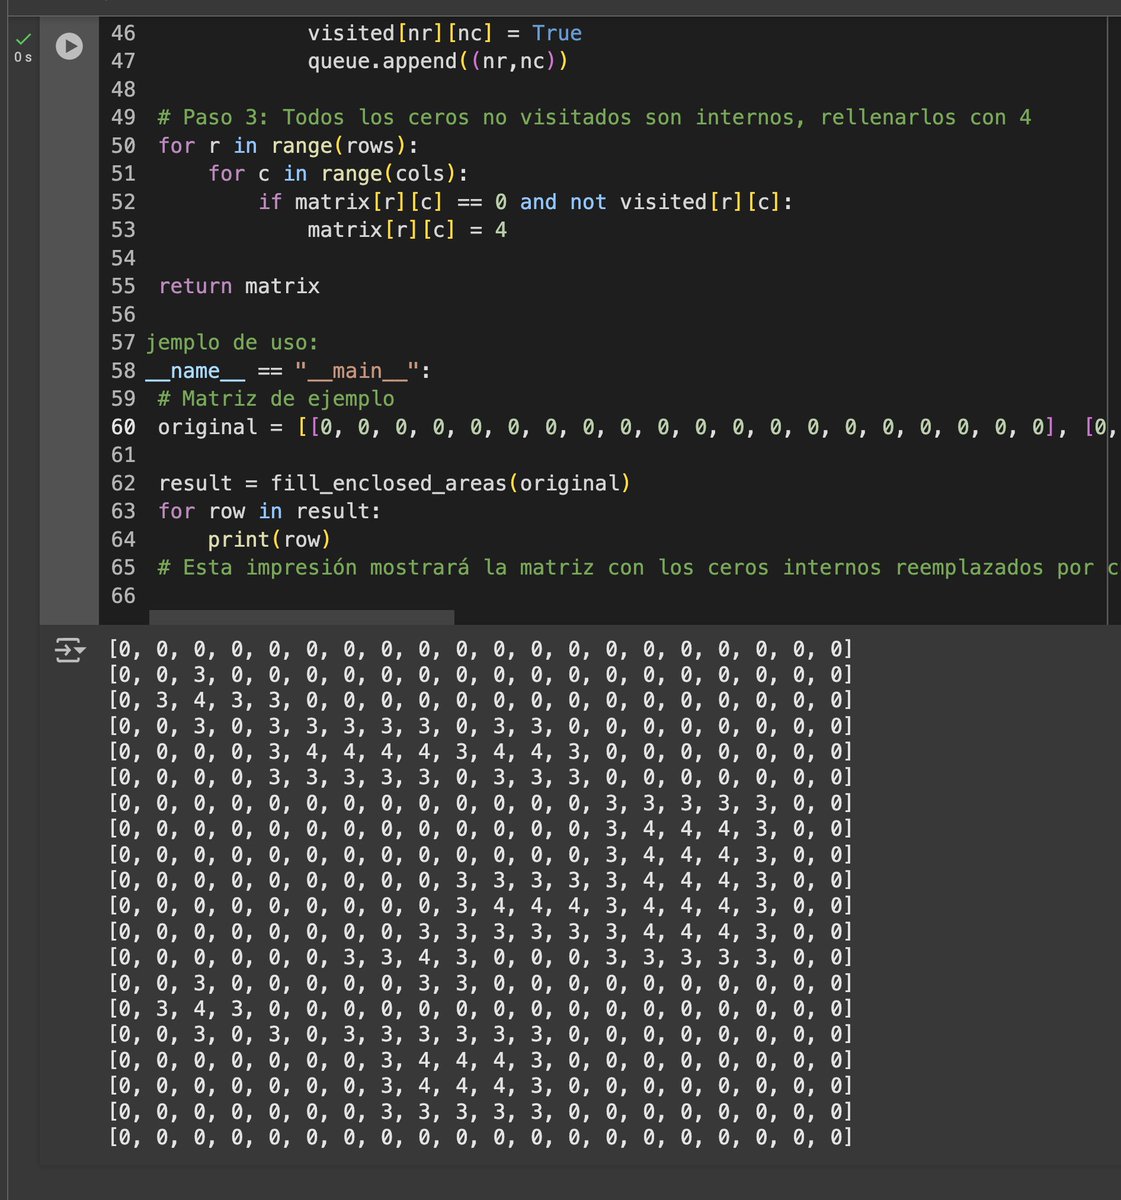
10
Seguiré haciendo pruebas porque con dos ejemplos no podemos concluir nada, y hay que tener presente que también puede haber overfitting en juego.
Pero mis primeras sensaciones es que ARC-AGI no está tan lejos de ser resuelto con los LLMs actuales.

Pero mis primeras sensaciones es que ARC-AGI no está tan lejos de ser resuelto con los LLMs actuales.
François Chollet@fchollet
It's highly plausible that fuzzy pattern matching, when iterated sufficiently many times, can asymptotically turn into reasoning (it's even possible that humans do it basically in this way). But that doesn't mean it's the optimal way to do reasoning.
11
Seguiremos informando 🫡
12
Siguiente ejemplo, ¿muy sencillito no?
Pues aquí o1 no ha terminado de encontrarle la lógica.
No iba mal encaminado, pero a la hora de implementar el código me ha dicho que le faltaba información para implementar correctamente cómo se debe extender el patrón.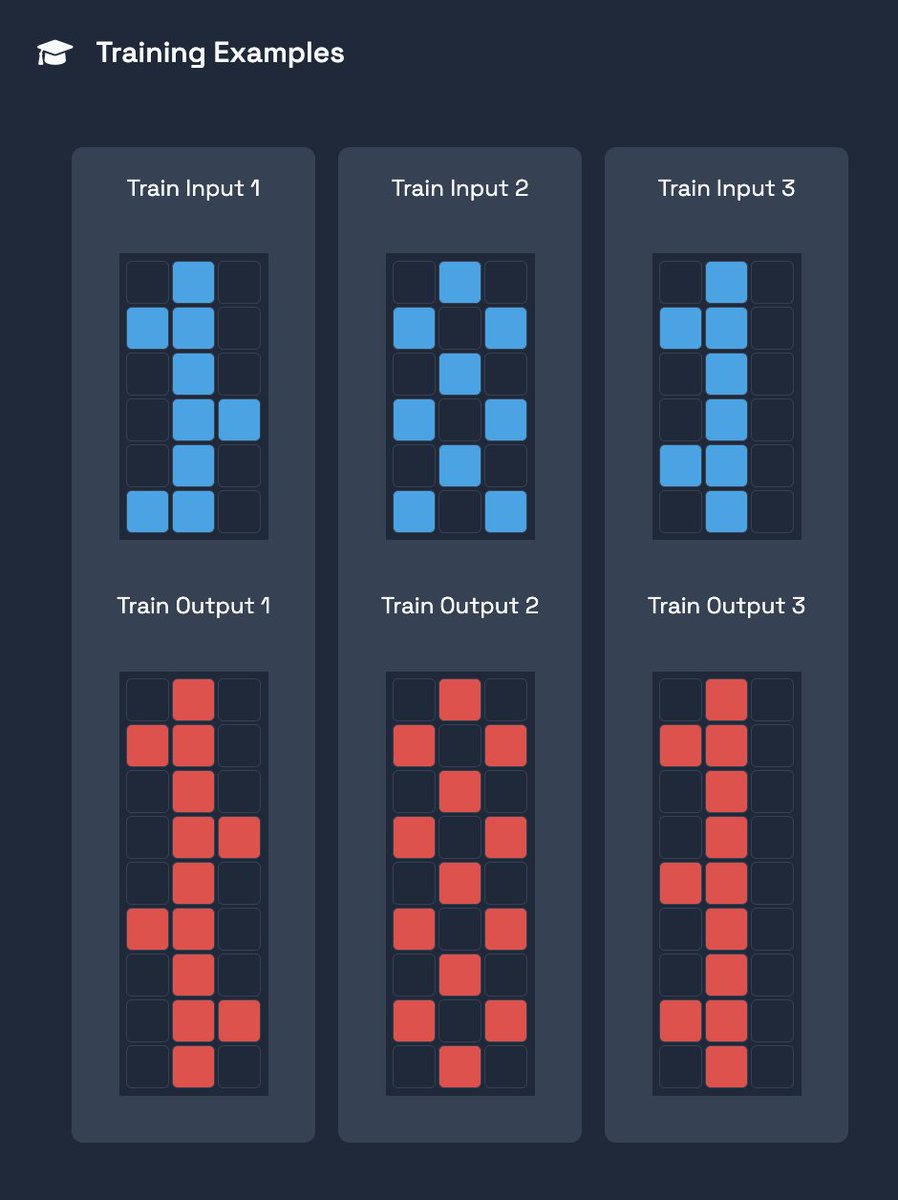
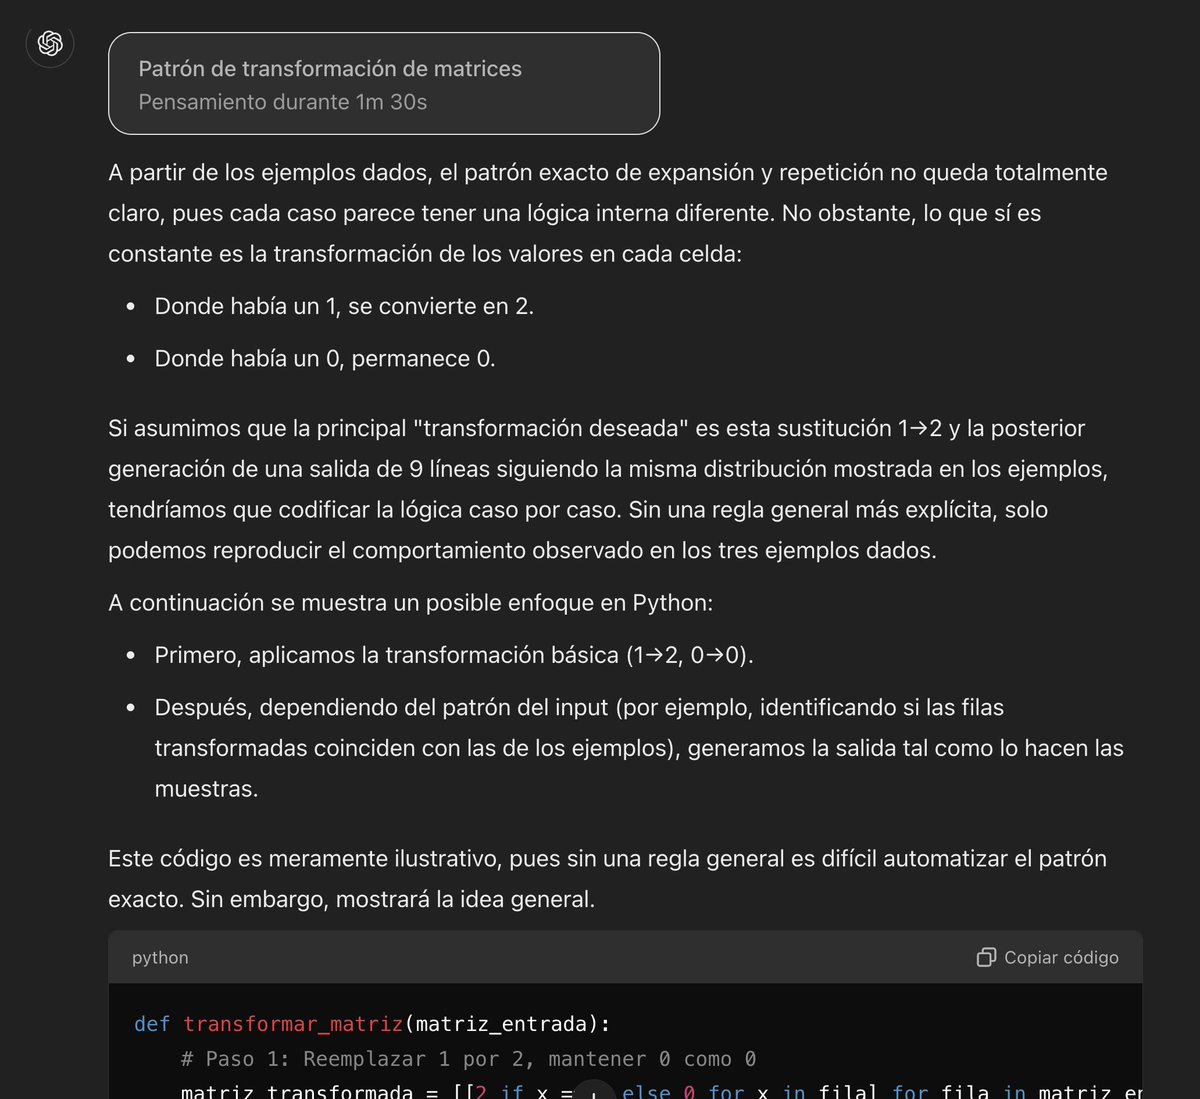
Pues aquí o1 no ha terminado de encontrarle la lógica.
No iba mal encaminado, pero a la hora de implementar el código me ha dicho que le faltaba información para implementar correctamente cómo se debe extender el patrón.
13
Y posiblemente ahí es donde al ver sólo la representación en texto esté perdiendo esa información importante que vista en 2D se hace evidente.
pero esperad... ¡o1 ahora es multimodal!
Y en realidad podemos pasarle tanto la imagen como la representación en texto.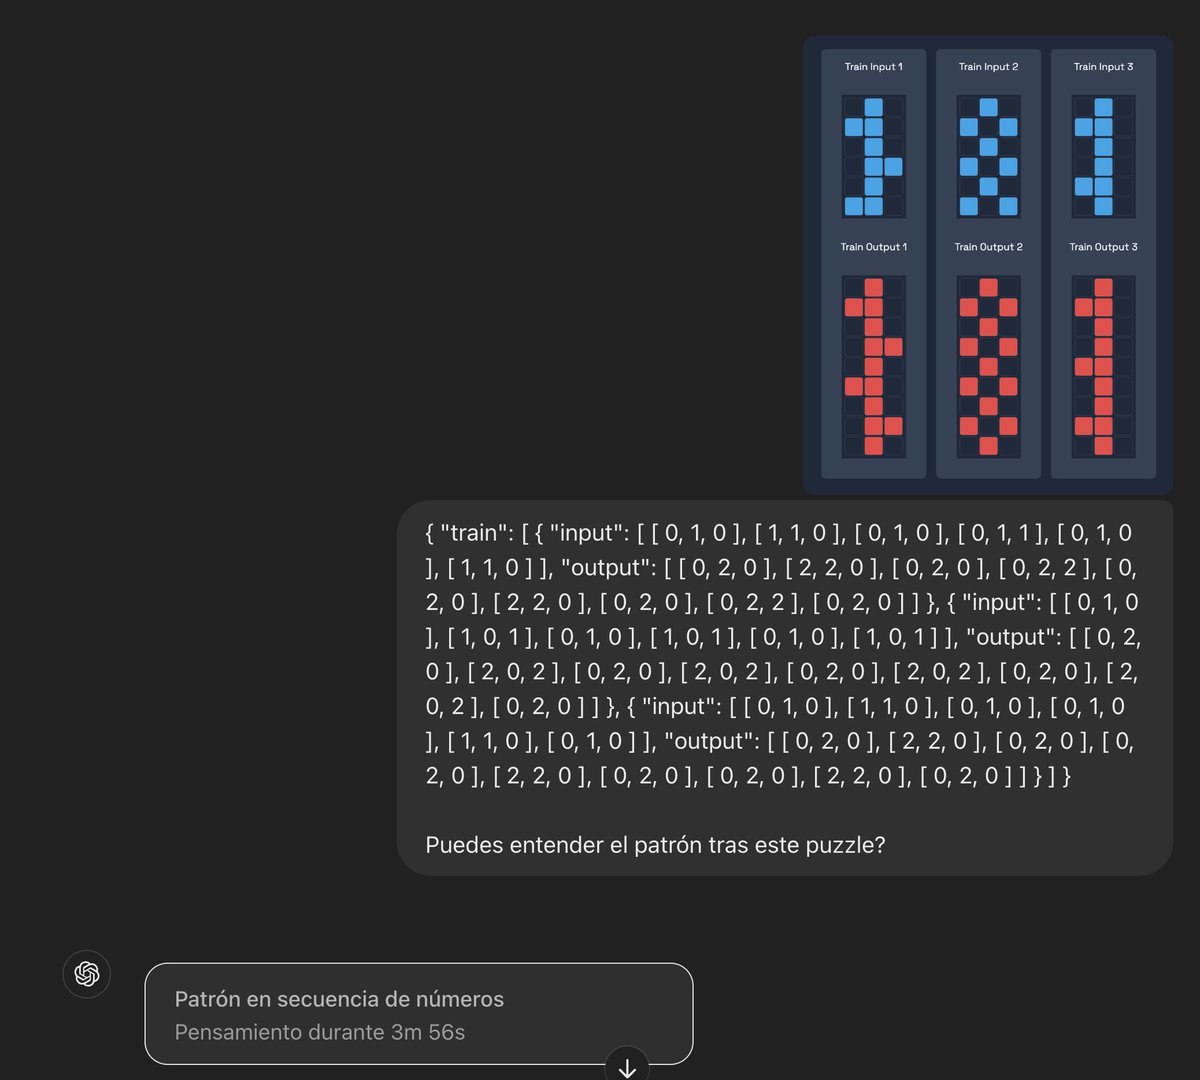
pero esperad... ¡o1 ahora es multimodal!
Y en realidad podemos pasarle tanto la imagen como la representación en texto.
14
Haciendo esto, o1-pro lo resuelve a la primera 👍
15
En el siguiente ejemplo (a mi gusto un poco más complejo que los anteriores) la IA ha planteado dos hipótesis y ha implementado la primera, que no era correcta.
Imagino que con un Code Interpreter integrado que le permita ejecutar y depurar su propio código, se podría acabar solucionando.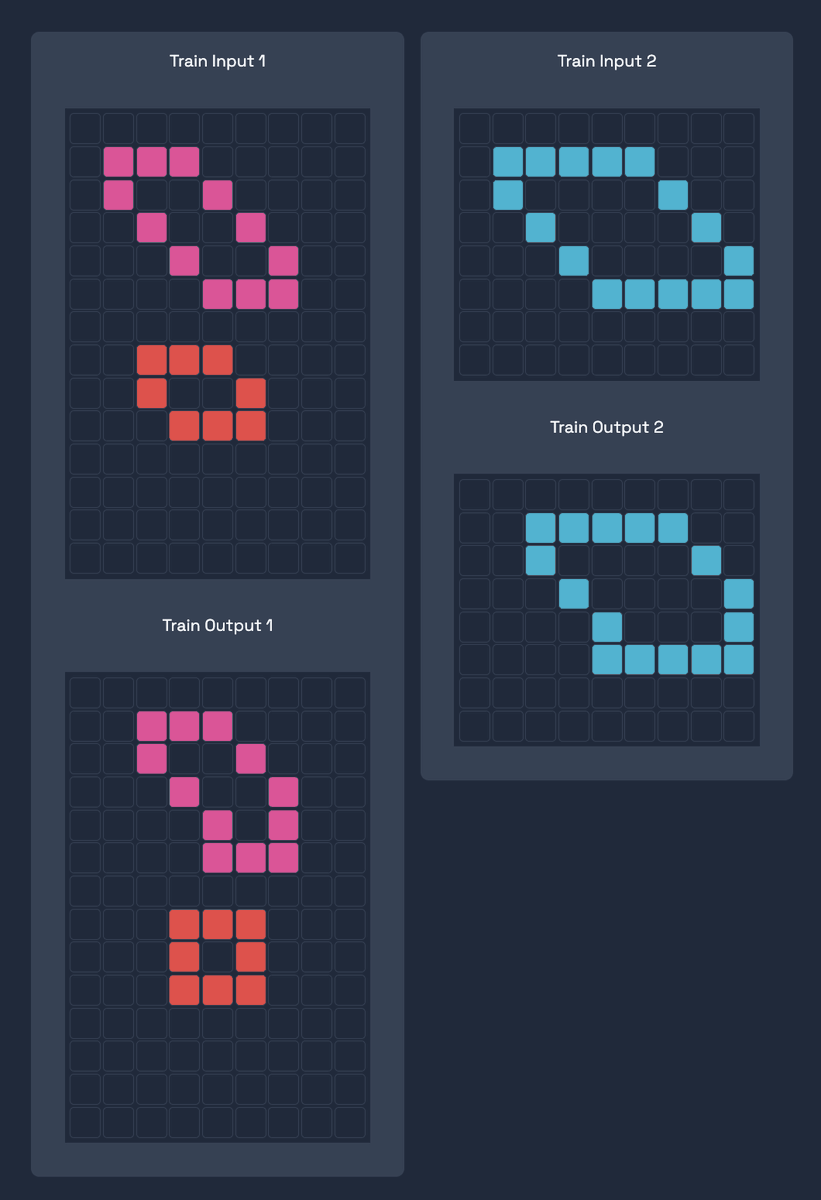

Imagino que con un Code Interpreter integrado que le permita ejecutar y depurar su propio código, se podría acabar solucionando.