#統計 森元良太『統計学再入門』(2024年9月30日)の信頼度の簡易確認。 添付画像はその本のスクショに私が赤を入れたもの。...

黒木玄 Gen Kuroki@genkuroki
82 views
Oct 09, 2024
~2 min read
Advertisement
1
#統計 森元良太『統計学再入門』(2024年9月30日)の信頼度の簡易確認。
添付画像はその本のスクショに私が赤を入れたもの。
ベイズ本人であることの証拠が皆無の怪しげな肖像画が引用されている
だけではなく
リチャード・プライスがジョージ・プライスになっていた!
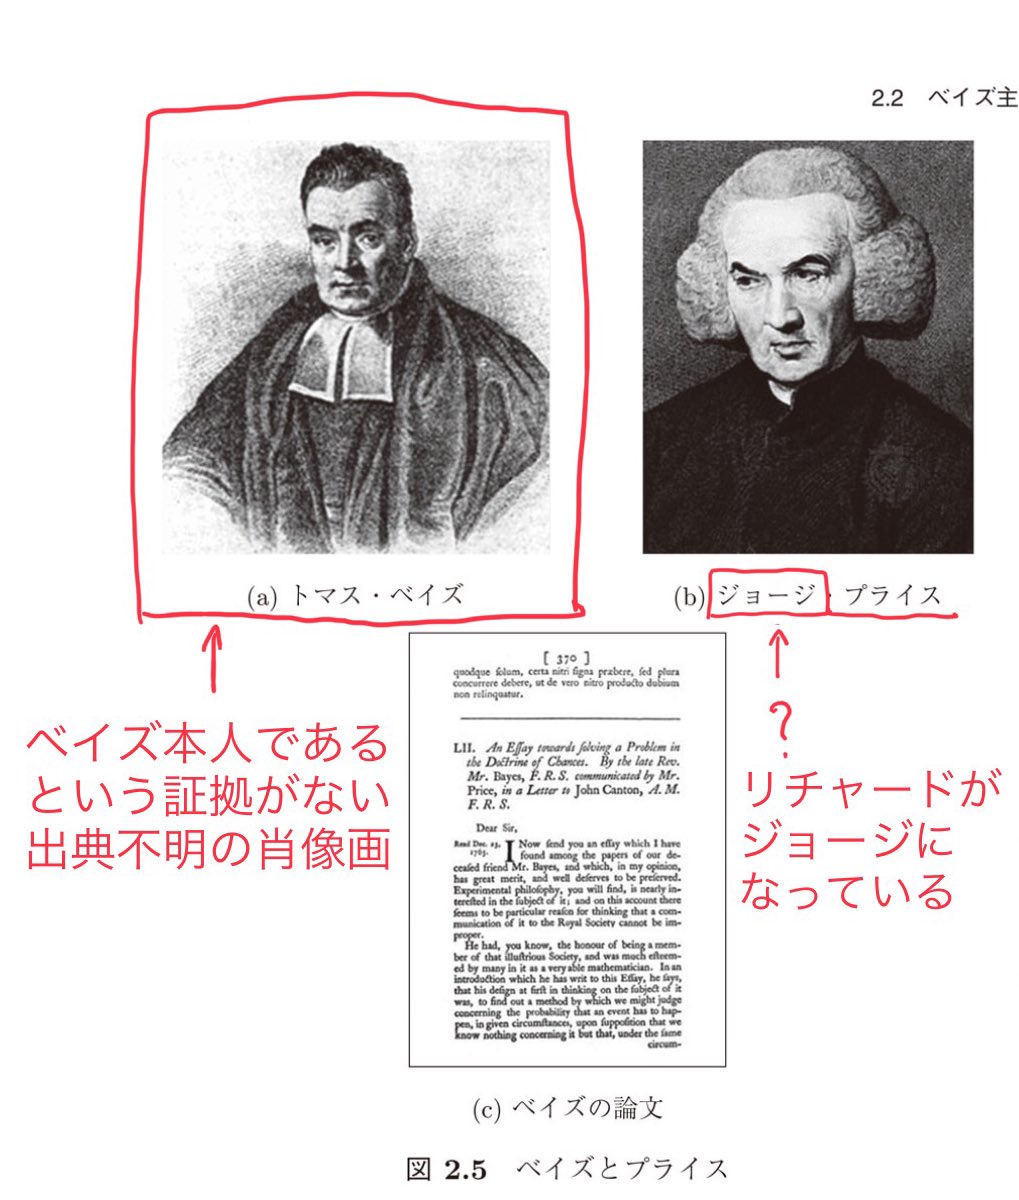

添付画像はその本のスクショに私が赤を入れたもの。
ベイズ本人であることの証拠が皆無の怪しげな肖像画が引用されている
だけではなく
リチャード・プライスがジョージ・プライスになっていた!
黒木玄 Gen Kuroki@genkuroki
#統計 私は添付画像のベイズ本人ではないことがほぼ確実な肖像画を使う人達はそれだけで信用に値しないと思います。
いつもの肖像画を見せることによって、いつもの話をしているという雰囲気を出しながら、いつものデタラメを平気で拡散する人達。
york.ac.uk/depts/maths/hi…
ja.wikipedia.org/wiki/%E3%83%88…
いつもの肖像画を見せることによって、いつもの話をしているという雰囲気を出しながら、いつものデタラメを平気で拡散する人達。
york.ac.uk/depts/maths/hi…
ja.wikipedia.org/wiki/%E3%83%88…
2
#統計 その本の副題は「科学哲学から探る統計思考の原点」。「統計学」の文脈で「哲学」という言葉を見たら要注意。
添付画像はその本のp.90より。
モーメントE((X-μ)ʳ)が(Σ(Xᵢ-μ)ʳ)/nであることになってしまっている。(Σ(Xᵢ-μ)ʳ)/nはXのモーメントそのものではなく、その推定量です。


添付画像はその本のp.90より。
モーメントE((X-μ)ʳ)が(Σ(Xᵢ-μ)ʳ)/nであることになってしまっている。(Σ(Xᵢ-μ)ʳ)/nはXのモーメントそのものではなく、その推定量です。
黒木玄 Gen Kuroki@genkuroki
例えば、『統計学を哲学する』p.17には添付画像のように書いてあります。楕円の長軸と回帰直線が異なることは入門的な話題の一つです。
分布を特徴付ける値をその期待値と呼んでいたりもする。(p.31)
そもそも統計学は【お墨付き】を得るための【特権的な機能】(p.1)を持っていません。
分布を特徴付ける値をその期待値と呼んでいたりもする。(p.31)
そもそも統計学は【お墨付き】を得るための【特権的な機能】(p.1)を持っていません。
3
#統計 確率変数が従う分布のパラメータそのものとパラメータの推定量を厳密に区別することは、統計学入門で最初に学ばなければいけない基本中の基本であり、その本の著者がそのレベルをクリアできていない可能性を疑ってしまいました。
4
#統計 数学に弱くても、歴史的な文献を地道に読んでそのまとめを本に書いてくれることはとてもありがたいことなので、数学に弱いことが原因で生じる初歩的な事柄に関する誤解の確認についてはもっと数学が強い人を頼った方が良いと思いました。
5
#統計 森元『統計学再入門』p.92
n個の観測値でのPearsonのχ²統計量
と
自由度nのχ²分布でのP値
で同じ記号nが使われている。
段落間で記号を共有していないなら誤りではないが、こういう説明の仕方はやめた方がよい。
新たに出てきた記号には説明をつけて、直前の記号との関係にも触れるべき。
n個の観測値でのPearsonのχ²統計量
と
自由度nのχ²分布でのP値
で同じ記号nが使われている。
段落間で記号を共有していないなら誤りではないが、こういう説明の仕方はやめた方がよい。
新たに出てきた記号には説明をつけて、直前の記号との関係にも触れるべき。
6
#統計 【標本と母集団の隔たり】の「母集団」の意味が曖昧に見える。正しい意味は「数学的フィクションであるモデル内での仮想的な母集団」です。確率変数としてのK. Pearsonのχ²統計量は数学的フィクション内の確率変数。
「母集団」と言われると現実の母集団をイメージする人が多いので要注意。
「母集団」と言われると現実の母集団をイメージする人が多いので要注意。
7
#統計 χ²検定のP値は
①現実の母集団に関する数学的なモデルを設定する。
②そのモデル内でχ²分布に(近似的に従う)χ²統計量を定義する。
③そのχ²統計量の値が現実の観察で得た標本の値(データの数値)から計算される値よりも大きくなる確率を(近似的に)求める。
という手続きで得られます。続く
①現実の母集団に関する数学的なモデルを設定する。
②そのモデル内でχ²分布に(近似的に従う)χ²統計量を定義する。
③そのχ²統計量の値が現実の観察で得た標本の値(データの数値)から計算される値よりも大きくなる確率を(近似的に)求める。
という手続きで得られます。続く
8
#統計 その確率(P値)は、①で設定したモデル(数学的フィクション)と現実の観察で得たデータの数値の相性の良さ(compatibility)もしくは整合性や適合度の指標として使われます。
どこからどこまでが数学的フィクション(=モデル)の中での話なのかを明瞭に説明しないと、モデルと現実を混同します。
どこからどこまでが数学的フィクション(=モデル)の中での話なのかを明瞭に説明しないと、モデルと現実を混同します。
9
#統計 『統計学再入門』p.127
帰無仮説有意性検定でも、Neyman-Pearson的な複合対立仮説を考えることが普通です。
例えばモデルのパラメータθに関する
帰無仮説「θ=a」の両側検定の対立仮説「θ≠a」
の実体は
{ 仮説「θ=b」| b≠a }
という無数の仮説達の集合(複合仮説)です。
帰無仮説有意性検定でも、Neyman-Pearson的な複合対立仮説を考えることが普通です。
例えばモデルのパラメータθに関する
帰無仮説「θ=a」の両側検定の対立仮説「θ≠a」
の実体は
{ 仮説「θ=b」| b≠a }
という無数の仮説達の集合(複合仮説)です。
10
#統計 母平均μに関する
帰無仮説「μ=15」
の両側検定での対立仮説は
対立仮説「μ≠15」
とよく書かれますが、対立仮説の実体は「μ=11」「μ=19」…のような無数の対立仮説達の集合
{ 仮説「μ=b」| b≠15 }
で、これを略して「μ≠15」と書いています。
帰無仮説「μ=15」
の両側検定での対立仮説は
対立仮説「μ≠15」
とよく書かれますが、対立仮説の実体は「μ=11」「μ=19」…のような無数の対立仮説達の集合
{ 仮説「μ=b」| b≠15 }
で、これを略して「μ≠15」と書いています。
11
#統計 Neyman-Pearsonの基本問題は、検定法Mをうまく取って、対立仮説の集合に含まれる仮説Kの検出力
power_M(K)=仮説Kの下で帰無仮説が棄却される確率
をKについて一様にできるだけ大きくすることです。
無数の単純対立仮説達を同時に考える点が数学的にややこしい。NPの補題一発で解決しない。
power_M(K)=仮説Kの下で帰無仮説が棄却される確率
をKについて一様にできるだけ大きくすることです。
無数の単純対立仮説達を同時に考える点が数学的にややこしい。NPの補題一発で解決しない。
12
#統計 帰無仮説有意性検定の典型例は、帰無仮説「差はゼロである」と対立仮説「差はゼロでない」の検定です。そのとき、
Neyman-Pearsonの理論と違って
その場合の対立仮説は「差はゼロでない」の1つだけである
と考えてしまう人は
対立仮説の概念をまるっきり何も理解していない
ことになります。
Neyman-Pearsonの理論と違って
その場合の対立仮説は「差はゼロでない」の1つだけである
と考えてしまう人は
対立仮説の概念をまるっきり何も理解していない
ことになります。
13
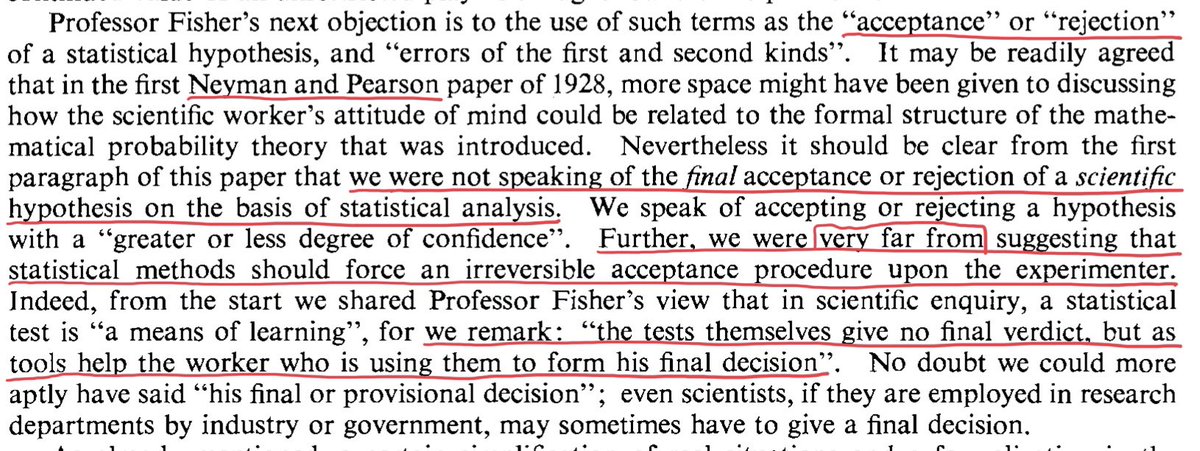
#統計 『統計学再入門』p.157から、Pearson (1955)の翻訳引用部分を孫引き
Pearsonの主張を素直に受け取れば、Neyman-Pearsonの仮説検定が、帰無仮説と対立仮説の片方の採択を強制するかのような解釈は全くのナンセンスで議論する必要がないということになる。しかし、この本では延々と議論している。

Pearsonの主張を素直に受け取れば、Neyman-Pearsonの仮説検定が、帰無仮説と対立仮説の片方の採択を強制するかのような解釈は全くのナンセンスで議論する必要がないということになる。しかし、この本では延々と議論している。
黒木玄 Gen Kuroki@genkuroki
#統計 Pearson (1955)には
NeymanとPearsonは「__最終的な__採択と棄却の話をしていない」し、「仮説検定が不可逆な採択の手続きを強制するべきだとは全然示唆していない」
とはっきり書いてあります。証拠提示終了!
戯画化されたNPについて騙る行為は滅びるべき!
NeymanとPearsonは「__最終的な__採択と棄却の話をしていない」し、「仮説検定が不可逆な採択の手続きを強制するべきだとは全然示唆していない」
とはっきり書いてあります。証拠提示終了!
戯画化されたNPについて騙る行為は滅びるべき!
14
#統計 Neyman-Pearsonの仮説検定の結果が帰無仮説と対立仮説の片方の採択を強制するかのような解説がもしも正しいなら、Neyman-Pearsonの仮説検定の考え方は科学的にクズであることは議論しなくても明らかです。
ところが、わざわざ長々と議論したがる人達がいる。続く
ところが、わざわざ長々と議論したがる人達がいる。続く
15
#統計 そして、Neyman-PearsonのPearsonの論文(1955)を見ると、Neyman-Pearsonの仮説検定の結果は最終的な判断を与えるものではなく、ユーザーの意思決定を助ける道具に過ぎないという常識的に見える考え方が書いてあります。
こういう常識的で合理的な考え方を深掘りして行く方が建設的でしょう。
こういう常識的で合理的な考え方を深掘りして行く方が建設的でしょう。
16
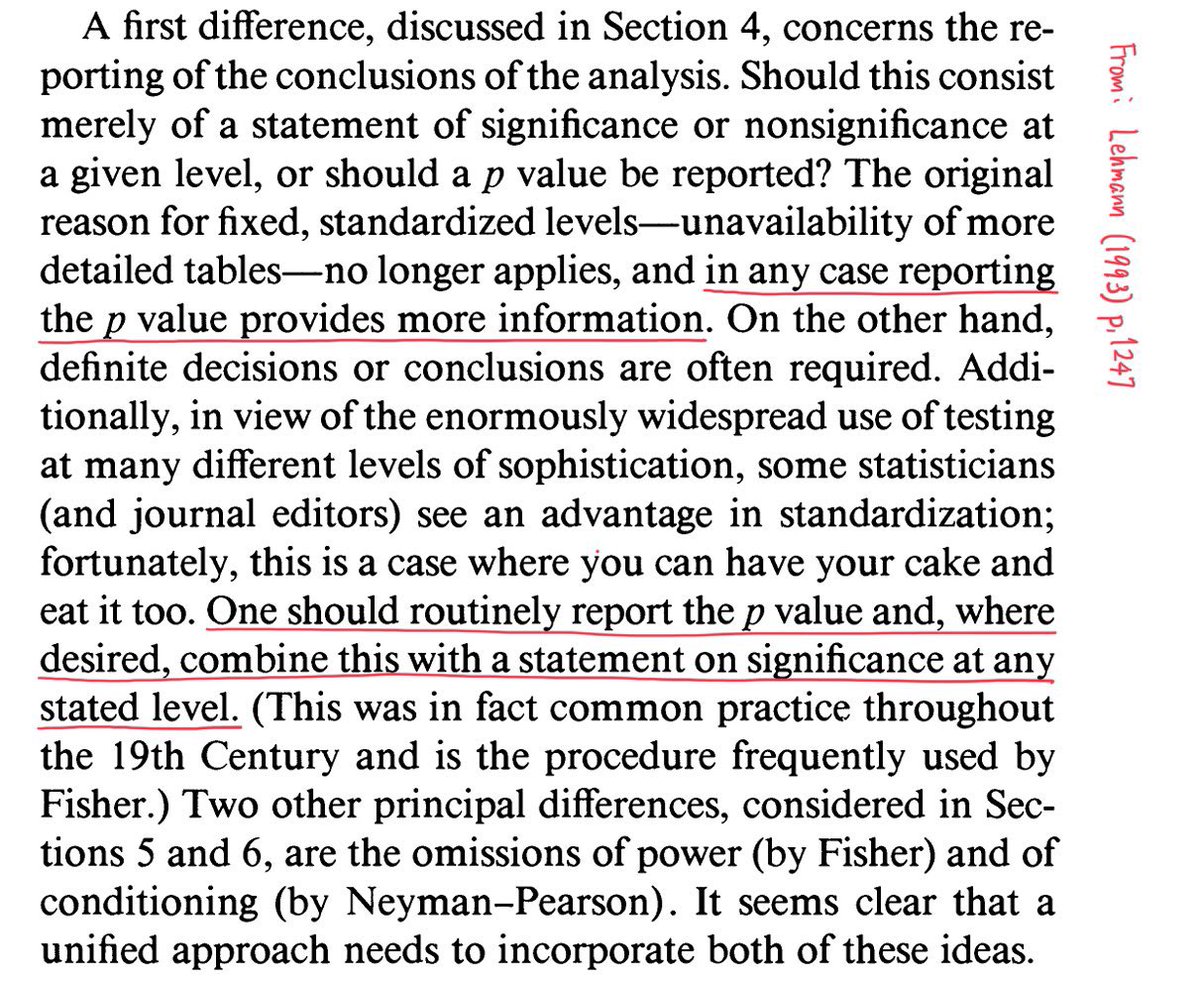
#統計 NPの仮説検定のまともな使い方を示唆しているPearson (1955) やそれを引用しているNeymanの高弟のLehmannの論文(1993)には、固定された水準での二分法の結果だけではなく、P値を報告する方が良いと書いてあることなどから、「NP vs. Fisher」の不毛な対立図式を語る必要はもうないと思います。
黒木玄 Gen Kuroki@genkuroki
#統計 要するにP値を1つ報告するだけで「すべての有意水準での仮説検定の結果」を報告したことになります。
Neymanの弟子のLehmannも、通常はP値を報告するべきだと言っています。
errorstatistics.com/wp-content/upl…
Neymanの弟子のLehmannも、通常はP値を報告するべきだと言っています。
errorstatistics.com/wp-content/upl…
17
#統計 大体において、「哲学」という用語が出て来る統計学の解説は、ASA声明(2016) scholar.google.co.jp/scholar?cluste… やnature誌(2019)の統計的有意性に反対する記事 scholar.google.co.jp/scholar?cluste… (およびその共著者達の他の論文)で否定されている考え方を取り上げ直して延々と議論しているという印象がある。
18
#統計 nature(2019)の統計的有意性に反対する非常に穏健で常識的な内容の記事の出版を主導したのは、超大物のSander Greenlandさんです。検索すればツイッターでも署名を募っていたことが分かります。すごいパワー!
そのGreenlandさんの考え方については講演スライド(2022)が非常にわかりやすい。

そのGreenlandさんの考え方については講演スライド(2022)が非常にわかりやすい。
黒木玄 Gen Kuroki@genkuroki
#統計 お勧めのGreenlandさんの講演スライドより
P値を推定のための道具として扱わない誤りの繰り返しはやめるべき。
「差がない」という帰無仮説のnull P値単体を帰無仮説有意性検定(NHST)で使うだけなのは誤解の主な原因になっている。
biostatistics.ucdavis.edu/sites/g/files/…
P値を推定のための道具として扱わない誤りの繰り返しはやめるべき。
「差がない」という帰無仮説のnull P値単体を帰無仮説有意性検定(NHST)で使うだけなのは誤解の主な原因になっている。
biostatistics.ucdavis.edu/sites/g/files/…
19
#統計 nature(2019)の統計的有意性に反対する記事の共著者の一人であるGreenlandさんは自分が関与した論文では「有意」(significant)という用語を決して使わないように気を付けて来たと言っています。
「有意」の語を避けたければGreenlandさんの論文を参考にすれば良いでしょう。

「有意」の語を避けたければGreenlandさんの論文を参考にすれば良いでしょう。
黒木玄 Gen Kuroki@genkuroki
#統計 Sander Greenlandさん(超大物)は、論文の編集時には「有意」(significant)の語をすべて削除して来たそうです。
そういう編集に同意が得られず、共著者から自分の名前を削除させた場合が一度だけあるらしい😅
添付画像 discourse.datamethods.org/t/principles-a… の終わりの2つの段落とその機械翻訳。
そういう編集に同意が得られず、共著者から自分の名前を削除させた場合が一度だけあるらしい😅
添付画像 discourse.datamethods.org/t/principles-a… の終わりの2つの段落とその機械翻訳。
20
#統計 「有意」(significant)という語の使用を避けるべきだと言っているGreenlandさんはP値がどのような意味で有用な道具であるかについても非常に詳しく説明しており、非常に建設的です。
21
#統計
P値について信頼区間の側から解説したスレッド
↓
P値について信頼区間の側から解説したスレッド
↓
黒木玄 Gen Kuroki@genkuroki
#統計 所謂「頻度論」の信頼区間についてもベイズ統計での事後分布のように使える道具があります。
それは岩田健太郎先生も確実に知っているものです。
もしも知らないなら統計学について完全な無知なままで研究をしていることになります。
問題: さてそれは何でしょうか?
解答の解説に続く!
それは岩田健太郎先生も確実に知っているものです。
もしも知らないなら統計学について完全な無知なままで研究をしていることになります。
問題: さてそれは何でしょうか?
解答の解説に続く!
22
#統計 基本的に一発の統計分析には再現性を確率的に保証するだけの力はないという当たり前の話を当然の前提にした上で「再現性の危機」について考える必要があることも多くの場合に見逃されています。
Amrhein-Trafimow-Greenland 2019が非常に良いです。
Amrhein-Trafimow-Greenland 2019が非常に良いです。
23
#統計 「3つの問い」で有名なRoyall氏の著作についてもGreenlandさんが正しいと思います。
常識的に否定されて当然の考え方をビッグネームを持ち出して引っ張り出して議論したりせずに、Greenlandさん達のように科学的な常識に沿った議論を行うべきだと思います。
常識的に否定されて当然の考え方をビッグネームを持ち出して引っ張り出して議論したりせずに、Greenlandさん達のように科学的な常識に沿った議論を行うべきだと思います。
24
#統計 Greenland-Hofman 2019 link.springer.com/article/10.100… より(MC=多重比較)
【頻度主義とベイズの区別は技術的な違いであり、哲学的な違いではない】
【「統計の哲学」は健全な方法の探求というよりも神学に似ている】


【頻度主義とベイズの区別は技術的な違いであり、哲学的な違いではない】
【「統計の哲学」は健全な方法の探求というよりも神学に似ている】
黒木玄 Gen Kuroki@genkuroki
#統計 Greenland-Hofman 2019より(MC=多重比較)
【頻度主義とベイズの区別は技術的な違いであり、哲学的な違いではない】
【「統計の哲学」は健全な方法の探求というよりも神学に似ている】
【頻度主義とベイズの区別は技術的な違いであり、哲学的な違いではない】
【「統計の哲学」は健全な方法の探求というよりも神学に似ている】
25
#統計 21世紀における統計学の健全な使い方に関する議論を眺めると、鉤括弧付きの「統計学の哲学」的な言説の悪影響を払拭しなければいけないという問題があることが分かります。
真の「統計学再入門」にはそういう視点も必要だと思います。
真の「統計学再入門」にはそういう視点も必要だと思います。
26
#統計 補足
P値が有用な道具であること
と
「統計的有意」と言うことが有害であること
はシンプルに整合的な主張になることにも注意が必要なのですが大丈夫か?
P値が帰無仮説有意性検定のための道具だと信じている人はP値に関する理解度が低すぎる。
P値が有用な道具であること
と
「統計的有意」と言うことが有害であること
はシンプルに整合的な主張になることにも注意が必要なのですが大丈夫か?
P値が帰無仮説有意性検定のための道具だと信じている人はP値に関する理解度が低すぎる。
27
#統計 P値はモデルとデータの数値の相性の良さ(compatibility)を測る指標の1つなので、P値を使う話題で使用するモデルの話(多くの場合にモデルの妥当性は保証されない)もしないと何も説明したことにならない。
そして、検定する仮説はモデルのパラメータの値の設定に関する仮説になります。
そして、検定する仮説はモデルのパラメータの値の設定に関する仮説になります。
28
#統計 閾値のαを設けて、仮説θ=aの(両側)P値がα未満かどうかを見ることは、特定のモデルの下で、仮説θ=aはデータの数値と(閾値αで)相性が悪いとみなされるかどうかを見ていることになります。
相性の良し悪しについての二分法に過ぎないので、仮説自体は肯定も否定もされない。
相性の良し悪しについての二分法に過ぎないので、仮説自体は肯定も否定もされない。
29
#統計 続き。しかし、使用した特定のモデルが他での経験から十分に役に立つものだと分かっているなら、そのモデルの下で、仮説θ=aの各々とデータの数値の間の相性の良さの様子の定量化のまとめの報告はさらなる研究の発展に貢献する可能性が高くなります。
これがP値の無難な使い方です。
これがP値の無難な使い方です。
30
#統計
統計学を科学的お墨付きが得られる道具であるかのように扱うことはやめるべき。
P値がどういう道具であるかについて語るときにも、確率的なお墨付きが得られる道具であるかのように誤解させないように注意するべき。
統計学を科学的お墨付きが得られる道具であるかのように扱うことはやめるべき。
P値がどういう道具であるかについて語るときにも、確率的なお墨付きが得られる道具であるかのように誤解させないように注意するべき。
31
#統計 補足
ベイズ主義に触れる場合には、Savageの主観ベイズ主義による意思決定論(期待リスク最小化)は、事前分布を含むモデル内部の「小さな世界」でのみ通用することについてもコメントしておかないとまずい。
ベイズ主義に触れる場合には、Savageの主観ベイズ主義による意思決定論(期待リスク最小化)は、事前分布を含むモデル内部の「小さな世界」でのみ通用することについてもコメントしておかないとまずい。
32
#統計 『統計学再入門』を読んだときにも、
「哲学的」な雰囲気で統計学について語るためには
データの数値の取得の適切さについても
モデルの妥当性についても怪しいことが普通の
実践的な統計学について有害な考え方を温存しなければいけない
のだろうなと思いました。
「哲学的」な雰囲気で統計学について語るためには
データの数値の取得の適切さについても
モデルの妥当性についても怪しいことが普通の
実践的な統計学について有害な考え方を温存しなければいけない
のだろうなと思いました。
33
#統計 現代的なP値の解釈(本質的にASA声明の原則1)は
P値はデータの数値と特定のモデルとそのパラメータの値に関する仮説の相性の良さ(compatibility)を表す。
これと整合性がない事柄について触れる場合には「ASA声明に反する内容であること」をきちんと断っておかないとまずいです。
P値はデータの数値と特定のモデルとそのパラメータの値に関する仮説の相性の良さ(compatibility)を表す。
これと整合性がない事柄について触れる場合には「ASA声明に反する内容であること」をきちんと断っておかないとまずいです。
黒木玄 Gen Kuroki@genkuroki
#統計 閾値のαを設けて、仮説θ=aの(両側)P値がα未満かどうかを見ることは、特定のモデルの下で、仮説θ=aはデータの数値と(閾値αで)相性が悪いとみなされるかどうかを見ていることになります。
相性の良し悪しについての二分法に過ぎないので、仮説自体は肯定も否定もされない。
相性の良し悪しについての二分法に過ぎないので、仮説自体は肯定も否定もされない。
34
#統計 P値の小ささはパラメータの値に関する仮説の怪しさを直接に表しておらず、データの数値と特定のモデルとそのパラメータの値に関する仮説の相性の悪さ(incompatibility)を表すに過ぎないことを認めた途端に、P値<5%か否かで仮説の正誤について確率的判断を下すことが誤りであることは自明になる。
35
#統計 だから、P値<5%であるときにそれだけで帰無仮説を否定することは誤りになります。ASA声明にもそう書いてあります。
これは常識的に当たり前の話で、P値<5%なだけで帰無仮説を否定できると思っていた人は常識的な思考をできなくなっています。そういう人達が多いのでASA声明が作られた。

これは常識的に当たり前の話で、P値<5%なだけで帰無仮説を否定できると思っていた人は常識的な思考をできなくなっています。そういう人達が多いのでASA声明が作られた。
黒木玄 Gen Kuroki@genkuroki
#統計 佐藤俊哉さんの講義動画で
* 有意な検定結果(P≤0.05)は帰無仮説が誤りであり、棄却するべきであることを意味する
は誤解の典型例という扱いになっています。その理由は背後の仮定の全体(モデルの全体)に配慮していない内容になっているからです。
* 有意な検定結果(P≤0.05)は帰無仮説が誤りであり、棄却するべきであることを意味する
は誤解の典型例という扱いになっています。その理由は背後の仮定の全体(モデルの全体)に配慮していない内容になっているからです。
36
#統計 P値≥5%のときに帰無仮説が正しいと判断することが誤りなだけではなく、P値<5%なだけで帰無仮説が誤りだと判断することも科学的に有害なのでやってはいけない。(教科書には間違った考え方が書いてある。)
上で紹介した佐藤俊哉先生の講義動画でも教科書が間違っていると言っています。
上で紹介した佐藤俊哉先生の講義動画でも教科書が間違っていると言っています。
37
#統計 ASA声明以後の流れを知っていると、「Fisher vs. Neyman-Pearson」という対立図式を持ち出されても、すでに否定されていることをビッグネームの力で復活させることによってのみ可能なつまらない話にしか見えない。予定通りのストーリーに載せるためにPearson (1955)の内容も素直に受け取らない。
38
#統計 頻度論での長期的最適性とか主観ベイズ主義での期待リスク最小化などは全て現実ではなく、モデル内部の「小さな世界」における最適性でしかありません。
こういうことを当然の前提にしてしまっても、ありがちな「哲学的」な統計学の解説はだいたい潰れるよね。
こういうことを当然の前提にしてしまっても、ありがちな「哲学的」な統計学の解説はだいたい潰れるよね。
39
#統計 引用されている
芝村(2004a) p.104
は
amazon.co.jp/R-%E3%83%95%E3…
のことなのですが、歪度と尖度について添付画像のような説明が本当に書いてあるかどうか確認できた人はその結果を教えて下さい。

芝村(2004a) p.104
は
amazon.co.jp/R-%E3%83%95%E3…
のことなのですが、歪度と尖度について添付画像のような説明が本当に書いてあるかどうか確認できた人はその結果を教えて下さい。
黒木玄 Gen Kuroki@genkuroki
#統計 その本の副題は「科学哲学から探る統計思考の原点」。「統計学」の文脈で「哲学」という言葉を見たら要注意。
添付画像はその本のp.90より。
モーメントE((X-μ)ʳ)が(Σ(Xᵢ-μ)ʳ)/nであることになってしまっている。(Σ(Xᵢ-μ)ʳ)/nはXのモーメントそのものではなく、その推定量です。
添付画像はその本のp.90より。
モーメントE((X-μ)ʳ)が(Σ(Xᵢ-μ)ʳ)/nであることになってしまっている。(Σ(Xᵢ-μ)ʳ)/nはXのモーメントそのものではなく、その推定量です。
40
#統計 解説
期待値μと標準偏差σを持つ確率変数Xについて
(歪度) = E[((X-μ)/σ)³],
(尖度) = E[((X-μ)/σ)⁴] - 3.
これは
log E[exp(t(X-μ)/σ)] = t²/2 + (歪度) t³/3! + (尖度) t⁴/4! + O(t⁵)
と同値です。後者の式から歪度と尖度はXが従う分布と正規分布の違いの指標であることが分かる。
期待値μと標準偏差σを持つ確率変数Xについて
(歪度) = E[((X-μ)/σ)³],
(尖度) = E[((X-μ)/σ)⁴] - 3.
これは
log E[exp(t(X-μ)/σ)] = t²/2 + (歪度) t³/3! + (尖度) t⁴/4! + O(t⁵)
と同値です。後者の式から歪度と尖度はXが従う分布と正規分布の違いの指標であることが分かる。
41
#統計 独立同分布なX₁,…,Xₙについて、X̅=(X+⋯+Xₙ)/nとおくと、n→∞のとき、
log E[exp(t(X̅-μ)/(σ/√n))]
= t²/2 + ((歪度)/√n) t³/3! + ((尖度)/n) t⁴/4! + O(n⁻³ᐟ²)
→ t²/2
となることが簡単に分かります。これは中心極限定理の証明になっている。(ただし本当はFourier解析が必要)
log E[exp(t(X̅-μ)/(σ/√n))]
= t²/2 + ((歪度)/√n) t³/3! + ((尖度)/n) t⁴/4! + O(n⁻³ᐟ²)
→ t²/2
となることが簡単に分かります。これは中心極限定理の証明になっている。(ただし本当はFourier解析が必要)
42
#統計 公式
log E[exp(t(X̅-μ)/(σ/√n))]
= t²/2 + ((歪度)/√n) t³/3! + ((尖度)/n) t⁴/4! + O(n⁻³ᐟ²)
は歪度と尖度と
中心極限定理による正規分布近似の誤差
の関係も与えています。それぞれ1/√n, 1/nのオーダーで効いて来る。
単に正規分布に近付くと言うよりもこちらの方が優れている。
log E[exp(t(X̅-μ)/(σ/√n))]
= t²/2 + ((歪度)/√n) t³/3! + ((尖度)/n) t⁴/4! + O(n⁻³ᐟ²)
は歪度と尖度と
中心極限定理による正規分布近似の誤差
の関係も与えています。それぞれ1/√n, 1/nのオーダーで効いて来る。
単に正規分布に近付くと言うよりもこちらの方が優れている。
43
#統計 中心極限定理は定義が異なる量達の振る舞いがn→∞で漸近的に一致することを示すためによく使われます。
この「定義が異なる量達の振る舞いがn→∞で漸近的に一致する」という事実は重要で、定義に戻って「定義が違うから違う」と説明するとミスリーディングになる場合が出て来ます。
この「定義が異なる量達の振る舞いがn→∞で漸近的に一致する」という事実は重要で、定義に戻って「定義が違うから違う」と説明するとミスリーディングになる場合が出て来ます。
44
#統計 数学に弱い人が統計学の学習中に論理的な厳密さを気にして、2つの量の「定義が違うこと」を確認して、「ゆえに全然違う」と結論すると誤りになる場合があります。
例えば、非ベイズの信用区間とベイズの信用区間は「全然違う」と考えるのは誤りです。
例えば、非ベイズの信用区間とベイズの信用区間は「全然違う」と考えるのは誤りです。
45
#統計 科学者は「1か0か」の二分法を好まず、「量的にどの程度か」という考え方をします。
だから、「定義の違い」という「1か0か」の二分法が可能なことで結論を出し続けると酷いことになります。定義が全然異なる2つの量のありがちなケースでの近似関係を考慮に入れないとダメです。
だから、「定義の違い」という「1か0か」の二分法が可能なことで結論を出し続けると酷いことになります。定義が全然異なる2つの量のありがちなケースでの近似関係を考慮に入れないとダメです。
46
#統計 現代的な統計学の基礎である確率論は「定義が全然違っている量達がn→∞で漸近的に同じように振る舞う」の形式の定理の宝庫です。
中心極限定理はその典型例。
この辺は数学に強くないと相当に苦しいので、数学に弱い人達は常に強い人に助けを求める必要があると思います。
中心極限定理はその典型例。
この辺は数学に強くないと相当に苦しいので、数学に弱い人達は常に強い人に助けを求める必要があると思います。
47
#統計 数学が強い人達が一般にやりたがらない傾向がある「現代的には時代遅れの昔の偉人達が書いたものを読んでまとめること」をやってくれる人も必要。
しかしそういう仕事が杜撰になるのは非常にまずい。
特に自分のストーリーにとって不都合な文献の内容を素直に受け取らずに軽く扱うのはまずい。
しかしそういう仕事が杜撰になるのは非常にまずい。
特に自分のストーリーにとって不都合な文献の内容を素直に受け取らずに軽く扱うのはまずい。
黒木玄 Gen Kuroki@genkuroki
#統計 『統計学再入門』p.157から、Pearson (1955)の翻訳引用部分を孫引き
Pearsonの主張を素直に受け取れば、Neyman-Pearsonの仮説検定が、帰無仮説と対立仮説の片方の採択を強制するかのような解釈は全くのナンセンスで議論する必要がないということになる。しかし、この本では延々と議論している。
Pearsonの主張を素直に受け取れば、Neyman-Pearsonの仮説検定が、帰無仮説と対立仮説の片方の採択を強制するかのような解釈は全くのナンセンスで議論する必要がないということになる。しかし、この本では延々と議論している。
48
#統計 あと、1次のモーメント(確率変数の期待値と同じ)を標本平均の式で表したり、中心がμの2,3,4次のモーメントを(μの値を仮に既知としたときの)標本から得られるそれらの推定量の式で表していたことは非常に印象が悪い。
母集団分布そのものとそこから抽出した標本の区別は統計学では超基本的です。
母集団分布そのものとそこから抽出した標本の区別は統計学では超基本的です。
黒木玄 Gen Kuroki@genkuroki
#統計 その本の副題は「科学哲学から探る統計思考の原点」。「統計学」の文脈で「哲学」という言葉を見たら要注意。
添付画像はその本のp.90より。
モーメントE((X-μ)ʳ)が(Σ(Xᵢ-μ)ʳ)/nであることになってしまっている。(Σ(Xᵢ-μ)ʳ)/nはXのモーメントそのものではなく、その推定量です。
添付画像はその本のp.90より。
モーメントE((X-μ)ʳ)が(Σ(Xᵢ-μ)ʳ)/nであることになってしまっている。(Σ(Xᵢ-μ)ʳ)/nはXのモーメントそのものではなく、その推定量です。
49
#統計 Neyman-Pearsonによる複合仮説としての対立仮説の設定の典型例は、統計学入門の教科書にある片側検定と両側検定の場合であることさえ知らずに、検定論に関する「哲学」を論じているように見えたことの印象も最悪。
本当は標準的な検定論を理解しているなら、そのことが分かるように書くべき。
本当は標準的な検定論を理解しているなら、そのことが分かるように書くべき。
黒木玄 Gen Kuroki@genkuroki
#統計 『統計学再入門』p.127
帰無仮説有意性検定でも、Neyman-Pearson的な複合対立仮説を考えることが普通です。
例えばモデルのパラメータθに関する
帰無仮説「θ=a」の両側検定の対立仮説「θ≠a」
の実体は
{ 仮説「θ=b」| b≠a }
という無数の仮説達の集合(複合仮説)です。
帰無仮説有意性検定でも、Neyman-Pearson的な複合対立仮説を考えることが普通です。
例えばモデルのパラメータθに関する
帰無仮説「θ=a」の両側検定の対立仮説「θ≠a」
の実体は
{ 仮説「θ=b」| b≠a }
という無数の仮説達の集合(複合仮説)です。
50
#統計 母分散が既知σ²=30の正規分布モデルでの母平均μに関する検定を例に説明します。
帰無仮説や対立仮説は可能なμの値全体の集合ℝの部分集合によって与えられます。
例えばNeyman-Pearsonの補題が直接適用できるのは
{170}⊂ℝ ↦ 帰無仮説μ=170
{180}⊂ℝ ↦ 対立仮説μ=180
のような場合。続く
帰無仮説や対立仮説は可能なμの値全体の集合ℝの部分集合によって与えられます。
例えばNeyman-Pearsonの補題が直接適用できるのは
{170}⊂ℝ ↦ 帰無仮説μ=170
{180}⊂ℝ ↦ 対立仮説μ=180
のような場合。続く
黒木玄 Gen Kuroki@genkuroki
#統計 『統計学再入門』p.127
帰無仮説有意性検定でも、Neyman-Pearson的な複合対立仮説を考えることが普通です。
例えばモデルのパラメータθに関する
帰無仮説「θ=a」の両側検定の対立仮説「θ≠a」
の実体は
{ 仮説「θ=b」| b≠a }
という無数の仮説達の集合(複合仮説)です。
帰無仮説有意性検定でも、Neyman-Pearson的な複合対立仮説を考えることが普通です。
例えばモデルのパラメータθに関する
帰無仮説「θ=a」の両側検定の対立仮説「θ≠a」
の実体は
{ 仮説「θ=b」| b≠a }
という無数の仮説達の集合(複合仮説)です。
51
#統計
片側検定の場合の例:
{170}⊂ℝ ↦ 帰無仮説μ=170
{μ|μ>170}⊂ℝ ↦ 対立仮説μ>170
対立仮説は実質的に170より大きなbに関する無数の単純仮説μ=b全体の集合になります。
以下のような設定でも検定法は同じになります:
{μ|μ≤170}⊂ℝ ↦ 帰無仮説μ≤170
{μ|μ>170}⊂ℝ ↦ 対立仮説μ>170
片側検定の場合の例:
{170}⊂ℝ ↦ 帰無仮説μ=170
{μ|μ>170}⊂ℝ ↦ 対立仮説μ>170
対立仮説は実質的に170より大きなbに関する無数の単純仮説μ=b全体の集合になります。
以下のような設定でも検定法は同じになります:
{μ|μ≤170}⊂ℝ ↦ 帰無仮説μ≤170
{μ|μ>170}⊂ℝ ↦ 対立仮説μ>170
52
#統計
両側検定の場合の例:
{170}⊂ℝ ↦ 帰無仮説μ=170
{μ|μ≠170}⊂ℝ ↦ 対立仮説μ≠170
対立仮説は数値b≠170に関する無数の単純仮説μ=b全体の集合であると考えます。
ずっと詳しい説明がLehmannさんの超有名な教科書にあります。検定論について語りたい人は必読。
google.com/search?q=Lehma…
両側検定の場合の例:
{170}⊂ℝ ↦ 帰無仮説μ=170
{μ|μ≠170}⊂ℝ ↦ 対立仮説μ≠170
対立仮説は数値b≠170に関する無数の単純仮説μ=b全体の集合であると考えます。
ずっと詳しい説明がLehmannさんの超有名な教科書にあります。検定論について語りたい人は必読。
google.com/search?q=Lehma…
53
#統計 21世紀現代における検定や信頼区間に関する議論についてはSander Greenlandさんの講演スライドもしくはそこで引用されている文献群が基本的。
そういう現代的議論を無視して「Fisher vs. Neyman-Pearson」の対立図式について語る伝統芸を披露するのはやめた方がよい。
biostatistics.ucdavis.edu/sites/g/files/…
そういう現代的議論を無視して「Fisher vs. Neyman-Pearson」の対立図式について語る伝統芸を披露するのはやめた方がよい。
biostatistics.ucdavis.edu/sites/g/files/…
54
#統計 biostatistics.ucdavis.edu/sites/g/files/… にある文献表
"instructors" が赤字で強調されている。
統計学の解説の仕事をする人はこの講演スライドには目を通しておいた方が良いです。伝統的な統計学の教え方の多くを否定しています。
"instructors" が赤字で強調されている。
統計学の解説の仕事をする人はこの講演スライドには目を通しておいた方が良いです。伝統的な統計学の教え方の多くを否定しています。
55
#統計 biostatistics.ucdavis.edu/sites/g/files/… の終わりの方では、実践的な統計学の運用に必須の統計的因果推論の入門的解説がされています。

56
#統計 GreenlandさんはPearlさんとRobinsの3人組で疫学に因果推論を導入したことでも有名です。因果推論についてはその影響で生まれた研究群を見た方が多分分かりやすい。というか、実践例を見ないと理解できない。
超お勧めの本
↓
『極論で語る予防医療』

超お勧めの本
↓
『極論で語る予防医療』
黒木玄 Gen Kuroki@genkuroki
#統計 #医学書だが実は一般向けの本でもある
これは非常に面白い本。売れると良い本。
【医学書となりますが、臨床医学でなく、どなたでも読めます】と著者が言う通りの本です。
maruzen-publishing.co.jp/item/?book_no=…
極論で語る予防医療
濱谷 陸太 著
香坂 俊 監修
龍華 朱音 イラスト
丸善出版
2024年7月
これは非常に面白い本。売れると良い本。
【医学書となりますが、臨床医学でなく、どなたでも読めます】と著者が言う通りの本です。
maruzen-publishing.co.jp/item/?book_no=…
極論で語る予防医療
濱谷 陸太 著
香坂 俊 監修
龍華 朱音 イラスト
丸善出版
2024年7月
57
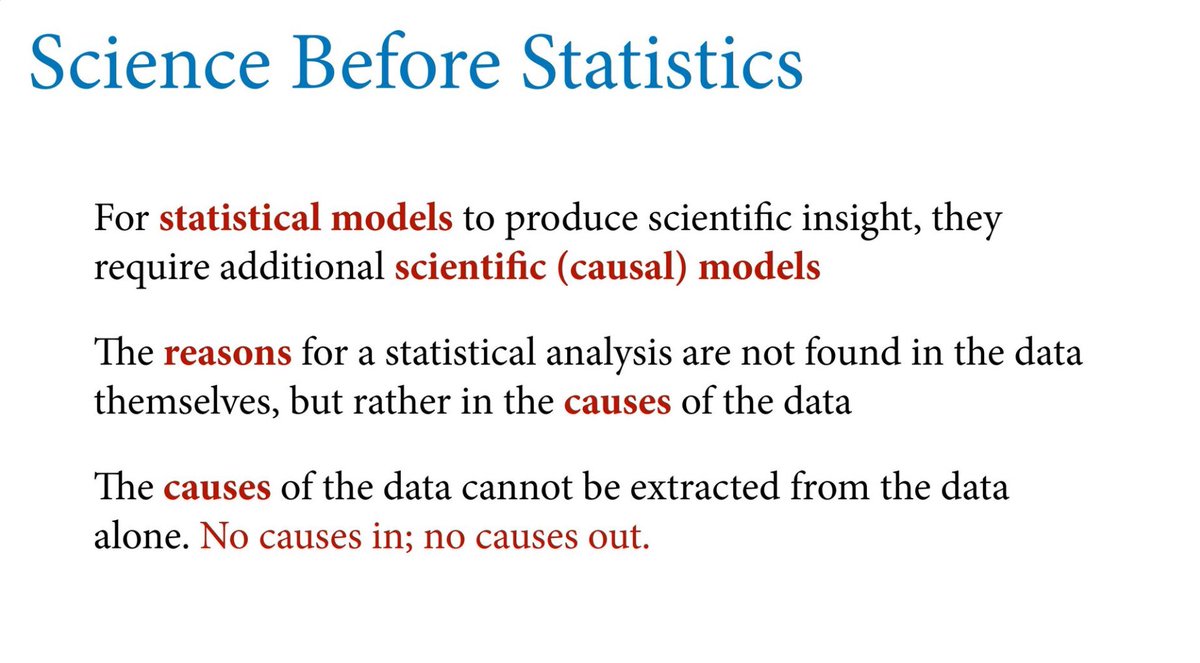
#統計 因果推論についてはMcElreathさんのStatistical Rethinkingも面白いです。
github.com/rmcelreath/sta…
のLecture 1より
↓

github.com/rmcelreath/sta…
のLecture 1より
↓
黒木玄 Gen Kuroki@genkuroki
#統計 これはMcElreathさんのStatistical Rethinkingの講義(世界的に大人気)の最初の方にあるページです。
Science before Statistics
の合言葉は因果推論と無関係に私は非常に基本的で重要だと思っています。
添付画像 github.com/rmcelreath/sta… Lecture 1より
Science before Statistics
の合言葉は因果推論と無関係に私は非常に基本的で重要だと思っています。
添付画像 github.com/rmcelreath/sta… Lecture 1より
58
#統計 統計学に再入門するなら、Greenlandさんの講演スライドを読んだり、McElreathさんのStatistical Rethinkingの講義をYouTubeで聴くのが良いと私なら思います。
59
『極論で語る予防医療』は医学書という分類ですが、自分の健康を気にしている人達が知りたいことについてどういうことがわかっているかに関する情報を超圧縮して大量に紹介してくれています。
因果推論に興味がない人でも面白く読めます。
情報量の多さに「こんな本、よく書いたな!」という感じ。
因果推論に興味がない人でも面白く読めます。
情報量の多さに「こんな本、よく書いたな!」という感じ。
黒木玄 Gen Kuroki@genkuroki
#統計 #医学書だが実は一般向けの本でもある
これは非常に面白い本。売れると良い本。
【医学書となりますが、臨床医学でなく、どなたでも読めます】と著者が言う通りの本です。
maruzen-publishing.co.jp/item/?book_no=…
極論で語る予防医療
濱谷 陸太 著
香坂 俊 監修
龍華 朱音 イラスト
丸善出版
2024年7月
これは非常に面白い本。売れると良い本。
【医学書となりますが、臨床医学でなく、どなたでも読めます】と著者が言う通りの本です。
maruzen-publishing.co.jp/item/?book_no=…
極論で語る予防医療
濱谷 陸太 著
香坂 俊 監修
龍華 朱音 イラスト
丸善出版
2024年7月
60
#統計 他にも、統計学再入門のためには、最新の宇宙怪人しまりす本も適していると思います。
asakura.co.jp/detail.php?boo…
宇宙怪人しまりす
統計よりも重要なことを学ぶ
佐藤俊哉
2024
非常にお勧め↑
この手の最新の優れた文献を見るとどれもGreenlandさんの考え方と概ね同じであることがわかります。
asakura.co.jp/detail.php?boo…
宇宙怪人しまりす
統計よりも重要なことを学ぶ
佐藤俊哉
2024
非常にお勧め↑
この手の最新の優れた文献を見るとどれもGreenlandさんの考え方と概ね同じであることがわかります。
61
#統計 Greenlandさんにしても、佐藤俊哉さんにしても、教科書に書いてあるようなこと(例えば「P値<5%ならば帰無仮説を否定して良い」など)は当然否定していて、単体のP値ではなくP値関数全体を使い、因果推論は当然の道具であり、データの取得の仕方などに十分に気を使う。
科学的には常識的。
科学的には常識的。
62
#統計 そういう科学的合理性の観点から明らかに優れている人達の議論と比較すると、今更「Fisher vs. Neyman-Pearson」の対立について語る伝統芸はほとんど意味がないように見えます。
そこにMcElreathさんのStatistical Rethinkingを追加するとなおさらそう見えて来る。
そこにMcElreathさんのStatistical Rethinkingを追加するとなおさらそう見えて来る。
63
#統計 頻度論について語るときに
固定された仮説(例えばμ=170)に関する単独の両側P値がα未満かどうかを見るだけの話にするようでは全然ダメ
で
例えば任意の数値aに関する仮説μ=a達のP値全体を考えた人だけが、Greenlandさん達のような考え方をしている人達に追い付いている
と言えます。
固定された仮説(例えばμ=170)に関する単独の両側P値がα未満かどうかを見るだけの話にするようでは全然ダメ
で
例えば任意の数値aに関する仮説μ=a達のP値全体を考えた人だけが、Greenlandさん達のような考え方をしている人達に追い付いている
と言えます。
64
#統計 「Fisher vs. Neyman-Pearson」の対立について語る伝統芸能をどんなに披露しても、検定法と区間推定法が表裏一体(双対)の関係になっていることを意識したP値の健全な使い方に到達することは不可能だと思います。
そろそろその伝統芸能はやめた方が良い。
そろそろその伝統芸能はやめた方が良い。
黒木玄 Gen Kuroki@genkuroki
#統計 お勧めのGreenlandさんの講演スライドより
P値を推定のための道具として扱わない誤りの繰り返しはやめるべき。
「差がない」という帰無仮説のnull P値単体を帰無仮説有意性検定(NHST)で使うだけなのは誤解の主な原因になっている。
biostatistics.ucdavis.edu/sites/g/files/…
P値を推定のための道具として扱わない誤りの繰り返しはやめるべき。
「差がない」という帰無仮説のnull P値単体を帰無仮説有意性検定(NHST)で使うだけなのは誤解の主な原因になっている。
biostatistics.ucdavis.edu/sites/g/files/…
65
肖像画関連
66
#統計 P値関数の概念の解説
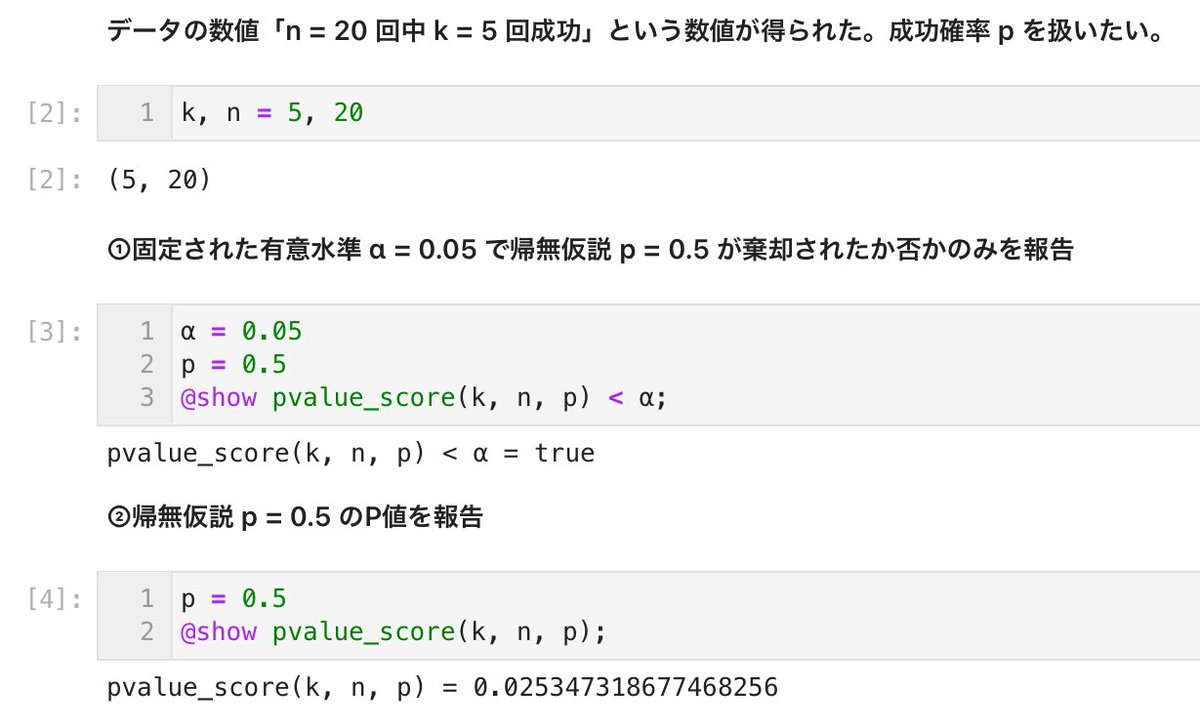
黒木玄 Gen Kuroki@genkuroki
#統計 P値関数の概念に至るまで
①固定された有意水準α(例えばα=5%)で、帰無仮説θ=0が棄却されるか否かの2値的情報だけを報告。
②帰無仮説θ=0のP値を報告。そのP値は帰無仮説θ=0が棄却される有意水準の下限なので、固定されていないすべての有意水準で棄却されるか否かを報告するのと同じ。
①固定された有意水準α(例えばα=5%)で、帰無仮説θ=0が棄却されるか否かの2値的情報だけを報告。
②帰無仮説θ=0のP値を報告。そのP値は帰無仮説θ=0が棄却される有意水準の下限なので、固定されていないすべての有意水準で棄却されるか否かを報告するのと同じ。
67
#統計 特定の仮説が成立しているかどうかという2値的な事柄のみを主に扱うことは、科学について語るときにはやめた方がよい。
程度問題を扱う数学(解析学)は複雑なので、程度問題も無数の仮説「θ=a」の成否で扱えるとは考えない方がよい。必要な数学がかなり違う。解析学の土俵で考えるべきです。
程度問題を扱う数学(解析学)は複雑なので、程度問題も無数の仮説「θ=a」の成否で扱えるとは考えない方がよい。必要な数学がかなり違う。解析学の土俵で考えるべきです。
68
#統計 例えばベイズ統計について語るときに、仮説M₁,M₂,M₃,…の成否に関する主観的事前確率がデータによって更新されるという確証理論的なイメージで考えると、実際には連続無限個のパラメータの値を扱っていることが原因で生じる数学的に複雑な事柄を見逃してしまいます。
69
#統計 統計学について語るときにも、特定の単純仮説(たとえば「コイン投げで表の出る確率はp=1/2」の類)の成否について考える(例えば検定法)というイメージで説明すると、科学的に普通の考え方は「表の出る確率はどの程度か」の方なので、道を誤ってしまいます。
70
#統計
P値関数(=信頼区間関数)の概念の説明も疫学の教科書では普通。
閾値を設けて「統計的に有意」「有意でない」などと言うことへの厳しい批判も疫学では普通。
その辺りのことを「統計学の哲学」的伝統芸は、既存のストーリーのパターンに合致しないせいで、取り込めていないのだろうか?
P値関数(=信頼区間関数)の概念の説明も疫学の教科書では普通。
閾値を設けて「統計的に有意」「有意でない」などと言うことへの厳しい批判も疫学では普通。
その辺りのことを「統計学の哲学」的伝統芸は、既存のストーリーのパターンに合致しないせいで、取り込めていないのだろうか?
71
#統計 通常は科学研究においては候補として挙がっている仮説M₁,M₂,M₃,…は全部間違っています。
まぐれあたりの可能性を増やすために候補になる仮説を増やすと、その分だけベイズ更新の収束は遅くなります。
こういう解析学的な問題を無視した確証理論には科学哲学的に価値がないと思います。
まぐれあたりの可能性を増やすために候補になる仮説を増やすと、その分だけベイズ更新の収束は遅くなります。
こういう解析学的な問題を無視した確証理論には科学哲学的に価値がないと思います。
黒木玄 Gen Kuroki@genkuroki
#統計 例えばベイズ統計について語るときに、仮説M₁,M₂,M₃,…の成否に関する主観的事前確率がデータによって更新されるという確証理論的なイメージで考えると、実際には連続無限個のパラメータの値を扱っていることが原因で生じる数学的に複雑な事柄を見逃してしまいます。
72
#統計 なぜか科学的合理性についてベイズ更新的な確証理論をイメージして納得している人たちをよく見かけるのですが、複雑なモデルでのベイズ更新の解析学的な性質をまるっきり無視しているのではないかと思います。
正しいか否かの2値的思考はやめて、程度を評価する解析学的思考をするべき。
正しいか否かの2値的思考はやめて、程度を評価する解析学的思考をするべき。
73
#統計 補足。『統計学再入門』p.135で複合仮説について説明していますが、複合仮説を無数の仮説の集合ととらえずに、1つの命題のように扱っています。
Neyman-Pearsonの検定理論では検出力がより高い検定法を作る問題が基本的で、そのためには複合仮説を1つの命題扱いする考え方は不適切です。

Neyman-Pearsonの検定理論では検出力がより高い検定法を作る問題が基本的で、そのためには複合仮説を1つの命題扱いする考え方は不適切です。
黒木玄 Gen Kuroki@genkuroki
#統計 『統計学再入門』p.127
帰無仮説有意性検定でも、Neyman-Pearson的な複合対立仮説を考えることが普通です。
例えばモデルのパラメータθに関する
帰無仮説「θ=a」の両側検定の対立仮説「θ≠a」
の実体は
{ 仮説「θ=b」| b≠a }
という無数の仮説達の集合(複合仮説)です。
帰無仮説有意性検定でも、Neyman-Pearson的な複合対立仮説を考えることが普通です。
例えばモデルのパラメータθに関する
帰無仮説「θ=a」の両側検定の対立仮説「θ≠a」
の実体は
{ 仮説「θ=b」| b≠a }
という無数の仮説達の集合(複合仮説)です。
74
#統計 Neyman-Pearsonの検定理論の意味で良い検定法は、帰無仮説(←多くの場合に複合仮説)の下でのモデル内で帰無仮説が棄却される確率を有意水準α以下に抑えながら、対立仮説(←大抵の場合に複合仮説)の検出力をできるだけ強くしたものになります。続く
75
#統計 続き。
帰無仮説が複合仮説の場合には複合仮説内のどの確率分布で帰無仮説が棄却される確率を全部α以下に抑える。
対立仮説が複合仮説の場合には複合仮説内の複数の確率分布についてその中で帰無仮説が棄却される確率(検出力)をできるだけ大きくしたい。
続く
帰無仮説が複合仮説の場合には複合仮説内のどの確率分布で帰無仮説が棄却される確率を全部α以下に抑える。
対立仮説が複合仮説の場合には複合仮説内の複数の確率分布についてその中で帰無仮説が棄却される確率(検出力)をできるだけ大きくしたい。
続く
76
#統計 Neyman-Pearsonが帰無仮説と対立仮説の2分法になるように採択/棄却という言葉を使ってしまったことについて、Pearsonは後で(1955)、仮設検定で得られた採択と棄却の結果は最終的な結論扱いされるべきではなく、ユーザーが結論を出すことを助けるための道具にすぎないと言っています。続き
黒木玄 Gen Kuroki@genkuroki
#統計 『統計学再入門』p.157から、Pearson (1955)の翻訳引用部分を孫引き
Pearsonの主張を素直に受け取れば、Neyman-Pearsonの仮説検定が、帰無仮説と対立仮説の片方の採択を強制するかのような解釈は全くのナンセンスで議論する必要がないということになる。しかし、この本では延々と議論している。
Pearsonの主張を素直に受け取れば、Neyman-Pearsonの仮説検定が、帰無仮説と対立仮説の片方の採択を強制するかのような解釈は全くのナンセンスで議論する必要がないということになる。しかし、この本では延々と議論している。
77
#統計 Pearson (1955) 的には、帰無仮説と対立仮説の採択/棄却は仮説検定ユーザーにとっての最終決定となることを意図されてなくて、単なる参考情報の1つにすぎません。続く
78
#統計 だから、帰無仮説p=0.5と対立仮説p≠0.5ならどちらか片方が正しいが、p=0.5とp=0.8の組み合わせだとそうではない、のようなことを気にしても対して意味がありません。
Neyman-Pearsonの意味での仮説検定の採択/棄却に従う必要がないことについてPearson(1955)によるお墨付きがある。続く
Neyman-Pearsonの意味での仮説検定の採択/棄却に従う必要がないことについてPearson(1955)によるお墨付きがある。続く
79
#統計 そして、帰無仮説も対立仮説も特定のモデル内でのみ意味を持つモデルのパラメータの値の設定に関する仮説に過ぎないので、数学的には帰無仮説p=0.5と対立仮説p≠0.5の片方が確実に真であったとしても、現実にはモデルそのものが間違っているかもしれない。
力こぶを入れる所が間違っている。
力こぶを入れる所が間違っている。
80
#統計 二項分布モデルの下で
帰無仮説p=0.5、対立仮説p=0.8
の場合の適切な検定法は片側検定になり、
帰無仮説p=0.5、対立仮説p>0.5
の場合も
帰無仮説p≤0.5、対立仮説p>0.5
の場合も全部同じ片側検定になります。続く
帰無仮説p=0.5、対立仮説p=0.8
の場合の適切な検定法は片側検定になり、
帰無仮説p=0.5、対立仮説p>0.5
の場合も
帰無仮説p≤0.5、対立仮説p>0.5
の場合も全部同じ片側検定になります。続く
81
#統計 二項分布モデルの下で
帰無仮説p=0.5、対立仮説p=0.8
の場合の適切な検定法におけるP値を見ることは、データの数値とp=0.5という設定の相性の良さの程度をp=0.8という設定との比較で見ていることになります。この場合にはp=0.7やp=0.6のような別の設定との比較でも全部同じになる。
帰無仮説p=0.5、対立仮説p=0.8
の場合の適切な検定法におけるP値を見ることは、データの数値とp=0.5という設定の相性の良さの程度をp=0.8という設定との比較で見ていることになります。この場合にはp=0.7やp=0.6のような別の設定との比較でも全部同じになる。
82
#統計 Neyman-PearsonのPearson(1955)によれば、NP流の仮説検定の採択/棄却はユーザーの最終判断になることを意図していなくて、ユーザーの最終判断を助けるための道具に過ぎません。
だから、NPの意味での採択/棄却に関する議論に力を入れても意味がありません。
だから、NPの意味での採択/棄却に関する議論に力を入れても意味がありません。
黒木玄 Gen Kuroki@genkuroki
#統計 『統計学再入門』p.157から、Pearson (1955)の翻訳引用部分を孫引き
Pearsonの主張を素直に受け取れば、Neyman-Pearsonの仮説検定が、帰無仮説と対立仮説の片方の採択を強制するかのような解釈は全くのナンセンスで議論する必要がないということになる。しかし、この本では延々と議論している。
Pearsonの主張を素直に受け取れば、Neyman-Pearsonの仮説検定が、帰無仮説と対立仮説の片方の採択を強制するかのような解釈は全くのナンセンスで議論する必要がないということになる。しかし、この本では延々と議論している。
83
#統計 上では本当は「帰無仮説」と言わずに「検定仮説」「検定したい仮説」と言う方が適切だったのですが、そうすると「対立仮説」を「比較したい仮説」のように言う必要があり、文字数的に厳しいので「帰無仮説」「対立仮説」という言い方をした。
「検定仮説」「比較仮説」の方が分かり易かったか?
「検定仮説」「比較仮説」の方が分かり易かったか?
黒木玄 Gen Kuroki@genkuroki
#統計 二項分布モデルの下で
帰無仮説p=0.5、対立仮説p=0.8
の場合の適切な検定法は片側検定になり、
帰無仮説p=0.5、対立仮説p>0.5
の場合も
帰無仮説p≤0.5、対立仮説p>0.5
の場合も全部同じ片側検定になります。続く
帰無仮説p=0.5、対立仮説p=0.8
の場合の適切な検定法は片側検定になり、
帰無仮説p=0.5、対立仮説p>0.5
の場合も
帰無仮説p≤0.5、対立仮説p>0.5
の場合も全部同じ片側検定になります。続く
84
#統計 補足
繰り返しになりますが、帰無仮説も複合仮説になっている場合の方が多いです。
例えば、2×2の分割表の独立性検定の帰無仮説は例えば「オッズ比=1」に取れるのですが、オッズ比以外のモデルのパラメータが残るので帰無仮説を満たすモデルの確率分布は無限個になります。
繰り返しになりますが、帰無仮説も複合仮説になっている場合の方が多いです。
例えば、2×2の分割表の独立性検定の帰無仮説は例えば「オッズ比=1」に取れるのですが、オッズ比以外のモデルのパラメータが残るので帰無仮説を満たすモデルの確率分布は無限個になります。
黒木玄 Gen Kuroki@genkuroki
#統計 Neyman-Pearsonの検定理論の意味で良い検定法は、帰無仮説(←多くの場合に複合仮説)の下でのモデル内で帰無仮説が棄却される確率を有意水準α以下に抑えながら、対立仮説(←大抵の場合に複合仮説)の検出力をできるだけ強くしたものになります。続く
85
#統計 完全に余談になってしまいますが、二項分布や正規分布のような特殊な分布族(所謂指数方分布族)をモデルに採用していない場合には、「片側検定は最強力」は成立しなくなります。
最強力な尤度比検定が非自明になる。
github.com/genkuroki/publ…


最強力な尤度比検定が非自明になる。
github.com/genkuroki/publ…
黒木玄 Gen Kuroki@genkuroki
#統計 Neyman-Pearsonの補題の応用例としては
帰無仮説Nornal(0,1)、対立仮説Normal(μ,1)の一様最強力検定は通常の片側検定になる
だけではなく、
帰無仮説Cauchy(0,1)、対立仮説Cauchy(μ,1)の一様最強力検定をコンピュータで視覚化せよ
もやっておくと勉強になる。続く
github.com/genkuroki/publ…
帰無仮説Nornal(0,1)、対立仮説Normal(μ,1)の一様最強力検定は通常の片側検定になる
だけではなく、
帰無仮説Cauchy(0,1)、対立仮説Cauchy(μ,1)の一様最強力検定をコンピュータで視覚化せよ
もやっておくと勉強になる。続く
github.com/genkuroki/publ…
86
#統計 このスレッドを読み直して感じたこと
「ロイヤルの3つの問い」的な「統計学の哲学」を統計学教育に導入する流れを作った人達は進むべき道を誤ったのではないか?
Greenlandさん達が昔から言っていることや、McElreathさんのStatistical Rethinking的な説明を導入するべきだったのではないか?
「ロイヤルの3つの問い」的な「統計学の哲学」を統計学教育に導入する流れを作った人達は進むべき道を誤ったのではないか?
Greenlandさん達が昔から言っていることや、McElreathさんのStatistical Rethinking的な説明を導入するべきだったのではないか?
87
#統計 関連スレッド
88
#統計 関連スレッド