#統計 所謂「頻度論」の信頼区間についてもベイズ統計での事後分布のように使える道具があります。...

黒木玄 Gen Kuroki@genkuroki
79 views
Oct 02, 2024
~1 min read
Advertisement
1
#統計 所謂「頻度論」の信頼区間についてもベイズ統計での事後分布のように使える道具があります。
それは岩田健太郎先生も確実に知っているものです。
もしも知らないなら統計学について完全な無知なままで研究をしていることになります。
問題: さてそれは何でしょうか?
解答の解説に続く!

それは岩田健太郎先生も確実に知っているものです。
もしも知らないなら統計学について完全な無知なままで研究をしていることになります。
問題: さてそれは何でしょうか?
解答の解説に続く!
岩田健太郎 K Iwata@georgebest1969
ベイズだと確率密度が出るので悩みはないのですが、普通の頻度論統計で95%CIであってもなんらかの分布(のようなもの?)があって、平均値のほうがより真の値に近くて、CIの端っこの方が真の値である可能性は下がる、、、ような気がするのですが、どうなのでしょう。
2
#統計 問題解答
通常の信頼区間におけるベイズ統計の事後分布の類似物はP値です。
統計学を研究で使っていてP値の存在を知らないということはあり得ないのに、どうして正解を自力で思い付けない人たちが多いのか?
その辺のことはSander Greenlandさん達が繰り返し説明しています。続く
通常の信頼区間におけるベイズ統計の事後分布の類似物はP値です。
統計学を研究で使っていてP値の存在を知らないということはあり得ないのに、どうして正解を自力で思い付けない人たちが多いのか?
その辺のことはSander Greenlandさん達が繰り返し説明しています。続く
3
#統計 非常に残念なことに(特に医学研究の分野では)、P値と言えば「違いはゼロである」という帰無仮説(ゼロ仮説)のP値単体を意味することが多い。
ゼロ仮説のP値単独では、事後分布と同じようには使えません。
だから自明な正解を見逃してしまうのです!(nullism(後述)という病気の症状の1つ)
ゼロ仮説のP値単独では、事後分布と同じようには使えません。
だから自明な正解を見逃してしまうのです!(nullism(後述)という病気の症状の1つ)
4
#統計 違いの指標として使うモデルのパラメータθ (例えば母平均の差や対数リスク比など)については、ゼロ仮説θ=0のP値(以下null P値と呼ぶ)だけではなく、任意の数値aに関する一般の検定仮説θ=aのP値も定義されています。
この後者の意味でのP値はちょうど事後分布と同じように使用できます。続く
この後者の意味でのP値はちょうど事後分布と同じように使用できます。続く
5
#統計 データxに関するモデルMのパラメータθについての仮説θ=aのP値は、パラメータθの値の関数とみなせます。その関数をP値関数と呼びます。
パラメータθのP値関数はほぼパラメータθの事後分布と同じように使えます。
P値関数と事後分布のグラフの例
↓


パラメータθのP値関数はほぼパラメータθの事後分布と同じように使えます。
P値関数と事後分布のグラフの例
↓
黒木玄 Gen Kuroki@genkuroki
#統計 最尤法でのP値関数とベイズ統計での事後分布が「同じようなもの」であることは、簡単なモデルでそれらを同時プロットすれば明らかになります。
二項分布モデルでの最尤法に付随するスコア法によるP値関数と平坦事前分布に対応する事後分布を比較するためのグラフ
↓
nbviewer.org/github/genkuro…
二項分布モデルでの最尤法に付随するスコア法によるP値関数と平坦事前分布に対応する事後分布を比較するためのグラフ
↓
nbviewer.org/github/genkuro…
6
#統計 添付画像は線形回帰 y=β₀+β₁x+u, u ~Normal(0,σ²)の場合のP値関数と事後分布のグラフ。
線形回帰では、事後分布としてβとlog σ²ついて平坦な事前分布を採用すると、通常のP値関数に付随する信頼区間(P値≥αとなるパラメータの値の範囲)とベイズ版信用区間は誤差無しにぴったり一致します。

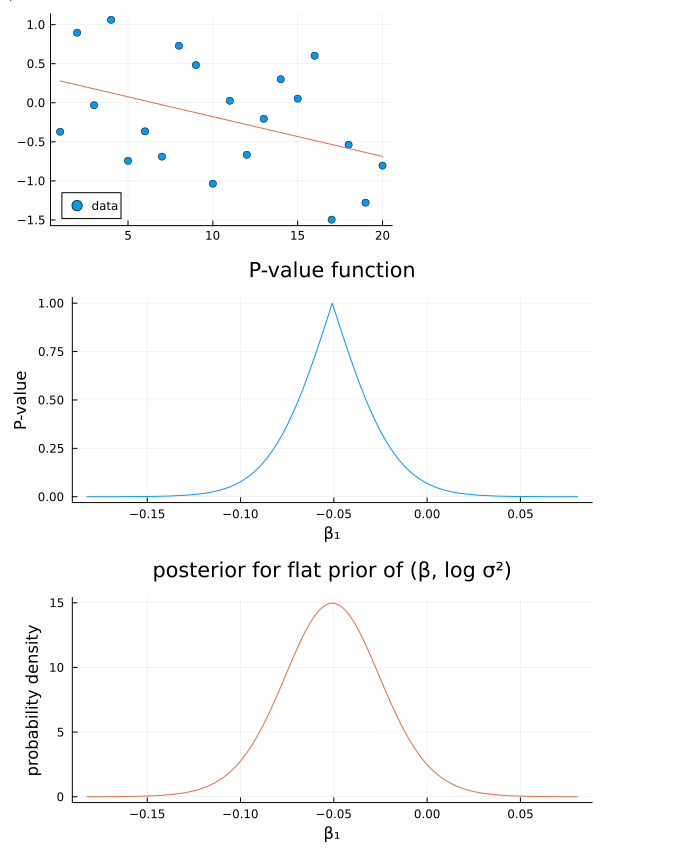
線形回帰では、事後分布としてβとlog σ²ついて平坦な事前分布を採用すると、通常のP値関数に付随する信頼区間(P値≥αとなるパラメータの値の範囲)とベイズ版信用区間は誤差無しにぴったり一致します。
黒木玄 Gen Kuroki@genkuroki
#統計 #Julia言語
線形回帰のβ₁に関するP値関数
と
βとlog σ²について平坦な事前分布での
ベイズ版線形回帰のβ₁に関する事後分布
は数学的に「同等」なので、
線形回帰に関するP値を使う方法とベイズ法の違い
は
事前分布の平坦分布との違い
にちょうど対応。
github.com/genkuroki/publ…
線形回帰のβ₁に関するP値関数
と
βとlog σ²について平坦な事前分布での
ベイズ版線形回帰のβ₁に関する事後分布
は数学的に「同等」なので、
線形回帰に関するP値を使う方法とベイズ法の違い
は
事前分布の平坦分布との違い
にちょうど対応。
github.com/genkuroki/publ…
7
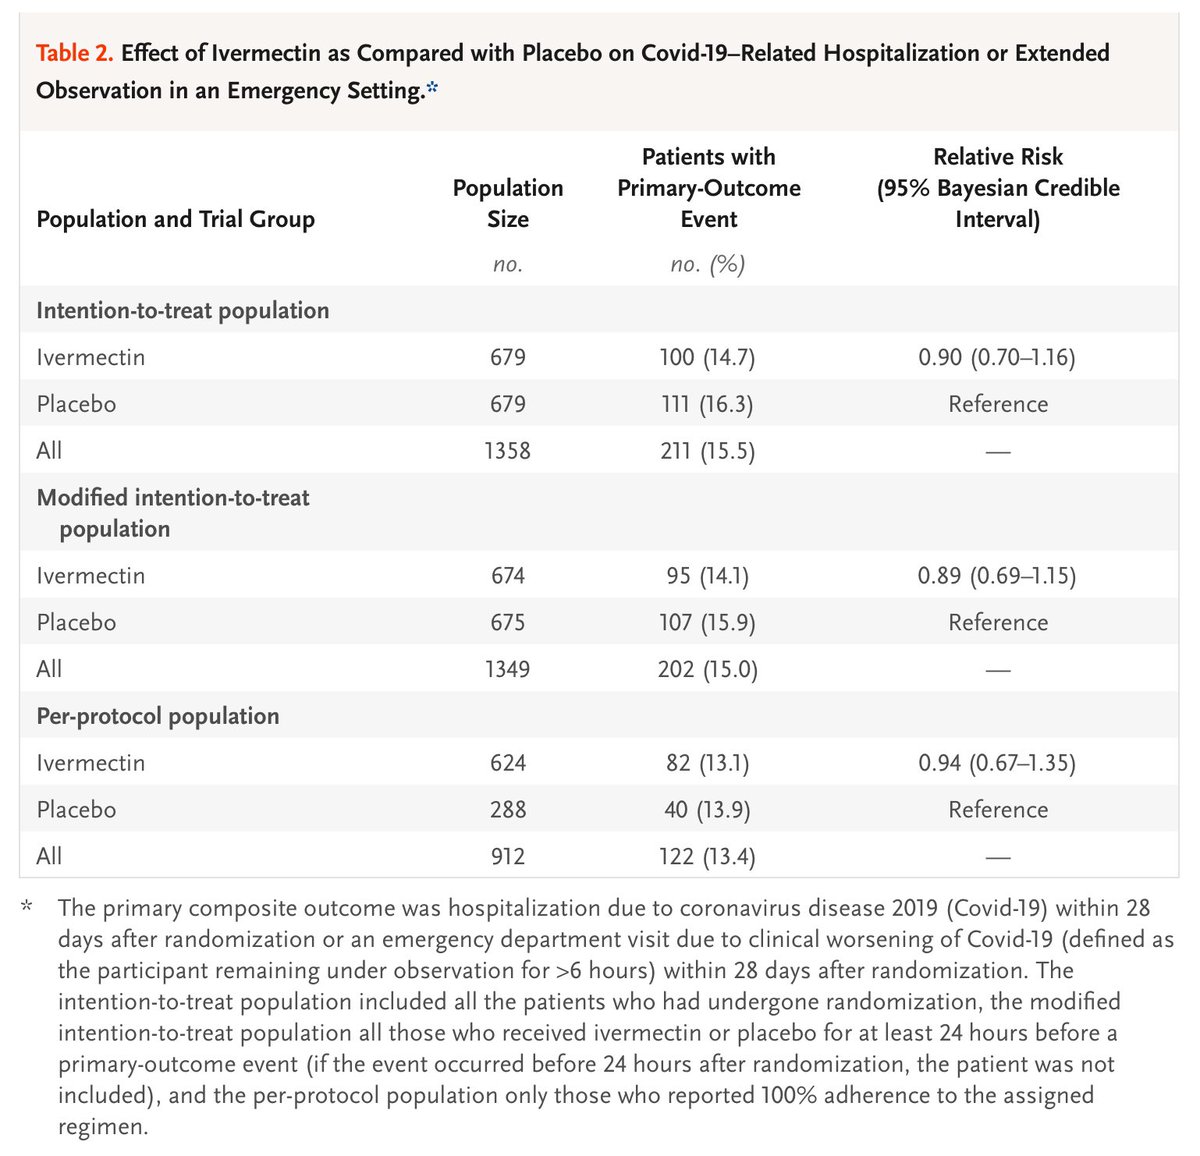
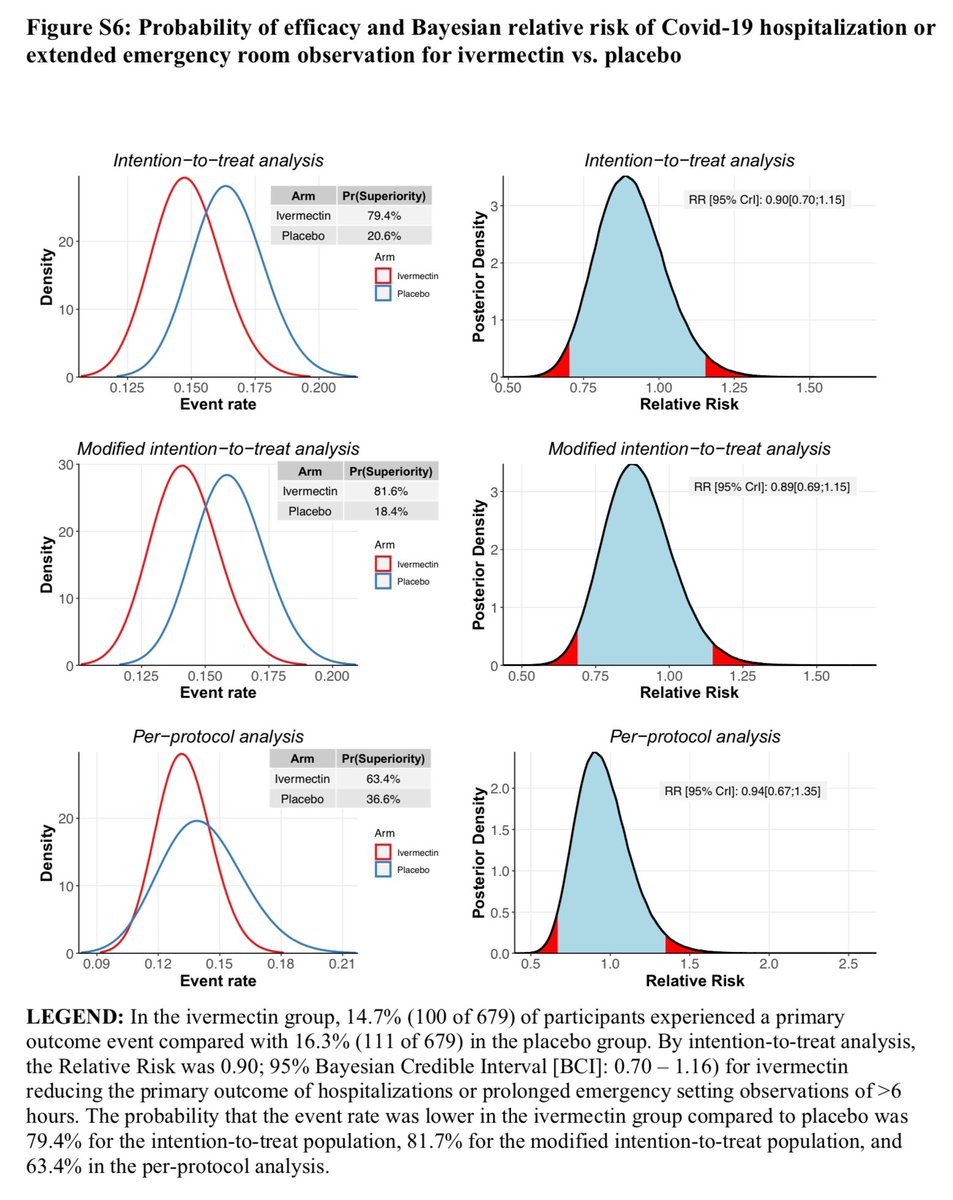
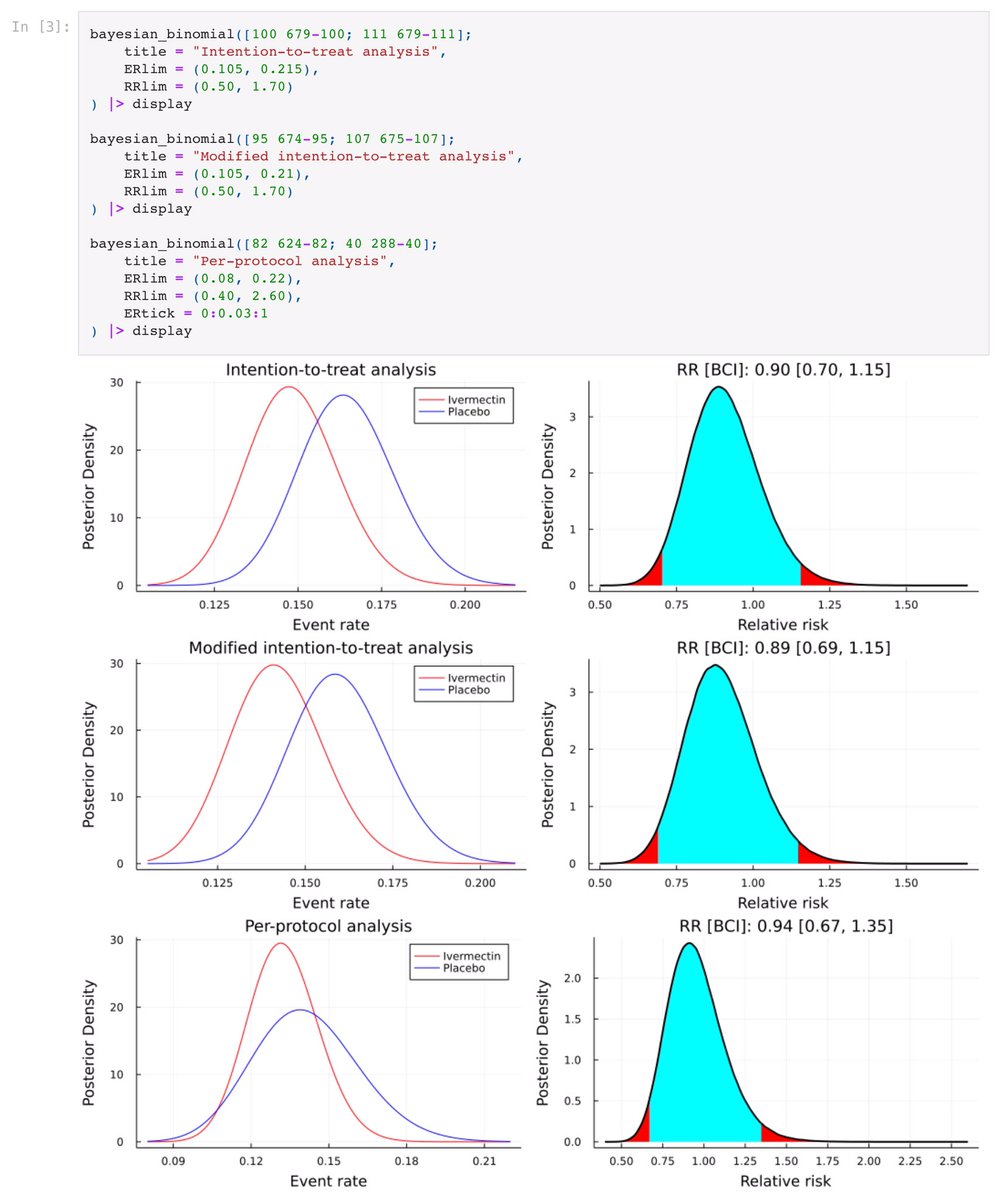
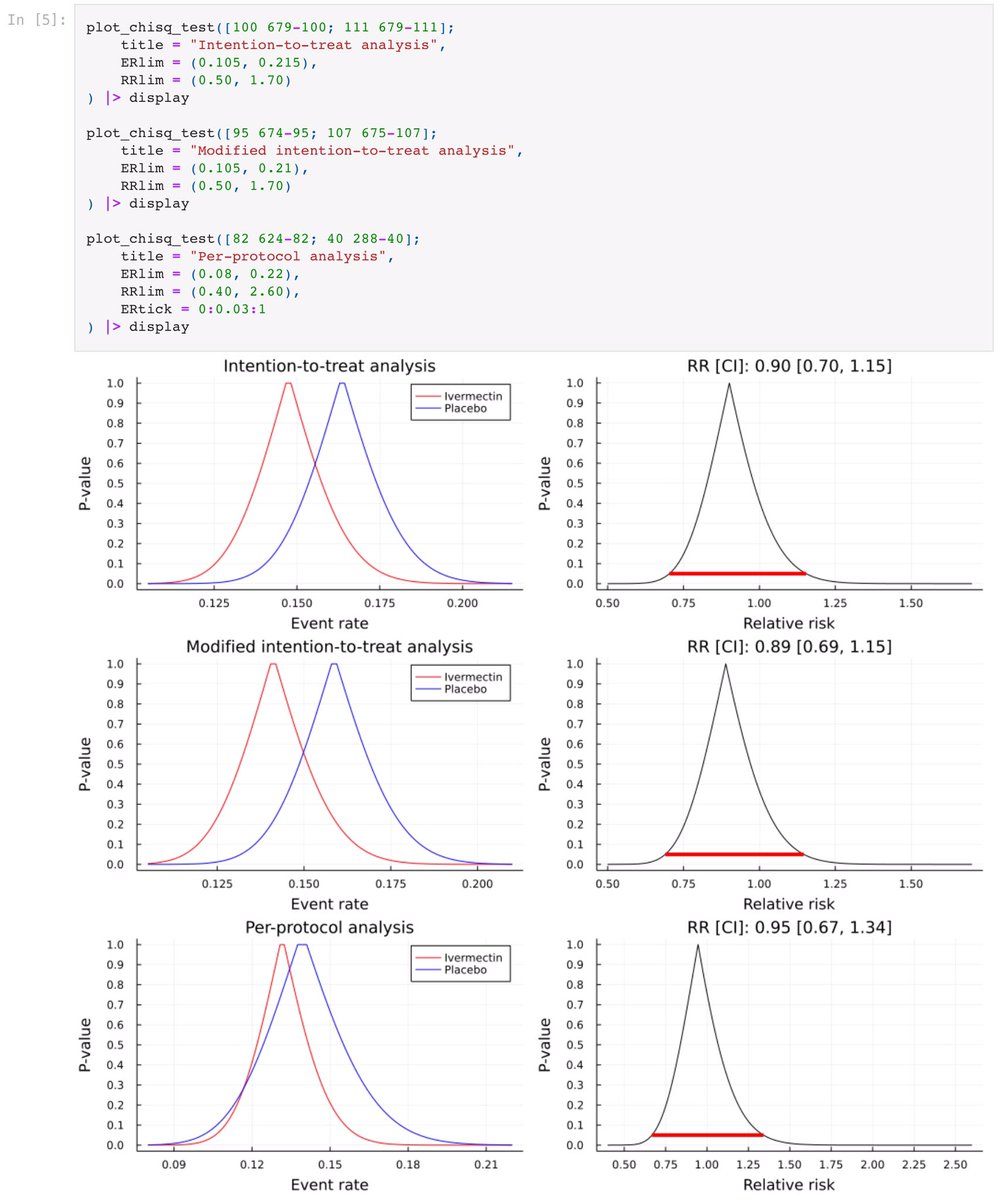
#統計 添付画像は、イベルメクチンの新型コロナに関する治験の論文にあった事後分布のグラフとP値関数のグラフを比較するために作ったものです。ベイズでもP値でも区間推定の結果はよく一致しています。
その論文のデータについてはベイズ統計を使ってもP値を使っても同じ結論が得られます。

その論文のデータについてはベイズ統計を使ってもP値を使っても同じ結論が得られます。
黒木玄 Gen Kuroki@genkuroki
@_akiraendo @EvidenceObasan @ykamit #統計 この場合には、ベイズ信用区間を使っても、通常の信頼区間を使っても数値的にはほぼ同じです。
添付画像①は nejm.org/doi/full/10.10… より。②はSupplementary Appendixより。
③は私による②の再現。④は対応する通常のP値版です。比較すれば本質的に同じだと分かります。 #Julia言語
添付画像①は nejm.org/doi/full/10.10… より。②はSupplementary Appendixより。
③は私による②の再現。④は対応する通常のP値版です。比較すれば本質的に同じだと分かります。 #Julia言語
8
#統計 P値関数については『ロスマンの疫学第2版』のような日本語訳された本でも学べますが、個人的な意見では、より徹底した知識を得るために、Sander Greenlandさんの講演スライドを読むのが良いと思います。
biostatistics.ucdavis.edu/sites/g/files/…


biostatistics.ucdavis.edu/sites/g/files/…
黒木玄 Gen Kuroki@genkuroki
#統計 お勧めのGreenlandさんの講演スライドより
P値を推定のための道具として扱わない誤りの繰り返しはやめるべき。
「差がない」という帰無仮説のnull P値単体を帰無仮説有意性検定(NHST)で使うだけなのは誤解の主な原因になっている。
biostatistics.ucdavis.edu/sites/g/files/…
P値を推定のための道具として扱わない誤りの繰り返しはやめるべき。
「差がない」という帰無仮説のnull P値単体を帰無仮説有意性検定(NHST)で使うだけなのは誤解の主な原因になっている。
biostatistics.ucdavis.edu/sites/g/files/…
9
#統計 ちなみにGreenlandさんは、悪名高いsignificance (有意性)だけではなく、confidence intervalのconfidence (信頼)も過大広告の不適切な単語の使い方であると強調しています。
confidence(信頼)はcompatibility(相性の良さ)に置き換えられるべきです。
biostatistics.ucdavis.edu/sites/g/files/…


confidence(信頼)はcompatibility(相性の良さ)に置き換えられるべきです。
biostatistics.ucdavis.edu/sites/g/files/…
黒木玄 Gen Kuroki@genkuroki
#統計 信頼区間の信頼(confidence)がいかに不適切な単語の使い方であったかは、Greenlandさんの講演スライド
biostatistics.ucdavis.edu/sites/g/files/…
で特に強調されていることの一つです。
biostatistics.ucdavis.edu/sites/g/files/…
で特に強調されていることの一つです。
10
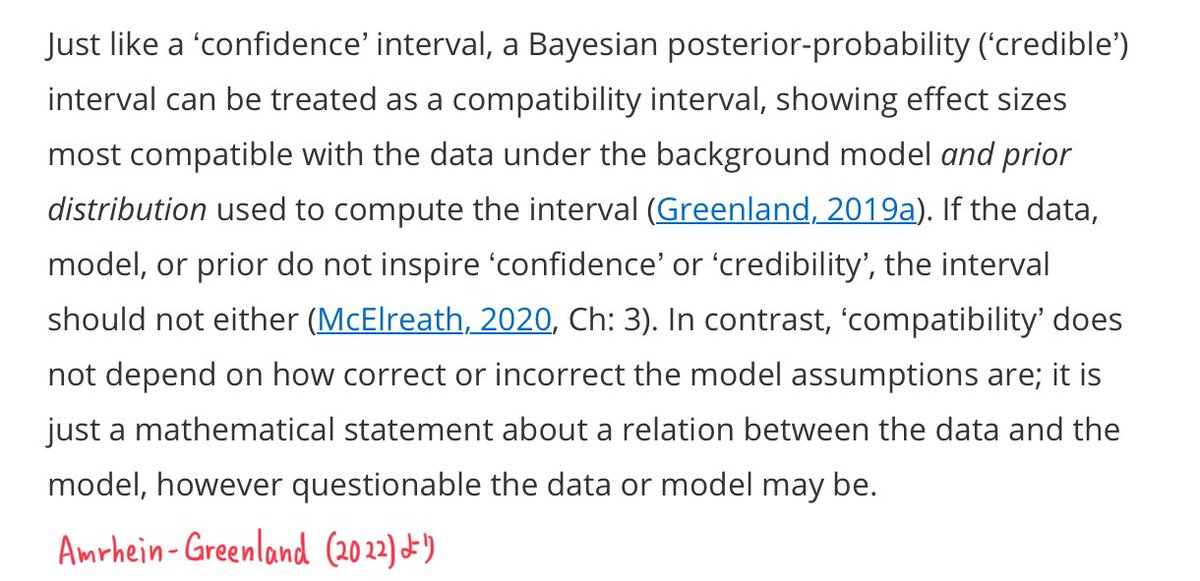
#統計 Greenlandさん達のcompatibility (相性の良さ)という解釈は、McElreathさんのStatistical Rethinking (世界的に大人気の講義)において、ベイズ統計の信用区間でも採用されています。
compatibility (相性の良さ)の解釈にすれば通常の信頼区間とベイズ的な信用区間を同じように扱えます。続く

compatibility (相性の良さ)の解釈にすれば通常の信頼区間とベイズ的な信用区間を同じように扱えます。続く
黒木玄 Gen Kuroki@genkuroki
#統計 通常の信頼区間だけではなく、ベイズ版の信用区間も compatibility interval と呼んで同じように解釈することの合理性については、McElreathさんのStatistical Rethinking 2nd ed. の3.2.2 (p.54)を参照。
Amrhein-Greenland (2022) journals.sagepub.com/doi/10.1177/02… も参照。
Amrhein-Greenland (2022) journals.sagepub.com/doi/10.1177/02… も参照。
11
#統計 考えの足りない「信頼区間警察」の人達は「頻度論vs.ベイズ統計」という有害な対立図式を持ち出して、信頼区間と信用区間の両方をcompatibility (相性の良さ)で解釈することに反対するかもしれません。
しかし、GreenlandさんとMcElreathさんの考え方は非常に合理的で何も問題ありません。
しかし、GreenlandさんとMcElreathさんの考え方は非常に合理的で何も問題ありません。
12
#統計 100(1-α)%の信頼区間と信用区間はどちらも
データの数値と閾値αの設定で相性が良い(compatible)とみなされるモデルのパラメータの範囲
だと解釈されます。ただし、ベイズ版の信用区間ではモデルに事前分布を含め、事前分布も含めて相性を見ていることになります。その点が信頼区間と違う。
データの数値と閾値αの設定で相性が良い(compatible)とみなされるモデルのパラメータの範囲
だと解釈されます。ただし、ベイズ版の信用区間ではモデルに事前分布を含め、事前分布も含めて相性を見ていることになります。その点が信頼区間と違う。
13
#統計 閾値αを5%に固定する必然性はないので、閾値αを0から1まで全部動かしたときの信頼区間と信用区間の全体を見ることは、通常のP値関数もしくは事後分布に付随するP値関数(の類似物)を見るのと同じことになります。
14
#統計 P値(=P値関数の値)は
データの数値とモデルのパラメータの値の設定の相性の良さ(compatibility)の指標の1つ
だと解釈されます。
「20人中6人」というデータの数値に関する母比率pのP値関数と事後分布のグラフ。これを見れば上の解釈の仕方が十分合理的なことが分かる。
↓
データの数値とモデルのパラメータの値の設定の相性の良さ(compatibility)の指標の1つ
だと解釈されます。
「20人中6人」というデータの数値に関する母比率pのP値関数と事後分布のグラフ。これを見れば上の解釈の仕方が十分合理的なことが分かる。
↓
15
#統計 そのとき、
* 水準100(1-α)%での区間推定の結果はP値≥αとなるパラメータの値の範囲(閾値αの設定でデータの数値と相性が良いとみなされるパラメータの値の範囲)になる。
* 点推定値はP値(=データの数値との相性の良さ)が最大になるパラメータの値になる。
シンプルでクリアです!
* 水準100(1-α)%での区間推定の結果はP値≥αとなるパラメータの値の範囲(閾値αの設定でデータの数値と相性が良いとみなされるパラメータの値の範囲)になる。
* 点推定値はP値(=データの数値との相性の良さ)が最大になるパラメータの値になる。
シンプルでクリアです!
16
#統計 統計学ユーザーは
* nullism (帰無主義)
* dichotomania (二分法病)
* reification (モデルを疑わない病(意訳))
の3つの病気に注意する必要があることも、Greenlandさんの講演スライドでは強調されています。
biostatistics.ucdavis.edu/sites/g/files/…

* nullism (帰無主義)
* dichotomania (二分法病)
* reification (モデルを疑わない病(意訳))
の3つの病気に注意する必要があることも、Greenlandさんの講演スライドでは強調されています。
biostatistics.ucdavis.edu/sites/g/files/…
黒木玄 Gen Kuroki@genkuroki
#統計 所謂NHST(帰無仮説有意性献帝)のユーザー達が3つの病気すべてに罹っていることが多い。
①「差がない」の形の帰無仮説(ゼロ仮説)にこだわる→nullism
②統計的有意性によって安易な二分法を行いたがる→dichotomania
③過剰に単純化された数学的設定を現実と混同する→reification
①「差がない」の形の帰無仮説(ゼロ仮説)にこだわる→nullism
②統計的有意性によって安易な二分法を行いたがる→dichotomania
③過剰に単純化された数学的設定を現実と混同する→reification
17
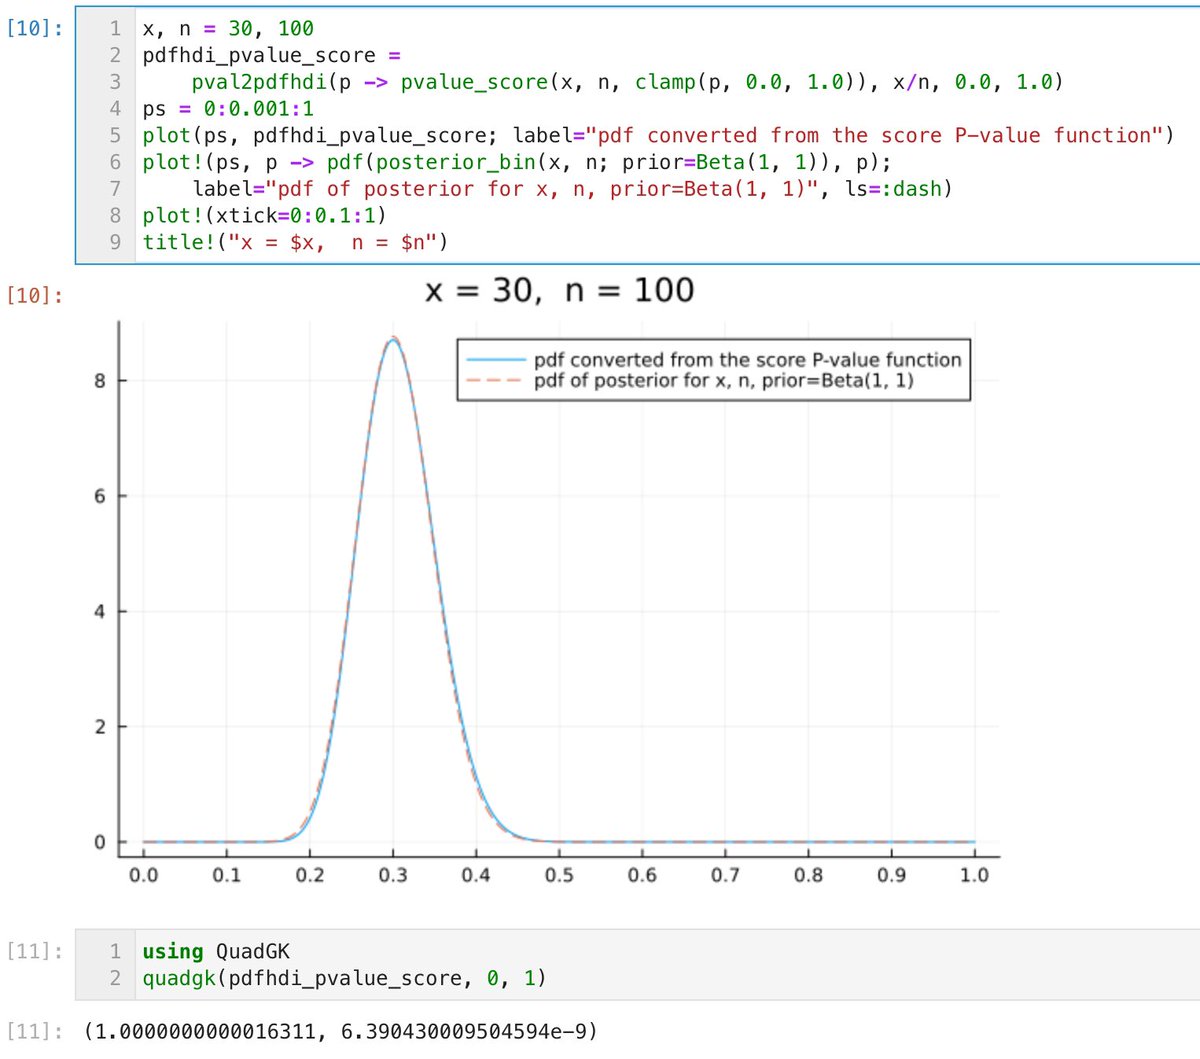
#統計 単峰性などに関する適当な条件の下で、P値関数と確率密度関数の間には相互変換を構成できます。
P値関数と事後分布の密度関数の精密な比較をしたいと思った人はどちらか片側に変換して比較する必要があります。
その辺の実装については
github.com/genkuroki/publ…
を参照。 #Julia言語

P値関数と事後分布の密度関数の精密な比較をしたいと思った人はどちらか片側に変換して比較する必要があります。
その辺の実装については
github.com/genkuroki/publ…
を参照。 #Julia言語
黒木玄 Gen Kuroki@genkuroki
#統計 単峰型の確率密度関数から上の方法でP値関数(の類似物)を作れます。
その構成は可逆で、P値関数から単峰型の確率密度関数を作れます。
添付画像はスコア法で作ったP値関数から作った密度関数と平坦事前分布の事後分布の同時プロットです。
github.com/genkuroki/publ…
その構成は可逆で、P値関数から単峰型の確率密度関数を作れます。
添付画像はスコア法で作ったP値関数から作った密度関数と平坦事前分布の事後分布の同時プロットです。
github.com/genkuroki/publ…
18
#統計 P値 (null P値以外のすべてのP値も含む)とベイズ統計での事後分布が同じように使える道具であることを納得するためには、複数のデータの数値についてそれらを計算して比較することを繰り返す必要があります。
そのための #Julia言語 のコードを私は全公開しているので、参考になると思います。
そのための #Julia言語 のコードを私は全公開しているので、参考になると思います。
19
#統計 補足
P値と言えば主にゼロ仮説のP値のみを意味する悪習はP値に関する理解を酷く歪めている。
さらに、「頻度主義vs.ベイズ主義」的な見方は、P値(より正確にはP値関数)はベイズ統計での事後分布と類似の使い方をできる道具であるという自明な事実に気付くことへの精神的障碍になっている。
P値と言えば主にゼロ仮説のP値のみを意味する悪習はP値に関する理解を酷く歪めている。
さらに、「頻度主義vs.ベイズ主義」的な見方は、P値(より正確にはP値関数)はベイズ統計での事後分布と類似の使い方をできる道具であるという自明な事実に気付くことへの精神的障碍になっている。
20
#統計 大雑把に言うと、使用するモデルがシンプルで事前分布が適切な意味で平坦もしくは平坦に近いならば、P値を使って得た結果とベイズ統計の事後分布を使って得た結果はほぼ等しくなります。
例: データ「20人中6人」に関する母比率のP値関数とそのベイズ版の比較。事前分布は平坦。
↓
例: データ「20人中6人」に関する母比率のP値関数とそのベイズ版の比較。事前分布は平坦。
↓
21
#統計
「20人中6人」というデータに関する母比率pの100(1-α)%信頼区間の両端の値を高さαで2点ずつプロットしています。
その結果は各pの値ごとにP値を1点プロットした結果に等しい。
ベイズ版の信用区間についても同様にプロットしています。事前分布は平坦事前分布。
github.com/genkuroki/publ…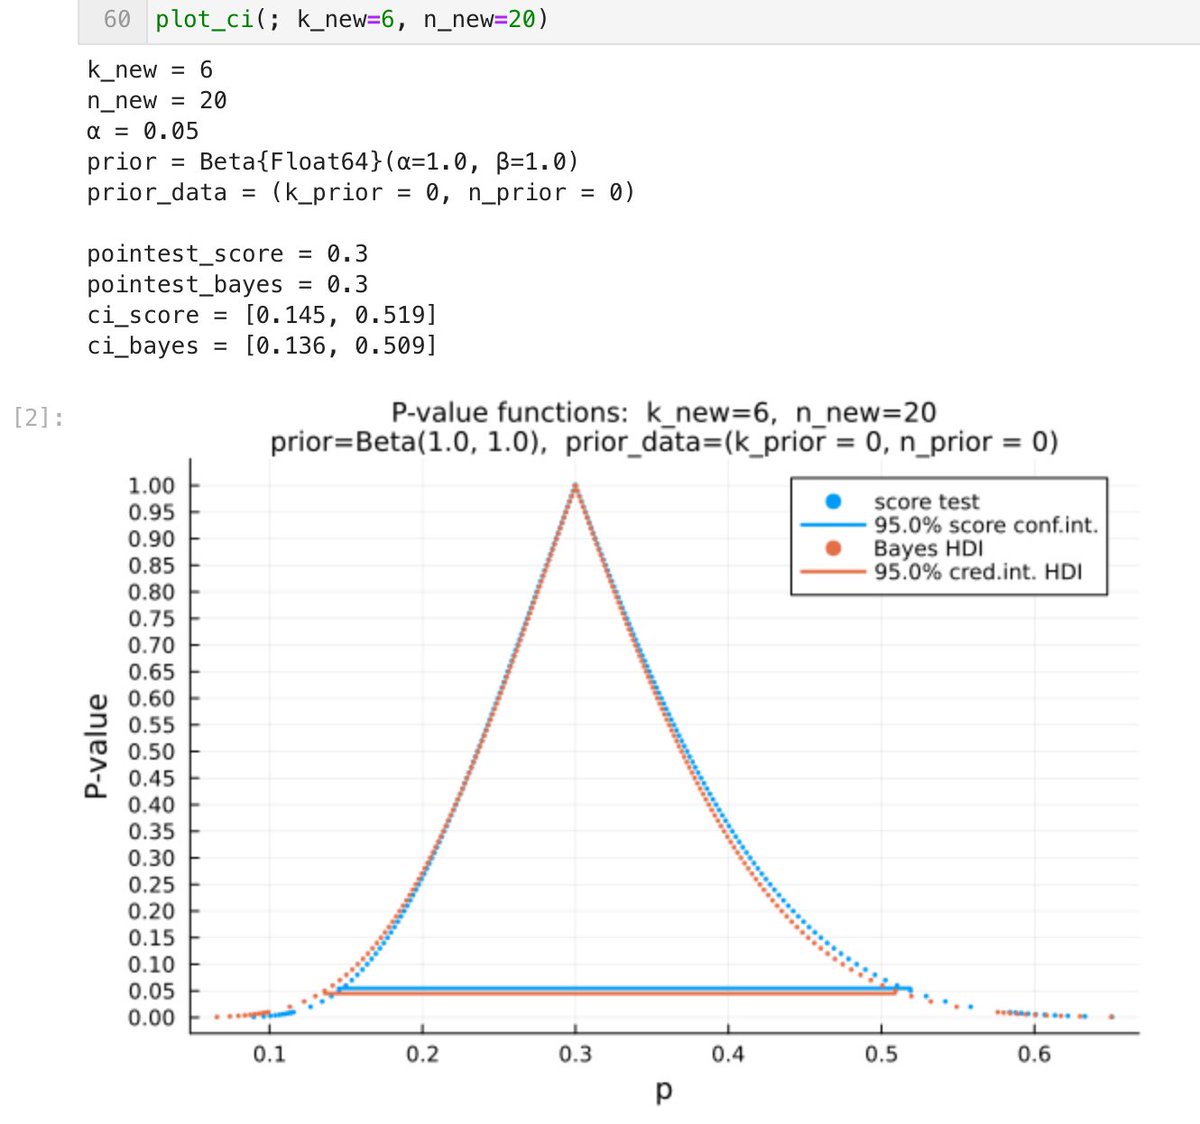
「20人中6人」というデータに関する母比率pの100(1-α)%信頼区間の両端の値を高さαで2点ずつプロットしています。
その結果は各pの値ごとにP値を1点プロットした結果に等しい。
ベイズ版の信用区間についても同様にプロットしています。事前分布は平坦事前分布。
github.com/genkuroki/publ…
22
#統計
「20人中6人」とデータの標本サイズは全然大きくないのですが、以下のグラフから、ベイズ側の事前分布が平坦事前分布ならば、通常の信頼区間達とベイズ版の信用区間の数値的違いは小さいです。
「20人中6人」とデータの標本サイズは全然大きくないのですが、以下のグラフから、ベイズ側の事前分布が平坦事前分布ならば、通常の信頼区間達とベイズ版の信用区間の数値的違いは小さいです。
23
#統計 平坦分布から事前分布が離れると、通常のP値を使って得た結果とベイズ的な結果の間に違いが生じて来ます。
ベイズの場合には、モデルのパラメータの値の設定とデータの数値だけの相性の良さではなく、データの数値と事前分布を合わせたものとの相性の良さを見ていることになります。
例
↓
ベイズの場合には、モデルのパラメータの値の設定とデータの数値だけの相性の良さではなく、データの数値と事前分布を合わせたものとの相性の良さを見ていることになります。
例
↓
24
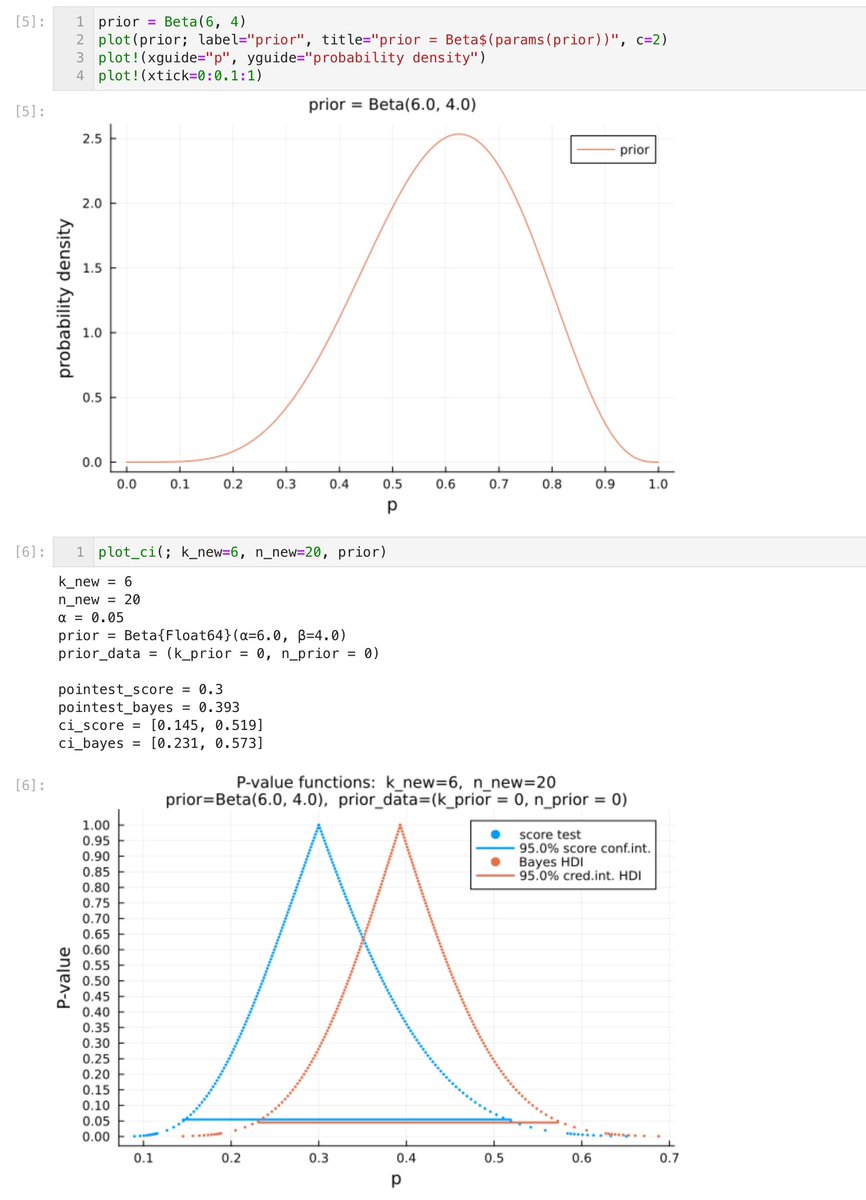
#統計 データの数値は「20人中6人」のままなのですが、ベイズ側の事前分布をBeta(6,4)に変更しています。
Beta(6,4)は右中央に偏っているので、ベイズ信用区間達(高さαの橙色の2点の間の区間)は通常の信頼区間(青点で表示)よりも右側に寄ったものになっています。
Beta(6,4)は右中央に偏っているので、ベイズ信用区間達(高さαの橙色の2点の間の区間)は通常の信頼区間(青点で表示)よりも右側に寄ったものになっています。
25
#統計 事前分布無しの通常の信頼区間達(高さαの青い2点の間の区間達)を見ると、母比率はp=0.2であるという仮説と「20人中6人」というデータの数値の相性は相当に良いのですが(P値は25%程度)、事前分布がBeta(6,4)の信用区間達(橙色で表示)を見るとp=0.2とデータ「20人中6人」の相性は悪そうに見える。
26
#統計 このグラフを見ると、二項分布モデルの下での、データの数値「20人中6人」と
①母比率はpであるという仮説の相性の良さ(青色)
と
②事前分布がBeta(6,4)のときの母比率はpであるという仮説の相性の良さ(橙色)
の程度が分かるわけです。
①母比率はpであるという仮説の相性の良さ(青色)
と
②事前分布がBeta(6,4)のときの母比率はpであるという仮説の相性の良さ(橙色)
の程度が分かるわけです。
27
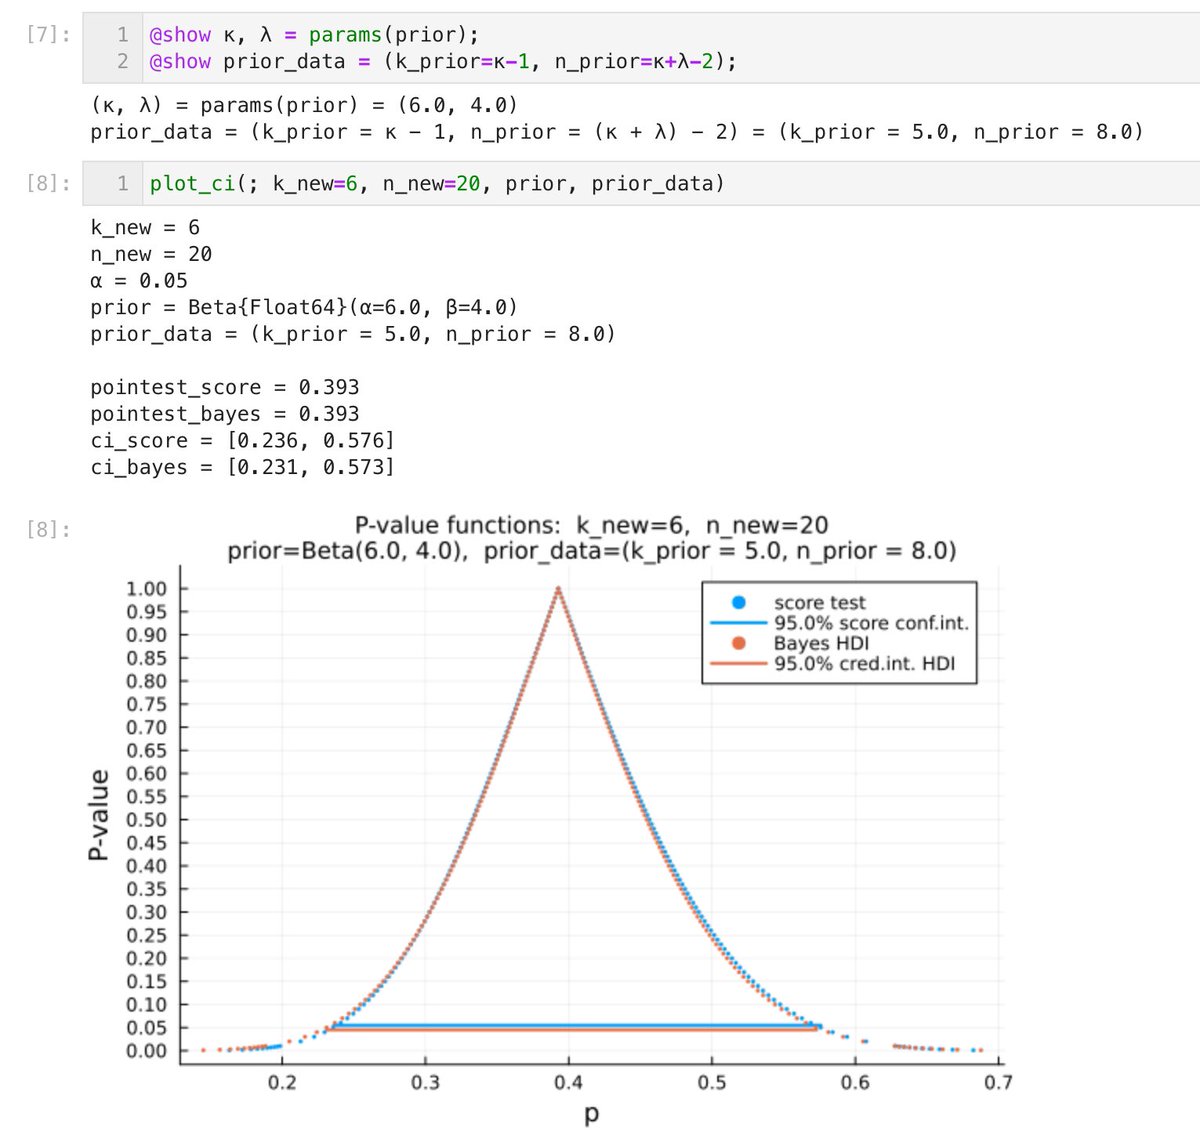
#統計 ベイズ統計での仮想的な事前分布の働きを、通常の信頼区間の側で仮想的な事前データでシミュレートできることがあります。
以上で扱った場合には、ベイズ側での事前分布Beta(6,4)は、事前に「8人中5人」というデータが得られていたという設定でシミュレートできます。
その証拠。よく一致!
↓
以上で扱った場合には、ベイズ側での事前分布Beta(6,4)は、事前に「8人中5人」というデータが得られていたという設定でシミュレートできます。
その証拠。よく一致!
↓
28
#統計 以上では、二項分布モデルを使った母比率の区間推定の場合に、通常の信頼区間とベイズ的な信用区間を比較しました。
その場合には仮想的な事前分布を仮想的な事前データでシミュレートできるので、事前分布による非ベイズとベイズの違いは適当な事前データの設定で解消できることもわかった。
その場合には仮想的な事前分布を仮想的な事前データでシミュレートできるので、事前分布による非ベイズとベイズの違いは適当な事前データの設定で解消できることもわかった。
29
#統計 以上で紹介した二項分布モデルによる母比率の区間推定の場合の比較のための #Julia言語 でのコードが
github.com/genkuroki/publ…
で公開されています。この手のことが好きな人は自由にコピー&改変&再配布して構いません。
そこでは分散を固定した正規分布モデルの場合の比較もやっています。
github.com/genkuroki/publ…
で公開されています。この手のことが好きな人は自由にコピー&改変&再配布して構いません。
そこでは分散を固定した正規分布モデルの場合の比較もやっています。
30
#統計 以上では、P値(より正確にはP値関数=信頼区間関数)はベイズ統計での事後分布(もしくは信用区間達)と同じような使い方をできる道具であることを、可能な限り平易に説明したつもりなのですが、分かり難い部分があったら教えて下さい。
別の説明の仕方を考えてみます。
別の説明の仕方を考えてみます。
31
#統計 既出の github.com/genkuroki/publ… では、高さαに100(1-α)%の信頼区間と信用区間の両端の値を2点プロットすることを実装しています。
これは、P値関数の概念に慣れていない人のための図を作るためです。
計算効率や実装の平易さ的には直接P値関数を計算してプロットする方が勝ります。
これは、P値関数の概念に慣れていない人のための図を作るためです。
計算効率や実装の平易さ的には直接P値関数を計算してプロットする方が勝ります。
32
#統計 信頼区間とP値の関係
パラメータpの信頼水準100(1-α)%の信用区間の両端の値をa≤bと書くとき、検定仮説p=aと検定仮説p=bのP値はαになります。
だから、(a, α), (b, α)に点をプロットすると、p=a,bのP値の値がプロットされたことになります。
信用区間についても同様のグラフを描けます。
パラメータpの信頼水準100(1-α)%の信用区間の両端の値をa≤bと書くとき、検定仮説p=aと検定仮説p=bのP値はαになります。
だから、(a, α), (b, α)に点をプロットすると、p=a,bのP値の値がプロットされたことになります。
信用区間についても同様のグラフを描けます。
33
#統計 パラメータθの100(1-α)%信頼区間が満たすべき必要最小限の条件は
(CI) パラメータθの値がaに設定されたモデル内での確率変数扱いされる仮想的なデータXから計算される区間にaが含まれる確率が概ね1-α以上(⪆1-α)になること
です。適当な条件の下で、ベイズ版信用区間はこの条件を満たします。
(CI) パラメータθの値がaに設定されたモデル内での確率変数扱いされる仮想的なデータXから計算される区間にaが含まれる確率が概ね1-α以上(⪆1-α)になること
です。適当な条件の下で、ベイズ版信用区間はこの条件を満たします。
34
#統計 データの数値xをパラメータθの区間に対応させる関数x↦[L(x), U(x)]について、
(CP) パラメータθの値がaに設定されたモデル内での確率変数扱いされる仮想的なデータXに関するa∈[L(X), U(X)]となる確率
を被覆確率と言います。1つ上の投稿中の条件(CI)は
(CI)' (被覆確率)⪆1-α
と同値です。
(CP) パラメータθの値がaに設定されたモデル内での確率変数扱いされる仮想的なデータXに関するa∈[L(X), U(X)]となる確率
を被覆確率と言います。1つ上の投稿中の条件(CI)は
(CI)' (被覆確率)⪆1-α
と同値です。
35
#統計 データの数値xとパラメータθの値にP値を対応させる関数pvalue(x,θ)について
(αe) パラメータθの値がaに設定されたモデル内での確率変数としての仮想的なデータXについてpvalue(X,a)<αとなる確率 (nuisance parameterがある場合にはその上限)
をαエラー率(第1種の過誤の確率)と呼びます。
(αe) パラメータθの値がaに設定されたモデル内での確率変数としての仮想的なデータXについてpvalue(X,a)<αとなる確率 (nuisance parameterがある場合にはその上限)
をαエラー率(第1種の過誤の確率)と呼びます。
36
#統計 データの数値にパラメータθの値の区間を返す関数x↦[L(x,α), U(x,α)]で条件
(CI)' (被覆確率)⪆1-α
を満たすものが与えられたとき、
pvalue(x,L(x))=pvalue(x,U(x))=α
でP値関数を定義すると、P値が満たすべき必要最小限の条件
(PV) (αエラー率)⪅α
を満たします(逆も言える)。
(CI)' (被覆確率)⪆1-α
を満たすものが与えられたとき、
pvalue(x,L(x))=pvalue(x,U(x))=α
でP値関数を定義すると、P値が満たすべき必要最小限の条件
(PV) (αエラー率)⪅α
を満たします(逆も言える)。
黒木玄 Gen Kuroki@genkuroki
#統計 信頼区間とP値の関係
パラメータpの信頼水準100(1-α)%の信用区間の両端の値をa≤bと書くとき、検定仮説p=aと検定仮説p=bのP値はαになります。
だから、(a, α), (b, α)に点をプロットすると、p=a,bのP値の値がプロットされたことになります。
信用区間についても同様のグラフを描けます。
パラメータpの信頼水準100(1-α)%の信用区間の両端の値をa≤bと書くとき、検定仮説p=aと検定仮説p=bのP値はαになります。
だから、(a, α), (b, α)に点をプロットすると、p=a,bのP値の値がプロットされたことになります。
信用区間についても同様のグラフを描けます。
37
#統計 以上のように、
信頼区間として必要最小限の条件を満たすパラメータθの区間に値を持つ関数[L(x,α), U(x,α)]
と
P値として必要最小限の条件を満たす関数pvalue(x,θ)
は一対一に対応しています。
信頼区間として必要最小限の条件を満たすパラメータθの区間に値を持つ関数[L(x,α), U(x,α)]
と
P値として必要最小限の条件を満たす関数pvalue(x,θ)
は一対一に対応しています。
38
#統計 大部分の人が読みそうもない数学的な話を上に書いた理由は、たとえそれを理解できる人が少数派であっても、それについて説明する人がいなければ、結果的に我々の社会でそれを理解している人がほぼゼロになってしまうからです。
理解している人が数的に十分にいないと誤りは放置され続ける。
理解している人が数的に十分にいないと誤りは放置され続ける。
39
#統計 ベイズ統計が実践的に利用されている場合の多くで、結果を出すために採用されている事前分布は平坦に近いものです。
モデルがシンプルで事前分布が平坦に近いと、ベイズ版の信用区間は信頼区間を近似するようになります(標本サイズ→大で相対誤差は小さくなる)。
モデルがシンプルで事前分布が平坦に近いと、ベイズ版の信用区間は信頼区間を近似するようになります(標本サイズ→大で相対誤差は小さくなる)。
40
#統計 例えば「8×2と2×8では意味が違う。8×2ではタコは8本足だが、2×8だとタコ2本足になる」と子供に教えている困った先生達がいます。
ベイズ信用区間が通常の信頼区間に数値的にほぼ一致する条件が満たされている場合にも「信頼区間と信用区間では意味が違う云々」と教えている人達はその同類です。
ベイズ信用区間が通常の信頼区間に数値的にほぼ一致する条件が満たされている場合にも「信頼区間と信用区間では意味が違う云々」と教えている人達はその同類です。
41
#統計 区間値関数[L(x,α), U(x,α)]の値を信頼区間扱いして良いかどうかはその実装の仕方で決まると信じている人達は、
スコア法による実装なら信頼区間と呼んでよいが、平坦事前分布のベイズ法による実装では信頼区間扱いは誤りで信用区間との違いを強調しなければいけない
と
誤解
してしまう。
スコア法による実装なら信頼区間と呼んでよいが、平坦事前分布のベイズ法による実装では信頼区間扱いは誤りで信用区間との違いを強調しなければいけない
と
誤解
してしまう。
42
#統計 以下のリンク先の疑問への解答は、P値の概念を使わずに、信頼水準1-αの信頼区間を高さαに線分としてプロットするだけでも得られます。
添付画像はデータ「20人中6人」から得られる母比率の信頼区間たちのグラフです。αは0.001, 0.01, 0.02, …, 1.00を動かした。続く
github.com/genkuroki/publ…

添付画像はデータ「20人中6人」から得られる母比率の信頼区間たちのグラフです。αは0.001, 0.01, 0.02, …, 1.00を動かした。続く
github.com/genkuroki/publ…
岩田健太郎 K Iwata@georgebest1969
ベイズだと確率密度が出るので悩みはないのですが、普通の頻度論統計で95%CIであってもなんらかの分布(のようなもの?)があって、平均値のほうがより真の値に近くて、CIの端っこの方が真の値である可能性は下がる、、、ような気がするのですが、どうなのでしょう。
43
#統計 データ「20人中6人」から得られる母比率pに関する100(1-α)%信頼区間を高さαに線分でプロットすると以下のグラフが得られます(採用したαの最小値は0.001)。
より狭い区間に含まれるpの値ほどデータの数値「20人中6人」に相性が良い仮想的な母比率の値になっています。
これが答え!超シンプル!

より狭い区間に含まれるpの値ほどデータの数値「20人中6人」に相性が良い仮想的な母比率の値になっています。
これが答え!超シンプル!
岩田健太郎 K Iwata@georgebest1969
ベイズだと確率密度が出るので悩みはないのですが、普通の頻度論統計で95%CIであってもなんらかの分布(のようなもの?)があって、平均値のほうがより真の値に近くて、CIの端っこの方が真の値である可能性は下がる、、、ような気がするのですが、どうなのでしょう。
44
#統計 データの数値「20人中6人」に最も相性が良い仮想的な母比率の値pは0%信頼区間に含まれる0.3です(母比率の点推定値)。
pの値が0.3から離れるほどデータの数値「20人中6人」との相性は悪くなって行きます。
グラフを見れば相性の良さの程度が定量的に分かる。
たったこれだけのこと。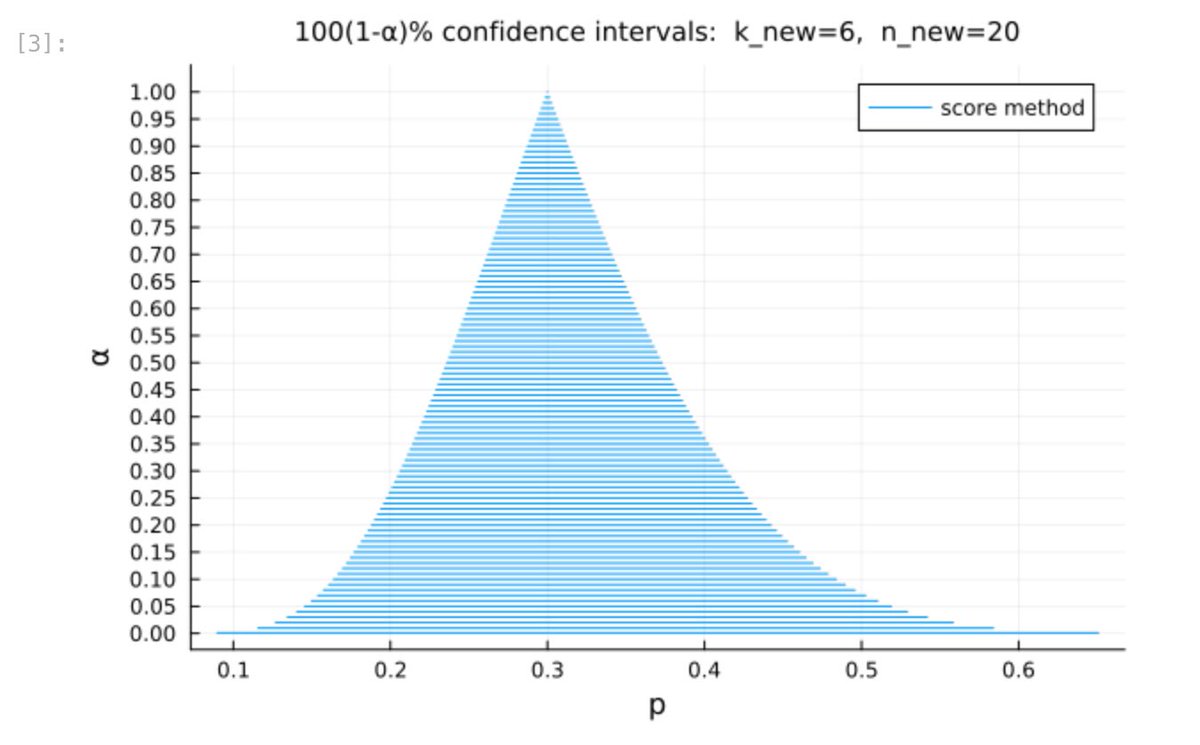
pの値が0.3から離れるほどデータの数値「20人中6人」との相性は悪くなって行きます。
グラフを見れば相性の良さの程度が定量的に分かる。
たったこれだけのこと。
45
#統計 以上の説明を一度読んでしまうと、信頼水準1-αを固定せずに動かして考えるだけという自明な話なので、
信頼区間についてもベイズ統計での事後分布のようにデータの数値との相性の良さを測る道具があるのではないか?
という疑問を持ってしまったこと自体を不思議に思うようになるでしょう。
信頼区間についてもベイズ統計での事後分布のようにデータの数値との相性の良さを測る道具があるのではないか?
という疑問を持ってしまったこと自体を不思議に思うようになるでしょう。
岩田健太郎 K Iwata@georgebest1969
ベイズだと確率密度が出るので悩みはないのですが、普通の頻度論統計で95%CIであってもなんらかの分布(のようなもの?)があって、平均値のほうがより真の値に近くて、CIの端っこの方が真の値である可能性は下がる、、、ような気がするのですが、どうなのでしょう。
46
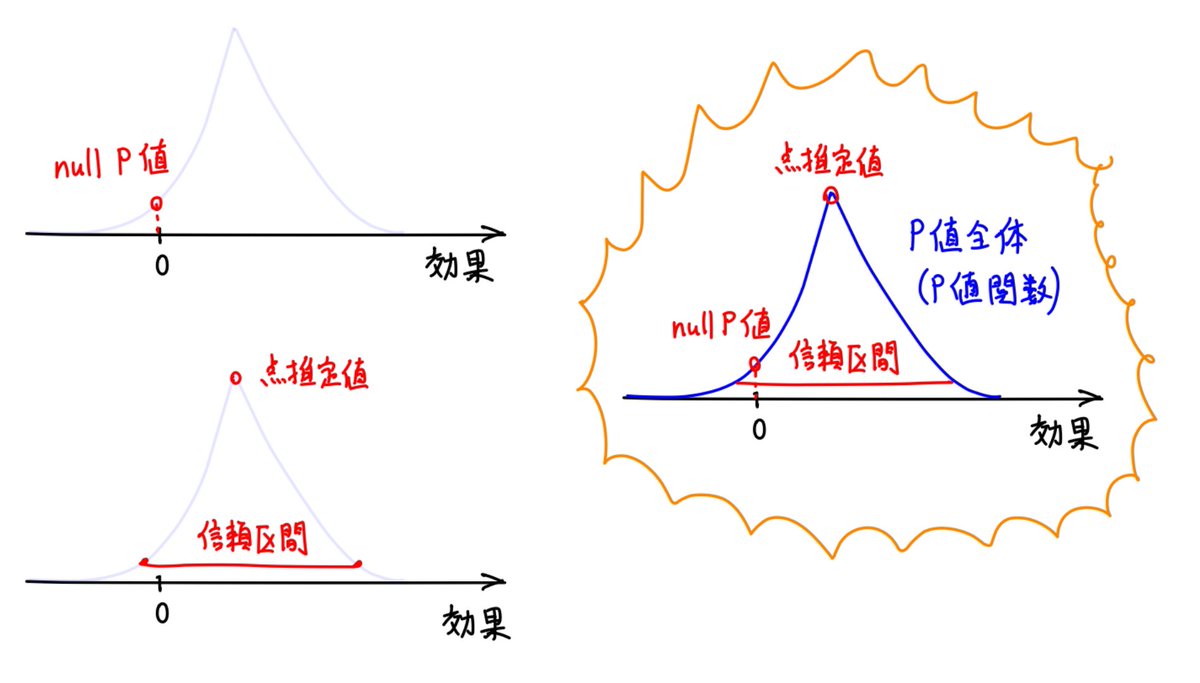
#統計 P値や信頼区間やP値の概念を十分に理解できなくなる主な原因の1つは、信頼区間として95%信頼区間しか考えなかったり、P値としてゼロ仮説θ=0のP値しか考えなかったりするからです。
すべての信頼水準の信頼区間達を同時に考えたり、すべての検定仮説θ=aのP値達を同時に考えれば理解が進みます。

すべての信頼水準の信頼区間達を同時に考えたり、すべての検定仮説θ=aのP値達を同時に考えれば理解が進みます。
黒木玄 Gen Kuroki@genkuroki
#統計 「効果はない」型の帰無仮説のP値をnull P値と呼ぶ。
結果の要約をnull P値の数値に限定すると大量に情報を捨てていることになる。
信頼区間+点推定値に替えたり追加しても大量に情報を捨てていることになる。
数値aに関する「効果はaである」型の仮説達のP値全体まで情報を増やせる。
結果の要約をnull P値の数値に限定すると大量に情報を捨てていることになる。
信頼区間+点推定値に替えたり追加しても大量に情報を捨てていることになる。
数値aに関する「効果はaである」型の仮説達のP値全体まで情報を増やせる。
47
#統計 以上のような考え方を学びたい人は、Greenlandさんの講演スライドとそこに引用されている論文達を読むのが良いと思います。
まだ世界的に十分に普及していないので、それを読めば理解度が世界の中で確実に上位に入るようになれます!
まだ世界的に十分に普及していないので、それを読めば理解度が世界の中で確実に上位に入るようになれます!
黒木玄 Gen Kuroki@genkuroki
#統計 P値関数については『ロスマンの疫学第2版』のような日本語訳された本でも学べますが、個人的な意見では、より徹底した知識を得るために、Sander Greenlandさんの講演スライドを読むのが良いと思います。
biostatistics.ucdavis.edu/sites/g/files/…
biostatistics.ucdavis.edu/sites/g/files/…
48
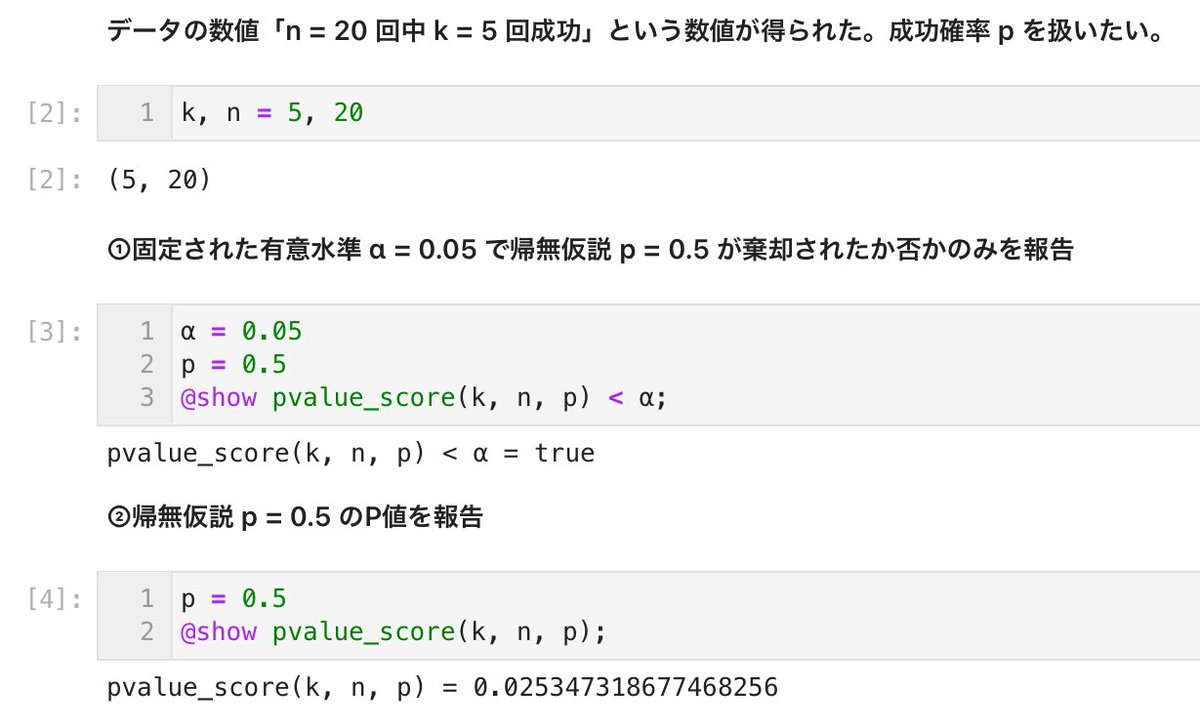
#統計 P値関数の概念の解説
黒木玄 Gen Kuroki@genkuroki
#統計 P値関数の概念に至るまで
①固定された有意水準α(例えばα=5%)で、帰無仮説θ=0が棄却されるか否かの2値的情報だけを報告。
②帰無仮説θ=0のP値を報告。そのP値は帰無仮説θ=0が棄却される有意水準の下限なので、固定されていないすべての有意水準で棄却されるか否かを報告するのと同じ。
①固定された有意水準α(例えばα=5%)で、帰無仮説θ=0が棄却されるか否かの2値的情報だけを報告。
②帰無仮説θ=0のP値を報告。そのP値は帰無仮説θ=0が棄却される有意水準の下限なので、固定されていないすべての有意水準で棄却されるか否かを報告するのと同じ。