#統計...

黒木玄 Gen Kuroki@genkuroki
84 views
Oct 21, 2024
~2 min read
Advertisement
1
#統計 ベータ分布は0から1の間に分布するので、6個の独立なベータ分布に従う確率変数Pᵢについて、Pᵢ達の和は0から6の間に分布し、1より大きくなることがあります。
総和が1の離散確率を定める条件pᵢ≥0, Σpᵢ=1 は単体を与えます。Dirichlet分布はそのようなpᵢ達の同時分布。

総和が1の離散確率を定める条件pᵢ≥0, Σpᵢ=1 は単体を与えます。Dirichlet分布はそのようなpᵢ達の同時分布。
florets@florets1
サイコロの特定の目が出るか出ないかという問題はコイン投げと同じだから、それぞれの目の出やすさのパラメーターの分布は6個のベータ分布で表現できそうな気がしていて、そしてそれはディリクレ分布と一致しそうに思うのだけど、そこがしっくりこない。腑に落ちていない。
2
#統計
普通に多項分布を使います。「すべての目が出る確率は等確率」という帰無仮説のカイ二乗検定(多項分布の正規分布近似を使う検定法、自由度は(目の個数)-1))はスタンダード。
これは二項分布の正規分布近似による検定法の一般化になっている。
普通に多項分布を使います。「すべての目が出る確率は等確率」という帰無仮説のカイ二乗検定(多項分布の正規分布近似を使う検定法、自由度は(目の個数)-1))はスタンダード。
これは二項分布の正規分布近似による検定法の一般化になっている。
florets@florets1
頻度論の仮説検定で、サイコロ投げ問題にカイ二乗分布を使いますが、多項分布を使わないのはなぜなのだろう。コイン投げ問題に二項分布を使うのだから、そっちの方が自然な拡張だと思うのです。
3
#統計 二項分布Binomial(n, p)の正規分布近似は結構小さなnpやn(1-p)であってもそう悪くないです。
二項分布の正規分布近似の基礎はn→∞で精度が高まるn!のスターリング近似だとみなせるのですが、スターリングの近似公式の相対誤差はn=1であっても8%弱で結構小さいです。
#Julia言語 →ALT

二項分布の正規分布近似の基礎はn→∞で精度が高まるn!のスターリング近似だとみなせるのですが、スターリングの近似公式の相対誤差はn=1であっても8%弱で結構小さいです。
#Julia言語 →ALT
florets@florets1
サンプル増やしていけば二項分布を正規分布で近似できますが、サンプルを増やせばそもそも検定を行う必要がなくなるという矛盾がありますね。(カイ二乗検定への悪口)
4
#統計 正規分布近似(多変量の場合を含む)が有効な場合ごとに無数のカイ二乗検定があります。
大事なことなので繰り返します。カイ二乗検定は無数にある。
最尤法の漸近論に付随する対数最大尤度比法、スコア法、Wald法は全部カイ二乗検定を与えます。
大事なことなので繰り返します。カイ二乗検定は無数にある。
最尤法の漸近論に付随する対数最大尤度比法、スコア法、Wald法は全部カイ二乗検定を与えます。
florets@florets1
@genkuroki 「カイ二乗検定は多項分布の正規分布近似を使う検定法」そういうことなんですね!ありがとうございます。道が開けました。
ところで、多項分布をそのまま使う多項検定?は流行っていないですよね。これはなんでなのでしょう。
ところで、多項分布をそのまま使う多項検定?は流行っていないですよね。これはなんでなのでしょう。
5
#統計 多項分布をそのまま使う検定法も容易に作れます。流行らない理由は知りません。続く
6
#統計 もしも「正規分布近似を使う方法よりも確率を正確に計算する方法の方が常に優れている」のように考えているとしたら、それは誤解です。
文献
↓
scholar.google.co.jp/scholar?cluste…
Approximate is better than “exact” for interval estimation of binomial proportions
Agresti-Coull 1998
文献
↓
scholar.google.co.jp/scholar?cluste…
Approximate is better than “exact” for interval estimation of binomial proportions
Agresti-Coull 1998
florets@florets1
@genkuroki 「カイ二乗検定は多項分布の正規分布近似を使う検定法」そういうことなんですね!ありがとうございます。道が開けました。
ところで、多項分布をそのまま使う多項検定?は流行っていないですよね。これはなんでなのでしょう。
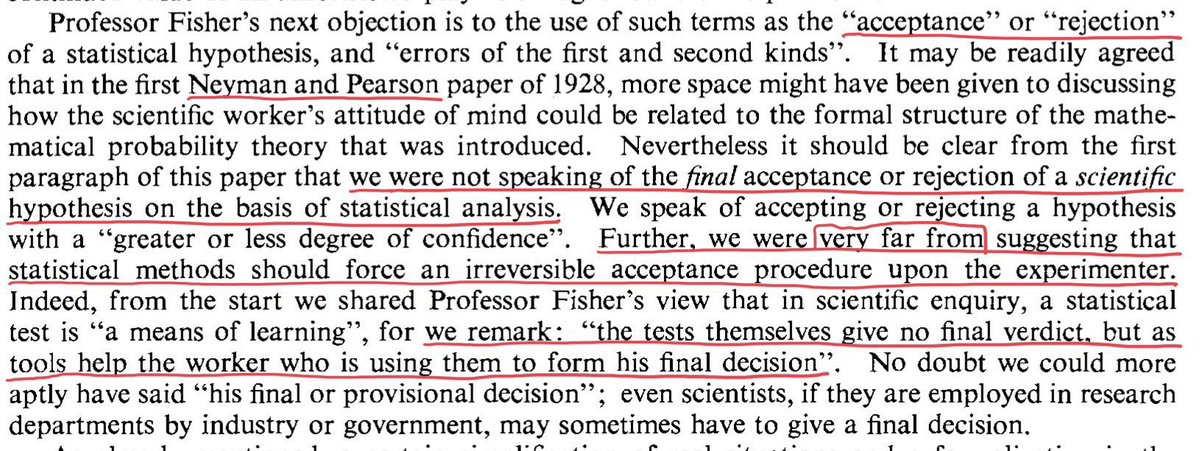
ところで、多項分布をそのまま使う多項検定?は流行っていないですよね。これはなんでなのでしょう。
7
#統計 多項分布に限らず、任意の離散分布P(x)のデータの数値xに関するP値を
pvalue(x) = Σ_{P(k)≤P(x)} P(k)
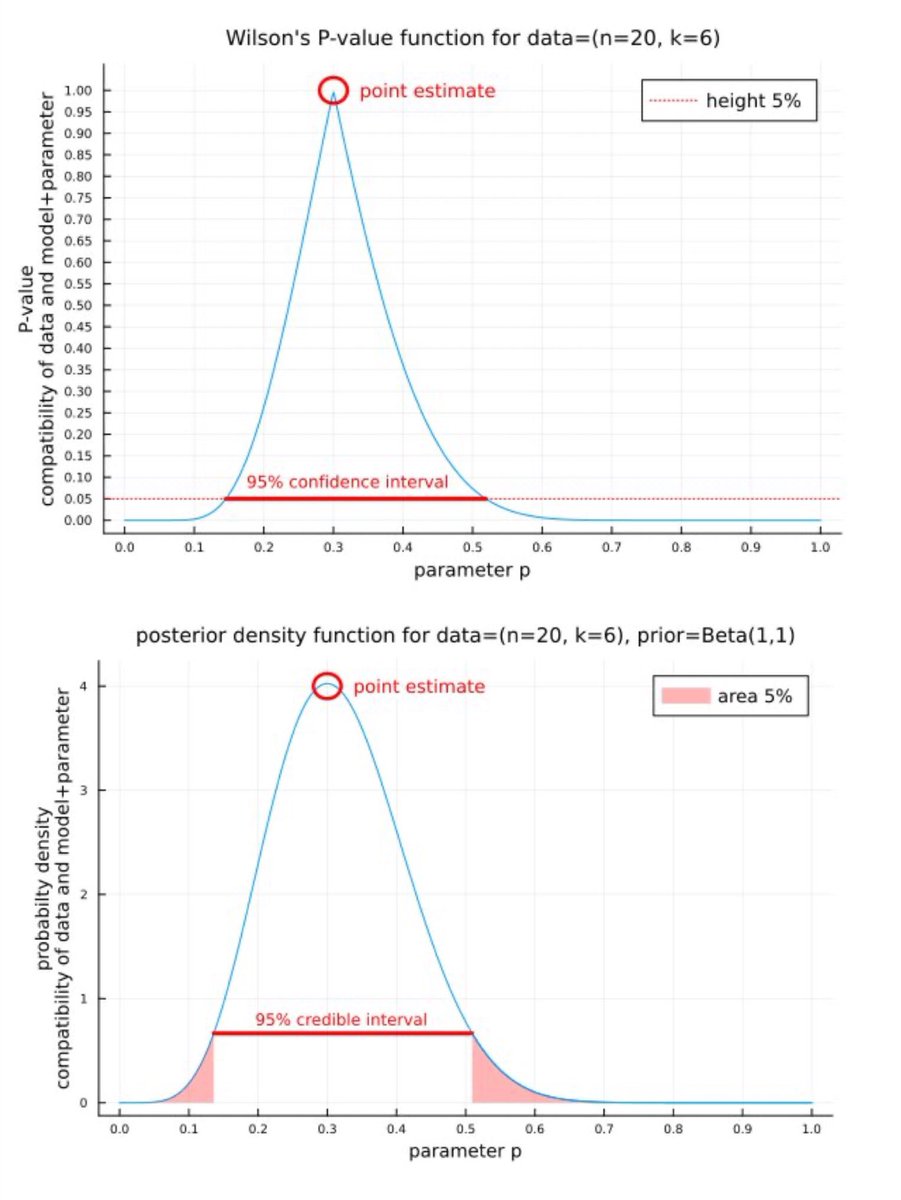
(x以下の確率になるkの確率全体の和)
で定義できます。これを、すべての目の出る確率が等しい多項分布に適用すれば多項分布をそのまま使う検定法が得られます。
計算量は非常に増えます。
pvalue(x) = Σ_{P(k)≤P(x)} P(k)
(x以下の確率になるkの確率全体の和)
で定義できます。これを、すべての目の出る確率が等しい多項分布に適用すれば多項分布をそのまま使う検定法が得られます。
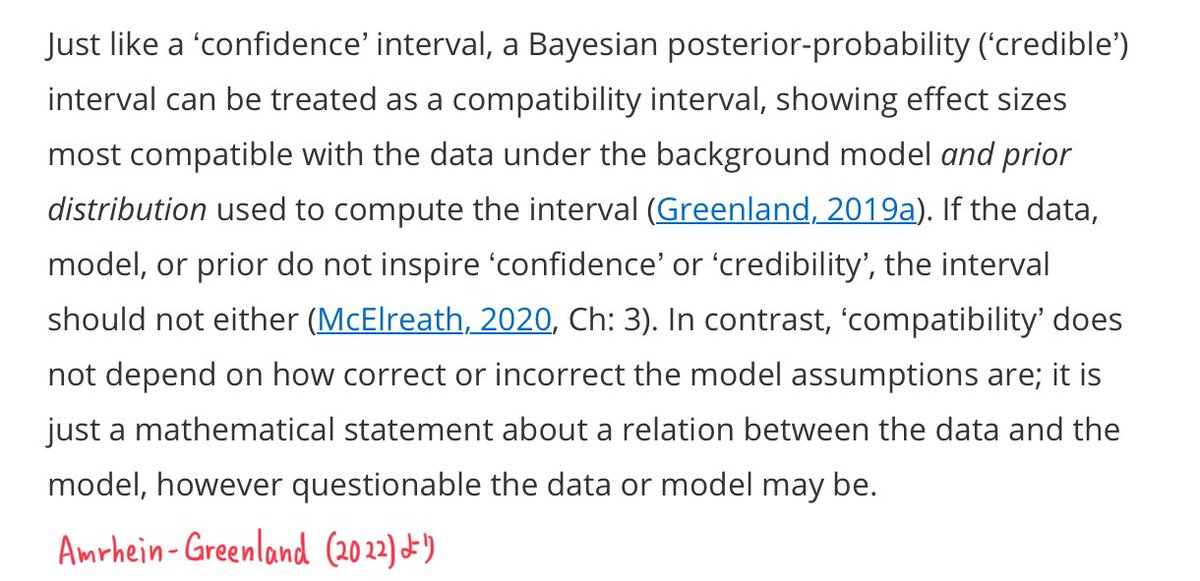
計算量は非常に増えます。
8
#統計 近似を嫌う人達は基本的なことを酷く誤解していることが多いので要注意です。
特に有害だと思うのは、2×2の分割表について
χ²検定はFisher検定の近似に過ぎないので
可能ならばFisher検定を常に使った方がよい
のような間違った考え方が蔓延していることです。
その辺、大丈夫でしょうか?
特に有害だと思うのは、2×2の分割表について
χ²検定はFisher検定の近似に過ぎないので
可能ならばFisher検定を常に使った方がよい
のような間違った考え方が蔓延していることです。
その辺、大丈夫でしょうか?
9
#統計 2×2の分割表でのPearsonのχ²検定とFisher検定に関する蔓延している誤解(コクランルールに従うべきだと教える誤り)については以下のリンク先スレッドとそのリンク先にある資料を参照。
統計学ユーザー界には伝統的に誤解が蔓延している。昔から言われていることの多くが誤り。
統計学ユーザー界には伝統的に誤解が蔓延している。昔から言われていることの多くが誤り。
10
#統計 「近似しなくてよいならしない方がうれしい」という有害な誤解は非常によく見ます。
検定法の性質の理解ではまずαエラー率がどうなっているかが重要です。
理想的には「(αエラー率)=α」となっていて欲しいのですが、離散分布モデルの検定法では近似を使わない方法でもそうなりません。続く
検定法の性質の理解ではまずαエラー率がどうなっているかが重要です。
理想的には「(αエラー率)=α」となっていて欲しいのですが、離散分布モデルの検定法では近似を使わない方法でもそうなりません。続く
11
#統計 続き。離散分布モデルの検定法であっても、同一の固定されたデータの数値から帰無仮説が棄却されるか否かを確率的にランダムに決めることを許せば、「(αエラー率)=α」を実現できるのですが(所謂UMPU検定はそういう話)、実践的には使えません。
12
#統計 離散分布モデルについての実践的に使用可能なすべての検定法は「(αエラー率)=α」を満たしていないという意味で、不正確な検定法になります。
確率を正確に計算する方法によって「(αエラー率)≤α」となるようにはできますが、αエラー率がαよりひどく小さくなって検出力が犠牲になったりします。
確率を正確に計算する方法によって「(αエラー率)≤α」となるようにはできますが、αエラー率がαよりひどく小さくなって検出力が犠牲になったりします。
13
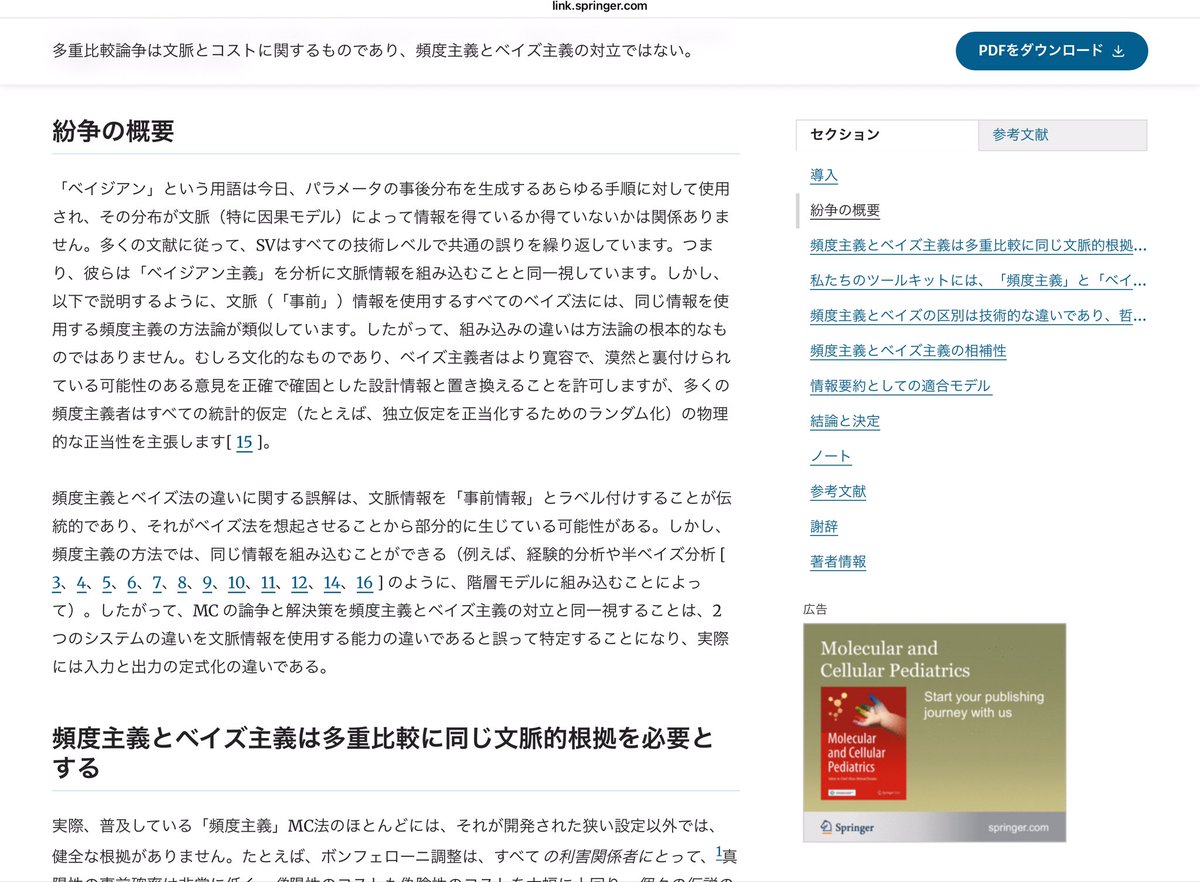
#統計 特に2×2の分割表でのFisher検定では検出力が犠牲になり易いです。
2×2の分割表では、Yatesの連続性補正なしのPearsonのχ²検定の方がαエラー率がαに近くなり、理想的なUMPU検定に近い性質を持つ場合が多いことを数値計算で確認できます。続く
2×2の分割表では、Yatesの連続性補正なしのPearsonのχ²検定の方がαエラー率がαに近くなり、理想的なUMPU検定に近い性質を持つ場合が多いことを数値計算で確認できます。続く
14
#統計 しかし、Pearsonのχ²検定では (αエラー率) ≈ α という近似は効率的に実現できても、(αエラー率) > α となる場合が生じることを防げません。
要するに、Pearsonのχ²検定とFisher検定はどちらも不正確であり、それぞれ異なる利点と欠点を持つということです。
要するに、Pearsonのχ²検定とFisher検定はどちらも不正確であり、それぞれ異なる利点と欠点を持つということです。
15
#統計 二項分布や多項分布の検定法についても同様です。
確率を正確に計算する検定法もαエラー率の意味では不正確な検定法になり、正規分布近似を使う方法との比較では利点だけではなく、欠点もある。
方法の選択はトレードオフの問題でしかない。
確率を正確に計算する検定法もαエラー率の意味では不正確な検定法になり、正規分布近似を使う方法との比較では利点だけではなく、欠点もある。
方法の選択はトレードオフの問題でしかない。
florets@florets1
@genkuroki 「正規分布近似を使う方法よりも確率を正確に計算する方法の方が常に優れている」これはそう考えていました。優れているといいますか、正規分布近似しなくてよいなら、しない方がアイデア通りでうれしいよなという気持ちです。いただいたリンク先がんばって読んでみます。
16
#統計 そもそも使用するデータの数値にはバイアスが入り込んでいる疑いが常にあるので、理想化されたモデル内での確率を正確に計算しても大してうれしくない。
あと、モデル内確率についても人間の直観はあまり効かないので、αエラー率などをコンピュータで地道に計算して確認するべきです。
あと、モデル内確率についても人間の直観はあまり効かないので、αエラー率などをコンピュータで地道に計算して確認するべきです。
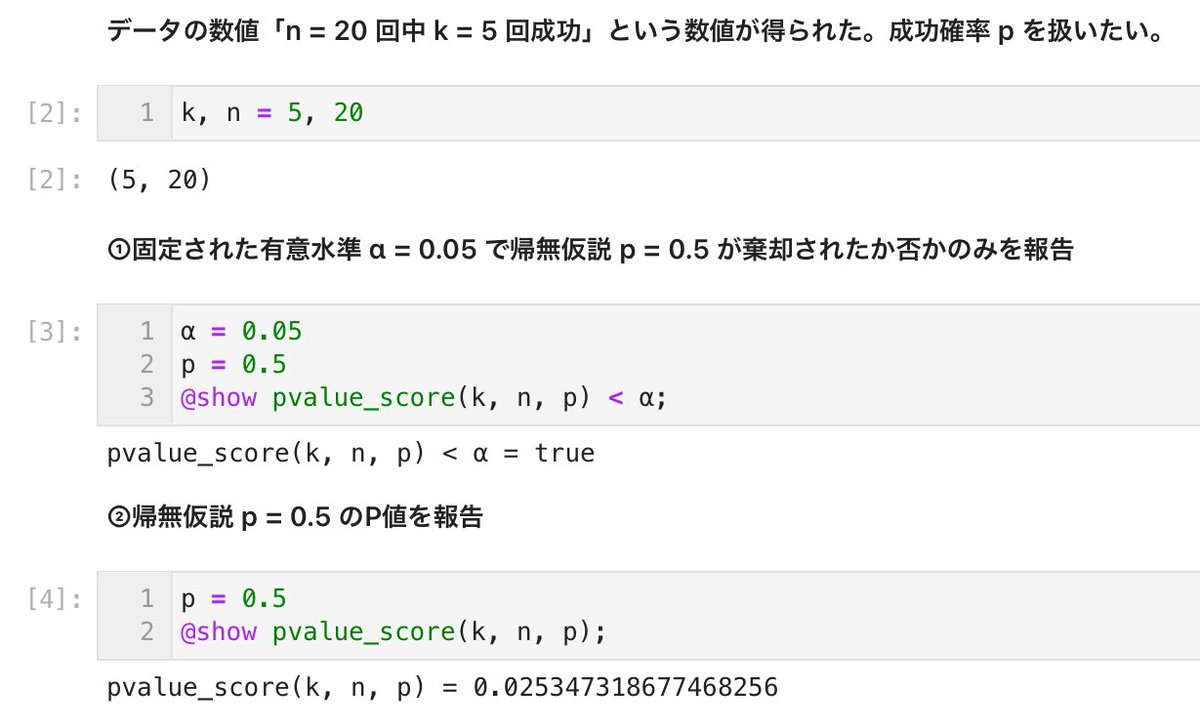
17
#統計 確率についての直観的な処理は人間にとっては非常に難しいです。本当に難しい。
検定法の評価において基本になる確率の数値であるαエラー率と検出力の数値をコンピュータで地道に計算して確認するまで、検定法の評価について変な思い込みを持たないように注意するべきだと思います。
検定法の評価において基本になる確率の数値であるαエラー率と検出力の数値をコンピュータで地道に計算して確認するまで、検定法の評価について変な思い込みを持たないように注意するべきだと思います。
florets@florets1
@genkuroki 「正規分布近似を使う方法よりも確率を正確に計算する方法の方が常に優れている」これはそう考えていました。優れているといいますか、正規分布近似しなくてよいなら、しない方がアイデア通りでうれしいよなという気持ちです。いただいたリンク先がんばって読んでみます。
18
#統計 2×2の分割表の2つの二項分布モデルにおける
理想的だが実践的には使えないUMPU検定
Pearsonのχ²検定
Fisher検定
の有意水準5%でも検出力の比較(続く)
↓

理想的だが実践的には使えないUMPU検定
Pearsonのχ²検定
Fisher検定
の有意水準5%でも検出力の比較(続く)
↓
黒木玄 Gen Kuroki@genkuroki
#統計 #Julia言語 umpu検定と連属性補正無しのχ²検定とFisher検定の有意水準5%での検出力とそれらの違いをプロットしてみました。
例えば、power: chisq b-w-r fisherのグラフでの青い部分(b)は、χ²検定の方がFisher検定より検出力が強いことを意味しています。続く
nbviewer.org/github/genkuro…
例えば、power: chisq b-w-r fisherのグラフでの青い部分(b)は、χ²検定の方がFisher検定より検出力が強いことを意味しています。続く
nbviewer.org/github/genkuro…
19
#統計 理想的だが実践的には使えないUMPU検定はFisher検定と同様の方法(条件付き確率分布を使う方法)を使って構成されるのですが、Fisher検定とUMPU検定は検出力の比較で大きく違い、近似を使うχ²検定はUMPU検定に非常に近いという結果が得られています。
nbviewer.org/github/genkuro…

nbviewer.org/github/genkuro…
黒木玄 Gen Kuroki@genkuroki
#統計 #Julia言語 umpu検定と連属性補正無しのχ²検定とFisher検定の有意水準5%での検出力とそれらの違いをプロットしてみました。
例えば、power: chisq b-w-r fisherのグラフでの青い部分(b)は、χ²検定の方がFisher検定より検出力が強いことを意味しています。続く
nbviewer.org/github/genkuro…
例えば、power: chisq b-w-r fisherのグラフでの青い部分(b)は、χ²検定の方がFisher検定より検出力が強いことを意味しています。続く
nbviewer.org/github/genkuro…
20
#統計 UMPU検定に近い構成法で得られるFisher検定が数値的にUMPU検定とは全然違い、近似を使うχ²検定の方がUMPU検定と似たような検出力を持つということも、実際に地道に計算しないと分かりません。
UMPU(UMP unbiased)検定についてはLehmannさんの超有名な教科書を参照
↓
google.com/search?q=Lehma…
UMPU(UMP unbiased)検定についてはLehmannさんの超有名な教科書を参照
↓
google.com/search?q=Lehma…
21
#統計 まとめ
* αエラー率と検出力などを実際に計算するまで、検定法の比較評価は控えるべきである。
* αエラー率と検出力がどうなるかは、多くの場合に実際に計算してみないと分からない。
* 離散分布モデルでの検定法については、確率を正確に計算する方法が良いとは限らない。
* αエラー率と検出力などを実際に計算するまで、検定法の比較評価は控えるべきである。
* αエラー率と検出力がどうなるかは、多くの場合に実際に計算してみないと分からない。
* 離散分布モデルでの検定法については、確率を正確に計算する方法が良いとは限らない。
22
#統計 簡単のために1標本t検定を考えましょう。
1標本t検定では、数学的フィクションであるモデル内の母集団分布として正規分布を仮定します。
しかし、データを取得する現実の母集団の分布は正規分布だとは仮定しません。
モデル内の仮想的な母集団と現実の母集団を完全に区別する必要がある。続く

1標本t検定では、数学的フィクションであるモデル内の母集団分布として正規分布を仮定します。
しかし、データを取得する現実の母集団の分布は正規分布だとは仮定しません。
モデル内の仮想的な母集団と現実の母集団を完全に区別する必要がある。続く
23
#統計 実際にデータを取得する母集団の分布が正規分布から外れている場合には、モデル内では成立している正規母集団の仮定が現実には成立していない場合になります。
そういう場合であっても、中心極限定理によって結構多くの場合に、母平均に関する1標本t検定がうまく行きます。続く
そういう場合であっても、中心極限定理によって結構多くの場合に、母平均に関する1標本t検定がうまく行きます。続く
24
#統計 データを取得する未知の母集団分布からのサイズnの標本の標本平均が従う分布が正規分布で十分近似されていると仮定します。(未知の母集団分布ごとにnを十分大きくすれば実際にそうなるというのが中心極限定理の主張です。)
続く
続く
florets@florets1
母集団に正規分布を仮定するt検定と、正規分布を仮定しないt検定は、名前を分けるべきだったのではないか。
25
#統計 さらに、データを取得する未知の母集団分布からのサイズnの標本の不偏分散は、未知の母集団分布の分散(母分散)を十分近似していると仮定します。(大数の法則よりnを十分条件大きくすればそうなる。)
続く
続く
florets@florets1
母集団に正規分布を仮定するt検定と、正規分布を仮定しないt検定は、名前を分けるべきだったのではないか。
26
#統計 そのとき、
T = (標本平均 - 母平均)/√(不偏分散/n)
は近似的に標準正規分布に従います。
自由度が大きめのt分布は標準正規分布でよく近似されます。
だからこの場合には1標本t検定は近似的にうまく行きます!続く
T = (標本平均 - 母平均)/√(不偏分散/n)
は近似的に標準正規分布に従います。
自由度が大きめのt分布は標準正規分布でよく近似されます。
だからこの場合には1標本t検定は近似的にうまく行きます!続く
florets@florets1
母集団に正規分布を仮定するt検定と、正規分布を仮定しないt検定は、名前を分けるべきだったのではないか。
27
#統計 自由度が20未満のt分布と標準正規分布は結構違います。その場合のt分布の使用は保守的な(P値を大きめにする)補正の役目を果たすことになります。
その補正は、未知の母集団分布が正規分布でなくても、そこそこ正規分布に近ければ結構うまく働きます。続く
その補正は、未知の母集団分布が正規分布でなくても、そこそこ正規分布に近ければ結構うまく働きます。続く
florets@florets1
母集団に正規分布を仮定するt検定と、正規分布を仮定しないt検定は、名前を分けるべきだったのではないか。
28
#統計 そういう場合には「本当のことはよくわからないこと」を受け入れて、誤差が大きい可能性が高いこと断った上で、参考情報として、結果を提示すれば良いと思います。
続く
続く
florets@florets1
母集団に正規分布を仮定するt検定と、正規分布を仮定しないt検定は、名前を分けるべきだったのではないか。
29
#統計 中心極限定理やら大数の法則による近似の仮定が実際に成立しているかは、ある程度分かる場合もあるし、ほとんど分からない場合もあります。
分からない場合には、1標本t検定の結果は信用し切るべきではない結果になります。続き
分からない場合には、1標本t検定の結果は信用し切るべきではない結果になります。続き
florets@florets1
母集団に正規分布を仮定するt検定と、正規分布を仮定しないt検定は、名前を分けるべきだったのではないか。
30
#統計 データの数値(標本の数値)が与えられたとき、1標本t検定のP値は具体的な数値μに関する「母平均はμである」という検定仮説ごとに決まるので、P値は数値μの関数になります。
これをデータの数値から決まるP値関数と呼びます。続く
これをデータの数値から決まるP値関数と呼びます。続く
31
#統計 P値関数は、P値の計算に使ったモデルの仮定の下での、データの数値と「母平均はμである」という仮説達の相性の良さの様子を表すと解釈されます。
この解釈は、データの数値の取得の仕方が不適切でも、モデルの仮定が現実には妥当でなくても有効です。続く
この解釈は、データの数値の取得の仕方が不適切でも、モデルの仮定が現実には妥当でなくても有効です。続く
32
#統計 P値関数の使い方はベイズ統計での事後分布と同じです。
モデルが妥当でかつデータの数値の取得法も適切ならば、P値関数のグラフを見ることによって、「母平均はμである」という仮説の現実との整合性をP値関数の値で測ることができます。(警告: 実際にはそう単純ではない場合がある。)
モデルが妥当でかつデータの数値の取得法も適切ならば、P値関数のグラフを見ることによって、「母平均はμである」という仮説の現実との整合性をP値関数の値で測ることができます。(警告: 実際にはそう単純ではない場合がある。)
33
#統計 特定の単独のμの値に関するP値が5%未満かどうかで安易な2値的判断を下すことはP値の誤用になります。
豊田秀樹さんに代表される困った人達はP値を誤用することをP値の標準的使用法だとみなして、P値の使用を不当に攻撃しているのできちんと否定して行く必要があります。
この辺、危なそう。
豊田秀樹さんに代表される困った人達はP値を誤用することをP値の標準的使用法だとみなして、P値の使用を不当に攻撃しているのできちんと否定して行く必要があります。
この辺、危なそう。
florets@florets1
母集団に正規分布を仮定するt検定と、正規分布を仮定しないt検定は、名前を分けるべきだったのではないか。
34
#統計 P値関数はベイズ統計での事後分布とほぼ同じ使われ方をする道具で、実際それら2つの方法で得られた結果は近似的に一致する場合が多数あります。
逆にベイズ統計での事後分布の使用時にはP値に関する注意がすべてそのまま適用される。続く
逆にベイズ統計での事後分布の使用時にはP値に関する注意がすべてそのまま適用される。続く
florets@florets1
母集団に正規分布を仮定するt検定と、正規分布を仮定しないt検定は、名前を分けるべきだったのではないか。
35
#統計 ちなみに、1標本t検定の方法を使って得た母平均の信頼区間と、μとlog σ²に関する正規分布モデルのベイズ統計から得た信用区間は誤差無しに数学的にぴったり等しくなります。
1標本t検定に対応するベイズ統計の現実への適用可能性は1標本t検定と全く同じであるべきです。続く
1標本t検定に対応するベイズ統計の現実への適用可能性は1標本t検定と全く同じであるべきです。続く
florets@florets1
母集団に正規分布を仮定するt検定と、正規分布を仮定しないt検定は、名前を分けるべきだったのではないか。
36
#統計 その条件はずっと上の方で述べたように、大雑把には
* データを取得する未知の母集団分布のサイズnの標本の標本平均が従う分布は正規分布で十分近似されている。
* 同標本の不偏分散は母分散をよく近似している。
になります。
* データを取得する未知の母集団分布のサイズnの標本の標本平均が従う分布は正規分布で十分近似されている。
* 同標本の不偏分散は母分散をよく近似している。
になります。
37
#統計 統計学教育では伝統的に数学的フィクションでしかないモデル内部での仮定(例えば正規分布)が現実においても成立している場合を暗黙のうちに想定して話を進めていたりします。所謂「小さな世界」での統計学です。
「小さな世界」の統計学は役に立たないので実践的には無視すれば良いと思います。
「小さな世界」の統計学は役に立たないので実践的には無視すれば良いと思います。
florets@florets1
母集団に正規分布を仮定するt検定と、正規分布を仮定しないt検定は、名前を分けるべきだったのではないか。
38
#統計 訂正
リンクを失敗したところを1つ削除したせいで、以下のリンク先の「そういう場合には」の「そういう場合」が書かれていた投稿が消えてしまいました。ごめんなさい。
「そういう場合」とは、諸々の仮定の現実での成立が怪しい場合やよく分からない場合のことです。
リンクを失敗したところを1つ削除したせいで、以下のリンク先の「そういう場合には」の「そういう場合」が書かれていた投稿が消えてしまいました。ごめんなさい。
「そういう場合」とは、諸々の仮定の現実での成立が怪しい場合やよく分からない場合のことです。
黒木玄 Gen Kuroki@genkuroki
#統計 そういう場合には「本当のことはよくわからないこと」を受け入れて、誤差が大きい可能性が高いこと断った上で、参考情報として、結果を提示すれば良いと思います。
続く
続く
39
#統計 すみません。この投稿の1つ上の訂正も見て下さい。
まとめ
* t検定の通常の説明ではモデル内の仮想的な母集団分布として正規分布を仮定する。(対応するベイズ版でも同様)
* データを取得する現実の未知の母集団分布は正規分布である必要はない。しかし、t検定が機能するには条件が必要。
まとめ
* t検定の通常の説明ではモデル内の仮想的な母集団分布として正規分布を仮定する。(対応するベイズ版でも同様)
* データを取得する現実の未知の母集団分布は正規分布である必要はない。しかし、t検定が機能するには条件が必要。
40
#統計 関連スレッド
悪しき伝統芸の継承者達問題。
悪しき伝統芸の継承者達問題。
41
#統計 以下のリンク先スレッドには「24回中7回表が出た」というデータの数値と「表の出る確率はpである」という仮説の相性の良さの程度を表すP値関数達のグラフがある。
42
#統計 一般化
離散分布の確率質量関数P(x)と実数値関数R(x)からP値を
pvalue(x) = Σ_{R(k)≤R(x)} P(k)
によって定めることもできる。R(k)≤R(x)は「kがx以上に極端な値」を意味する。関数R(x)の決め方はケースバイケース。
負の二項分布モデルの場合にはここまで一般化しておいた方が良さそう。
離散分布の確率質量関数P(x)と実数値関数R(x)からP値を
pvalue(x) = Σ_{R(k)≤R(x)} P(k)
によって定めることもできる。R(k)≤R(x)は「kがx以上に極端な値」を意味する。関数R(x)の決め方はケースバイケース。
負の二項分布モデルの場合にはここまで一般化しておいた方が良さそう。
黒木玄 Gen Kuroki@genkuroki
#統計 多項分布に限らず、任意の離散分布P(x)のデータの数値xに関するP値を
pvalue(x) = Σ_{P(k)≤P(x)} P(k)
(x以下の確率になるkの確率全体の和)
で定義できます。これを、すべての目の出る確率が等しい多項分布に適用すれば多項分布をそのまま使う検定法が得られます。
計算量は非常に増えます。
pvalue(x) = Σ_{P(k)≤P(x)} P(k)
(x以下の確率になるkの確率全体の和)
で定義できます。これを、すべての目の出る確率が等しい多項分布に適用すれば多項分布をそのまま使う検定法が得られます。
計算量は非常に増えます。
43
#統計 うわ!P値の学習について不合理な困難を抱えているように見えた理由は豊田秀樹さん的な悪しき言説に影響を受けていたから何ですね。早めに豊田秀樹さんを否定する側に回った方が多くの事柄を気持ちよく勉強できるようになると思います。
スレッドに続く(必読)
confit.atlas.jp/guide/event-im…

スレッドに続く(必読)
confit.atlas.jp/guide/event-im…
florets@florets1
「有意性検定とは「帰無仮説が偽であるという結論の下で,棄却だったらnが大きかった,採択だったらnが小さかったということを判定する方法」と言い換えることすらできます。 ナンセンスなのです。」
しっくりきますね〜。
confit.atlas.jp/guide/event-im…
しっくりきますね〜。
confit.atlas.jp/guide/event-im…
44
#統計 添付画像のように confit.atlas.jp/guide/event-im… では、合理的な
⭕️ポストp<0.05時代
と不合理な
❌ポストp値時代
をまるで同じことを言っているかのように扱っています。
P値<5%という条件による安易な2値的判断がダメであることは当たり前の話で、P値のそういう使い方はP値の単なる誤用。続く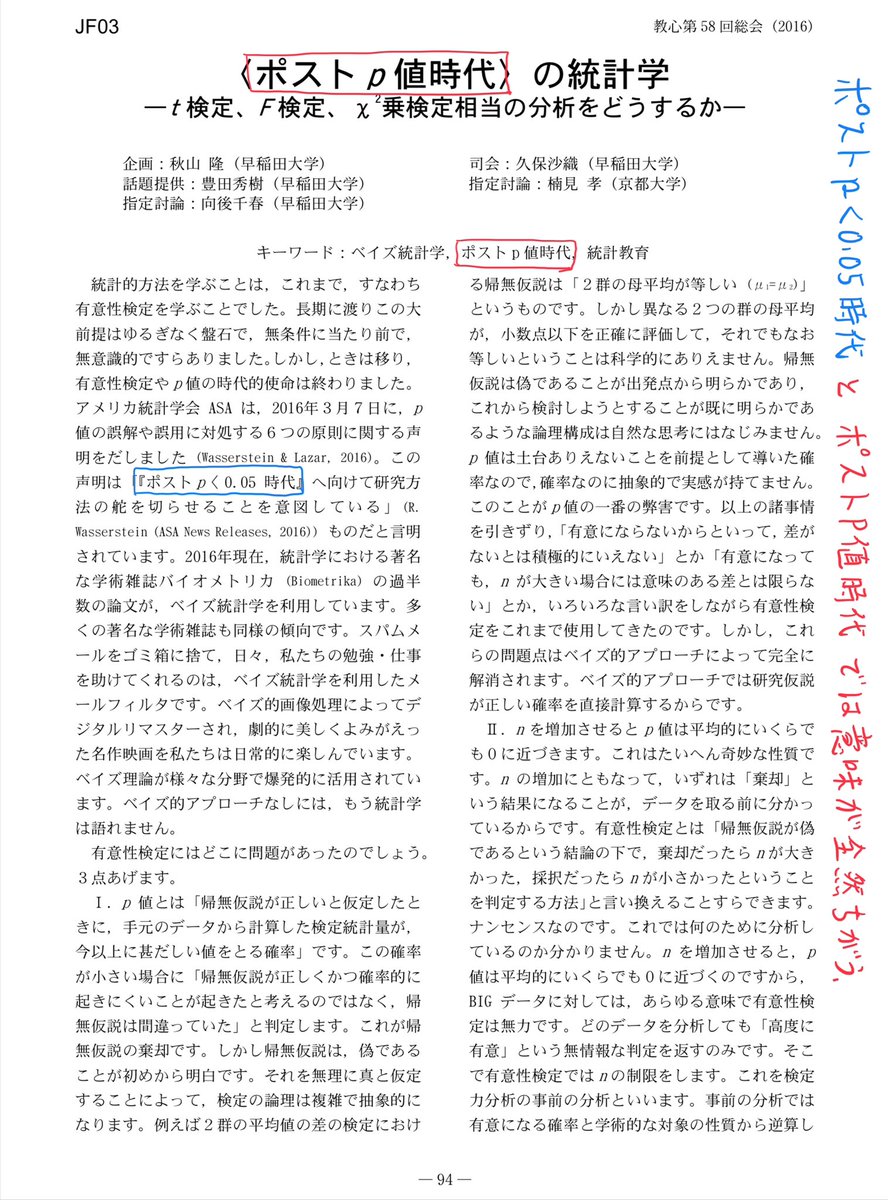
⭕️ポストp<0.05時代
と不合理な
❌ポストp値時代
をまるで同じことを言っているかのように扱っています。
P値<5%という条件による安易な2値的判断がダメであることは当たり前の話で、P値のそういう使い方はP値の単なる誤用。続く
45
#統計 P値の正しい使い方についてはGreenlandさん達が繰り返し解説してくれています。
P値は、特定のモデルの下でのデータの数値とモデルのパラメータの値の相性の指標の1つ。
P値(より正確にはP値関数)は、推定のための道具としても使える。

P値は、特定のモデルの下でのデータの数値とモデルのパラメータの値の相性の指標の1つ。
P値(より正確にはP値関数)は、推定のための道具としても使える。
黒木玄 Gen Kuroki@genkuroki
#統計 お勧めのGreenlandさんの講演スライドより
P値を推定のための道具として扱わない誤りの繰り返しはやめるべき。
「差がない」という帰無仮説のnull P値単体を帰無仮説有意性検定(NHST)で使うだけなのは誤解の主な原因になっている。
biostatistics.ucdavis.edu/sites/g/files/…
P値を推定のための道具として扱わない誤りの繰り返しはやめるべき。
「差がない」という帰無仮説のnull P値単体を帰無仮説有意性検定(NHST)で使うだけなのは誤解の主な原因になっている。
biostatistics.ucdavis.edu/sites/g/files/…
46
#統計 P値関数についてはRothmanさんの疫学の教科書にも昔から載っていました。P値関数の使用を勧めて来たRothmanさんはP値<0.05による安易な2値的判断に対する批判者としても有名だと思います。
P値<0.05による安易な2値的判断を否定する常識的態度と、P値そのものを否定する態度では大違いです。
P値<0.05による安易な2値的判断を否定する常識的態度と、P値そのものを否定する態度では大違いです。
47
#統計 豊田秀樹さんを代表とする「ポストP値時代」言説の宣伝者達は、誤用だとされているP値の使い方をP値の正式な使い方であるかのようにみなし、それを否定することによって、P値はダメだと言っています。
これは大変悪質な行為でみんなで非難する価値があります。
これは大変悪質な行為でみんなで非難する価値があります。
48
#統計 P値の誤用(みんな誤用しているのでASA声明が出た)をP値の正式な使い方であるかのように宣伝されてしまうと、それに影響を受けた人達はP値についての真っ当な勉強をすることが精神的に難しくなるでしょう。
RothmanさんやGreenlandさんのような超大物による解説さえ発見できなくなってしまう。
RothmanさんやGreenlandさんのような超大物による解説さえ発見できなくなってしまう。
49
#統計 以下のリンク先のグラフは、二項分布モデル(もしくは同じことになるが負の二項分布モデル)の場合の、Pearsonのχ²検定のP値関数とベイズ統計の事後分布から得たP値関数の同時プロットです。その2つはほぼ一致しています。
ベイズ推しの人はPearsonのχ²検定も推さざるを得ない(笑)

ベイズ推しの人はPearsonのχ²検定も推さざるを得ない(笑)
黒木玄 Gen Kuroki@genkuroki
#統計 せっかくなので、スコア法のP値関数と、ベイズ統計での事後分布から作ったP値関数の比較も行ってみました。
この場合にはほぼ一致しています。
こういうグラフを描けば、数値的にhs。ベイズと非ベイズは大して違わないことを沢山の場合に確認できます。
nbviewer.org/github/genkuro…
この場合にはほぼ一致しています。
こういうグラフを描けば、数値的にhs。ベイズと非ベイズは大して違わないことを沢山の場合に確認できます。
nbviewer.org/github/genkuro…
50
#統計 以下のリンク先では
所謂「頻度論」のP値(二項分布モデルでのPearsonのχ²検定のP値=正規分布近似によるP値)のグラフ
と
ベイズ統計での事後分布
のグラフを並べています。ほぼ同じ使い方をできることは明らかです。(事後分布をP値関数に変換するとそれらはほぼ一致する)
所謂「頻度論」のP値(二項分布モデルでのPearsonのχ²検定のP値=正規分布近似によるP値)のグラフ
と
ベイズ統計での事後分布
のグラフを並べています。ほぼ同じ使い方をできることは明らかです。(事後分布をP値関数に変換するとそれらはほぼ一致する)

51
#統計 豊田秀樹さんの『瀕死』本に載っているphc (研究仮説が正しい確率 probability that research hypothesis is correct)の幾つかは所謂「頻度論」的な片側P値によく一致している。
P値を否定してphcを勧める豊田氏は実質的に、P値を否定してP値を勧めていることになります。
余りにもダメすぎ!


P値を否定してphcを勧める豊田氏は実質的に、P値を否定してP値を勧めていることになります。
余りにもダメすぎ!
黒木玄 Gen Kuroki@genkuroki
@wakadaishou #統計 豊田氏が推しているphcと通常の(片側)P値の同時プロットを見れば、豊田氏はP値を否定して数値的にP値にほぼ同じphcを推すという訳のわからないことをやっていることが分かります。
これをトンデモ扱いしないある種の分野の人達もトンデモの仲間扱いが妥当でしょう。
nbviewer.org/gist/genkuroki…
これをトンデモ扱いしないある種の分野の人達もトンデモの仲間扱いが妥当でしょう。
nbviewer.org/gist/genkuroki…
52
#統計 豊田秀樹さんが扱っているような例ではベイズ的な事後確率が頻度論的なP値によく一致します。
この事実の認識にはP値についてのある程度以上の理解が必要なのですが、そのための勉強を豊田秀樹氏とその協力者達は阻害しているわけです。続く
この事実の認識にはP値についてのある程度以上の理解が必要なのですが、そのための勉強を豊田秀樹氏とその協力者達は阻害しているわけです。続く
53
#統計 実際には豊田秀樹氏自身が統計学に関する基礎的な学習が不十分で、事後確率とP値の関係を全然理解できていないように見えます。
勉強不足の人がP値とベイズ統計の両方について誤解をばらまいている。
騙されないように注意が必要。
潜在的にどれだけの被害者がいることやら。
勉強不足の人がP値とベイズ統計の両方について誤解をばらまいている。
騙されないように注意が必要。
潜在的にどれだけの被害者がいることやら。
54
#統計 P値について十分に勉強して、以下のリンク先の添付画像上段のP値関数のグラフとその見方に習熟すれば、ベイズ統計での事後分布の使い方については「P値関数と同じ」と説明でき、ベイズ統計のツールを使った統計モデリングにスムーズに進めます。
教育的にはP値を否定しない方が良いです。
教育的にはP値を否定しない方が良いです。
55
#統計 Neyman-PearsonのPeasonさんも、NP流の仮説検定の結論をそのまま最終結論にするべきだとは言っておらず、意思決定を助けるための道具であると言っています。
NP流の仮説検定による2分法による結論をそのまま最終結論とするかのように思っている人達は誤解している。
errorstatistics.com/wp-content/upl…
NP流の仮説検定による2分法による結論をそのまま最終結論とするかのように思っている人達は誤解している。
errorstatistics.com/wp-content/upl…
黒木玄 Gen Kuroki@genkuroki
#統計 繰り返し
Neyman-PearsonのPeasonさんも、NP流の仮説検定の結論をそのまま最終結論にするべきだとは言っておらず、意思決定を助けるための道具であることを強調しています。
この原則はすべての統計分析の結果についても通用し、結果の報告はそういう道具として機能するように行うべき。
Neyman-PearsonのPeasonさんも、NP流の仮説検定の結論をそのまま最終結論にするべきだとは言っておらず、意思決定を助けるための道具であることを強調しています。
この原則はすべての統計分析の結果についても通用し、結果の報告はそういう道具として機能するように行うべき。
56
#統計 帰無仮説だけではなく、比較対象の対立仮説を設定することは検出力を定義して効率の良い検定法(もしくはP値の構成法)を得るために必要なことです。
そういう意味で価値がある事柄について「仮説検定の結論はそのまま最終結論になる」と誤解するのはダメすぎます。何も理解していない。
そういう意味で価値がある事柄について「仮説検定の結論はそのまま最終結論になる」と誤解するのはダメすぎます。何も理解していない。
57
#統計 仮説検定の結論を安易に最終的な結論扱いしてはいけないという主張は、P値<5%によって安易に2値的判断をしてはいけないことを含んでいます。
このPearsonさんの説明は常識的だと思います。
Pearson 1955
scholar.google.co.jp/scholar?cluste…
errorstatistics.com/wp-content/upl…
このPearsonさんの説明は常識的だと思います。
Pearson 1955
scholar.google.co.jp/scholar?cluste…
errorstatistics.com/wp-content/upl…
58
#統計 今後の統計学教育の改革については、Greenlandさん(超大物!)の講演スライドが秀逸だと思います。
P値について教えるときに注意するべきことが明瞭に書いてあります。(そしてP値関数について理解すればベイズ統計への移行も容易)
抵抗勢力の問題も率直に指摘。
biostatistics.ucdavis.edu/sites/g/files/…
P値について教えるときに注意するべきことが明瞭に書いてあります。(そしてP値関数について理解すればベイズ統計への移行も容易)
抵抗勢力の問題も率直に指摘。
biostatistics.ucdavis.edu/sites/g/files/…
59
#統計 図の上段のP値のグラフも図の下段の事後分布のグラフも__どちらも__「20回中6回成功」というデータの数値とモデルと「成功確率はp」という設定の相性の良さの様子を表しています。
相性が最大のpの値がpの点推定値で、区間推定は図にある通り。
相性が最大のpの値がpの点推定値で、区間推定は図にある通り。
60
#統計 P値や事後確率が確率であることを安易に強調するのは有害です。P値も事後確率もどちらも数学的フィクションであるモデル内での確率に過ぎないので、現実にそのまま適用できる確率ではありません。
P値も事後分布もデータの数値とのモデルの相性の良さを表していることを強調した方が無難。
P値も事後分布もデータの数値とのモデルの相性の良さを表していることを強調した方が無難。
61
#統計 同じことは、95%信頼区間や95%信用区間の95%についても言えます。それらの95%を確率だと強調することはミスリーディングです。それらの95%は数学的フィクションであるモデル内での確率にすぎません。現実における確率ではない。
続く
続く
62
#統計 モデルのパラメータθの95%信頼区間の定義はP値≥5%となるパラメータθ全体の区間です。
P値は、データの数値とモデルのパラメータθの値の相性の良さの指標でした。信頼区間は5%のような閾値でデータの数値と相性が良いとみなされるパラメータθの値の集合であると解釈されます。
P値は、データの数値とモデルのパラメータθの値の相性の良さの指標でした。信頼区間は5%のような閾値でデータの数値と相性が良いとみなされるパラメータθの値の集合であると解釈されます。
63
#統計 信頼区間もまたP値<5%か否かでの二分法を実行する道具なので、信頼区間に興味あるパラメータの値が含まれるか否かを安易に最終結論に結びつけないように注意が必要になります。
64
#統計 以上に書いた話はRothmanさんやGreenlandさんのような超有名人達が書いた解説文を読んでいる人にとってはスタンダードな内容で、しかも非常に合理的だと思うのですが、現実には全然普及していません。
どんなに偉い人が全力で解説を書いても効果がないというのが現状。
どんなに偉い人が全力で解説を書いても効果がないというのが現状。
65
#統計 Greenlandさん達が広めている「データの数値とモデルの相性の良さ(compatibility)の様子の記述」というP値や信頼区間の解釈の仕方は、ベイズ統計での事後分布の解釈の仕方にも影響を与えています。
McElreathさんのStatistical Rethinkingでは信用区間をcompatibilityで解釈しています。

McElreathさんのStatistical Rethinkingでは信用区間をcompatibilityで解釈しています。
黒木玄 Gen Kuroki@genkuroki
#統計 通常の信頼区間だけではなく、ベイズ版の信用区間も compatibility interval と呼んで同じように解釈することの合理性については、McElreathさんのStatistical Rethinking 2nd ed. の3.2.2 (p.54)を参照。
Amrhein-Greenland (2022) journals.sagepub.com/doi/10.1177/02… も参照。
Amrhein-Greenland (2022) journals.sagepub.com/doi/10.1177/02… も参照。
66
#統計 GreenlandさんやMcElreathさん(Statistical Rethinking)のような科学的に合理的な人達は、非ベイズとベイズの両方の区間推定について、現実を直接記述するものだと誤解させないように、データの数値とモデルのパラメータの値の相性の良さ(compatibility)を記述していると説明している。続く
67
#統計 それに対して、豊田秀樹さんのような基本的な事柄をよく理解していない人達やある種の有害言説に騙されている人達は、ベイズ版の95%信用区間であれば「真の値が区間に含まれる確率は95%である」と解釈でき、頻度論の95%信頼区間よりも分かりやすい、というデタラメを平気で述べる。
68
#統計 頻度論版の95%信頼区間であっても、ベイズ版の95%信用区間であっても、数学的フィクションであるモデルの内側であれば、真の値が含まれる確率は95%になります(ただしそれらの確率の定義は違う)。
どちらについても現実において95%という確率が得られているわけではありません。続く
どちらについても現実において95%という確率が得られているわけではありません。続く
69
#統計 P値関数や信頼区間やベイズ統計の事後分布やベイズファクターをコンピュータで求めても、そこから直接分かることは、データの数値とモデルの相性の良さ(compatibility)の様子だけで、データの数値の背後にある隠された現実の真実が明らかになることはありません。続く
70
#統計 P値関数や信頼区間やベイズ統計の事後分布やベイズファクターをコンピュータで求めただけでは、データの数値の背後にある現実の隠された真実については何もわからず、それ以外の面倒な議論をして初めて科学的に色々なことが言えるわけです。
個人的にこれは当たり前の話だと思います。
個人的にこれは当たり前の話だと思います。
71
#統計 P値関数や信頼区間やベイズ統計の事後分布やベイズファクターをコンピュータで求めただけで、自分が欲しい結論について科学的お墨付きが得られて欲しいという要求を常識的な判断力によってきちんと全否定できれば、多くの事柄がシンプルに易しい話に見えて来ます。
72
#統計 P値関数や信頼区間やベイズ統計の事後分布やベイズファクターをコンピュータで求めることはモデルを使ったデータの数値の記述統計を行っていることになる。
記述統計以上の結論を出すには別の議論が必要。
自分が得たデータの数値だけでは解きたい問題に決着を付けられないかもしれない。続く
記述統計以上の結論を出すには別の議論が必要。
自分が得たデータの数値だけでは解きたい問題に決着を付けられないかもしれない。続く
73
#統計 たとえ自分が得たデータの数値だけでは解きたい問題に決着を付けられないとしても、根拠が不十分であっても仮の設定として十分に合理的なモデルを通してデータの数値を眺めるとどのように見えるかを整理された形で報告することは科学的に価値ある行為です。そのための道具が~続く
74
#統計 そのための道具が、P値関数、信頼区間、事後分布、ベイズファクター、各種の情報量規準、などなのです。
それらをお墨付きを得るための道具だとみなそうとすると必ず不合理な考え方になる。
モデルを使ってデータの数値がどのように見えるかを報告するための道具だとみなすとシンプル。
それらをお墨付きを得るための道具だとみなそうとすると必ず不合理な考え方になる。
モデルを使ってデータの数値がどのように見えるかを報告するための道具だとみなすとシンプル。
75
#統計 以上のストーリーは、科学哲学的な議論によって統計学を科学的なお墨付きを得るための道具とみなそうとする行為も否定していることに注意して下さい。
個人的な経験では、統計学の哲学の言説は統計学的ツールの理解のために有害であることが多いと思います。内容的に粗雑な議論が実に多い。
個人的な経験では、統計学の哲学の言説は統計学的ツールの理解のために有害であることが多いと思います。内容的に粗雑な議論が実に多い。
76
#統計 関連

黒木玄 Gen Kuroki@genkuroki
#統計 二項分布モデルと負の二項分布モデルの場合に確率を正確に計算する方法で得たP値を比較して
同じデータの数値なのにP値が違う!
と騒ぎ立てるという
悪しき伝統芸の継承者達
が再生産され続けているという問題があります。
スコア検定のP値は等しくなります。
github.com/genkuroki/publ…
同じデータの数値なのにP値が違う!
と騒ぎ立てるという
悪しき伝統芸の継承者達
が再生産され続けているという問題があります。
スコア検定のP値は等しくなります。
github.com/genkuroki/publ…
77
#統計 「頻度論だと標本サイズを大きくし過ぎると困る」という説をばらまいている人は、単に理解していないだけのお馬鹿さん達なので、勉強するときには無視した方が良いです。
倫理的な理由で標本サイズを必要最小限に抑えることは合理的ですが、それはベイズでも同じことで頻度論云々は関係ない。
倫理的な理由で標本サイズを必要最小限に抑えることは合理的ですが、それはベイズでも同じことで頻度論云々は関係ない。
florets@florets1
伝統的統計学がしっくりこないのですよね。「私の」直感と合わない。サンプルサイズが多過ぎるとダメで、適度に少なくしなければいけないこととか。データが多くて困るって何事?
78
#統計 floretsさんの過去の投稿を少し見てみましたが、豊田秀樹さん的な無知に基くおかしな言説(もしくは悪質な印象操作)に騙されてしまっているように見えました。
GreenlandさんやMcElreathさんのような信頼できる人達に学んだ方が良いと思いました。
詳しくはこのスレッド全体を参照。
GreenlandさんやMcElreathさんのような信頼できる人達に学んだ方が良いと思いました。
詳しくはこのスレッド全体を参照。
florets@florets1
伝統的統計学がしっくりこないのですよね。「私の」直感と合わない。サンプルサイズが多過ぎるとダメで、適度に少なくしなければいけないこととか。データが多くて困るって何事?
79
#統計 次のような問題を解けば誤解が解けるかも。P値関数のような基本概念を知らずに「しっくりこない」のように言うべきではないです。
問題: 統計モデルとデータの数値を具体的に与えてP値関数のグラフをプロットして、その解釈の仕方について簡単に説明せよ。
ヒント
↓
biostatistics.ucdavis.edu/sites/g/files/…
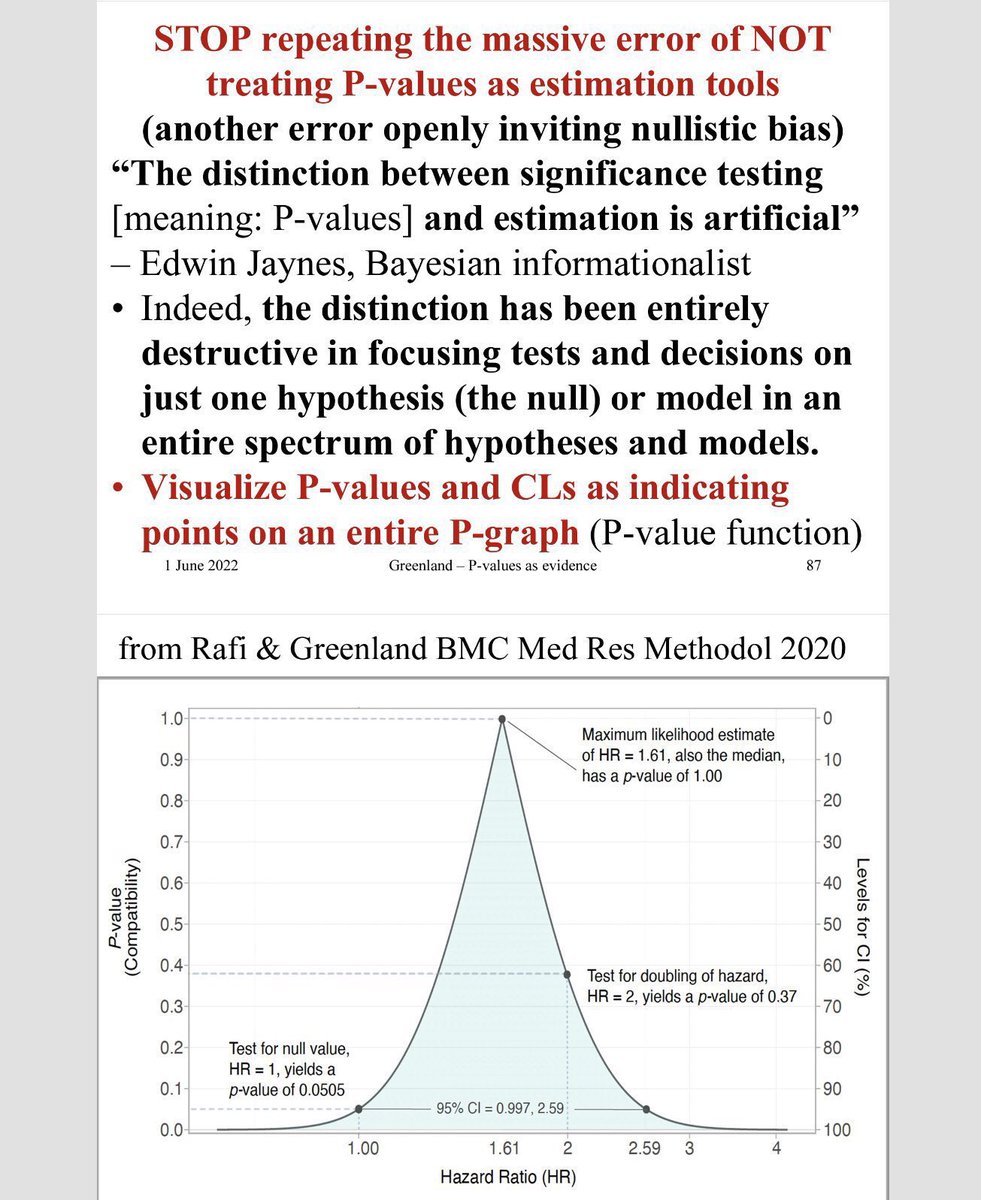
問題: 統計モデルとデータの数値を具体的に与えてP値関数のグラフをプロットして、その解釈の仕方について簡単に説明せよ。
ヒント
↓
biostatistics.ucdavis.edu/sites/g/files/…
florets@florets1
伝統的統計学がしっくりこないのですよね。「私の」直感と合わない。サンプルサイズが多過ぎるとダメで、適度に少なくしなければいけないこととか。データが多くて困るって何事?
80
#統計 添付画像はMcElreathさんのStatistical Rethinkingより。
問題: どうして「ベイズvs.頻度論」のゴジラとキングコングが因果推論犬を見て逃げ出したのか?
続く(佐藤俊哉さんもしまりす本の紹介)
github.com/rmcelreath/sta…
[1] Slides pp.8-9
speakerdeck.com/rmcelreath/sta…

問題: どうして「ベイズvs.頻度論」のゴジラとキングコングが因果推論犬を見て逃げ出したのか?
続く(佐藤俊哉さんもしまりす本の紹介)
github.com/rmcelreath/sta…
[1] Slides pp.8-9
speakerdeck.com/rmcelreath/sta…
florets@florets1
伝統的統計学がしっくりこないのですよね。「私の」直感と合わない。サンプルサイズが多過ぎるとダメで、適度に少なくしなければいけないこととか。データが多くて困るって何事?
81
#統計 次の本はお勧め。
asakura.co.jp/detail.php?boo…
宇宙怪人しまりす
統計よりも重要なことを学ぶ
佐藤俊哉
2024
この本のタイトルは1つ上の投稿にある問題の大ヒントにもなっています。
頻度論やらベイズやらの違いを気にするのはダメな考え方。気にするべき点が大きくずれている。

asakura.co.jp/detail.php?boo…
宇宙怪人しまりす
統計よりも重要なことを学ぶ
佐藤俊哉
2024
この本のタイトルは1つ上の投稿にある問題の大ヒントにもなっています。
頻度論やらベイズやらの違いを気にするのはダメな考え方。気にするべき点が大きくずれている。
黒木玄 Gen Kuroki@genkuroki
#統計 お勧め本。注文した。
宇宙怪人しまりす 統計よりも重要なことを学ぶ asakura.co.jp/detail.php?boo… @AsakuraPubより
添付画像は試し読みより。
95%信頼区間単体よりも情報量が多いP値関数のグラフを描くことを勧めている!
asakura.tameshiyo.me/9784254122978?…
宇宙怪人しまりす 統計よりも重要なことを学ぶ asakura.co.jp/detail.php?boo… @AsakuraPubより
添付画像は試し読みより。
95%信頼区間単体よりも情報量が多いP値関数のグラフを描くことを勧めている!
asakura.tameshiyo.me/9784254122978?…
82
#統計 文脈明瞭化のためのスクショ

83
#統計 あわわ!
豊田秀樹さん的な言説に騙されたせいで「サンプルサイズを最初に決めなければいけない。途中で変えちゃダメ」を否定するようになったのでしょうか?
P値の場合と同様にベイズ統計でも、自分に都合の良い結果が出るまでサンプルサイズを増やしちゃダメです。不正行為になります。続く
豊田秀樹さん的な言説に騙されたせいで「サンプルサイズを最初に決めなければいけない。途中で変えちゃダメ」を否定するようになったのでしょうか?
P値の場合と同様にベイズ統計でも、自分に都合の良い結果が出るまでサンプルサイズを増やしちゃダメです。不正行為になります。続く
florets@florets1
@MyNew_Gear ありがとうございます。そうなんですよね。仮説検定を捨てたらよいと思う人も多いと思うのですけど、「仮説を立ててからデータを集めて分析すべし」「サンプルサイズを最初に決めなければならない。途中で変えちゃダメ」のような習慣が残り続けています。これも直感と合わない。
84
#統計 例えば、効果を意味するパラメータの事後分布が十分右側に偏って欲しいときに、実際にそうなるように少しずつサンプルサイズを増やすことはP-hackingと近似的に同等の不正行為になります。
事後分布での片側確率は片側P値で近似されます。
不正行為はやめて欲しいです。続く
事後分布での片側確率は片側P値で近似されます。
不正行為はやめて欲しいです。続く
85
#統計 ベイズファクターが事前に決めた閾値を超えるまで少しずつサンプルサイズを増やした場合には、ベイズファクターの漸近挙動によって、適切に閾値を設定しておけばαエラー率を低く抑えられます。だからそういう行為は十分に合理的。
しかし、これをベイズ特有の利点だとみなすのは誤りです。続く
しかし、これをベイズ特有の利点だとみなすのは誤りです。続く
86
#統計 なぜならば、ベイズファクターがある閾値を超えるか否かは、各サンプルサイズnごとに適切に設定された有意水準αₙについてP値がαₙ未満になることと近似的に同値になるからです。
αₙは単調減少数列になります。
続く
αₙは単調減少数列になります。
続く
87
#統計 つまり、ベイズファクターがある閾値を超えたかどうかによる2値的判断は、サンプルサイズが大きいほどより厳しい小さな有意水準を設定したときの仮説検定と近似的に同値になります。
ベイズファクターによる検定と近似的に同じことをP値を使った検定でも行えるわけです。
ベイズファクターによる検定と近似的に同じことをP値を使った検定でも行えるわけです。
88
#統計 事前にサンプルサイズnごとに有意水準αₙを適切に単調減少するように定めておけば、サンプルサイズを後で増やしても、仮説検定でαエラー率を低く抑えることができます。
本質的に多重検定のための調整の一種だと思えば新しい話でも何でもないと思います。
本質的に多重検定のための調整の一種だと思えば新しい話でも何でもないと思います。
89
#統計 P値を使う方法もベイズ統計も尤度関数は共通しており、どちらの場合もサンプルサイズn→大での挙動は尤度関数で決まります。だから、数学的には必然的にP値を使う方法とベイズ統計の間に近似的な関係が生じます。続く
90
#統計 そういう事情があるので「P値ならダメでベイズなら良い」という主張の大部分は容易に否定されることになります。
ただし、尤度関数の形状が複雑になる場合には、最尤法の漸近論を使ったP値の理論が破綻するので、ベイズ統計が有利になります。一般に最尤法が使えない場合にはベイズが優る。
ただし、尤度関数の形状が複雑になる場合には、最尤法の漸近論を使ったP値の理論が破綻するので、ベイズ統計が有利になります。一般に最尤法が使えない場合にはベイズが優る。
91
#統計 あと、統計モデリングを自分で行ったときに、適切にP値関数の構成するのはかなり面倒。
ベイズでMCMCを使って事後分布をプロットすることであれば、ツールの使い方を覚えるだけで簡単にできます。このメリットは非常に大きいと思います。(だからStatistical Rethinkingはベイズを使っている。)
ベイズでMCMCを使って事後分布をプロットすることであれば、ツールの使い方を覚えるだけで簡単にできます。このメリットは非常に大きいと思います。(だからStatistical Rethinkingはベイズを使っている。)
92
#統計 豊田秀樹さんの尤度原理によるベイズ推しはほとんど研究不正を大っぴらに勧めているようにも見えて非常に危険だと思います。

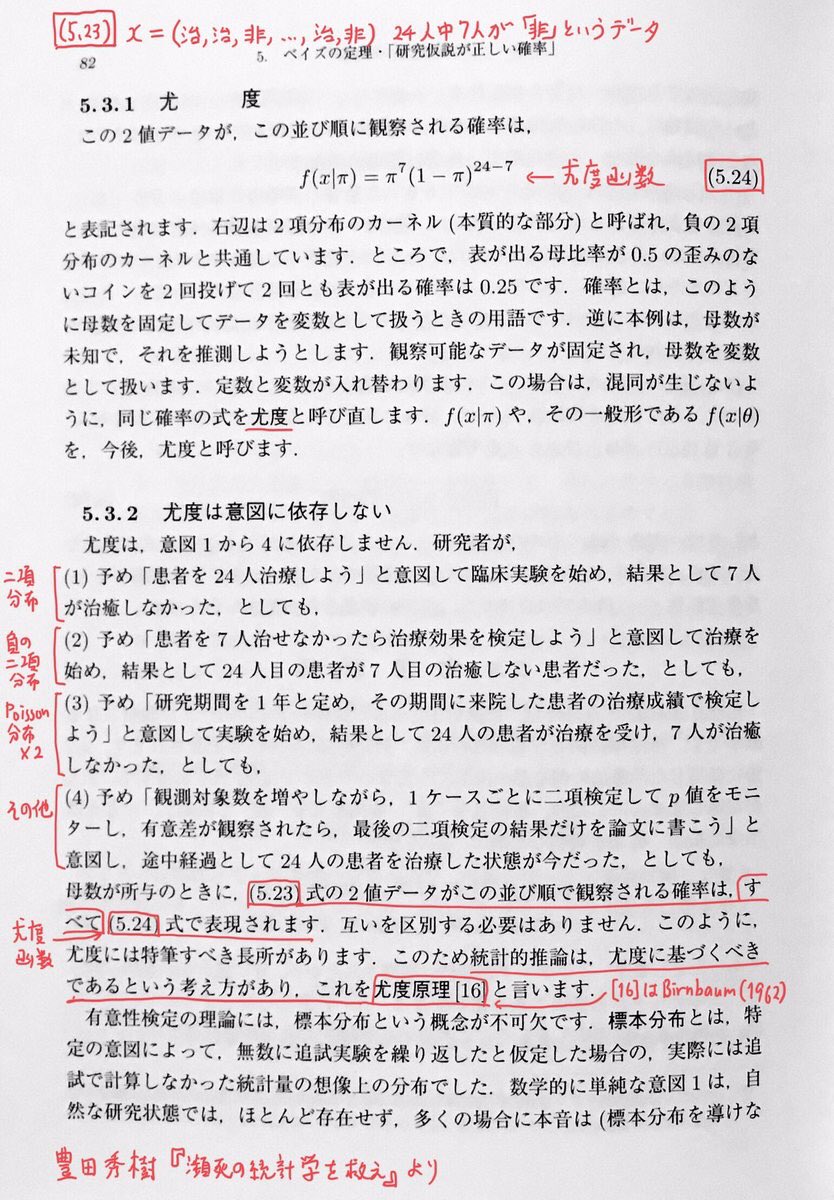
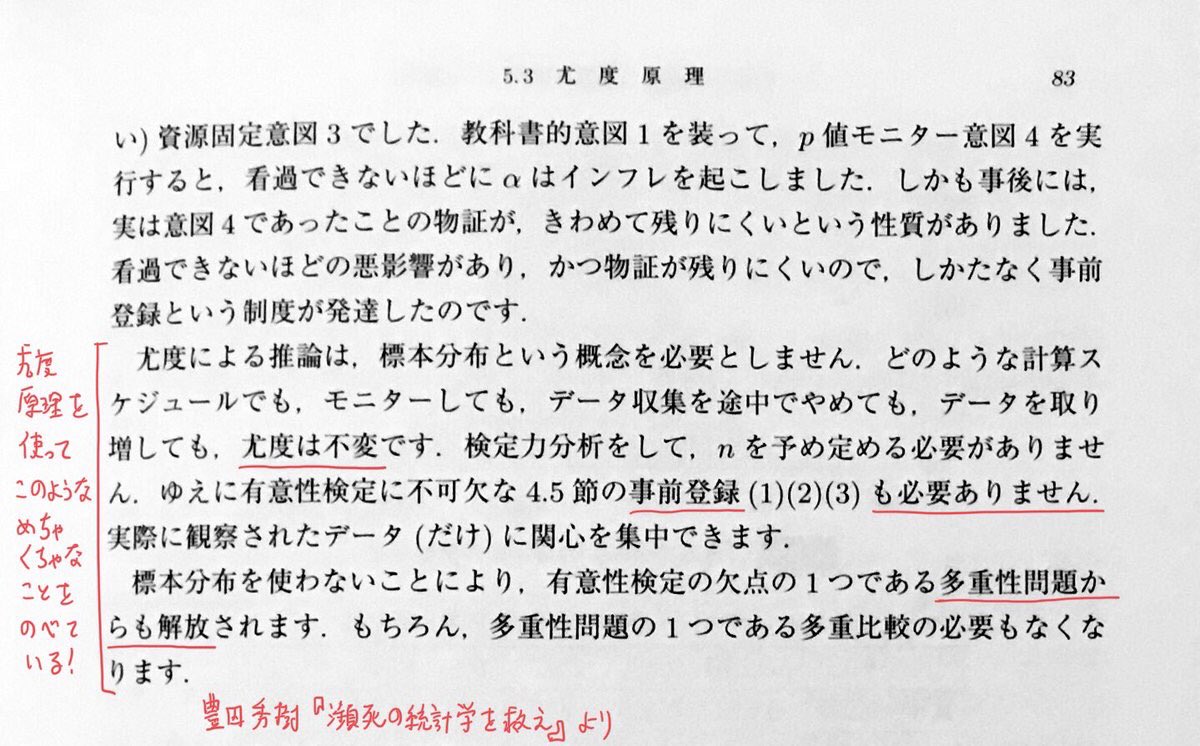
黒木玄 Gen Kuroki@genkuroki
#統計 こんな感じで、不適切利用が可能なP値を使った不正行為は、ほとんどそのままでベイズ統計にも拡張されます。
こういう事実を理解した後に添付画像の引用部分に注目すれば、豊田『瀕死本』がベイズ統計を使った研究不正を推奨しているようにも見えて来るはずです。
こういう事実を理解した後に添付画像の引用部分に注目すれば、豊田『瀕死本』がベイズ統計を使った研究不正を推奨しているようにも見えて来るはずです。
93
#統計 尤度関数だけを使って得られるスコア法によるP値は尤度原理を満たしています。しかし、自分にとって都合の良い結果が得られるまでデータを追加することは研究不正行為になります。
ベイズ更新でも自分にとって都合の良い結果が得られるまでデータを追加することは研究不正行為になります。
ベイズ更新でも自分にとって都合の良い結果が得られるまでデータを追加することは研究不正行為になります。
florets@florets1
頻度論もベイズ統計も同じというのならですね。ベイズ更新みたいなのを頻度論でもやらせてほしいなあ。
94
#統計

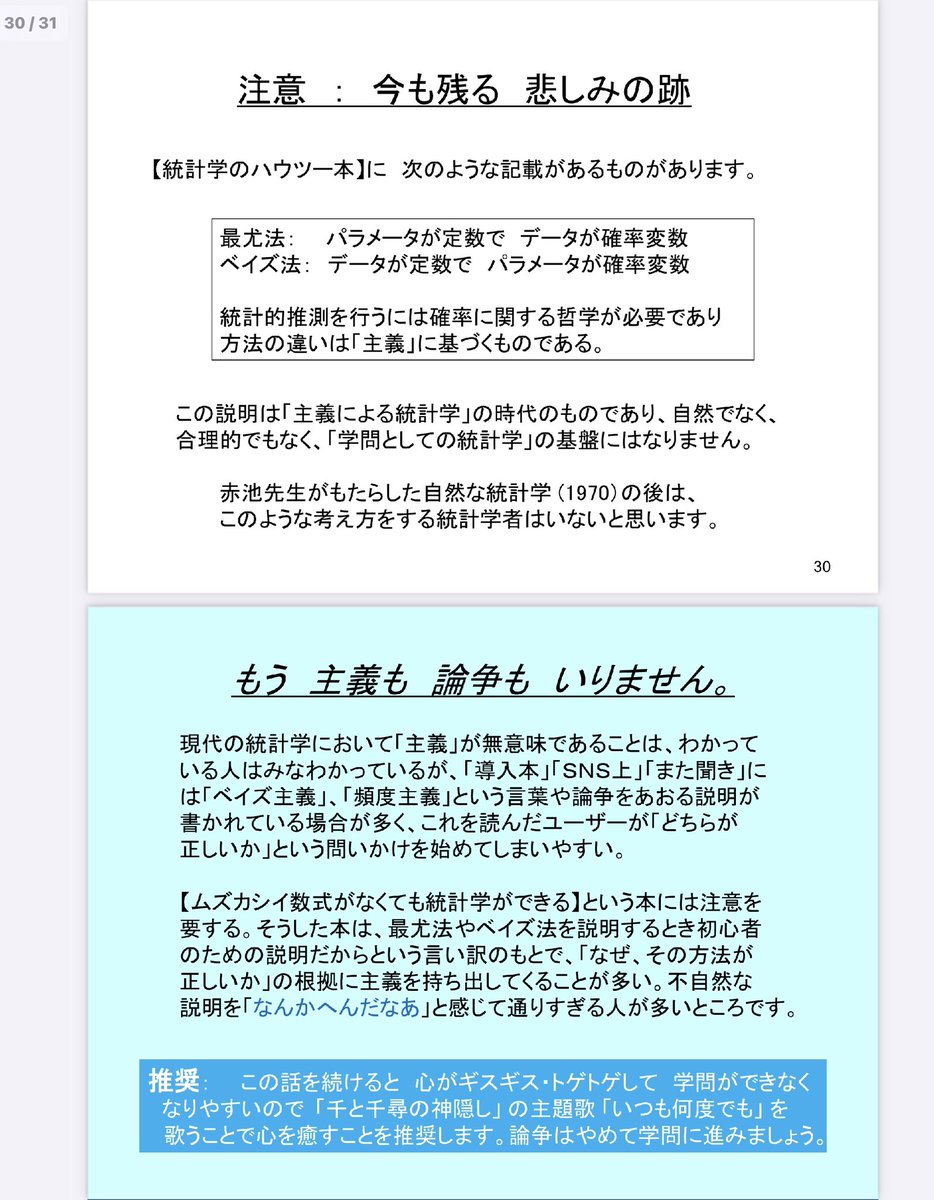
黒木玄 Gen Kuroki@genkuroki
#統計 今はない東工大の渡辺澄夫さんのウェブサイトのファイルへのリンク切れは、URLの中のhttps:// と watanabe-www.~の間に
warp.ndl.go.jp/info:ndljp/pid…
を挿入すれば補完されます。
補完結果の例
warp.ndl.go.jp/info:ndljp/pid…
↓
warp.ndl.go.jp/info:ndljp/pid…
warp.ndl.go.jp/info:ndljp/pid…
を挿入すれば補完されます。
補完結果の例
warp.ndl.go.jp/info:ndljp/pid…
↓
warp.ndl.go.jp/info:ndljp/pid…
95
#統計
黒木玄 Gen Kuroki@genkuroki
#統計 多重比較の話題で「頻度論vs.ベイズ主義」を持ち出す人達は酷く間違っている。
↓
Multiple comparisons controversies are about context and costs, not frequentism versus Bayesianism
Sander Greenland & Albert Hofman
14 September 2019
doi.org/10.1007/s10654…
一部の機械翻訳
↓
↓
Multiple comparisons controversies are about context and costs, not frequentism versus Bayesianism
Sander Greenland & Albert Hofman
14 September 2019
doi.org/10.1007/s10654…
一部の機械翻訳
↓
96
#統計 理解度が低い人達との合意は単に有害。
ベイズ更新でも適当な設定の下で次を数学的に証明できます:
自分にとって都合が悪いことが真実であっても、自分にとって都合が良い結果が得られるまでデータを取得し続けることによって、自分にとって都合の良い結果が高確率で得られる。

ベイズ更新でも適当な設定の下で次を数学的に証明できます:
自分にとって都合が悪いことが真実であっても、自分にとって都合が良い結果が得られるまでデータを取得し続けることによって、自分にとって都合の良い結果が高確率で得られる。
florets@florets1
@genkuroki なるほど。でもその考え方「都合の良い結果が得られるまでデータを追加することはベイズでも不正行為」はどこまで合意されているのでしょう。少なくとも現在の私の直感とは相容れません。私は、自分が納得するまで十分景色を眺めたいのです。それは不正なのでしょうか。
97
#統計 続き
例えば、効果がないことを意味するパラメータの値がベイズ版95%信用区間に含まれなくなるまでデータの取得を続けてベイズ更新すると、真実は効果ゼロであってもそうなる状況を原理的には確率1で実現できます。
ベイズ版信用区間と信頼区間は漸近的に一致するので、信頼区間と同様になる。

例えば、効果がないことを意味するパラメータの値がベイズ版95%信用区間に含まれなくなるまでデータの取得を続けてベイズ更新すると、真実は効果ゼロであってもそうなる状況を原理的には確率1で実現できます。
ベイズ版信用区間と信頼区間は漸近的に一致するので、信頼区間と同様になる。
florets@florets1
@genkuroki なるほど。でもその考え方「都合の良い結果が得られるまでデータを追加することはベイズでも不正行為」はどこまで合意されているのでしょう。少なくとも現在の私の直感とは相容れません。私は、自分が納得するまで十分景色を眺めたいのです。それは不正なのでしょうか。
98
#統計 P値関数もベイズ更新の事後分布も、どちらも尤度関数のみから得られます(そうでないP値もあるが尤度関数だけで決まるP値は多用されている、ベイズでは実際には事前分布も必要)。
そのことから、データの新たな取得ごとでのP値関数の更新と事後分布のベイズ更新は共通の漸近挙動を持ちます。続く
そのことから、データの新たな取得ごとでのP値関数の更新と事後分布のベイズ更新は共通の漸近挙動を持ちます。続く
99
#統計 P値関数の更新と事後分布のベイズ更新は共通の漸近挙動を持つので、その片方でやっていけないことは他方でもやってはいけないことになり、その片方でやって良いことは他方でもやって良いことになります。
これは数学的な結果なので、数学的直観がない人がどんなに騒いでもひっくり返せない。
これは数学的な結果なので、数学的直観がない人がどんなに騒いでもひっくり返せない。
florets@florets1
@genkuroki なるほど。でもその考え方「都合の良い結果が得られるまでデータを追加することはベイズでも不正行為」はどこまで合意されているのでしょう。少なくとも現在の私の直感とは相容れません。私は、自分が納得するまで十分景色を眺めたいのです。それは不正なのでしょうか。
100
#統計 だから、P値関数の側の不正行為にちょうど対応するベイズ統計の側での行為は自動的に不正行為になります。
これは論理的に導かれることなので、数学的理解力がない人達は黙って従うしかない。
ベイズにしただけで不正行為が正当な行為になると考えることは科学的な常識的にも馬鹿げています。
これは論理的に導かれることなので、数学的理解力がない人達は黙って従うしかない。
ベイズにしただけで不正行為が正当な行為になると考えることは科学的な常識的にも馬鹿げています。
101
#統計 P値を使う方法とベイズ統計の方法の違いについて単なる技術的な違いだと説明せずに主義の違いで説明する悪習が生き残っているせいで、
P値を使う行為とベイズ統計での行為をどのように適切に対応させると良いか
という実践的に必要な知識が全然普及しなくなってしまっています。大問題。
P値を使う行為とベイズ統計での行為をどのように適切に対応させると良いか
という実践的に必要な知識が全然普及しなくなってしまっています。大問題。
102
#統計 「パラメータθの事後分布におけるθ≤cとなる確率」は、P値の側では「検定仮説θ≤cの片側P値」が対応します。それらの定義は全然違いますが、多くの場合にそれらは近似的に一致します。
多くの場合に数学的に必然的に近似的に一致するのに、解釈の違いだけを強調する行為が横行している。
多くの場合に数学的に必然的に近似的に一致するのに、解釈の違いだけを強調する行為が横行している。
103
#統計 「検定仮説θ=cの両側P値」のベイズ統計での適切な対応物は「事後分布でθ=cとなる確率」では__ありません__。数学に弱い多くの人達がこの点について誤解している可能性が高い。
両側P値の片側確率の2倍版での対応物は「事後分布でθ≤cとなる確率とθ≥cとなる確率の小さい方の2倍」です。
両側P値の片側確率の2倍版での対応物は「事後分布でθ≤cとなる確率とθ≥cとなる確率の小さい方の2倍」です。
104
#統計 通常の95%信頼区間にはベイズ統計における95%信用区間がちょうど対応しています。
それらは多くの場合に近似的に一致します。ただし、事前分布を大きく偏ったものにしている場合にはその分だけ標本サイズを大きくしないとずれは小さくなりません。
それらは多くの場合に近似的に一致します。ただし、事前分布を大きく偏ったものにしている場合にはその分だけ標本サイズを大きくしないとずれは小さくなりません。
105
#統計 添付画像では、ネストしているモデルの場合に、ベイズファクターとP値関数を縦に並べてプロットしています。
このグラフからベイズファクターとP値の間には近似的な変換公式がありそうだと分かるのですが、それは実際に正しいです。


このグラフからベイズファクターとP値の間には近似的な変換公式がありそうだと分かるのですが、それは実際に正しいです。
黒木玄 Gen Kuroki@genkuroki
#統計 添付のグラフは、二項分布モデルの場合に、帰無仮説「当たりが出る確率はpである」のpを動かして横軸に取って作ったベイズファクターとP値のグラフです。
グラフを比較すれば分かるようにこの場合にはベイズファクターを使うことはP値を使うことと本質的に同じです。
nbviewer.org/github/genkuro…
グラフを比較すれば分かるようにこの場合にはベイズファクターを使うことはP値を使うことと本質的に同じです。
nbviewer.org/github/genkuro…
106
#統計 以上で紹介したP値とベイズ統計の対応は一応数学的に非自明な話なので、全然理解できない人達がたくさん出て来ることは仕方がないです。
しかし、P値とベイズ統計の対応のような基本的なことを理解していない人が頻度論とベイズの比較の解説をすることは、やめさせるべきだと思います。
しかし、P値とベイズ統計の対応のような基本的なことを理解していない人が頻度論とベイズの比較の解説をすることは、やめさせるべきだと思います。
107
#統計 人間は一度騙されてしまうと、プライドが邪魔をして騙されていることを認めることをできなくなってしまうことがあります。
P値とベイズの対応さえ知らない無知な人達が堂々とミスリーディングな「頻度vs.ベイズ」の解説を書いているせいで、そういう被害者達が大量発生しています。
P値とベイズの対応さえ知らない無知な人達が堂々とミスリーディングな「頻度vs.ベイズ」の解説を書いているせいで、そういう被害者達が大量発生しています。
108
#統計 母比率に関する非ベイズの2つの信頼区間(Wilsonのスコア信頼区間、Clopper-Pearsonの信頼区間)と平坦事前分布の場合のベイズ信用区間(HDI版)を同時プロット。
Wilsonのスコア信頼区間とベイズ信用区間の違いよりも、信頼区間どうしの違いの方が大きい!
github.com/genkuroki/publ… #Julia言語
Wilsonのスコア信頼区間とベイズ信用区間の違いよりも、信頼区間どうしの違いの方が大きい!
github.com/genkuroki/publ… #Julia言語
109
#統計 Wilsonのスコア信頼区間とベイズ信用区間の違いは小さいです。
それと比較すると、Wilsonのスコア信頼区間とClopper-Pearsonの信頼区間の違いはずっと大きい。同じ頻度論側どうしの違いの方が大きい。
標本サイズnを大きくすると全部ほぼ同じになります。
github.com/genkuroki/publ…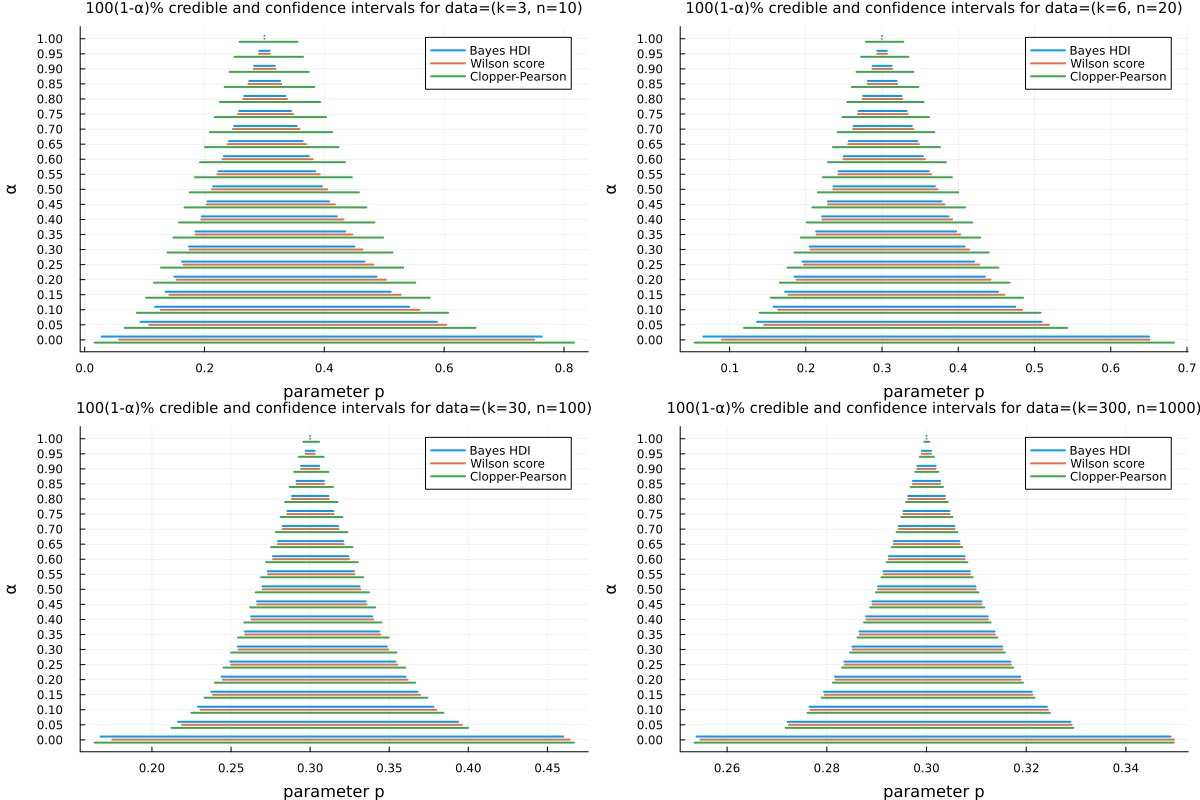
それと比較すると、Wilsonのスコア信頼区間とClopper-Pearsonの信頼区間の違いはずっと大きい。同じ頻度論側どうしの違いの方が大きい。
標本サイズnを大きくすると全部ほぼ同じになります。
github.com/genkuroki/publ…
110
#統計
母比率に関するWilsonのスコア信頼区間は性能的に優れた標準的に使うべき信頼区間です(Agresti-Coull (1998) scholar.google.co.jp/scholar?cluste…)。
平坦事前分布のHDI版のベイズ信用区間も「標準的」と言って良いと思います。
それらの違いは、頻度論の信頼区間どうしの違いよりも小さいわけです。
母比率に関するWilsonのスコア信頼区間は性能的に優れた標準的に使うべき信頼区間です(Agresti-Coull (1998) scholar.google.co.jp/scholar?cluste…)。
平坦事前分布のHDI版のベイズ信用区間も「標準的」と言って良いと思います。
それらの違いは、頻度論の信頼区間どうしの違いよりも小さいわけです。
111
#統計 通常の信頼区間とベイズ版の信用区間の数学的定義は確かに全く異なります。
しかし、二項分布モデルの事前分布としてよく使われている平坦事前分布の下では(Jeffreys事前分布でもそう変わらない)、標準的な信頼区間とベイズ信用区間が近似的によく一致したりします。
しかし、二項分布モデルの事前分布としてよく使われている平坦事前分布の下では(Jeffreys事前分布でもそう変わらない)、標準的な信頼区間とベイズ信用区間が近似的によく一致したりします。
112
#統計 以上のような予備知識があれば、片側の使用に慣れている人が(例えば信頼区間の使用に慣れている人が)、もう一方の道具(例えばベイズ信用区間)を使うことに躊躇する必要がなくなります。
これは教育的に大きなメリットです。
主義に基く統計学観の宣伝はその逆に相当に有害だと思います。
これは教育的に大きなメリットです。
主義に基く統計学観の宣伝はその逆に相当に有害だと思います。
113
関連スレッドに相互リンク
114
#統計 P値関数の概念の解説
黒木玄 Gen Kuroki@genkuroki
#統計 P値関数の概念に至るまで
①固定された有意水準α(例えばα=5%)で、帰無仮説θ=0が棄却されるか否かの2値的情報だけを報告。
②帰無仮説θ=0のP値を報告。そのP値は帰無仮説θ=0が棄却される有意水準の下限なので、固定されていないすべての有意水準で棄却されるか否かを報告するのと同じ。
①固定された有意水準α(例えばα=5%)で、帰無仮説θ=0が棄却されるか否かの2値的情報だけを報告。
②帰無仮説θ=0のP値を報告。そのP値は帰無仮説θ=0が棄却される有意水準の下限なので、固定されていないすべての有意水準で棄却されるか否かを報告するのと同じ。