#統計 まるっきり間違っています。...

黒木玄 Gen Kuroki@genkuroki
73 views
Sep 20, 2024
~3 min read
Advertisement
1
#統計 まるっきり間違っています。
最尤法は点推定法ではあるのですが、統計学のイロハのイとして「点推定値だけを報告してはいけない」という原則があるので、最尤法に付随するP値関数によって、
データの数値と
モデルと
パラメータの値の設定
の相性の良さの様子
の記述を行います。続く


最尤法は点推定法ではあるのですが、統計学のイロハのイとして「点推定値だけを報告してはいけない」という原則があるので、最尤法に付随するP値関数によって、
データの数値と
モデルと
パラメータの値の設定
の相性の良さの様子
の記述を行います。続く
タランチュラ | データサイエンティスト@tarantula_ds_
【最尤推定 vs ベイズ推論】
2つの違いを直感的に理解できる図が、「Pythonでスラスラわかるベイズ推論超入門」にあったから抜粋させてもらったよ🙆♂️
それぞれの長所・短所もスライドに書いてるから覗いてみてね👀
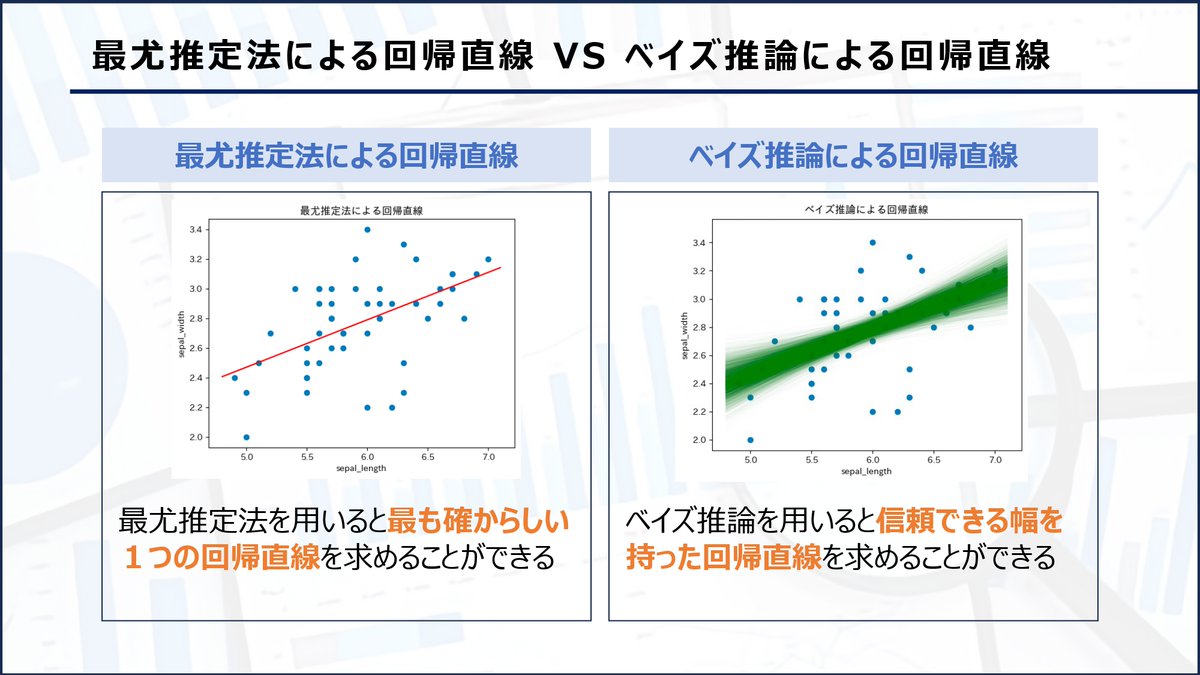
2つの違いを直感的に理解できる図が、「Pythonでスラスラわかるベイズ推論超入門」にあったから抜粋させてもらったよ🙆♂️
それぞれの長所・短所もスライドに書いてるから覗いてみてね👀
2
#統計 続き。ベイズ統計でのP値関数の対応物は事後分布です。事後分布を見れば、
データの数値と
モデル(モデルは事前分布を含む)と
パラメータの値の設定
の相性の良さの様子
が分かります。
事前分布の有無は違いますが、目的は同じです。続く
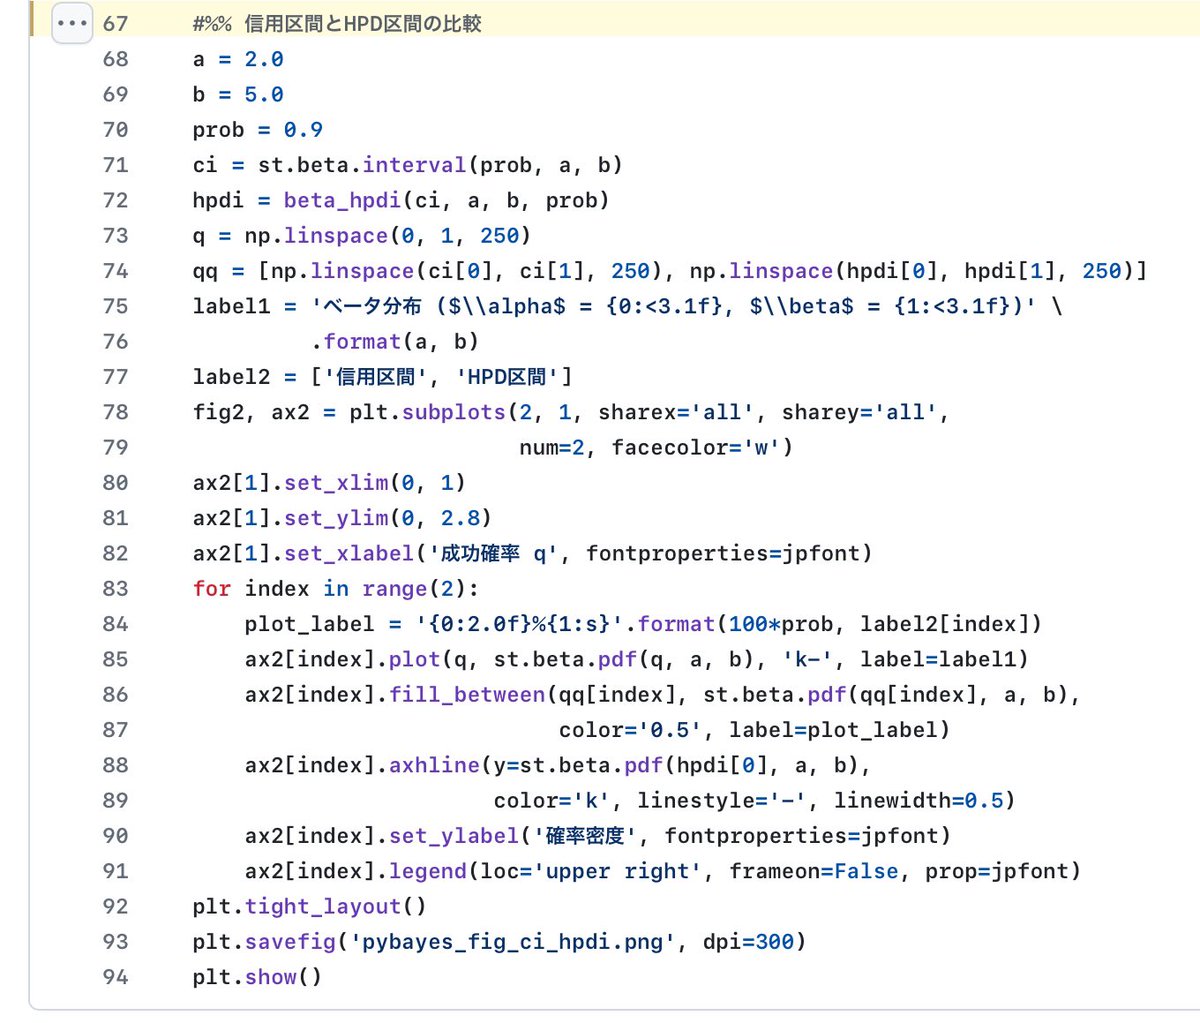
データの数値と
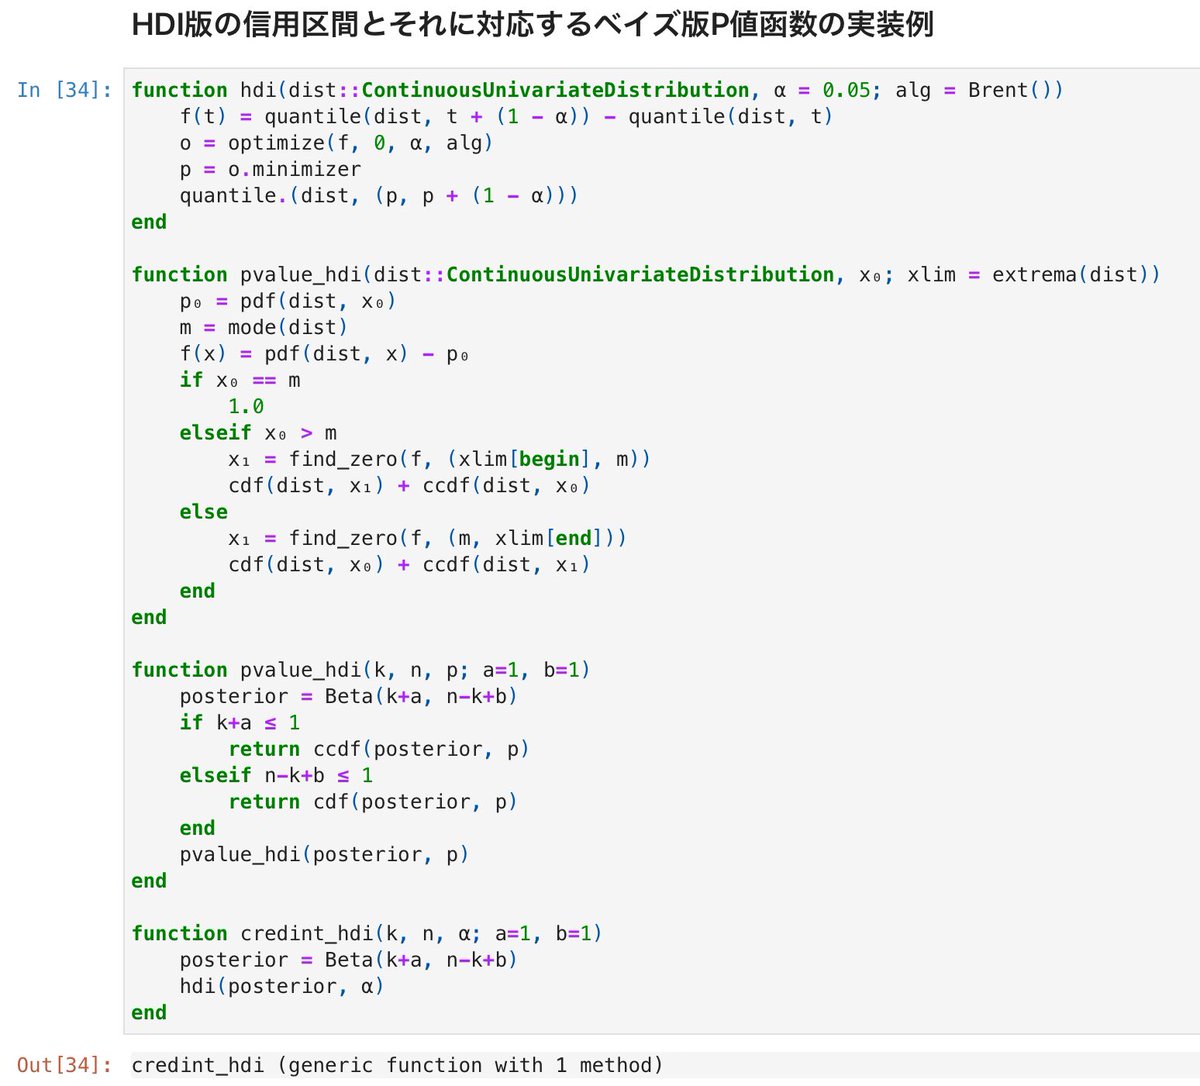
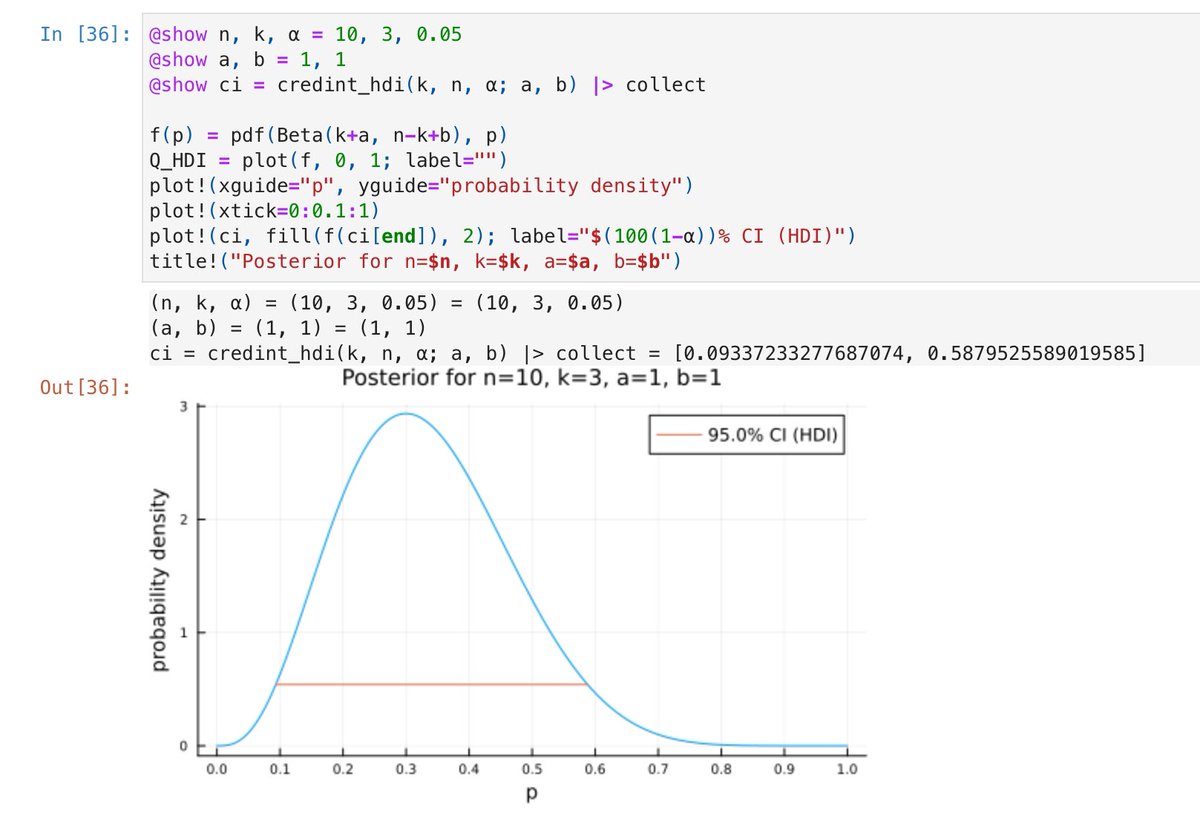
モデル(モデルは事前分布を含む)と
パラメータの値の設定
の相性の良さの様子
が分かります。
事前分布の有無は違いますが、目的は同じです。続く
3
#統計 最尤法でのP値関数とベイズ統計での事後分布が「同じようなもの」であることは、簡単なモデルでそれらを同時プロットすれば明らかになります。
二項分布モデルでの最尤法に付随するスコア法によるP値関数と平坦事前分布に対応する事後分布を比較するためのグラフ
↓
nbviewer.org/github/genkuro…
二項分布モデルでの最尤法に付随するスコア法によるP値関数と平坦事前分布に対応する事後分布を比較するためのグラフ
↓
nbviewer.org/github/genkuro…
4
#統計
A/Bテストに関する
左: ベイズ統計での平坦事前分布に対応する事後分布のグラフ
右: 最尤法に付随するスコア法によるP値関数のグラフ
も比較してみてください。この場合にも事後分布とP値関数はほぼ同じ使い方をできることが分かると思います。
↓

A/Bテストに関する
左: ベイズ統計での平坦事前分布に対応する事後分布のグラフ
右: 最尤法に付随するスコア法によるP値関数のグラフ
も比較してみてください。この場合にも事後分布とP値関数はほぼ同じ使い方をできることが分かると思います。
↓
黒木玄 Gen Kuroki@genkuroki
#統計 以下のリンク先とおそらく同様のグラフを描いてみた。それは、添付画像の左側で、A側の比率pとB側の比率qとそれらの差p-qの事後分布のグラフ。
右側はP値関数達のグラフ。
この場合には事後分布とP値関数はほぼ同じ情報を持っている。続く
#Julia言語 ソースコード→github.com/genkuroki/publ…
右側はP値関数達のグラフ。
この場合には事後分布とP値関数はほぼ同じ情報を持っている。続く
#Julia言語 ソースコード→github.com/genkuroki/publ…
5
#統計
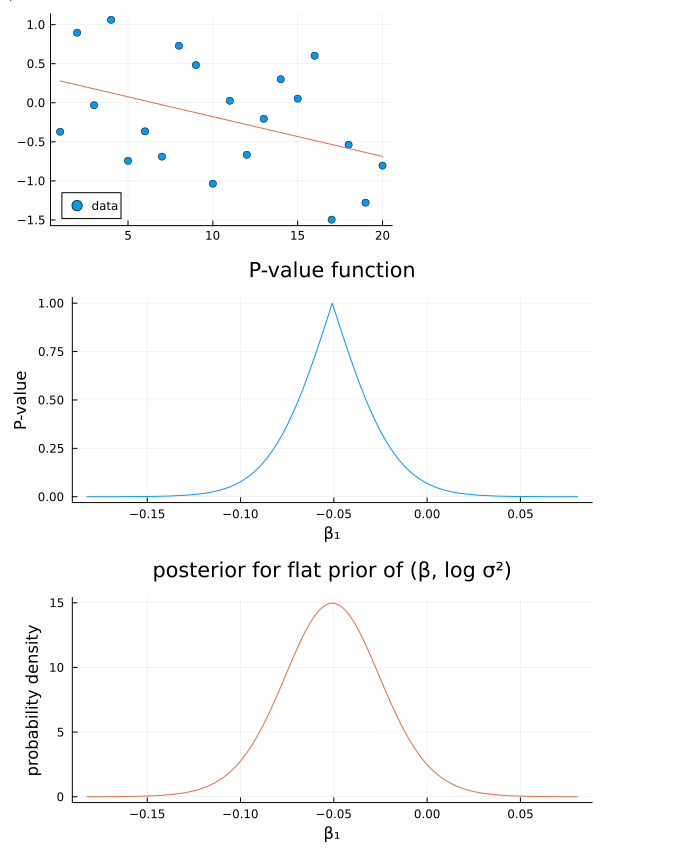
通常の線形回帰も最尤推定の一種です。やはり、P値(関数)を考えて、モデルの回帰係数パラメータの設定とデータの数値の相性の良さを見ることができます。
回帰係数とlog σ²についての平坦事前分布についてのベイズ版線形回帰は数学的には通常の線形回帰にある意味でぴったり一致します。
通常の線形回帰も最尤推定の一種です。やはり、P値(関数)を考えて、モデルの回帰係数パラメータの設定とデータの数値の相性の良さを見ることができます。
回帰係数とlog σ²についての平坦事前分布についてのベイズ版線形回帰は数学的には通常の線形回帰にある意味でぴったり一致します。
黒木玄 Gen Kuroki@genkuroki
#統計 #Julia言語
線形回帰のβ₁に関するP値関数
と
βとlog σ²について平坦な事前分布での
ベイズ版線形回帰のβ₁に関する事後分布
は数学的に「同等」なので、
線形回帰に関するP値を使う方法とベイズ法の違い
は
事前分布の平坦分布との違い
にちょうど対応。
github.com/genkuroki/publ…
線形回帰のβ₁に関するP値関数
と
βとlog σ²について平坦な事前分布での
ベイズ版線形回帰のβ₁に関する事後分布
は数学的に「同等」なので、
線形回帰に関するP値を使う方法とベイズ法の違い
は
事前分布の平坦分布との違い
にちょうど対応。
github.com/genkuroki/publ…
6
#統計 最尤法に付随するP値(関数)を構成するための定番の方法(対数最大尤度比法、スコア法、Wald法)のような基本的な事柄を未修の人がベイズ法と最尤法の比較の解説を書くと、ベイズでの事後分布と最尤法でのP値関数を比較するべきあることを分からないままで、まるっきりダメな解説を書きがちです。
タランチュラ | データサイエンティスト@tarantula_ds_
【最尤推定 vs ベイズ推論】
2つの違いを直感的に理解できる図が、「Pythonでスラスラわかるベイズ推論超入門」にあったから抜粋させてもらったよ🙆♂️
それぞれの長所・短所もスライドに書いてるから覗いてみてね👀
2つの違いを直感的に理解できる図が、「Pythonでスラスラわかるベイズ推論超入門」にあったから抜粋させてもらったよ🙆♂️
それぞれの長所・短所もスライドに書いてるから覗いてみてね👀
7
#統計 この辺は、集団でまるっきりダメな解説を書いて拡散している状態がずっと続いているので、そういう流れに参加する人が新たに出て来ても目立たないという問題があります。
自分の勉強不足(最尤法に付随するP値(関数)の構成法さえ知らない)を自ら暴露する人が増え過ぎ。
自分の勉強不足(最尤法に付随するP値(関数)の構成法さえ知らない)を自ら暴露する人が増え過ぎ。
8
#統計 「ベイズの側で事後分布ではなく、ベイズファクターを使った場合にはどうなるのか?」と思った人は以下のリンク先以降を見て下さい。
疑問が生じたら、比較したい2つのものを同時に視覚化して並べて比較することが基本になります。
めんどくさい理屈こねるのはその後でよい。具体例需要。

疑問が生じたら、比較したい2つのものを同時に視覚化して並べて比較することが基本になります。
めんどくさい理屈こねるのはその後でよい。具体例需要。
黒木玄 Gen Kuroki@genkuroki
#統計 添付のグラフは、二項分布モデルの場合に、帰無仮説「当たりが出る確率はpである」のpを動かして横軸に取って作ったベイズファクターとP値のグラフです。
グラフを比較すれば分かるようにこの場合にはベイズファクターを使うことはP値を使うことと本質的に同じです。
nbviewer.org/github/genkuro…
グラフを比較すれば分かるようにこの場合にはベイズファクターを使うことはP値を使うことと本質的に同じです。
nbviewer.org/github/genkuro…
9
#統計 シンプルなモデルでの最尤法とベイズ法の違いは、本質的に
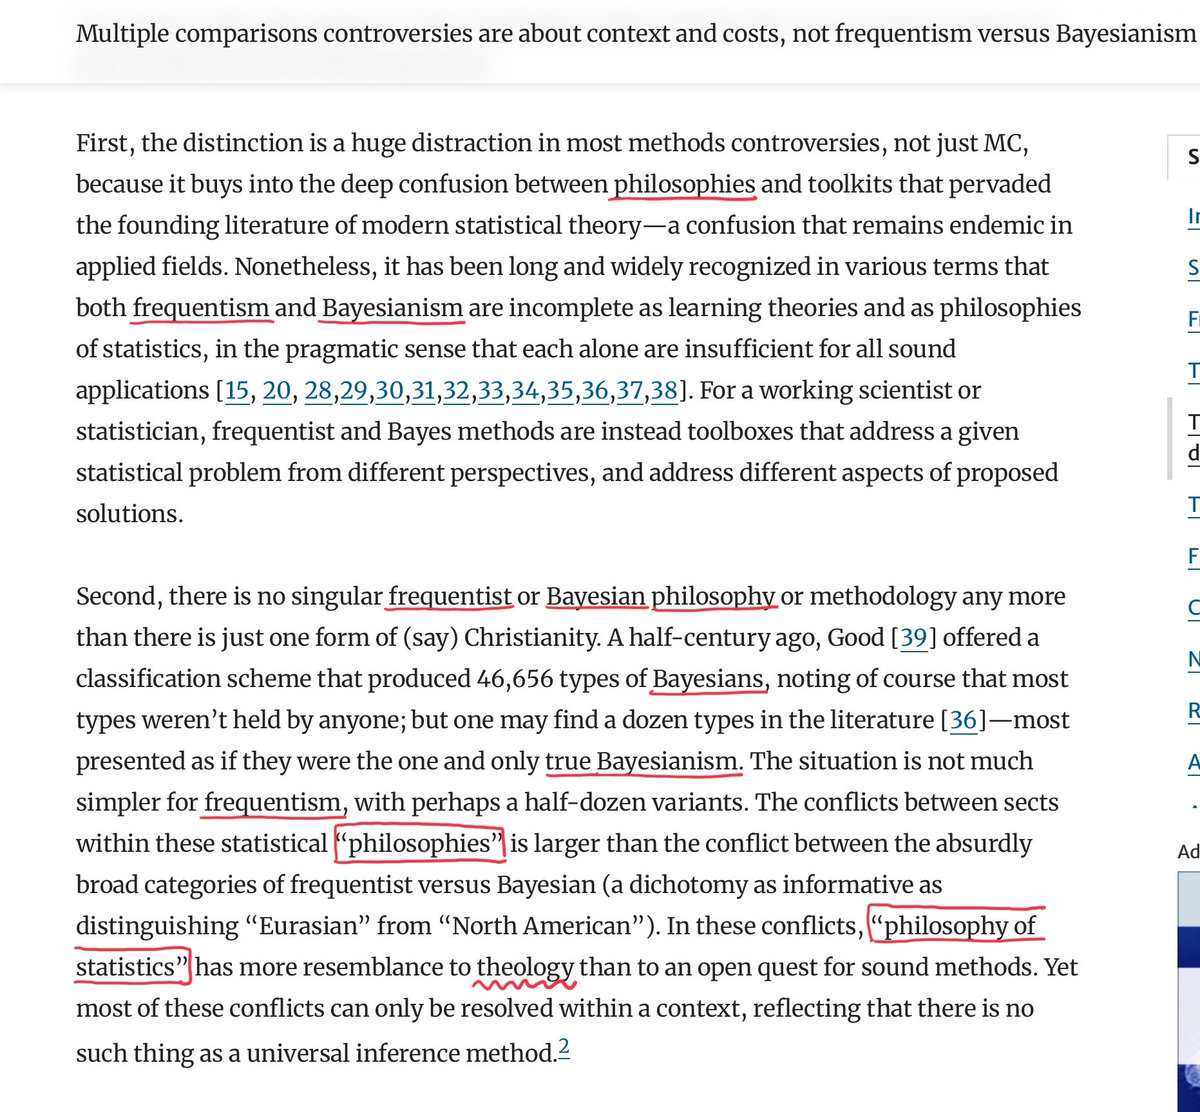
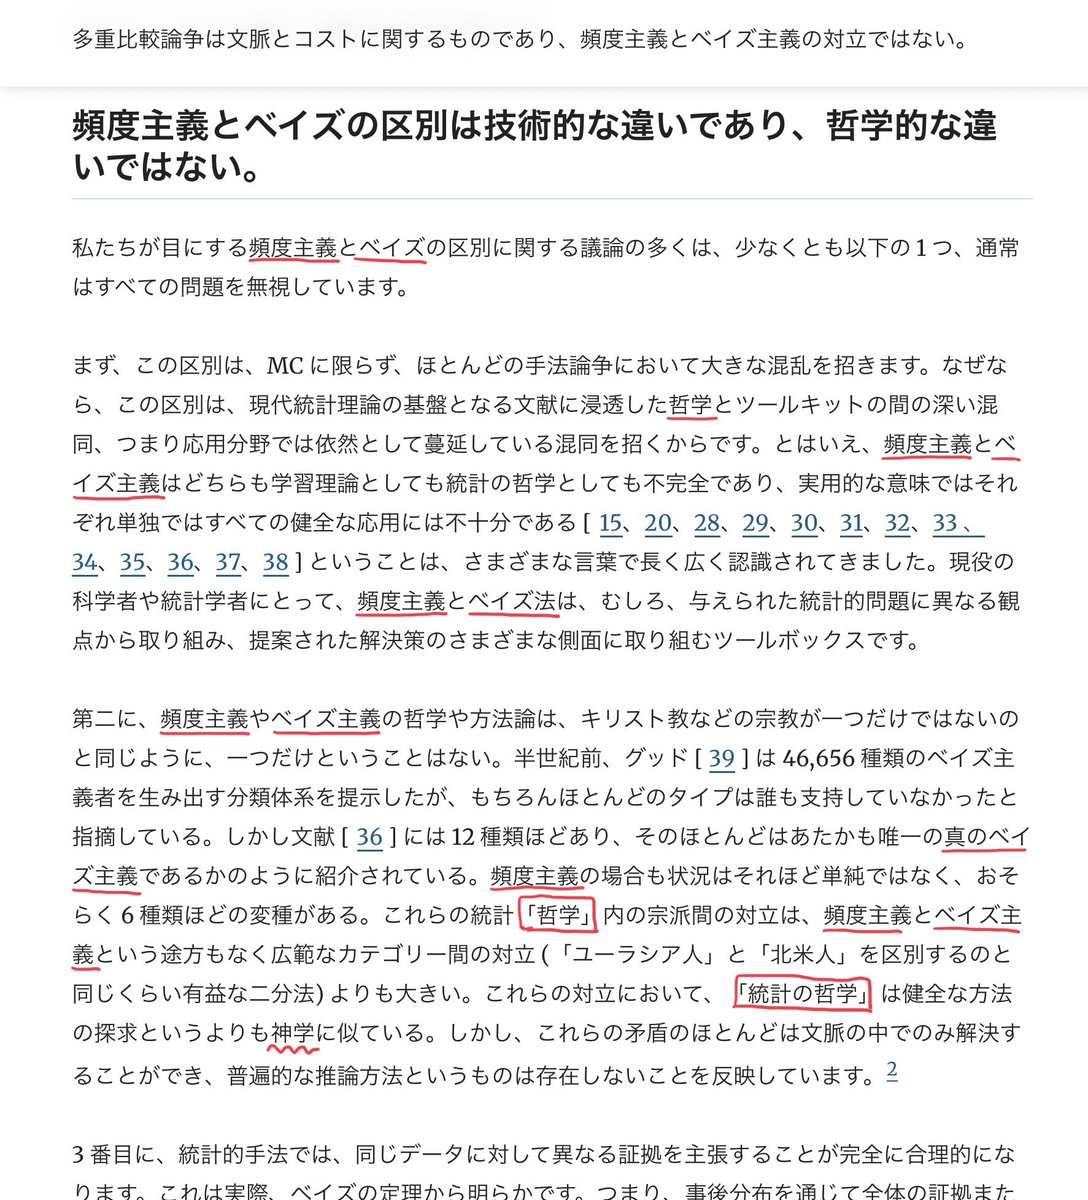
ベイズの側での事前分布を
どれだけ平坦事前分布(もしくはその類似物)
と違うものを取るか
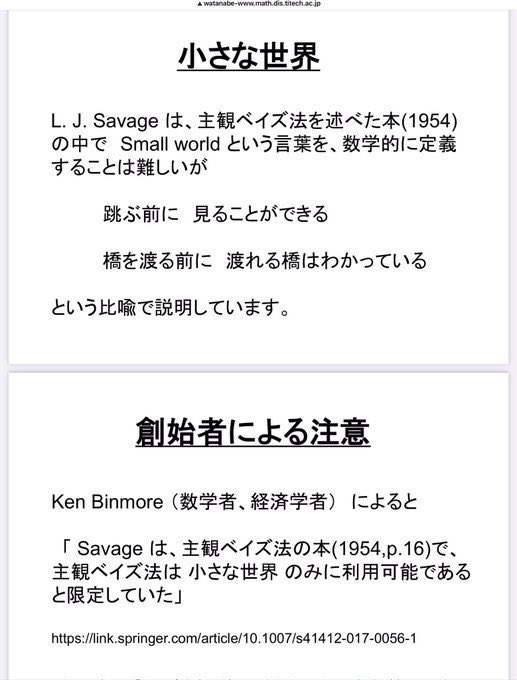
しかありません。
しかし、複雑なモデルではシンプルな最尤法は有効でなくなったりして本質的な違いが出ます。
ベイズの側での事前分布を
どれだけ平坦事前分布(もしくはその類似物)
と違うものを取るか
しかありません。
しかし、複雑なモデルではシンプルな最尤法は有効でなくなったりして本質的な違いが出ます。
10
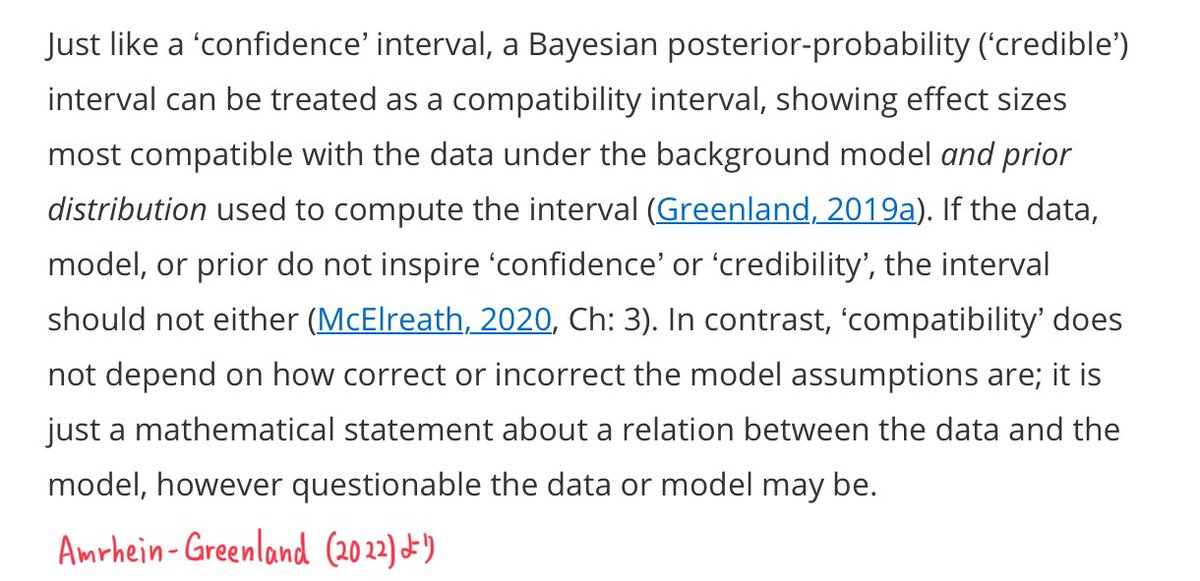
#統計 事後分布もデータの数値とモデルとパラメータの値の設定の相性の良さ(compatibility)を記述していることは、McElreathさんのStatistical Rethinkingにあります。
Statistical Rethinkingは主義に基くベイズ統計に洗脳された人を脱洗脳するために役に立つ素晴らしいベイズ統計入門になっている。

Statistical Rethinkingは主義に基くベイズ統計に洗脳された人を脱洗脳するために役に立つ素晴らしいベイズ統計入門になっている。
黒木玄 Gen Kuroki@genkuroki
#統計 通常の信頼区間だけではなく、ベイズ版の信用区間も compatibility interval と呼んで同じように解釈することの合理性については、McElreathさんのStatistical Rethinking 2nd ed. の3.2.2 (p.54)を参照。
Amrhein-Greenland (2022) journals.sagepub.com/doi/10.1177/02… も参照。
Amrhein-Greenland (2022) journals.sagepub.com/doi/10.1177/02… も参照。
11
#統計 多分、「頻度論 vs. ベイズ主義」的な言説に騙されている人達は、P値を使う統計学とは全然違う別の流派としてベイズ統計学があるかのように信じている。
そうなった人達が、P値関数とベイズ統計の事後分布が同じような使い方をできるというようなことに自力で気付くことはないだろう。
そうなった人達が、P値関数とベイズ統計の事後分布が同じような使い方をできるというようなことに自力で気付くことはないだろう。
12
#統計 一方、P値と言えば主に「差がない」型のゼロ仮説単体のP値(null P値)のことだと思っていて、P値はNHST(帰無仮説有意性検定)のための道具だと信じている人も、「差はaである」型の仮説達に関するP値全体(P値関数)が認識外になって、ベイズ統計の事後分布との類似に気付くことはないだろう。
13
#統計 一方、世界の一流の人達は(例えばGreenlandさんは) null P値単体ではなくP値関数全体を考えて、compatibilityによる安全な解釈を提案している。
そのベイズ統計での類似として信用区間のcompatibilityによる解釈をStatistical Rethinkingは提案している。
こういう重要情報が広まっていない。
そのベイズ統計での類似として信用区間のcompatibilityによる解釈をStatistical Rethinkingは提案している。
こういう重要情報が広まっていない。
14
関連

黒木玄 Gen Kuroki@genkuroki
#統計 統計学入門の教科書の伝統的スタイルでは推定の章と検定の章が分離されており、多くの場合にそれらの双対性の説明はない。P値の説明がなくて、棄却領域で説明していることが多い。
しかし、実際には、「P値(関数)から点推定、区間推定、仮説検定が全部出て来る」のスタイルに単純化可能。
しかし、実際には、「P値(関数)から点推定、区間推定、仮説検定が全部出て来る」のスタイルに単純化可能。
15
#統計 短くまとめると、
* 最尤法とベイズ法を比較するときに、ベイズ側で事後分布を持ち出すのであれば、最尤法の側でP値関数を持ち出す必要がある。
* 最尤法側でのP値関数の話は対数(最大)尤度比法、スコア法、Wald法に関する標準的な話になる。
* P値関数と事後分布の使い方はほぼ同じ。
* 最尤法とベイズ法を比較するときに、ベイズ側で事後分布を持ち出すのであれば、最尤法の側でP値関数を持ち出す必要がある。
* 最尤法側でのP値関数の話は対数(最大)尤度比法、スコア法、Wald法に関する標準的な話になる。
* P値関数と事後分布の使い方はほぼ同じ。
黒木玄 Gen Kuroki@genkuroki
#統計 まるっきり間違っています。
最尤法は点推定法ではあるのですが、統計学のイロハのイとして「点推定値だけを報告してはいけない」という原則があるので、最尤法に付随するP値関数によって、
データの数値と
モデルと
パラメータの値の設定
の相性の良さの様子
の記述を行います。続く
最尤法は点推定法ではあるのですが、統計学のイロハのイとして「点推定値だけを報告してはいけない」という原則があるので、最尤法に付随するP値関数によって、
データの数値と
モデルと
パラメータの値の設定
の相性の良さの様子
の記述を行います。続く
16
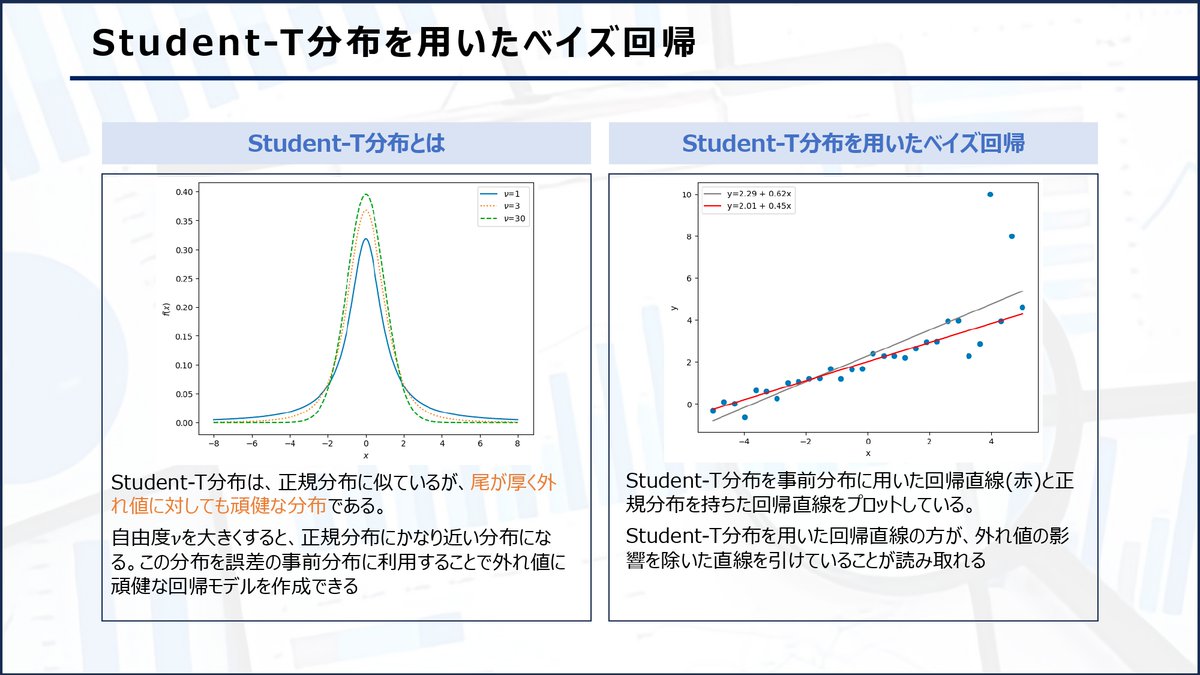
#統計 多分、「t分布を誤差の事前分布に用いる」ではなく、「t分布を残差の分布に用いる」が正しいと思います。
そして、外れ値に頑健な回帰モデルの使用は最尤法でも可能です。ただし、階層モデルの取り扱いが最尤法では大変で、尤度関数が多峰型になる場合もあって色々大変になる。
そして、外れ値に頑健な回帰モデルの使用は最尤法でも可能です。ただし、階層モデルの取り扱いが最尤法では大変で、尤度関数が多峰型になる場合もあって色々大変になる。
タランチュラ | データサイエンティスト@tarantula_ds_
【Student-T分布を用いたベイズ回帰】
Student-T分布を誤差の事前分布に用いると、外れ値に頑健な回帰モデルを作成できるよ🤔
この辺りは最尤推定ではできないことだと思うからベイズ回帰の大きな特徴の一つだと思う👍
Student-T分布を誤差の事前分布に用いると、外れ値に頑健な回帰モデルを作成できるよ🤔
この辺りは最尤推定ではできないことだと思うからベイズ回帰の大きな特徴の一つだと思う👍
17
#統計
* 残差がスケール変換されたt分布に従う
とするモデルは
* パラメータσ²は逆ガンマ分布に従う。
* 残差は期待値が0で分散がσ²の正規分布に従う
とするモデルと同等。後者は階層モデルになっており、そのままの最尤法の実装は面倒。t分布一発でモデル化しても尤度関数の多峰性が問題になる。
* 残差がスケール変換されたt分布に従う
とするモデルは
* パラメータσ²は逆ガンマ分布に従う。
* 残差は期待値が0で分散がσ²の正規分布に従う
とするモデルと同等。後者は階層モデルになっており、そのままの最尤法の実装は面倒。t分布一発でモデル化しても尤度関数の多峰性が問題になる。
18
#統計 階層モデルの最尤法では、最大化したい尤度関数が積分で定義されているので、そのまま実装しようとすると数値積分という重たい計算が必要になってしまう。
積分で定義された尤度関数の積分結果がシンプルな式で書けるならその問題はなくなるが、尤度関数が多峰型になると面倒さが残る。
積分で定義された尤度関数の積分結果がシンプルな式で書けるならその問題はなくなるが、尤度関数が多峰型になると面倒さが残る。
19
#統計 最尤法やその特別な場合の線形回帰(最小二乗法)も区間推定と共に使うことが普通だと思います。
統計学のイロハのイに「原則として点推定値はその不確かさがどの程度であるかが分かるように報告せよ」があります。
最尤法の漸近論の応用→対数(最大)尤度比法、スコア法、Wald法

統計学のイロハのイに「原則として点推定値はその不確かさがどの程度であるかが分かるように報告せよ」があります。
最尤法の漸近論の応用→対数(最大)尤度比法、スコア法、Wald法
なむ@namumam01
ベイズ推定だけ最適化問題(点推定)じゃな
くて区間推定できるけど、ある積分が難しいらしい。そのためにMCMCのギブスサンプリングって数値解法つかうみたい。
くて区間推定できるけど、ある積分が難しいらしい。そのためにMCMCのギブスサンプリングって数値解法つかうみたい。
20
#統計 ベイズ法での事後分布は、その計算に用いた事前分布と統計モデルの下での、データの数値とパラメータの値の設定の相性の良さの様子を記述しているとみなせます、
ベイズ法での事後分布と同じ使い方をする最尤法での道具は漸近論を使って得られるP値関数。
P値について理解していないと苦しい。
ベイズ法での事後分布と同じ使い方をする最尤法での道具は漸近論を使って得られるP値関数。
P値について理解していないと苦しい。
21
#統計 データの数値とモデル+パラメータの値の設定の相性の良さの程度を数値化して比較することは基本的な問題。
区間推定は相性の良さの程度を数値化から自然に得られる。
相性の良さの程度の数値化にはP値、尤度、事後分布などがある。
最尤法の漸近論はP値の構成のための標準的な方法の1つ。
区間推定は相性の良さの程度を数値化から自然に得られる。
相性の良さの程度の数値化にはP値、尤度、事後分布などがある。
最尤法の漸近論はP値の構成のための標準的な方法の1つ。
22
#統計 続き。ベイズ統計の解説者の中には、P値関数が事後分布と同様の使い方をされることを知らなかったり、最尤法の漸近論がP値を構成するための標準的方法の1つであることを知らなかったりする人達がいるので要注意。基本知識が足りない。
最悪の場合は哲学思想主義の違いを持ち出し始める。
最悪の場合は哲学思想主義の違いを持ち出し始める。
23
#統計 ベイズ的意思決定論の存在を理由に「ベイズ統計はリスク管理に向いている」と安易に言う人もいますが、ベイズ的意思決定論は事前分布を含むモデル内での期待リスクを最小化しているだけで、現実でのリスクを扱っているのではないということを正直に言わないのは不正直な態度で非難に値する。
24
#統計 最尤法は対数最大尤度比法、スコア法、Wald法で信頼区間も合わせて使うことが普通。
しかも、回帰係数とlog σ²についての平坦事前分布のベイズ法と通常の最小二乗法による線形回帰は、区間推定も含めて、誤差なしに結果がぴったり一致し、違い自体がありません。続く
しかも、回帰係数とlog σ²についての平坦事前分布のベイズ法と通常の最小二乗法による線形回帰は、区間推定も含めて、誤差なしに結果がぴったり一致し、違い自体がありません。続く
タランチュラ | データサイエンティスト@tarantula_ds_
【最尤推定による回帰直線 vs ベイズ推論による回帰直線】
最尤推定法とベイズ推論それぞれで回帰直線を求めたよ🤔
最尤推定法は最も確からしい1つの回帰直線を算出でき、ベイズ推論は信頼できる幅を持った回帰直線を算出できる特徴があるね👍面白い!!
最尤推定法とベイズ推論それぞれで回帰直線を求めたよ🤔
最尤推定法は最も確からしい1つの回帰直線を算出でき、ベイズ推論は信頼できる幅を持った回帰直線を算出できる特徴があるね👍面白い!!
25
#統計 事前分布が回帰係数とlog σ²に関する平坦事前分布から離れた分だけ、通常の線形回帰とベイズ的な線形回帰はことなります。
平坦でなくてもそれに近い大人しめの事前分布なら数値的にほとんど違いは出ません。続く
平坦でなくてもそれに近い大人しめの事前分布なら数値的にほとんど違いは出ません。続く
タランチュラ | データサイエンティスト@tarantula_ds_
【最尤推定による回帰直線 vs ベイズ推論による回帰直線】
最尤推定法とベイズ推論それぞれで回帰直線を求めたよ🤔
最尤推定法は最も確からしい1つの回帰直線を算出でき、ベイズ推論は信頼できる幅を持った回帰直線を算出できる特徴があるね👍面白い!!
最尤推定法とベイズ推論それぞれで回帰直線を求めたよ🤔
最尤推定法は最も確からしい1つの回帰直線を算出でき、ベイズ推論は信頼できる幅を持った回帰直線を算出できる特徴があるね👍面白い!!
26
#統計 実践的には平坦に近い大人しめの事前分布を採用することが多いと思います。
そういう場合には、通常の線形回帰とそのベイズ版の間には違いがほぼなくなります。
そういう場合を例にベイズと最尤法の違いを説明するのは酷くミスリーディングで有害情報の拡散になると思います。続く
そういう場合には、通常の線形回帰とそのベイズ版の間には違いがほぼなくなります。
そういう場合を例にベイズと最尤法の違いを説明するのは酷くミスリーディングで有害情報の拡散になると思います。続く
タランチュラ | データサイエンティスト@tarantula_ds_
【最尤推定による回帰直線 vs ベイズ推論による回帰直線】
最尤推定法とベイズ推論それぞれで回帰直線を求めたよ🤔
最尤推定法は最も確からしい1つの回帰直線を算出でき、ベイズ推論は信頼できる幅を持った回帰直線を算出できる特徴があるね👍面白い!!
最尤推定法とベイズ推論それぞれで回帰直線を求めたよ🤔
最尤推定法は最も確からしい1つの回帰直線を算出でき、ベイズ推論は信頼できる幅を持った回帰直線を算出できる特徴があるね👍面白い!!
27
#統計 ベイズ統計の方法は色々優秀なのですが、その解説者の大部分が不十分な理解でおかしなことを言っています。
おそらくそういうダメな解説を参考にしてしまったのだと思います。参考にした解説をきちんと引用して、誰がダメな解説を拡散しているかを明らかにすることは社会貢献になると思います。
おそらくそういうダメな解説を参考にしてしまったのだと思います。参考にした解説をきちんと引用して、誰がダメな解説を拡散しているかを明らかにすることは社会貢献になると思います。
タランチュラ | データサイエンティスト@tarantula_ds_
【最尤推定による回帰直線 vs ベイズ推論による回帰直線】
最尤推定法とベイズ推論それぞれで回帰直線を求めたよ🤔
最尤推定法は最も確からしい1つの回帰直線を算出でき、ベイズ推論は信頼できる幅を持った回帰直線を算出できる特徴があるね👍面白い!!
最尤推定法とベイズ推論それぞれで回帰直線を求めたよ🤔
最尤推定法は最も確からしい1つの回帰直線を算出でき、ベイズ推論は信頼できる幅を持った回帰直線を算出できる特徴があるね👍面白い!!
28
#統計 パラメータが2個の統計モデルの尤度関数を色々プロットすると、単峰型にならずに、複雑な形になる場合も色々あることに気付きます。
そういう場合には最尤法は有効だとは思えず、ベイズ統計を積極的に使わないと危ないと思います。
詳しくは渡辺澄夫著『ベイズ統計の理論と方法』を参照。
そういう場合には最尤法は有効だとは思えず、ベイズ統計を積極的に使わないと危ないと思います。
詳しくは渡辺澄夫著『ベイズ統計の理論と方法』を参照。
29
#統計 最尤法が破綻する統計モデルの尤度関数のヒートマップの例


黒木玄 Gen Kuroki@genkuroki
#統計 #Julia言語
添付画像の尤度函数は、分布
p(x|μ, t) = 0.5 N(x) + 0.5 N((x-μ)/exp(t))
のサイズ10の標本分布モデルの尤度函数の例です。
ここで、N(x)は標準正規分布の密度函数。
このモデルでは忠実な最尤法は破綻する。
github.com/genkuroki/publ…
添付画像の尤度函数は、分布
p(x|μ, t) = 0.5 N(x) + 0.5 N((x-μ)/exp(t))
のサイズ10の標本分布モデルの尤度函数の例です。
ここで、N(x)は標準正規分布の密度函数。
このモデルでは忠実な最尤法は破綻する。
github.com/genkuroki/publ…
30
#統計 尤度関数のヒートマップがこんな形になることもある。


黒木玄 Gen Kuroki@genkuroki
#統計 添付画像の瞬間の尤度函数の形(値が大きな場所ほど明るい)は、渡辺澄夫『ベイズ統計の理論と方法』の意味での特異モデルの場合の典型的な尤度函数の形になります。
データを取る前に、尤度函数の形がこういう感じになる可能性があるとわかっている場合には最尤法を使うのは危ない。
データを取る前に、尤度函数の形がこういう感じになる可能性があるとわかっている場合には最尤法を使うのは危ない。
31
#統計
通常の最小二乗法を線形回帰でのパラメータの区間推定
と
回帰係数とlog σ²についての平坦事前分布のベイズ線形回帰での事後分布を使ったパラメータの区間推定
が、数学的にぴったり同じになることの証明は易しいので、興味がある人は挑戦してみると良いと思います。
通常の最小二乗法を線形回帰でのパラメータの区間推定
と
回帰係数とlog σ²についての平坦事前分布のベイズ線形回帰での事後分布を使ったパラメータの区間推定
が、数学的にぴったり同じになることの証明は易しいので、興味がある人は挑戦してみると良いと思います。
32
#統計 どういう文献を参考にすればこういうおかしなことになるのでしょうか?
「信頼区間」は多分「信用区間」と書こうとしていたのだと思う。
信用区間の定義は1通りではなく、最高密度区間としての定義もあるし、等踞区間(図の左側)としての定義もあります。両方を信用区間と呼んで良い。
「信頼区間」は多分「信用区間」と書こうとしていたのだと思う。
信用区間の定義は1通りではなく、最高密度区間としての定義もあるし、等踞区間(図の左側)としての定義もあります。両方を信用区間と呼んで良い。
33
#統計 関連
34
#統計 信用区間には等踞区間や最高密度区間による複数の定義があるという普通の説明の仕方をせずに、「信用区間」と「最高事後密度区間」(HPD区間)は違うものだという前提で解説している本もあるようです。
次々におかしなスタイルが出て来る。
次々におかしなスタイルが出て来る。
黒木玄 Gen Kuroki@genkuroki
#統計 信用区間の構成法は複数あって、ETIやHDIがあります。
ETI版の信用区間とHDI版の信用区間がある。
「信用区間とHPD区間の比較」という言い方は信用区間と別にHPD区間(HPDI, HDI)があるかのように誤解させるのでよろしくない。
騙されないように気を付けて下さい。
↓
github.com/nakatsuma/pyth…
ETI版の信用区間とHDI版の信用区間がある。
「信用区間とHPD区間の比較」という言い方は信用区間と別にHPD区間(HPDI, HDI)があるかのように誤解させるのでよろしくない。
騙されないように気を付けて下さい。
↓
github.com/nakatsuma/pyth…
35
#統計 1変量連続分布での最高密度区間(HDI)の #Julia言語 による実装例。
黒木玄 Gen Kuroki@genkuroki
#統計 あと、HDIをcdfとpdfで書ける方程式の解を求める方法で実装していますが、単峰型連続分布での「指定された確率を持つ最短の区間」というHDIの特徴付けを用いても実装できます。
添付画像のhdi函数は #Julia言語 による実装例で非常にシンプルです。
nbviewer.org/github/genkuro…
添付画像のhdi函数は #Julia言語 による実装例で非常にシンプルです。
nbviewer.org/github/genkuro…
36
#統計 まとめ
* 最尤法でのP値関数もベイズ法での事後分布も特定のモデルの下でのデータの数値とパラメータの値の相性の良さ(compatibility)の様子を記述している。
* 残差がt分布に従うモデルによる回帰は最尤法でも可能。
* 平坦事前分布の下でのベイズ線形回帰は通常の線形回帰とぴったり同じ。
* 最尤法でのP値関数もベイズ法での事後分布も特定のモデルの下でのデータの数値とパラメータの値の相性の良さ(compatibility)の様子を記述している。
* 残差がt分布に従うモデルによる回帰は最尤法でも可能。
* 平坦事前分布の下でのベイズ線形回帰は通常の線形回帰とぴったり同じ。
37
#統計 この問題の背景
P値(とその双対の信頼区間)やベイズ統計に関する普及している解説の多くは杜撰なので、その内容を信じて再拡散すると社会的にマイナスの貢献になってしまう。
本当はデマの出所になっている人たちが火消しの努力をするべき。
P値(とその双対の信頼区間)やベイズ統計に関する普及している解説の多くは杜撰なので、その内容を信じて再拡散すると社会的にマイナスの貢献になってしまう。
本当はデマの出所になっている人たちが火消しの努力をするべき。
38
#統計 頻繁に見かける誤り。
誤り1: 例えば、袋の中に赤玉と白玉が大量に入っているとき、赤玉の割合は未知だが確定した値を持つ定数です。この事実は頻度論か否かと無関係です。その袋の中の赤玉の割合は物理的に確定しています。
t.co/a5K9lTh6i0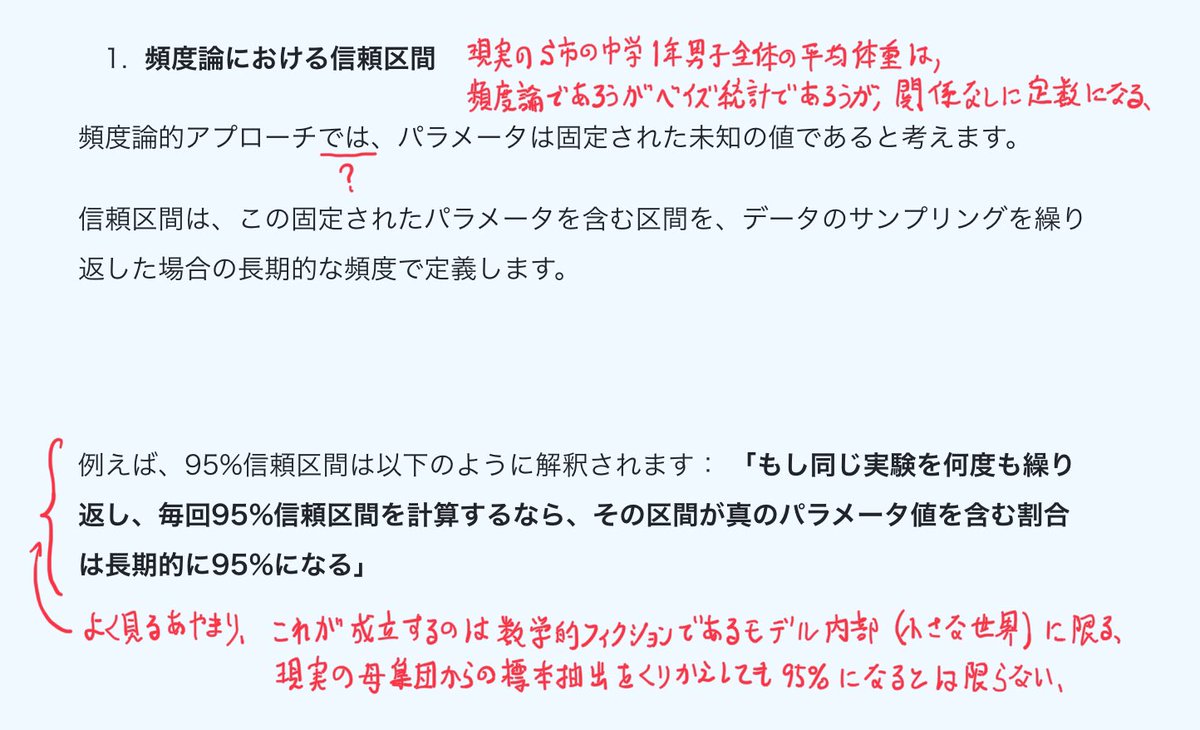
誤り1: 例えば、袋の中に赤玉と白玉が大量に入っているとき、赤玉の割合は未知だが確定した値を持つ定数です。この事実は頻度論か否かと無関係です。その袋の中の赤玉の割合は物理的に確定しています。
t.co/a5K9lTh6i0
39
#統計 続き
現実において赤玉と白玉が大量に入っている袋の中の赤玉に割合は物理的に確定している定数です。
ベイズ的なモデルでは袋の中の赤玉の割合を確率変数でモデル化しますが、そのようにモデル化しても、現実の袋の中の赤玉の割合も確率変数になったりしない。続く
statisticsschool.com/%e3%83%99%e3%8…
x.com/bluebayes_ja/s…
現実において赤玉と白玉が大量に入っている袋の中の赤玉に割合は物理的に確定している定数です。
ベイズ的なモデルでは袋の中の赤玉の割合を確率変数でモデル化しますが、そのようにモデル化しても、現実の袋の中の赤玉の割合も確率変数になったりしない。続く
statisticsschool.com/%e3%83%99%e3%8…
x.com/bluebayes_ja/s…
40
#統計 統計学の入門的解説が抱える最大の問題は、数学的フィクションに過ぎないモデルと現実の区別を曖昧にしていることです。あたかもモデルの前提が現実でも成立しているかのように解説が進んで行く。
モデルと現実の混同が非科学的な考え方の典型例なので、これは科学的に極めて有害です。続く
モデルと現実の混同が非科学的な考え方の典型例なので、これは科学的に極めて有害です。続く
41
#統計 誤り2
モデルの前提は現実では成立しているとは限らないので、
標本の無作為抽出を繰り返して95%信頼区間を何度も計算し直せば、真の値を含む区間の割合は95%程度になる
という主張も一般には誤りです。これは数学的フィクションであるモデル内でのみ成立している主張です。
x.com/bluebayes_ja/s…
モデルの前提は現実では成立しているとは限らないので、
標本の無作為抽出を繰り返して95%信頼区間を何度も計算し直せば、真の値を含む区間の割合は95%程度になる
という主張も一般には誤りです。これは数学的フィクションであるモデル内でのみ成立している主張です。
x.com/bluebayes_ja/s…
42
#統計 「標本の無作為抽出を繰り返して95%信頼区間を何度も計算し直せば、真の値を含む区間の割合は95%程度になる」という説明の仕方は有害。
「モデル内部で生成された仮想的な標本から計算された95%信頼区間には、標本生成に使われたパラメータの値が95%の確率で含まれる」が正しい説明になります。
「モデル内部で生成された仮想的な標本から計算された95%信頼区間には、標本生成に使われたパラメータの値が95%の確率で含まれる」が正しい説明になります。
43
#統計 モデル内部での標本分布における確率計算では、標本の無作為抽出を繰り返す必要はなくて、確率質量関数や確率密度関数を足し上げれば良いので、標本の無作為抽出を繰り返しも必要ありません。
「頻度論」のような科学的に無用な主義の話をしたがるから、非科学的な解説になってしまうのです。
「頻度論」のような科学的に無用な主義の話をしたがるから、非科学的な解説になってしまうのです。
44
#統計 大量に赤玉と白玉を含んでいる現実の袋の中からn個の玉を無作為に取り出したらそのうちのx個が赤玉だったとします。事前分布Beta(a,b)の二項分布モデルでの事後分布はBeta(a+x,b+n-x)になる。
現実には袋の中の赤玉の割合は未知の確定した定数であり、Beta(a+x,b+n-x)に従う確率変数ではない。
現実には袋の中の赤玉の割合は未知の確定した定数であり、Beta(a+x,b+n-x)に従う確率変数ではない。
45
#統計 だから、現実のその袋の中に含まれる赤玉の割合(所謂真の値)がベイズ的な95%信用区間に含まれるか否かは未知だが確定しており、現実の真の値が95%信用区間に95%の確率で含まれるという主張は自明に間違っています。
その主張は、事前分布を含むベイズ的なモデル内部でのみ正しい。
その主張は、事前分布を含むベイズ的なモデル内部でのみ正しい。
46
#統計 以上が誤り3の説明。以下は誤り4
HPD区間は【通常の信用区間とは少し異なります】という説明の仕方も変です。
95%HPD区間(95%最高事後密度区間)は95%信用区間の一種です。
95%信用区間達に中で最短のものが95%HPD区間になります。
x.com/bluebayes_ja/s…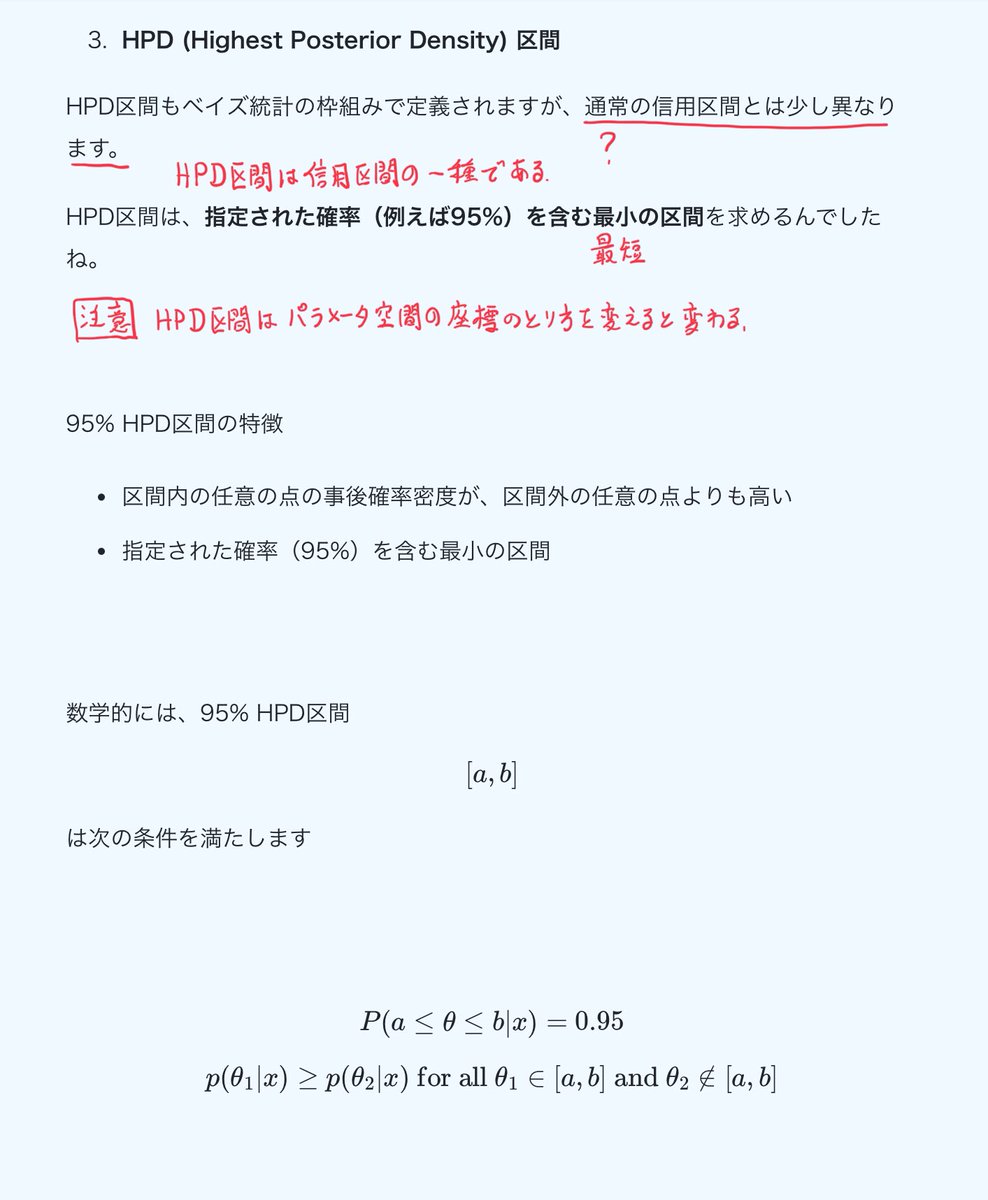
HPD区間は【通常の信用区間とは少し異なります】という説明の仕方も変です。
95%HPD区間(95%最高事後密度区間)は95%信用区間の一種です。
95%信用区間達に中で最短のものが95%HPD区間になります。
x.com/bluebayes_ja/s…
47
#統計 直接にはチェックしていないのですが、中妻照雄『Pythonによるベイズ統計学入門』朝倉書店には、信用区間とHPD区間は違うというような誤解を招く説明があるのでしょうか?
もしもあるなら該当箇所を誰か見せて欲しいです。
サポートサイトのリポジトリを見たら、確かにおかしかった。
↓
もしもあるなら該当箇所を誰か見せて欲しいです。
サポートサイトのリポジトリを見たら、確かにおかしかった。
↓
48
#統計 事後分布でのHDI(HPD区間)が最短の信用区間だと認識せずに、HPD区間と信用区間は違うと誤解しているように(不適切な解説に騙されているように)見える人達の例
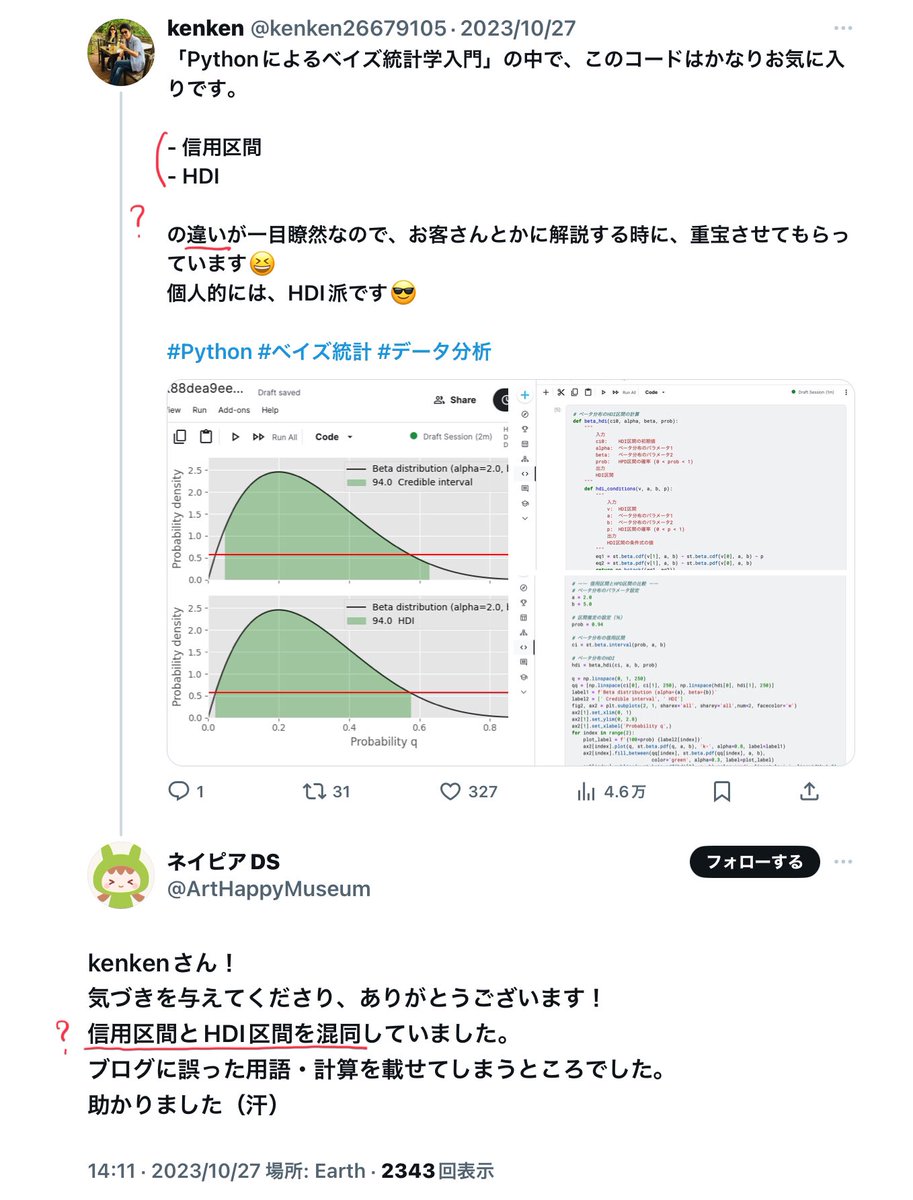
49
#統計 事後分布でのHDI(HPD区間)が最短の信用区間だと認識せずに、HPD区間と信用区間は違うと誤解しているように(不適切な解説に騙されているように)見える人達の例の追加
新たな誤解がリアルタイムで広まって来ている感じ。
新たな誤解がリアルタイムで広まって来ている感じ。
50
#統計 タランチュラ|データサイエンス学習支援さんは、定期的にデタラメを拡散して社会的に負の貢献をするためのアカウントなのでしょうか?
社会的に有害な活動は若い人が始めた場合ほど長期間社会に害を与え続けることになるので要注意です。
以下が酷いことは上の方で以前指摘しておいた。
社会的に有害な活動は若い人が始めた場合ほど長期間社会に害を与え続けることになるので要注意です。
以下が酷いことは上の方で以前指摘しておいた。
51
#統計 まだ酷くミスリーディング。
線形回帰のようなシンプルなモデルでは、最尤法とベイズ法の違いはほぼないことを強調しておいた方が誤解が少ないと思う。
回帰係数と残差の分散の対数についての平坦事前分布の下でのベイズ版線形回帰の結果は、最尤法を使う通常の線形回帰にぴったり一致。続く


線形回帰のようなシンプルなモデルでは、最尤法とベイズ法の違いはほぼないことを強調しておいた方が誤解が少ないと思う。
回帰係数と残差の分散の対数についての平坦事前分布の下でのベイズ版線形回帰の結果は、最尤法を使う通常の線形回帰にぴったり一致。続く
タランチュラ | データサイエンティスト@tarantula_ds_
こちらご指摘いただいたことをもとに修正させていただいたのですが、ベイズに詳しい方こちらの修正後の資料では違いを正確に表現できておりますでしょうか?
52
#統計 だから、ベイズ版線形回帰と通常の線形回帰の違いはベイズ版の方での事前分布の選び方による違いしか出ません。
多くの場合に事前分布は平坦に近い大人しめのものを選び、標本サイズもそれなりに大きいので、その違いは数値的に小さなものになります。続く

多くの場合に事前分布は平坦に近い大人しめのものを選び、標本サイズもそれなりに大きいので、その違いは数値的に小さなものになります。続く
タランチュラ | データサイエンティスト@tarantula_ds_
こちらご指摘いただいたことをもとに修正させていただいたのですが、ベイズに詳しい方こちらの修正後の資料では違いを正確に表現できておりますでしょうか?
53
#統計 最尤法とベイズ法の違いを線形回帰モデルの場合を例に説明しようとするのは無謀。その場合には最尤法とベイズ法はほぼ同じだと思っておいた方が良いです。
最尤法とベイズ法の違いについて説明したいなら、実際に大きな違いが出るようなモデルを使うべきです。私の過去投稿に例があります。続く

最尤法とベイズ法の違いについて説明したいなら、実際に大きな違いが出るようなモデルを使うべきです。私の過去投稿に例があります。続く
タランチュラ | データサイエンティスト@tarantula_ds_
こちらご指摘いただいたことをもとに修正させていただいたのですが、ベイズに詳しい方こちらの修正後の資料では違いを正確に表現できておりますでしょうか?
54
#統計 特定のモデルの下での最尤法では
データの数値に最も適合するモデルのパラメータの値
が求まります。通常の単純線形回帰では、残差が正規分布に従う云々というモデルの下で
データの数値に最も適合する回帰直線
が求まります。続く
データの数値に最も適合するモデルのパラメータの値
が求まります。通常の単純線形回帰では、残差が正規分布に従う云々というモデルの下で
データの数値に最も適合する回帰直線
が求まります。続く
55
#統計 【データの数値に基づいて最も適合した回帰直線を推定できる】だと「何に最も適合しているのか」が不明になり、おかしな説明にもなります。
実際に求めているのは、特定のモデルの下でデータの数値に最も適合している直線です。
データの数値に最も適合させています。続く

実際に求めているのは、特定のモデルの下でデータの数値に最も適合している直線です。
データの数値に最も適合させています。続く
タランチュラ | データサイエンティスト@tarantula_ds_
こちらご指摘いただいたことをもとに修正させていただいたのですが、ベイズに詳しい方こちらの修正後の資料では違いを正確に表現できておりますでしょうか?
56
#統計 データの数値への回帰係数の適合度(最近の私は「相性の良さの程度」と表現することが多い)の指標の1つはP値と呼ばれており、最尤法で求めた回帰係数はデータの数値への適合度が最大なのでそのP値は1になります。
続く
続く
タランチュラ | データサイエンティスト@tarantula_ds_
こちらご指摘いただいたことをもとに修正させていただいたのですが、ベイズに詳しい方こちらの修正後の資料では違いを正確に表現できておりますでしょうか?
57
#統計 P値が最大の1にならない回帰係数の値達には、データの数値への適合度が最大ではない回帰直線が対応しています。
最尤法でもP値を適切に定義することによって、適合度が最大でない回帰直線達も考えることができるようになります。そのことを利用して区間推定も可能になります。
続く
最尤法でもP値を適切に定義することによって、適合度が最大でない回帰直線達も考えることができるようになります。そのことを利用して区間推定も可能になります。
続く
タランチュラ | データサイエンティスト@tarantula_ds_
こちらご指摘いただいたことをもとに修正させていただいたのですが、ベイズに詳しい方こちらの修正後の資料では違いを正確に表現できておりますでしょうか?
58
#統計 最尤法の側ではP値関数がベイズ方での事後分布の役目を果たします。
線形回帰の場合には、最尤法の側のP値関数から得られる区間推定の結果は、βとlog σ²の平坦事前分布に関するベイズ法の事後分布から得られる区間推定の結果と誤差なしにぴったり一致します。
一般の場合も漸近的に一致。続く
線形回帰の場合には、最尤法の側のP値関数から得られる区間推定の結果は、βとlog σ²の平坦事前分布に関するベイズ法の事後分布から得られる区間推定の結果と誤差なしにぴったり一致します。
一般の場合も漸近的に一致。続く
タランチュラ | データサイエンティスト@tarantula_ds_
こちらご指摘いただいたことをもとに修正させていただいたのですが、ベイズに詳しい方こちらの修正後の資料では違いを正確に表現できておりますでしょうか?
59
#統計 線形回帰を例に説明しておくと良さそうなことは、最尤法とベイズ法の違いではなく、
最尤法側のP値関数
と
ベイズ法側の事後分布
が
ほぼ同じ役目を果たして
かつ
結果の数値もよく一致する
という事実を説明することです。
どちらを使っても大差がないことを説明するべきです。続く
最尤法側のP値関数
と
ベイズ法側の事後分布
が
ほぼ同じ役目を果たして
かつ
結果の数値もよく一致する
という事実を説明することです。
どちらを使っても大差がないことを説明するべきです。続く
タランチュラ | データサイエンティスト@tarantula_ds_
こちらご指摘いただいたことをもとに修正させていただいたのですが、ベイズに詳しい方こちらの修正後の資料では違いを正確に表現できておりますでしょうか?
60
#統計 よくある杜撰な解説には「頻度論vs.ベイズ主義」という極めて有害でミスリーディングな説明が含まれています。すでに洗脳され済みの人は、「P値(関数)と事後分布がほぼ同等の場合がある」という事実を知ると驚くと思う。
せっかく解説を書くならそういう面白い話を解説すると良いと思います。
せっかく解説を書くならそういう面白い話を解説すると良いと思います。
タランチュラ | データサイエンティスト@tarantula_ds_
こちらご指摘いただいたことをもとに修正させていただいたのですが、ベイズに詳しい方こちらの修正後の資料では違いを正確に表現できておりますでしょうか?
61
#統計 すでにパラメータθの区間推定法が与えられているとき(例えば通常の線形回帰ではt分布を使った区間推定法が与えられている)、仮説θ=aのP値は
信頼水準1-αの信頼区間の端点の1つがaになるαの値
として得られます。これが線形回帰の場合に具体的にどのように書けるかを求めるのは良い演習問題。
信頼水準1-αの信頼区間の端点の1つがaになるαの値
として得られます。これが線形回帰の場合に具体的にどのように書けるかを求めるのは良い演習問題。
62
#統計 P値関数の解説が載っている教科書は少ないのですが、P値関数とはaに仮説θ=aのP値を対応させる関数のことです。
1つ上の投稿にある演習問題を解けばP値関数についてよく理解できると思います。私もその演習問題を地道に解きました。
1つ上の投稿にある演習問題を解けばP値関数についてよく理解できると思います。私もその演習問題を地道に解きました。
63
#統計 最尤法よりもベイズ法が優れている場合→リンク先のリンク先
最尤法が使えない場合には、事前分布を使う方法(ベイズ法、MAP法)が力を発揮します。
最尤法が使えない場合には、事前分布を使う方法(ベイズ法、MAP法)が力を発揮します。
64
#統計 尤度関数の形が全然単峰型にならない場合には、おそらく最尤法は不適切で、ベイズ法を使うべきだと思います。
最尤法の基礎は標本サイズを大きくしたときの漸近論(尤度関数は単峰型になる)なのですが、それが通用しない場合があります。
最尤法の基礎は標本サイズを大きくしたときの漸近論(尤度関数は単峰型になる)なのですが、それが通用しない場合があります。
65
#統計 パラメータ数が大きなモデルの最尤法ではオーバーフィッティングのせいでまともに意味のある推定ができなくなる場合があります。
そういう場合には事前分布の設定によってオーバーフィッティングを抑制する方法が有効になります。
(((赤池弘次さんが出て来る話は面白いです。)))

そういう場合には事前分布の設定によってオーバーフィッティングを抑制する方法が有効になります。
(((赤池弘次さんが出て来る話は面白いです。)))
黒木玄 Gen Kuroki@genkuroki
#統計 補足資料5
ism.ac.jp/~ogata/Soukend…
統計地震学と赤池さん
尾形良彦
単純な最尤法だとパラメータ数が多いときにまともに推定できないときに、事前分布(先験分布)による「正則化」によって何とかできるという話。
赤池弘次さんも主義でベイズ統計を語ることに反対していました。
ism.ac.jp/~ogata/Soukend…
統計地震学と赤池さん
尾形良彦
単純な最尤法だとパラメータ数が多いときにまともに推定できないときに、事前分布(先験分布)による「正則化」によって何とかできるという話。
赤池弘次さんも主義でベイズ統計を語ることに反対していました。
66
#統計 階層モデルでの最尤法の実装は大変なので、階層モデルによる統計モデリングを行いたい人にとってはMCMC法のためのツール群を気軽に使えるベイズ法が有力な選択肢になります。
(((階層モデルでなくても、最尤法の数値計算が破綻しないようにすることは面倒なことが多いです。)))
(((階層モデルでなくても、最尤法の数値計算が破綻しないようにすることは面倒なことが多いです。)))
67
#統計 統計学ユーザー教育において異なる方法を比較するときには、主義の違いで説明しないようにすることが非常に重要です。
重要な理由は伝統的に主義に基く統計学観による有害な比較の仕方が蔓延しているからです。「頻度論vs.ベイズ主義」のスタイルの解説は典型的です。
重要な理由は伝統的に主義に基く統計学観による有害な比較の仕方が蔓延しているからです。「頻度論vs.ベイズ主義」のスタイルの解説は典型的です。
68
#統計 あと、特に不適切なスタイルでベイズ推しの印象操作をしている困って人達には、統計学の入門レベルのP値や信頼区間の知識が欠けている場合がよくあります。
例えば、Jaynesさんは信頼区間の構成の仕方を理解していないくせに頻度論を非常に偉そうな態度でdisっています。

例えば、Jaynesさんは信頼区間の構成の仕方を理解していないくせに頻度論を非常に偉そうな態度でdisっています。
黒木玄 Gen Kuroki@genkuroki
#統計 ところがJaynesさんは、なぜか、min(x)ではなく、x̅の方を使って信頼区間のようなものを構成しており、案の定、ナンセンスな結果が得られます。
そこで自分の誤りに気付けば良かったのですが、信頼区間を使用すること自体がナンセンスだと強く主張している。😱
github.com/genkuroki/publ…
そこで自分の誤りに気付けば良かったのですが、信頼区間を使用すること自体がナンセンスだと強く主張している。😱
github.com/genkuroki/publ…
69
#統計 Jaynesさんによるおかしな信頼区間の構成の代わりに、真っ当そうに見える信頼区間を構成すると、結果的にJaynesさんが比較として持ち出している平坦事前でのベイズ法による信用区間と誤差無しにぴったり同じ区間が得られます。
Jaynesさんが頻度論disのために持ち出した例は論外に不適切。

Jaynesさんが頻度論disのために持ち出した例は論外に不適切。
黒木玄 Gen Kuroki@genkuroki
#統計 素直に、min(x)を用いて作った信頼区間は平坦事前分布から得られるベイズ信用区間にぴったり一致します!
まだ私の議論に細かいミスが含まれているかもしれませんが、x̅を使う方針は最初からおかしく、min(x)を使うべきだということは正しいと思います。
github.com/genkuroki/publ…
まだ私の議論に細かいミスが含まれているかもしれませんが、x̅を使う方針は最初からおかしく、min(x)を使うべきだということは正しいと思います。
github.com/genkuroki/publ…
70
#統計 Jaynesさんのような超有名な偉い先生であっても「頻度論disのベイズ推し」は信用できない。
問題はそういう偉い先生達が書いた解説を再構成して理解(まるっきり間違っていることを理解する場合もある)するのではなく、鵜呑みして再拡散している集団の側にもあります。
被害者が加害者になる。
問題はそういう偉い先生達が書いた解説を再構成して理解(まるっきり間違っていることを理解する場合もある)するのではなく、鵜呑みして再拡散している集団の側にもあります。
被害者が加害者になる。
71
相互リンク
黒木玄 Gen Kuroki@genkuroki
@DS_school_1 #統計 そうなんです。特に大学の先生達が書いた酷い解説群が問題なんです。
ペンとコンピュータを使って地道に計算すると最尤法+αとベイズ法が多くの場合にほぼ同じ結果(場合によってはぴったり同じ結果)を与えることに気付けます。モデルがシンプルなら漸近的には常にそうなります。
関連
↓
ペンとコンピュータを使って地道に計算すると最尤法+αとベイズ法が多くの場合にほぼ同じ結果(場合によってはぴったり同じ結果)を与えることに気付けます。モデルがシンプルなら漸近的には常にそうなります。
関連
↓
72
#統計 P値関数に関する説明(具体例のグラフや文献紹介を含む)が欲しいならば、𝕏ったーで
from:genkuroki P値関数 OR P値関数
を検索するのが良いと思う。
P値はデータの数値とモデル+パラメータの値の設定の相性の良さの指標だと解釈されます。パラメータの値の関数としてのP値をP値関数と呼ぶ。
from:genkuroki P値関数 OR P値関数
を検索するのが良いと思う。
P値はデータの数値とモデル+パラメータの値の設定の相性の良さの指標だと解釈されます。パラメータの値の関数としてのP値をP値関数と呼ぶ。
73
#統計 補足
S市の高校1年生男子100人分の身長のデータの数値を得たとき、
* 頻度論であっても、そのデータの数値は確率変数ではなく定数です。
* ベイズであっても、S市の高校1年生男子全体の平均身長の値は未知ではあるが値が確定している定数です。
頻度論かベイズかは現実の事実には関係ない。
S市の高校1年生男子100人分の身長のデータの数値を得たとき、
* 頻度論であっても、そのデータの数値は確率変数ではなく定数です。
* ベイズであっても、S市の高校1年生男子全体の平均身長の値は未知ではあるが値が確定している定数です。
頻度論かベイズかは現実の事実には関係ない。
黒木玄 Gen Kuroki@genkuroki
#統計 統計学ユーザー教育において異なる方法を比較するときには、主義の違いで説明しないようにすることが非常に重要です。
重要な理由は伝統的に主義に基く統計学観による有害な比較の仕方が蔓延しているからです。「頻度論vs.ベイズ主義」のスタイルの解説は典型的です。
重要な理由は伝統的に主義に基く統計学観による有害な比較の仕方が蔓延しているからです。「頻度論vs.ベイズ主義」のスタイルの解説は典型的です。
74
#統計 続き
ベイズでパラメータが確率変数になるのは数学的フィクションであるモデル内での話で、現実の平均身長の話ではない。
S市の高校1年生男子全体からの無作為抽出による確率的揺らぎの影響を調べるときには、ベイズであっても、モデルとして確率変数のデータを考えざるを得ない。
ベイズでパラメータが確率変数になるのは数学的フィクションであるモデル内での話で、現実の平均身長の話ではない。
S市の高校1年生男子全体からの無作為抽出による確率的揺らぎの影響を調べるときには、ベイズであっても、モデルとして確率変数のデータを考えざるを得ない。
75
#統計 以上の2つの投稿で述べたことは、常識的でかつ易しい思考によってすぐにわかるはずのことなのですが、「頻度論vs.ベイズ」のスタイルの伝統的な言説群の影響力に負けてしまうと、当たり前の話が見えなくなって、カルトの信者のごとくパターン化されたおかしな教義を拡散する側にまわってしまう。
76
#統計 方法の違いを主義哲学思想原理の違いで説明しようとする伝統に対する批判の例。渡辺澄夫さん。
再リンク
↓
warp.ndl.go.jp/collections/in…
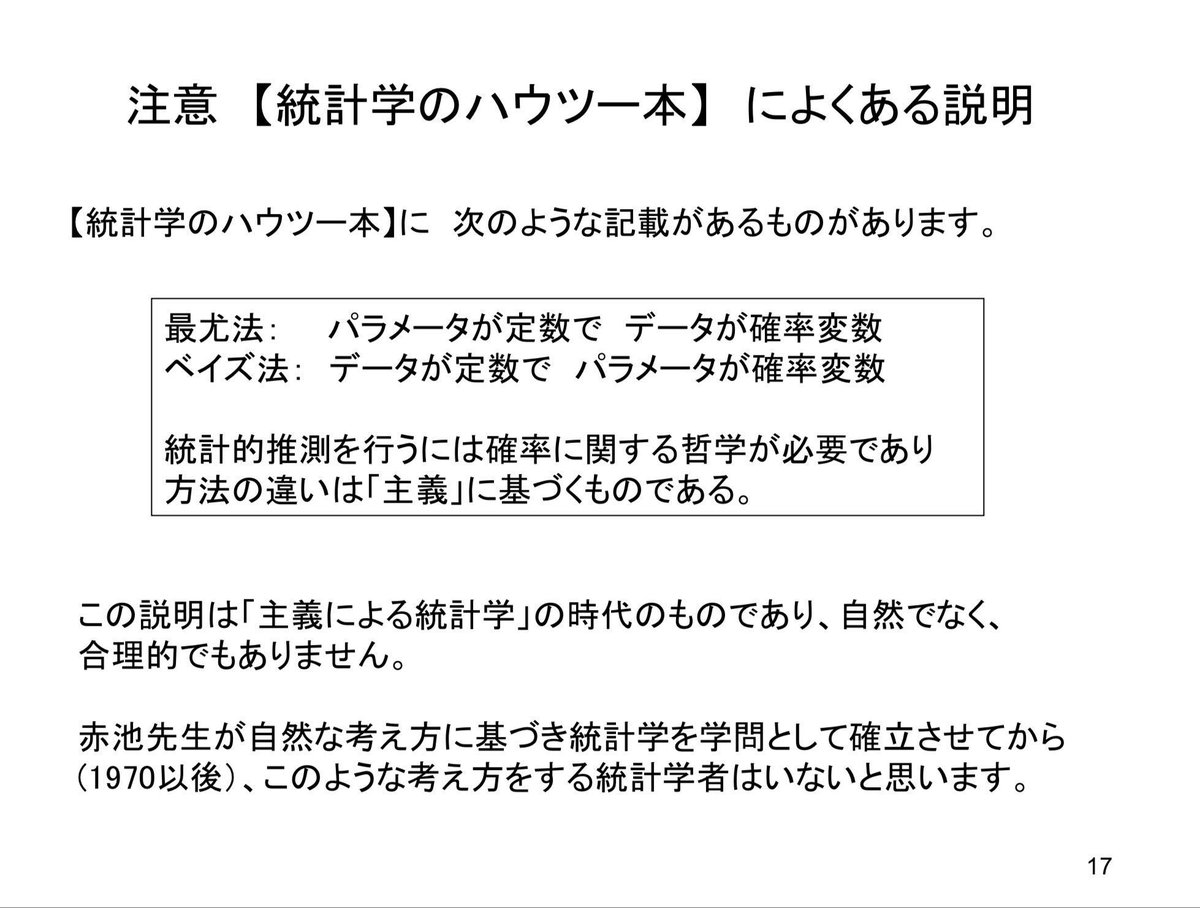
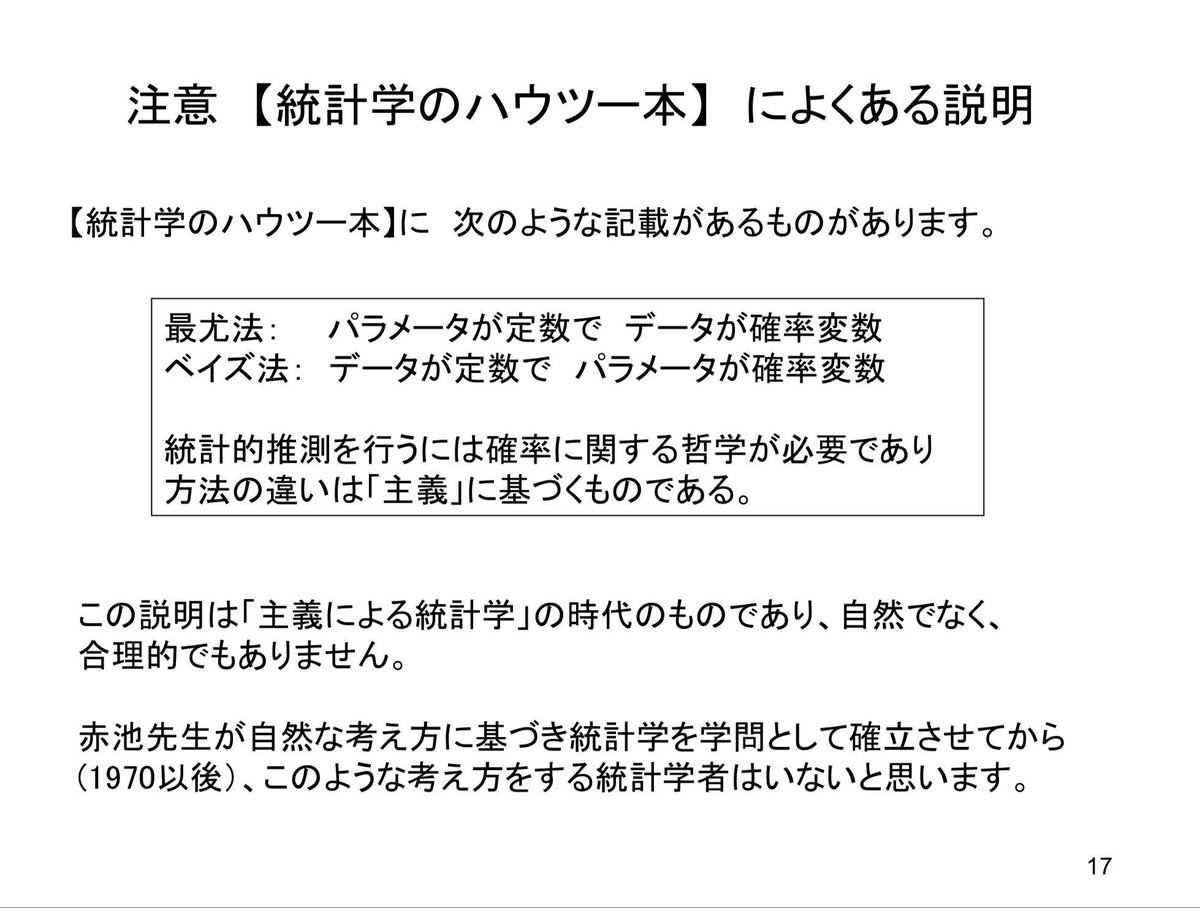
再リンク
↓
warp.ndl.go.jp/collections/in…
黒木玄 Gen Kuroki@genkuroki
#統計 翻訳【「パラメータは頻度論者には定数として扱われるが、ベイズ主義者に確率変数として扱われる」とよく(間違って)言われている】😊
「間違って」の部分を強調したい。
以下も参照。
watanabe-www.math.dis.titech.ac.jp/users/swatanab…
渡辺澄夫さん曰く
↓
「間違って」の部分を強調したい。
以下も参照。
watanabe-www.math.dis.titech.ac.jp/users/swatanab…
渡辺澄夫さん曰く
↓
77
#統計 通常の線形回帰での信頼区間と、回帰係数と残差の分散の対数について平坦な事前分布に関するベイズ版線形回帰の信用区間がぴったり一致することの証明。
↓
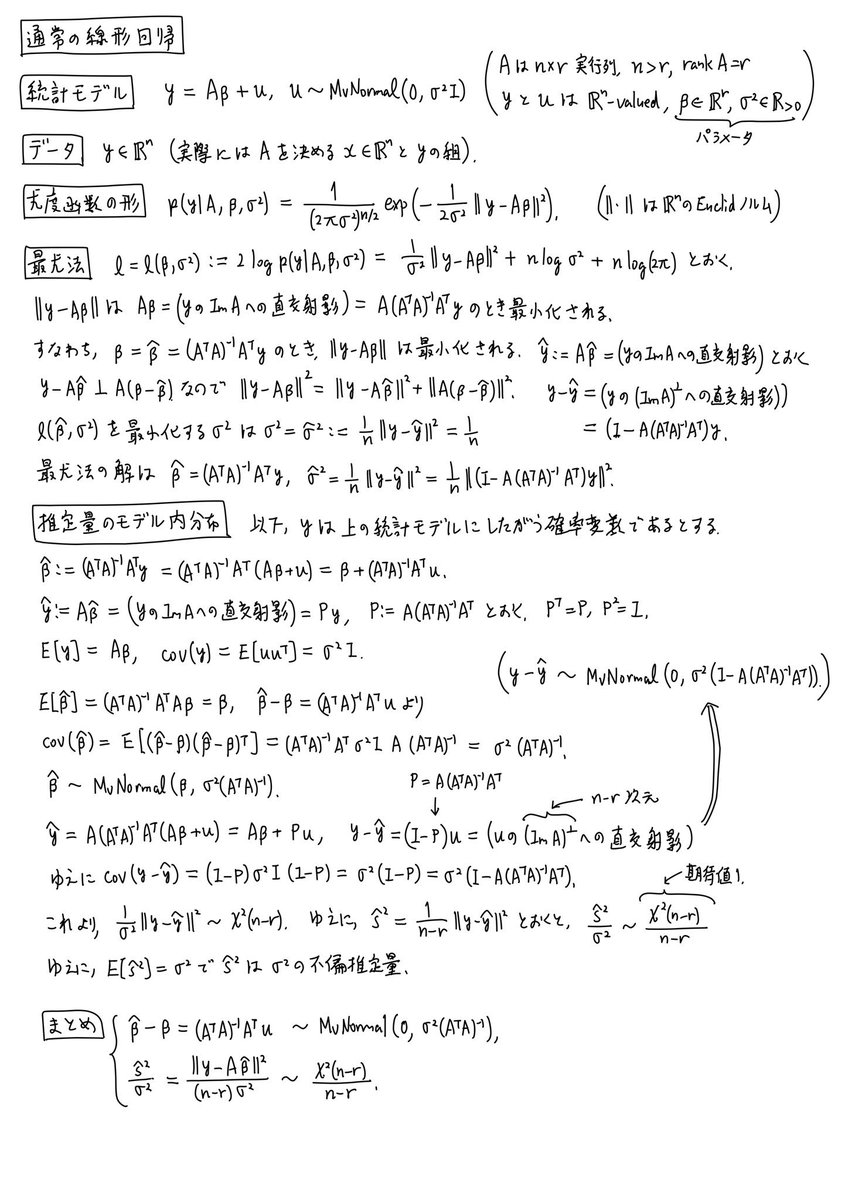

↓
黒木玄 Gen Kuroki@genkuroki
#統計
通常の線形回帰での回帰係数の信頼区間
と
回帰係数とlog σ²に関する平坦事前分布を使ったベイズ版線形回帰での回帰係数の信用区間
はぴったり一致します。
だから、平坦事前分布を使っていればMCMCで計算した回帰係数の信用区間は通常の信頼区間を求める計算にもなっています。続く
通常の線形回帰での回帰係数の信頼区間
と
回帰係数とlog σ²に関する平坦事前分布を使ったベイズ版線形回帰での回帰係数の信用区間
はぴったり一致します。
だから、平坦事前分布を使っていればMCMCで計算した回帰係数の信用区間は通常の信頼区間を求める計算にもなっています。続く
78
#統計 【ノンパラメトリック法は、データの分布に対する特定の仮定を設けずに分析する】は誤り。
例えば、Wilcoxon-Mann-Whitney検定の解説には「2つの母集団分布が平行移動の違いを除いて等しい」という仮定がよく書かれており、無条件では脆弱で使うべきではない検定法になります。続く

例えば、Wilcoxon-Mann-Whitney検定の解説には「2つの母集団分布が平行移動の違いを除いて等しい」という仮定がよく書かれており、無条件では脆弱で使うべきではない検定法になります。続く
タランチュラ | データサイエンティスト@tarantula_ds_
【パラメトリック法 vs ノンパラメトリック法】
データサイエンスの学習を進めるとパラメトリック・ノンパラメトリックという言葉がよく出てくるね🤔
簡単にいうと、データが特定の分布に従うと仮定するか否かだね!
それぞれまとめたので、なんとなく分かるけどよく分からない人は要チェック👍
データサイエンスの学習を進めるとパラメトリック・ノンパラメトリックという言葉がよく出てくるね🤔
簡単にいうと、データが特定の分布に従うと仮定するか否かだね!
それぞれまとめたので、なんとなく分かるけどよく分からない人は要チェック👍
79
#統計 【ノンパラメトリック法は、データの分布に対する特定の仮定を設けずに分析する】は誤り
2つ目の例。Brunner-Munzel検定は検定統計量の分布が正規分布で近似されることを仮定するので無条件で使える方法ではない。
練習問題: Wilcoxonの符号順位検定ではどのような条件を仮定しているか?
2つ目の例。Brunner-Munzel検定は検定統計量の分布が正規分布で近似されることを仮定するので無条件で使える方法ではない。
練習問題: Wilcoxonの符号順位検定ではどのような条件を仮定しているか?
タランチュラ | データサイエンティスト@tarantula_ds_
【パラメトリック法 vs ノンパラメトリック法】
データサイエンスの学習を進めるとパラメトリック・ノンパラメトリックという言葉がよく出てくるね🤔
簡単にいうと、データが特定の分布に従うと仮定するか否かだね!
それぞれまとめたので、なんとなく分かるけどよく分からない人は要チェック👍
データサイエンスの学習を進めるとパラメトリック・ノンパラメトリックという言葉がよく出てくるね🤔
簡単にいうと、データが特定の分布に従うと仮定するか否かだね!
それぞれまとめたので、なんとなく分かるけどよく分からない人は要チェック👍
80
#統計 パラメトリック法についても酷い誤解が蔓延しているので、誤解を助長しないように解説する必要があります。
その蔓延している酷い誤解は
t検定達は正規母集団でないと使えない
という誤解です。そのせいで、余計に危険で脆弱なノンパラメトリック検定の使用に誤誘導されている人が多い。
その蔓延している酷い誤解は
t検定達は正規母集団でないと使えない
という誤解です。そのせいで、余計に危険で脆弱なノンパラメトリック検定の使用に誤誘導されている人が多い。
タランチュラ | データサイエンティスト@tarantula_ds_
【パラメトリック法 vs ノンパラメトリック法】
データサイエンスの学習を進めるとパラメトリック・ノンパラメトリックという言葉がよく出てくるね🤔
簡単にいうと、データが特定の分布に従うと仮定するか否かだね!
それぞれまとめたので、なんとなく分かるけどよく分からない人は要チェック👍
データサイエンスの学習を進めるとパラメトリック・ノンパラメトリックという言葉がよく出てくるね🤔
簡単にいうと、データが特定の分布に従うと仮定するか否かだね!
それぞれまとめたので、なんとなく分かるけどよく分からない人は要チェック👍
81
#統計
正規分布を使うモデルを母平均に関する検定や区間推定に使う場合には、中心極限定理のおかげで正規分布の仮定が現実の母集団で成立していなくても十分に使える場合が多数出て来ます。
個人的にはt検定達をノンパラメトリック検定として解説するのもありだと思います。次の投稿で解説にリンク
正規分布を使うモデルを母平均に関する検定や区間推定に使う場合には、中心極限定理のおかげで正規分布の仮定が現実の母集団で成立していなくても十分に使える場合が多数出て来ます。
個人的にはt検定達をノンパラメトリック検定として解説するのもありだと思います。次の投稿で解説にリンク
タランチュラ | データサイエンティスト@tarantula_ds_
【パラメトリック法 vs ノンパラメトリック法】
データサイエンスの学習を進めるとパラメトリック・ノンパラメトリックという言葉がよく出てくるね🤔
簡単にいうと、データが特定の分布に従うと仮定するか否かだね!
それぞれまとめたので、なんとなく分かるけどよく分からない人は要チェック👍
データサイエンスの学習を進めるとパラメトリック・ノンパラメトリックという言葉がよく出てくるね🤔
簡単にいうと、データが特定の分布に従うと仮定するか否かだね!
それぞれまとめたので、なんとなく分かるけどよく分からない人は要チェック👍
82
#統計
t検定達をノンパラメトリック検定として説明する方法の解説(1標本t検定を例に説明しているが、Studentのt検定やWelchのt検定でも同様、さらに線形回帰一般でも同様)
↓
t検定達をノンパラメトリック検定として説明する方法の解説(1標本t検定を例に説明しているが、Studentのt検定やWelchのt検定でも同様、さらに線形回帰一般でも同様)
↓
黒木玄 Gen Kuroki@genkuroki
#統計 1標本t検定の方法によるP値(関数)や信頼区間については「正規母集団モデルを使う方法」だという説明が原因の誤解が蔓延しているので、対抗策として
「1標本t検定や2標本の場合のWelchのt検定はノンパラメトリック検定である」
という方針で解説するのもありだと思います。続く
「1標本t検定や2標本の場合のWelchのt検定はノンパラメトリック検定である」
という方針で解説するのもありだと思います。続く
83
#統計 正規性の仮定の取り扱いは非自明
* 母平均(もしくはその差)の検定や区間推定を行う場合には正規分布の仮定からの逸脱について頑健。その場合はノンパラメトリック法扱いすることも可能。
* 母分散(もしくはその比)検定や区間推定を行う場合には正規分布の仮定からの逸脱について脆弱。
* 母平均(もしくはその差)の検定や区間推定を行う場合には正規分布の仮定からの逸脱について頑健。その場合はノンパラメトリック法扱いすることも可能。
* 母分散(もしくはその比)検定や区間推定を行う場合には正規分布の仮定からの逸脱について脆弱。
タランチュラ | データサイエンティスト@tarantula_ds_
【パラメトリック法 vs ノンパラメトリック法】
データサイエンスの学習を進めるとパラメトリック・ノンパラメトリックという言葉がよく出てくるね🤔
簡単にいうと、データが特定の分布に従うと仮定するか否かだね!
それぞれまとめたので、なんとなく分かるけどよく分からない人は要チェック👍
データサイエンスの学習を進めるとパラメトリック・ノンパラメトリックという言葉がよく出てくるね🤔
簡単にいうと、データが特定の分布に従うと仮定するか否かだね!
それぞれまとめたので、なんとなく分かるけどよく分からない人は要チェック👍
84
#統計 その辺の解説は、教科書や大学での講義に従うとミスリーディングな解説を再拡散する側になり易いので、教科書や大学の講義を引用して否定して行く内容にした方が無難で安全になる可能性さえあります。
先輩達の考え方をはっきり否定して行くことが必要になるので大変な話だと思います。
先輩達の考え方をはっきり否定して行くことが必要になるので大変な話だと思います。
タランチュラ | データサイエンティスト@tarantula_ds_
【パラメトリック法 vs ノンパラメトリック法】
データサイエンスの学習を進めるとパラメトリック・ノンパラメトリックという言葉がよく出てくるね🤔
簡単にいうと、データが特定の分布に従うと仮定するか否かだね!
それぞれまとめたので、なんとなく分かるけどよく分からない人は要チェック👍
データサイエンスの学習を進めるとパラメトリック・ノンパラメトリックという言葉がよく出てくるね🤔
簡単にいうと、データが特定の分布に従うと仮定するか否かだね!
それぞれまとめたので、なんとなく分かるけどよく分からない人は要チェック👍
85
#統計 統計学のユーザー教育のための解説の多くが相当に酷い内容なのに、それを厳しく批判する傾向がないことが大問題。
特にフローチャート統計学の蔓延が酷い。
「パラメトリック」「ノンパラメトリック」などを危険な用語扱いする必要がある理由は杜撰なフローチャートに出て来る用語だから。
特にフローチャート統計学の蔓延が酷い。
「パラメトリック」「ノンパラメトリック」などを危険な用語扱いする必要がある理由は杜撰なフローチャートに出て来る用語だから。
86
#統計 悪しきフローチャート統計学の実態については以下のリンク先スレッドを参照。
フローチャート統計学を教えて来た人達(現在も存在する!)は「やってはいけないことをやってしまった」ときちんと宣言して、フローチャート統計学を潰す側に回って欲しいと思います。

フローチャート統計学を教えて来た人達(現在も存在する!)は「やってはいけないことをやってしまった」ときちんと宣言して、フローチャート統計学を潰す側に回って欲しいと思います。
黒木玄 Gen Kuroki@genkuroki
#統計 【日本の生物統計の第一人者の大橋靖男先生】については、以下を発見できた。
正規でなければt検定を使えないという誤解によって、常に使用可能なわけではないノンパラメトリック検定に安易に誘導することになる有害なフローチャートを引用していた。
これはアウト!
google.com/search?q=%22%E…
正規でなければt検定を使えないという誤解によって、常に使用可能なわけではないノンパラメトリック検定に安易に誘導することになる有害なフローチャートを引用していた。
これはアウト!
google.com/search?q=%22%E…
87
#統計 フローチャート統計学を教えてもペナルティを科されず来た人達は社会的に強い立場に就いているはずです。
そういう人達が「やってはいけないことをやってしまった」とはっきり宣言してくれないと、自分より強い立場の人達を否定する負担を次世代の若い人達に負わせてしまうことになります。
そういう人達が「やってはいけないことをやってしまった」とはっきり宣言してくれないと、自分より強い立場の人達を否定する負担を次世代の若い人達に負わせてしまうことになります。
88
#統計 常識的におかしな考え方を否定することも必要。
* 理解せずに機械的な手続きに従うだけでは、まともな統計分析を決してできない。理解する努力をしない人は統計学を使うことをやめた方がよい。
* 国試のためと称して悪しきフローチャート統計学を教えて来る先生はあなたを馬鹿にしている。
* 理解せずに機械的な手続きに従うだけでは、まともな統計分析を決してできない。理解する努力をしない人は統計学を使うことをやめた方がよい。
* 国試のためと称して悪しきフローチャート統計学を教えて来る先生はあなたを馬鹿にしている。
89
#統計 リンク先で言っていることの大雑把な説明
母平均やその差について知りたい場合には正規母集団の仮定からの逸脱に神経質にならずに済む場合が多いのですが、母分散やその比について知りたい場合には正規母集団の仮定からの逸脱に神経質になる必要がある。目的ごとに態度を変える必要がある。
母平均やその差について知りたい場合には正規母集団の仮定からの逸脱に神経質にならずに済む場合が多いのですが、母分散やその比について知りたい場合には正規母集団の仮定からの逸脱に神経質になる必要がある。目的ごとに態度を変える必要がある。
黒木玄 Gen Kuroki@genkuroki
#統計 正規性の仮定の取り扱いは非自明
* 母平均(もしくはその差)の検定や区間推定を行う場合には正規分布の仮定からの逸脱について頑健。その場合はノンパラメトリック法扱いすることも可能。
* 母分散(もしくはその比)検定や区間推定を行う場合には正規分布の仮定からの逸脱について脆弱。
* 母平均(もしくはその差)の検定や区間推定を行う場合には正規分布の仮定からの逸脱について頑健。その場合はノンパラメトリック法扱いすることも可能。
* 母分散(もしくはその比)検定や区間推定を行う場合には正規分布の仮定からの逸脱について脆弱。
90
#統計 悪しきフローチャート統計学の実例については以下のリンク先スレッドも参照。
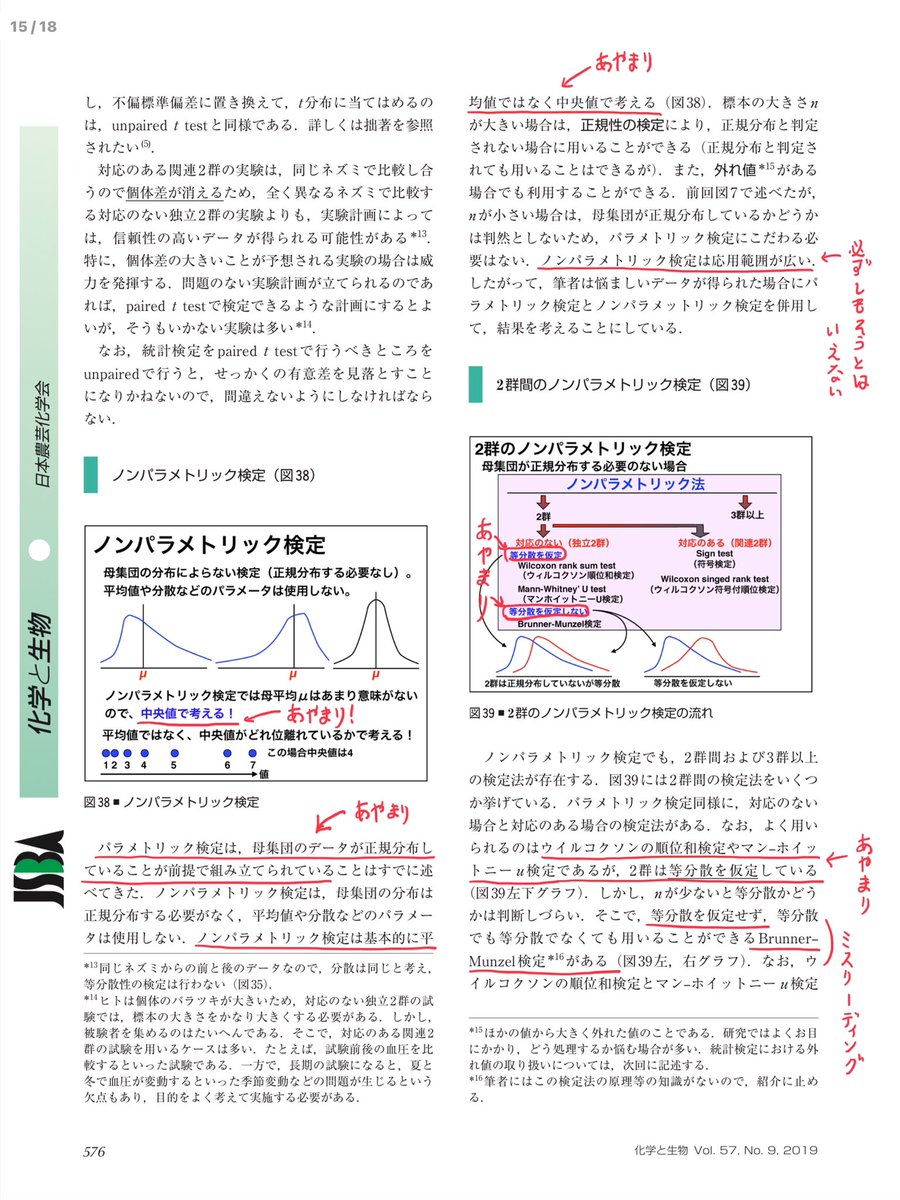
黒木玄 Gen Kuroki@genkuroki
#統計
jstage.jst.go.jp/article/kagaku…
改訂増補版:統計検定を理解せずに使っている人のためにII
池田 郁男
化学と生物57 巻 (2019) 9 号
これは3年前なのですが、いつものよく見る誤解がもろに説明されています。
現代でもこういうので統計学入門の勉強をしてしまう人達がいるわけです。非常に残念。続く
jstage.jst.go.jp/article/kagaku…
改訂増補版:統計検定を理解せずに使っている人のためにII
池田 郁男
化学と生物57 巻 (2019) 9 号
これは3年前なのですが、いつものよく見る誤解がもろに説明されています。
現代でもこういうので統計学入門の勉強をしてしまう人達がいるわけです。非常に残念。続く
91
#統計 以前に出版された本に加筆修正して最近出版されたバージョンでも悪しきフローチャート統計学が維持されたまま。
おそらく、悪しきフローチャート統計学について大学で講義して来た人達は誤りを認めて訂正する気がない。
こういう酷い話は非常に珍しいと思います。

おそらく、悪しきフローチャート統計学について大学で講義して来た人達は誤りを認めて訂正する気がない。
こういう酷い話は非常に珍しいと思います。
黒木玄 Gen Kuroki@genkuroki
#統計 池田郁男著『実験で使うとこだけ生物統計2 キホンのホン 決定版』関連情報。
フローチャート統計学を教えることは社会への負の貢献になるので、負の貢献だときちんと評価されるべき。
負の貢献をしていると評価されずに済んでいるから、何度でも負の貢献をノーリスクで繰り返す。
フローチャート統計学を教えることは社会への負の貢献になるので、負の貢献だときちんと評価されるべき。
負の貢献をしていると評価されずに済んでいるから、何度でも負の貢献をノーリスクで繰り返す。
92
#統計 以下のリンク先の件も酷くて、フローチャートの内容が杜撰なことを指摘したら、次の年のバージョンではフローチャートだけが削除されて、フローチャートと同じ内容を説明している部分はそのまま残されていました。
やはり、誤りを訂正するつもりがないように見えます。
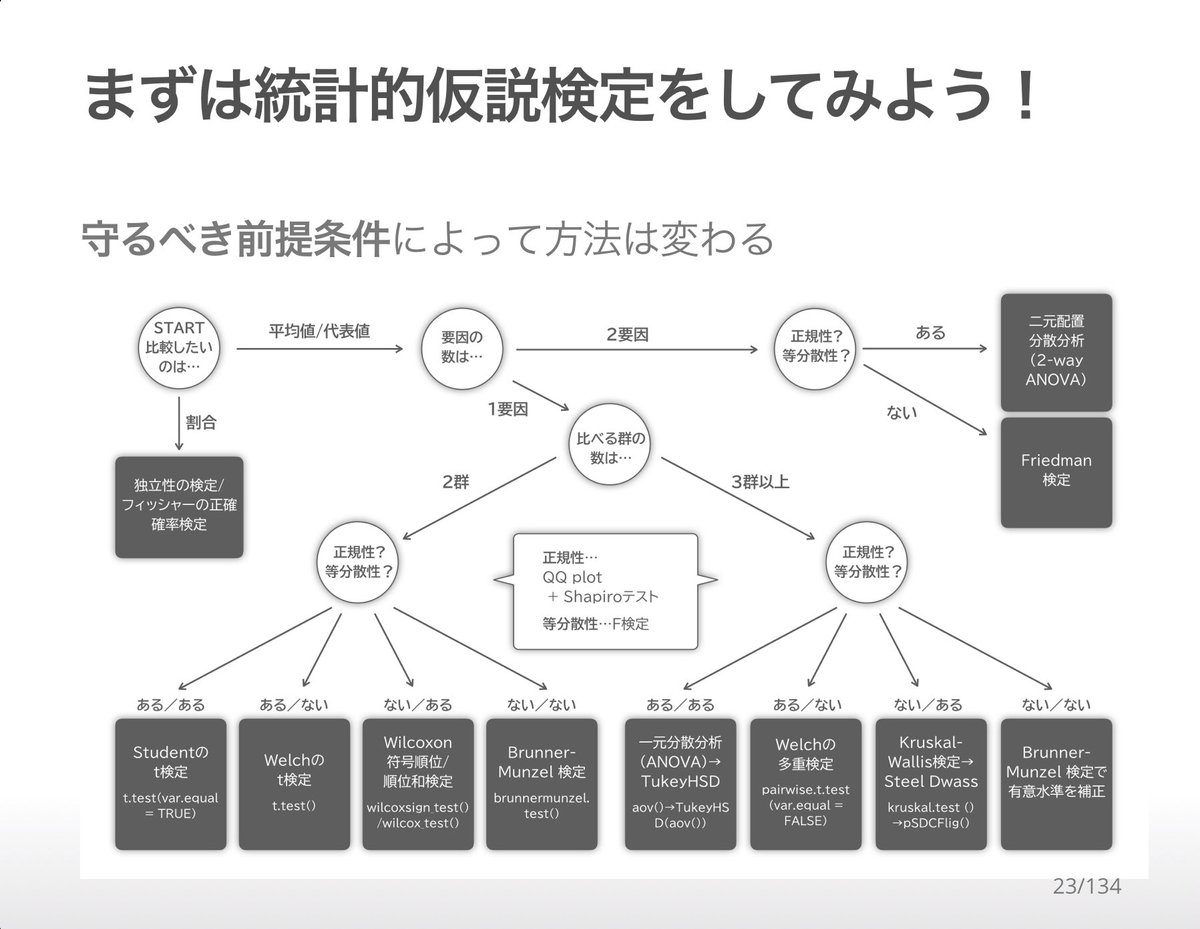
やはり、誤りを訂正するつもりがないように見えます。
黒木玄 Gen Kuroki@genkuroki
#統計 高等教育機関は、引用したフローチャートに従って統計分析を行う学生には統計学の単位を出すべきではないと私は思います。
なぜならば酷く間違った考え方をしているからです。
以下では「2群」の場合に制限して、具体的にどこが間違っているかを説明します。続く
comicalcommet.github.io/r-training-202…
なぜならば酷く間違った考え方をしているからです。
以下では「2群」の場合に制限して、具体的にどこが間違っているかを説明します。続く
comicalcommet.github.io/r-training-202…
93
#統計
2023年度版に対する指摘 (悪しきフローチャート統計学は、正規性検定で正規性が棄却されなければ「正規性あり」と判断するという仮説検定に関する初歩的誤りを含んでいることが多い。フローチャートを削除しても、内容はそのまま残されている)
↓


2023年度版に対する指摘 (悪しきフローチャート統計学は、正規性検定で正規性が棄却されなければ「正規性あり」と判断するという仮説検定に関する初歩的誤りを含んでいることが多い。フローチャートを削除しても、内容はそのまま残されている)
↓
黒木玄 Gen Kuroki@genkuroki
#統計 こういう非論理的な解説は珍しくない。
添付画像
25/153
①P値>5%のとき【態度を保留するのが正解】💮
40/153
②正規性検定によって【正規性があることは言えない】💮
41/153
③正規性検定でP値>5%のとき
【正規性がないとは言えない→「正規性あり」と判断】❓
comicalcommet.github.io/r-training-202…
添付画像
25/153
①P値>5%のとき【態度を保留するのが正解】💮
40/153
②正規性検定によって【正規性があることは言えない】💮
41/153
③正規性検定でP値>5%のとき
【正規性がないとは言えない→「正規性あり」と判断】❓
comicalcommet.github.io/r-training-202…
94
#統計 「用語有意差検定」は有害。「有意差」自体も有害だが(nature 2019の有名な記事)、「有意性検定」という言い方は、「どのような条件の下で母集団分布での何を測るのか」の違いを無視して、互換性がない検定法を互換性があるかのように誤解させるのでよくない。
悪しきフローチャート統計学。

悪しきフローチャート統計学。
タランチュラ | データサイエンティスト@tarantula_ds_
【t検定とWilcoxonの符号順位検定】
有意差検定はいくつかあってその違いを覚えるのは意外と大変だよね🤔
今回は、t検定とWilcoxonの符号順位検定の違いをまとめてみたよ!
☑️データがパラメトリックか否か
☑️平均値の差の検定か中央値の差の検定か
が大きな違いになるね👍
有意差検定はいくつかあってその違いを覚えるのは意外と大変だよね🤔
今回は、t検定とWilcoxonの符号順位検定の違いをまとめてみたよ!
☑️データがパラメトリックか否か
☑️平均値の差の検定か中央値の差の検定か
が大きな違いになるね👍
95
#統計 すでに指摘したように「パラメトリックかノンパラメトリックか」は大して重要ではない。その形式での区別を強調すると、正規分布モデルを使う方法が非正規分布にも広く使用できる場合があることや、ノンパラメトリックな方法も無条件では使えないことを説明を聴いた人が無視するリスクが増える。
タランチュラ | データサイエンティスト@tarantula_ds_
【t検定とWilcoxonの符号順位検定】
有意差検定はいくつかあってその違いを覚えるのは意外と大変だよね🤔
今回は、t検定とWilcoxonの符号順位検定の違いをまとめてみたよ!
☑️データがパラメトリックか否か
☑️平均値の差の検定か中央値の差の検定か
が大きな違いになるね👍
有意差検定はいくつかあってその違いを覚えるのは意外と大変だよね🤔
今回は、t検定とWilcoxonの符号順位検定の違いをまとめてみたよ!
☑️データがパラメトリックか否か
☑️平均値の差の検定か中央値の差の検定か
が大きな違いになるね👍
96
#統計 これも既出だと思うが、ノンパラメトリック検定の多くは中央値の差の検定ではないので、「平均値の差の検定か中央値の差の検定か」を強調することはミスリーディングです。
タランチュラ | データサイエンティスト@tarantula_ds_
【t検定とWilcoxonの符号順位検定】
有意差検定はいくつかあってその違いを覚えるのは意外と大変だよね🤔
今回は、t検定とWilcoxonの符号順位検定の違いをまとめてみたよ!
☑️データがパラメトリックか否か
☑️平均値の差の検定か中央値の差の検定か
が大きな違いになるね👍
有意差検定はいくつかあってその違いを覚えるのは意外と大変だよね🤔
今回は、t検定とWilcoxonの符号順位検定の違いをまとめてみたよ!
☑️データがパラメトリックか否か
☑️平均値の差の検定か中央値の差の検定か
が大きな違いになるね👍
97
#統計 対応のある2標本の意味が不明瞭。その場合の「2つのグループ間の平均値の差」とは何か?対応がない場合との区別がついていないように見える。
例えば、薬を飲む前の血圧Bᵢと飲んだ後の血圧Aᵢの差Xᵢ=Aᵢ-Bᵢに関する1標本t検定を「対応のある2標本のt検定」と呼んでいます。
例えば、薬を飲む前の血圧Bᵢと飲んだ後の血圧Aᵢの差Xᵢ=Aᵢ-Bᵢに関する1標本t検定を「対応のある2標本のt検定」と呼んでいます。
98
#統計 他にも、T先生の授業を受ける前のテストの点数Bᵢと受けた後の点数Aᵢの差Xᵢ=Aᵢ-Bᵢに関する1標本t検定が「対応のある2標本のt検定」といういかにもミスリーディングな言い方をされている。
Xᵢが正規分布のiidでなくても、iidであれば中心極限定理のおかげで多くの場合に使えます。続く
Xᵢが正規分布のiidでなくても、iidであれば中心極限定理のおかげで多くの場合に使えます。続く
タランチュラ | データサイエンティスト@tarantula_ds_
【t検定とWilcoxonの符号順位検定】
有意差検定はいくつかあってその違いを覚えるのは意外と大変だよね🤔
今回は、t検定とWilcoxonの符号順位検定の違いをまとめてみたよ!
☑️データがパラメトリックか否か
☑️平均値の差の検定か中央値の差の検定か
が大きな違いになるね👍
有意差検定はいくつかあってその違いを覚えるのは意外と大変だよね🤔
今回は、t検定とWilcoxonの符号順位検定の違いをまとめてみたよ!
☑️データがパラメトリックか否か
☑️平均値の差の検定か中央値の差の検定か
が大きな違いになるね👍
99
#統計 Wilcoxonの符号順位検定で使っているモデルでは、上記のXᵢ達がiidであるだけではなく、0を中心に左右対称な分布のiidであると仮定します。
この条件は現実では一般に保証されません。次の投稿で私のシミュレーション結果にリンクをはるために、引用リポストを一時的に切ります。
この条件は現実では一般に保証されません。次の投稿で私のシミュレーション結果にリンクをはるために、引用リポストを一時的に切ります。
タランチュラ | データサイエンティスト@tarantula_ds_
【t検定とWilcoxonの符号順位検定】
有意差検定はいくつかあってその違いを覚えるのは意外と大変だよね🤔
今回は、t検定とWilcoxonの符号順位検定の違いをまとめてみたよ!
☑️データがパラメトリックか否か
☑️平均値の差の検定か中央値の差の検定か
が大きな違いになるね👍
有意差検定はいくつかあってその違いを覚えるのは意外と大変だよね🤔
今回は、t検定とWilcoxonの符号順位検定の違いをまとめてみたよ!
☑️データがパラメトリックか否か
☑️平均値の差の検定か中央値の差の検定か
が大きな違いになるね👍
100
#統計 左右非対称な分布であるInverseGamma(1, 1)を並行移動して P(X₁+X₂>0)=1/2となるように調節して(注意: 母中央値が(P(X₁>0)=0)となるようには調節していない)行ったWilcoxonの符号順位検定の対称性の仮定からの逸脱への頑健性の程度を調べるためのシミュレーション。
↓
↓
101
#統計 「頻度主義 vs. ベイズ主義」と書いている時点で極めて有害。科学的にまともな考え方を少しでもできていれば、その手の主義に基く統計学観はクズそのものだと判断できていたはずです。
あと、数学的フィクションであるモデルに関する仮定と現実の話を明確に区別するべき。続く

あと、数学的フィクションであるモデルに関する仮定と現実の話を明確に区別するべき。続く
タランチュラ | データサイエンティスト@tarantula_ds_
【頻度主義 vs ベイズ主義】
統計学には頻度主義とベイズ主義の2種類のアプローチ方法があると「Pythonで体感するベイズ推論」で学び、まとめてみました。
何か認識を間違えている点やご指摘ありましたら、ぜひご意見ください!
統計学には頻度主義とベイズ主義の2種類のアプローチ方法があると「Pythonで体感するベイズ推論」で学び、まとめてみました。
何か認識を間違えている点やご指摘ありましたら、ぜひご意見ください!
102
#統計 頻度論的方法(←不適切だが仕方なくそう言っている)とベイズ法の違いは、事前分布を使うかどうか、データの数値による条件付けによる条件付き確率分布で統一的に仕組みが作られているかに過ぎません。数学的構成が全然違うのに、数学的に必然的に結果が互いに相手をよく近似することがよくある。
タランチュラ | データサイエンティスト@tarantula_ds_
【頻度主義 vs ベイズ主義】
統計学には頻度主義とベイズ主義の2種類のアプローチ方法があると「Pythonで体感するベイズ推論」で学び、まとめてみました。
何か認識を間違えている点やご指摘ありましたら、ぜひご意見ください!
統計学には頻度主義とベイズ主義の2種類のアプローチ方法があると「Pythonで体感するベイズ推論」で学び、まとめてみました。
何か認識を間違えている点やご指摘ありましたら、ぜひご意見ください!
103
#統計
非ベイズでは事前分布を使わないので、モデルのパラメータは確率変数扱いされません。
ベイズ統計の数学的モデルではモデルのパラメータの事前分布を使うので、モデルのパラメータは確率変数扱いされます。続く
非ベイズでは事前分布を使わないので、モデルのパラメータは確率変数扱いされません。
ベイズ統計の数学的モデルではモデルのパラメータの事前分布を使うので、モデルのパラメータは確率変数扱いされます。続く
タランチュラ | データサイエンティスト@tarantula_ds_
【頻度主義 vs ベイズ主義】
統計学には頻度主義とベイズ主義の2種類のアプローチ方法があると「Pythonで体感するベイズ推論」で学び、まとめてみました。
何か認識を間違えている点やご指摘ありましたら、ぜひご意見ください!
統計学には頻度主義とベイズ主義の2種類のアプローチ方法があると「Pythonで体感するベイズ推論」で学び、まとめてみました。
何か認識を間違えている点やご指摘ありましたら、ぜひご意見ください!
104
#統計 例えば私が住んでいる宮城県仙台市の小学校1年生男子全体の体重の平均値(母平均)という現実の値は、未知ではあるが物理的に決まっている定数だと考えられます。
母平均の区間推定でベイズ法を使う場合には、モデルの中での仮想的な母平均は事前分布によって確率変数扱いされます。続く
母平均の区間推定でベイズ法を使う場合には、モデルの中での仮想的な母平均は事前分布によって確率変数扱いされます。続く
タランチュラ | データサイエンティスト@tarantula_ds_
【頻度主義 vs ベイズ主義】
統計学には頻度主義とベイズ主義の2種類のアプローチ方法があると「Pythonで体感するベイズ推論」で学び、まとめてみました。
何か認識を間違えている点やご指摘ありましたら、ぜひご意見ください!
統計学には頻度主義とベイズ主義の2種類のアプローチ方法があると「Pythonで体感するベイズ推論」で学び、まとめてみました。
何か認識を間違えている点やご指摘ありましたら、ぜひご意見ください!
105
#統計 1つ上の投稿に書いたような当たり前のことを、普通に常識的に科学的に考える能力が足りないせいで、主義に基く統計学の信者になってしまった人たちはきちんと説明しません。
モデル(数学的フィクション)と現実の常識的な区別がないことが多いのです。
そういう流儀は全否定が妥当です。
モデル(数学的フィクション)と現実の常識的な区別がないことが多いのです。
そういう流儀は全否定が妥当です。
タランチュラ | データサイエンティスト@tarantula_ds_
【頻度主義 vs ベイズ主義】
統計学には頻度主義とベイズ主義の2種類のアプローチ方法があると「Pythonで体感するベイズ推論」で学び、まとめてみました。
何か認識を間違えている点やご指摘ありましたら、ぜひご意見ください!
統計学には頻度主義とベイズ主義の2種類のアプローチ方法があると「Pythonで体感するベイズ推論」で学び、まとめてみました。
何か認識を間違えている点やご指摘ありましたら、ぜひご意見ください!
106
#統計 例えば、コインを投げて表が出たら当たりが出る確率が80%のルーレットを回し、裏が出たら当たりが出る確率が20%のルーレットを回したとしましょう。そしてルーレットの出目は当たりだったとします。
続く。以下、引用リポストを切ります。続く
続く。以下、引用リポストを切ります。続く
タランチュラ | データサイエンティスト@tarantula_ds_
【頻度主義 vs ベイズ主義】
統計学には頻度主義とベイズ主義の2種類のアプローチ方法があると「Pythonで体感するベイズ推論」で学び、まとめてみました。
何か認識を間違えている点やご指摘ありましたら、ぜひご意見ください!
統計学には頻度主義とベイズ主義の2種類のアプローチ方法があると「Pythonで体感するベイズ推論」で学び、まとめてみました。
何か認識を間違えている点やご指摘ありましたら、ぜひご意見ください!
107
#統計 続き。そのときに投げたコインが表であった確率を求めることは、主観事前分布を使うベイズ主義と無関係に、単なる条件付き確率を求める試験問題に過ぎません。非ベイズの場合だともみなされる。続く
108
#統計 その計算で使用するモデル内で、コインの表裏は数学的には事前分布と同じ形式で定式化されますが、その確率分布は頻度論的に(近似的に)正しいものを採用します(表の出る確率は1/2)。
条件付き確率の定義からただちに得られる自明でつまらないベイズの定理を使うこととベイズ統計は違います。
条件付き確率の定義からただちに得られる自明でつまらないベイズの定理を使うこととベイズ統計は違います。
109
#統計 ベイズの定理を使っていれば即ベイズ統計を使っているという印象操作を行なっている人が結構いるので注意が必要です。
続く
続く
110
#統計 事前分布にあたるものとして頻度論的に近似的に正しいと分かっているものを使った議論は単に正しい確率計算をしているだけなので文句を付けようがない。
そういう手堅い計算を見せた後に、さらりと怪しげな事前分布を使った場合の計算を見せて同じようなものだと思わせる作戦です。酷い。
そういう手堅い計算を見せた後に、さらりと怪しげな事前分布を使った場合の計算を見せて同じようなものだと思わせる作戦です。酷い。
111
#統計 実践的なケースで怪しげなのは事前分布だけではなくて、事前分布を与えるパラメータ付き確率分布のモデルの現実での妥当性が保証されない場合が非常に多い。
所謂「大きな世界」の統計学というやつです。続く
所謂「大きな世界」の統計学というやつです。続く
112
#統計 非常に困ったことに、統計学の解説では、非ベイズの方法でもベイズの方法でも、モデルが現実でも正しいことを当然の前提とした上で方法の最適性(所謂意思決定論にこと)について説明していることが多い。
それは実践的には使えない「小さな世界」の統計学です。続く
それは実践的には使えない「小さな世界」の統計学です。続く
113
#統計 「頻度主義vs.ベイズ主義」の言説は「小さな世界」(モデルが現実でも正しい世界)を前提にしており、「小さな世界」の統計学は、モデルの現実での妥当性が不明の「大きな世界」での実践には役に立ちません。
114
#統計 実践的な「大きな世界」の統計学では、頻度主義とベイズ主義の違いは単に使っている数学的方法の違いに過ぎません。
数学の世界では異なる方法が近似的に同じ結果を与えるという結果が多数あるので、数学的に方法が違っていても、実践的にもまるっきり違うとは単純には言えません。
数学の世界では異なる方法が近似的に同じ結果を与えるという結果が多数あるので、数学的に方法が違っていても、実践的にもまるっきり違うとは単純には言えません。
115
#統計 「頻度主義vs.ベイズ主義」の議論は「小さな世界」内における小さなことに過ぎません。単に数学的方法としての違いを正確に説明すれば十分です。主義はいらない。
対立させるなら、
実践的には使えない「小さな世界」の統計学
と
実践的な「大きな世界」の統計学
を対立させるべきです。
対立させるなら、
実践的には使えない「小さな世界」の統計学
と
実践的な「大きな世界」の統計学
を対立させるべきです。
116
#統計 「小さな世界」の住人は頻度主義とベイズ主義の選択を大問題だと誤解し続ける。非科学的な人達。
「大きな世界」の住人にとっては、モデルが現実で妥当であるか否かが大問題で、モデルが妥当ならベイズを使うからどうかは技術的な問題に過ぎないと考える。科学的には普通の考え方。
「大きな世界」の住人にとっては、モデルが現実で妥当であるか否かが大問題で、モデルが妥当ならベイズを使うからどうかは技術的な問題に過ぎないと考える。科学的には普通の考え方。
117
#統計 運良くモデルが妥当だと分かっていてかつモデルがシンプルで最尤法とそれに付随するP値関数を楽に使えるなら、最尤法とP値関数を使えば楽でしょう。しかし、最尤法が使えなかったり、モデルが複雑だったりする場合にはベイズ法の道具を使うことになるでしょう。主義で道具を選んだりしない。
118
#統計 「頻度主義vs.ベイズ主義」の話はバカでもそれなりに面白く聞けてしまうので、ついつい信じてしまう人が再生産され続けています。
主義の違いによって使用する道具を選ぶという発想はよっぽど何も理解していない限り出て来ません。
主義の違いによって使用する道具を選ぶという発想はよっぽど何も理解していない限り出て来ません。
119
#統計 以上のような「主義に基く統計学観を潰すための話」はここ数年繰り返ししています。𝕏ったーで
from:genkuroki #統計 主義
を検索してみて下さい。
個人的な意見では酷い実害が出ています。「頻度主義vs.ベイズ主義」を語る嘘つき達の害については以下のリンク先スレッドを参照。
from:genkuroki #統計 主義
を検索してみて下さい。
個人的な意見では酷い実害が出ています。「頻度主義vs.ベイズ主義」を語る嘘つき達の害については以下のリンク先スレッドを参照。
黒木玄 Gen Kuroki@genkuroki
#統計 「頻度主義vs.ベイズ主義」を語る嘘つき達のせいで、多くの人達が実践的によく使われる平坦もしくは平坦に近い事前分布の下では、ベイズ統計を使っても、P値関数や信頼区間達を使ってもほぼ同じ結果が得られることが多いという実践的に重要な情報が全然広まらない。続く
120
#統計 疫学・統計学・因果推論などの調査大家であるSander Greenlandさんの講演スライドは非常に面白いのでお勧め。
添付画像の下半分で説明されているのは、以上の話における「小さな世界」の統計学だとみなされます。
「小さな世界」の統計学は科学と対比されている。
biostatistics.ucdavis.edu/sites/g/files/…

添付画像の下半分で説明されているのは、以上の話における「小さな世界」の統計学だとみなされます。
「小さな世界」の統計学は科学と対比されている。
biostatistics.ucdavis.edu/sites/g/files/…

121
#統計 主義に基く統計学の否定や「小さな世界」などについては以下のリンク先スレッドも参照。
122
#統計 Greenland-Hofman 2019
Multiple comparisons controversies are about context and costs, not frequentism versus Bayesianism
Sander Greenland & Albert Hofman
14 September 2019
link.springer.com/article/10.100…
Multiple comparisons controversies are about context and costs, not frequentism versus Bayesianism
Sander Greenland & Albert Hofman
14 September 2019
link.springer.com/article/10.100…
123
#統計 Greenland-Hofman 2019より(MC=多重比較)
【頻度主義とベイズの区別は技術的な違いであり、哲学的な違いではない】
【「統計の哲学」は健全な方法の探求というよりも神学に似ている】


【頻度主義とベイズの区別は技術的な違いであり、哲学的な違いではない】
【「統計の哲学」は健全な方法の探求というよりも神学に似ている】
黒木玄 Gen Kuroki@genkuroki
#統計 添付画像はリンク先の論文 Greenland-Hofman 2019 より。
統計学に関する哲学の違いとツールキットとしての違いの混同が有害であることを徹底的に主張しています。
統計学についての哲学の違いを語る人たちは統計学教育的には概ね有害であるという情報は広く共有されるべきだと思います。
統計学に関する哲学の違いとツールキットとしての違いの混同が有害であることを徹底的に主張しています。
統計学についての哲学の違いを語る人たちは統計学教育的には概ね有害であるという情報は広く共有されるべきだと思います。
124

125
#統計 ベイズ的な統計的意思決定論は、パラメータ付き確率分布と事前分布の組み合わせで構成されたモデル内での確率分布について期待リスクを最小化しているだけなので、非実践的な「小さな世界」の統計学扱いする必要があります。
渡辺澄夫さんの解説スライドより
↓
warp.ndl.go.jp/info:ndljp/pid…
渡辺澄夫さんの解説スライドより
↓
warp.ndl.go.jp/info:ndljp/pid…
黒木玄 Gen Kuroki@genkuroki
#統計 渡辺澄夫さんは悪しき言説からの脱洗脳のために有用な用語として「小さな世界」を使っているのですが、Small Worldの解説はStatistical Rethinking 2nd ed.の第2章にもある。
このように、渡辺澄夫さん、Greenlandさん、Statistical Rethinkingには共通点が多い。
warp.ndl.go.jp/info:ndljp/pid…
このように、渡辺澄夫さん、Greenlandさん、Statistical Rethinkingには共通点が多い。
warp.ndl.go.jp/info:ndljp/pid…
126
#統計 数学的最適性は確かに重要です。同じ条件の下で検出力が高いP値関数の方が優秀だし、期待リスクは小さい方が良い。
しかしそれらの数理統計学的最適性は、数学的フィクションであるモデル内部(小さな世界)での最適性に過ぎず、現実における最適性ではありません。
biostatistics.ucdavis.edu/sites/g/files/…


しかしそれらの数理統計学的最適性は、数学的フィクションであるモデル内部(小さな世界)での最適性に過ぎず、現実における最適性ではありません。
biostatistics.ucdavis.edu/sites/g/files/…
黒木玄 Gen Kuroki@genkuroki
#統計 統計的意思決定論はモデル内部の「小さな世界」における最適性の話に過ぎず、「地元で最強」「井の中の蛙」。ベイズ的な意思決定論も当然そうです。
Greenlandさんも、モデル内部での数学的な最適性は実践的にもうまく行くことを意味しないことを強調しています。
biostatistics.ucdavis.edu/sites/g/files/…
Greenlandさんも、モデル内部での数学的な最適性は実践的にもうまく行くことを意味しないことを強調しています。
biostatistics.ucdavis.edu/sites/g/files/…
127
#統計 赤池弘次さんの1980年の2つの論説は非常に面白いので、みんな読むべき。

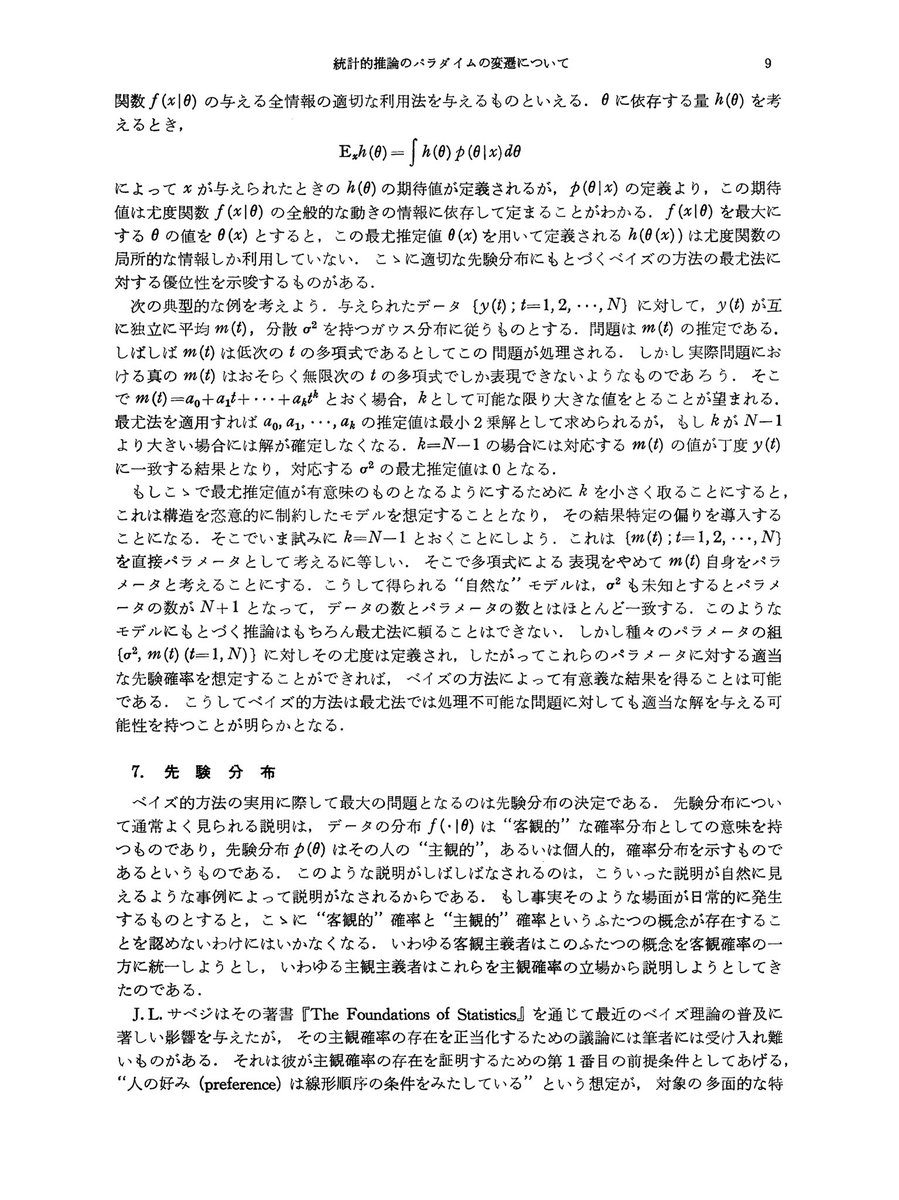


黒木玄 Gen Kuroki@genkuroki
#統計 赤池弘次さんの1980年の2つの論説は非常に面白いのでお勧め!
ismrepo.ism.ac.jp/records/32568
統計的推論のパラダイムの変遷について
jstage.jst.go.jp/article/butsur…
エントロピーとモデルの尤度(<講座>物理学周辺の確率統計)
添付画像は前者より
ismrepo.ism.ac.jp/records/32568
統計的推論のパラダイムの変遷について
jstage.jst.go.jp/article/butsur…
エントロピーとモデルの尤度(<講座>物理学周辺の確率統計)
添付画像は前者より
128
#統計 McElreathさんのStatistical Rethinkingも主義に基く統計学観を否定するために役に立ちます。(Statistical Rethinkingはベイズ統計の方法を採用しているが、ベイズ主義の統計学に帰依したりしていない(その逆))
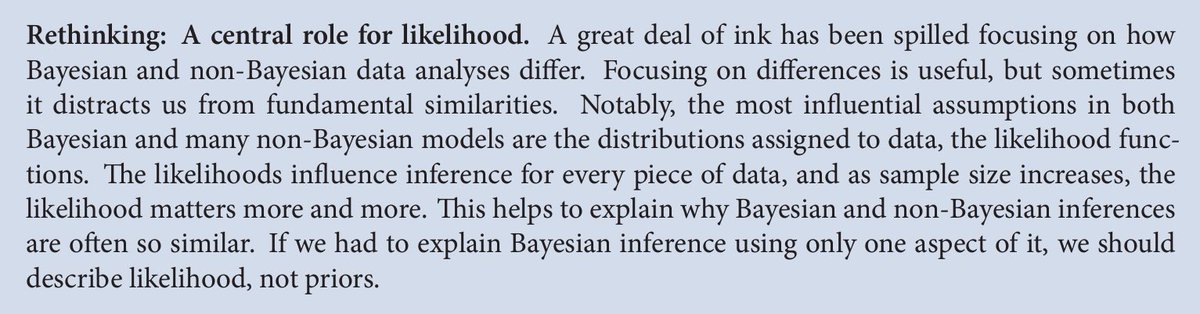
黒木玄 Gen Kuroki@genkuroki
#統計 添付画像はStatistical Rethinking 2nd ed. Chap.2より。
McElreathさんも、分析結果には尤度関数(モデルのパラメータ付き確率分布の部分)の影響が大きいことから、ベイズと非ベイズの(相違性ではなく)類似性を説明できると言っています。
xcelab.net/rmpubs/sr2/sta…
ALTに私訳あり
↓
McElreathさんも、分析結果には尤度関数(モデルのパラメータ付き確率分布の部分)の影響が大きいことから、ベイズと非ベイズの(相違性ではなく)類似性を説明できると言っています。
xcelab.net/rmpubs/sr2/sta…
ALTに私訳あり
↓
129
#統計 McElreathさんのStatistical Rethinking google.com/search?q=Stati… はそのタイトルからも分かるように、主義に基く統計学観を含む杜撰な内容の「統計学のハウツー本」による洗脳を解くために非常に役に立つ内容になっています。
伝統的かつ杜撰な説明をことごとく再考して否定してくれています。

伝統的かつ杜撰な説明をことごとく再考して否定してくれています。
黒木玄 Gen Kuroki@genkuroki
#統計 添付画像はStatistical Rethinking 2nd ed. Chap.2より
事前分布を使うベイズと使わないのでベイズの違いを気にするよりも、モデルとして採用したパラメータ付き確率分布が妥当であるかの方が重要。
多くの場合にモデルが妥当である保証はない。
xcelab.net/rmpubs/sr2/sta…
(ALTに私訳あり)
事前分布を使うベイズと使わないのでベイズの違いを気にするよりも、モデルとして採用したパラメータ付き確率分布が妥当であるかの方が重要。
多くの場合にモデルが妥当である保証はない。
xcelab.net/rmpubs/sr2/sta…
(ALTに私訳あり)
130
#統計 McElreathさんのStatistical Rethinkingの講義はミームのジョークを使いまくっており、ベイズvs.頻度についてはこんなのも使っています。
ベイズと頻度は闘うどころではない。
DAGを使った因果推論は実質必須。
github.com/rmcelreath/sta…
[1] Slides pp.8-9
speakerdeck.com/rmcelreath/sta…


ベイズと頻度は闘うどころではない。
DAGを使った因果推論は実質必須。
github.com/rmcelreath/sta…
[1] Slides pp.8-9
speakerdeck.com/rmcelreath/sta…
黒木玄 Gen Kuroki@genkuroki
#統計 添付画像はMcElreathさんのStatistical Rethinkingより。
問題: どうして「ベイズvs.頻度論」のゴジラとキングコングが因果推論犬を見て逃げ出したのか?
続く(佐藤俊哉さんもしまりす本の紹介)
github.com/rmcelreath/sta…
[1] Slides pp.8-9
speakerdeck.com/rmcelreath/sta…
問題: どうして「ベイズvs.頻度論」のゴジラとキングコングが因果推論犬を見て逃げ出したのか?
続く(佐藤俊哉さんもしまりす本の紹介)
github.com/rmcelreath/sta…
[1] Slides pp.8-9
speakerdeck.com/rmcelreath/sta…
131
#統計 精神的に歳を食い過ぎて新しいことを学んで合理的な考え方をできなくなったせいで、20世紀の杜撰な統計学観の考え方をばらまき続ける年寄りは年齢的にじきにいなくなります。
しかし、伝統を受け継ぐ若い後継者が再生産されると話は全然違って来る。そういう流れを断ち切ることは容易ではない。
しかし、伝統を受け継ぐ若い後継者が再生産されると話は全然違って来る。そういう流れを断ち切ることは容易ではない。
132
#統計 下手に「主義に基く統計学観」に染まるくらいなら、実践的入門書を読む方がずっと良いと思いました。続きとしてお勧めなのは
Statistical Rethinking xcelab.net/rm/
これはRを使っているのですが
Python実装 github.com/dustinstansbur…
も
動画 github.com/rmcelreath/sta…
もある。
Statistical Rethinking xcelab.net/rm/
これはRを使っているのですが
Python実装 github.com/dustinstansbur…
も
動画 github.com/rmcelreath/sta…
もある。
タランチュラ | データサイエンティスト@tarantula_ds_
@ML_deep ありがとうございます!
もし次のステップとしてベイズ系のオススメのものがあればぜひ教えていただきたいです🙇
もし次のステップとしてベイズ系のオススメのものがあればぜひ教えていただきたいです🙇
133
#統計
Statistical Rethinkingを学ぶと、主義に基く悪しき統計学観に染まらずに、真に実践的はベイズ統計の使い方を学べます。
R+Stan実装だけではなく、複数のPython実装とJulia実装がある。
ボーナスとして実践的に必須の統計的因果推論についても学べます。
Statistical Rethinkingを学ぶと、主義に基く悪しき統計学観に染まらずに、真に実践的はベイズ統計の使い方を学べます。
R+Stan実装だけではなく、複数のPython実装とJulia実装がある。
ボーナスとして実践的に必須の統計的因果推論についても学べます。
タランチュラ | データサイエンティスト@tarantula_ds_
@ML_deep ありがとうございます!
もし次のステップとしてベイズ系のオススメのものがあればぜひ教えていただきたいです🙇
もし次のステップとしてベイズ系のオススメのものがあればぜひ教えていただきたいです🙇
134
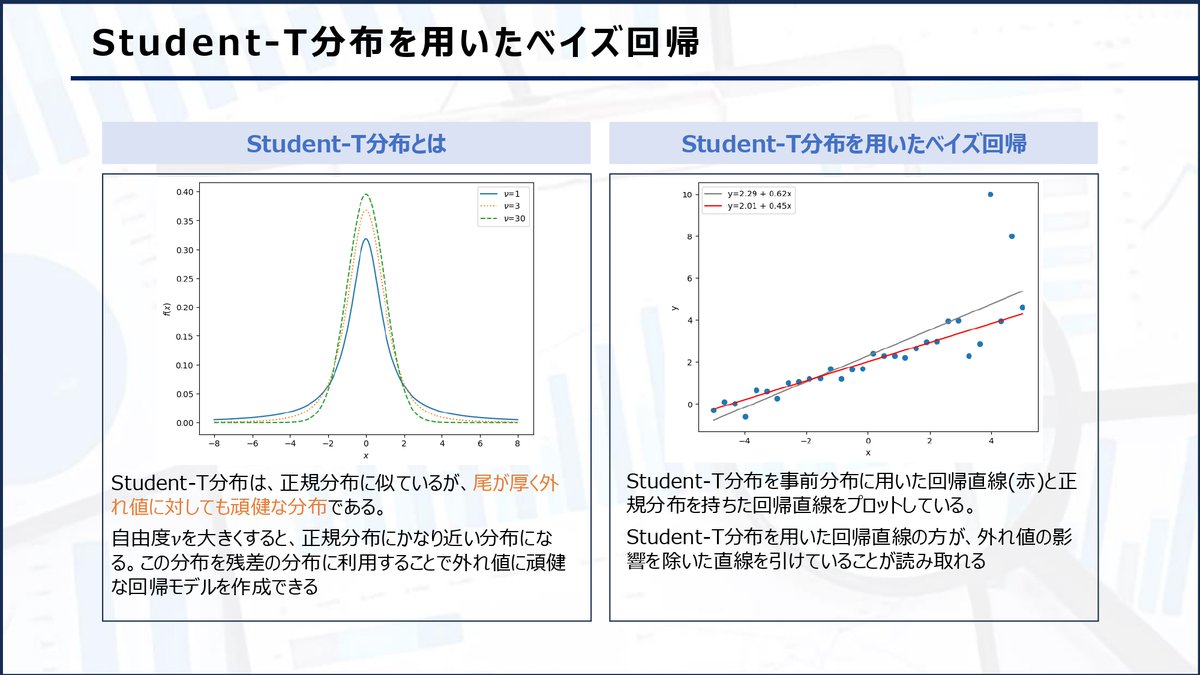
#統計 「残差の分布」と「事前分布」が違うものだと分かっているでしょうか?
自分で思い付いたこと以外については、参考にした文献をピンポイントで引用した方が良いと思いました。
あと、図の作成に使ったコードも公開した方がbetterです。今回のような場合に誤りを指摘してもらい易くなります。
自分で思い付いたこと以外については、参考にした文献をピンポイントで引用した方が良いと思いました。
あと、図の作成に使ったコードも公開した方がbetterです。今回のような場合に誤りを指摘してもらい易くなります。
タランチュラ | データサイエンティスト@tarantula_ds_
【Student-T分布を用いたベイズ回帰】
みんなStudent-T分布って知ってますか?
Student-T分布を残差の分布に用いると、外れ値に頑健な回帰モデルを作成できます。
事前分布に任意の確率分布を定義できるのがベイズの素晴らしいところですね!
みんなStudent-T分布って知ってますか?
Student-T分布を残差の分布に用いると、外れ値に頑健な回帰モデルを作成できます。
事前分布に任意の確率分布を定義できるのがベイズの素晴らしいところですね!
135
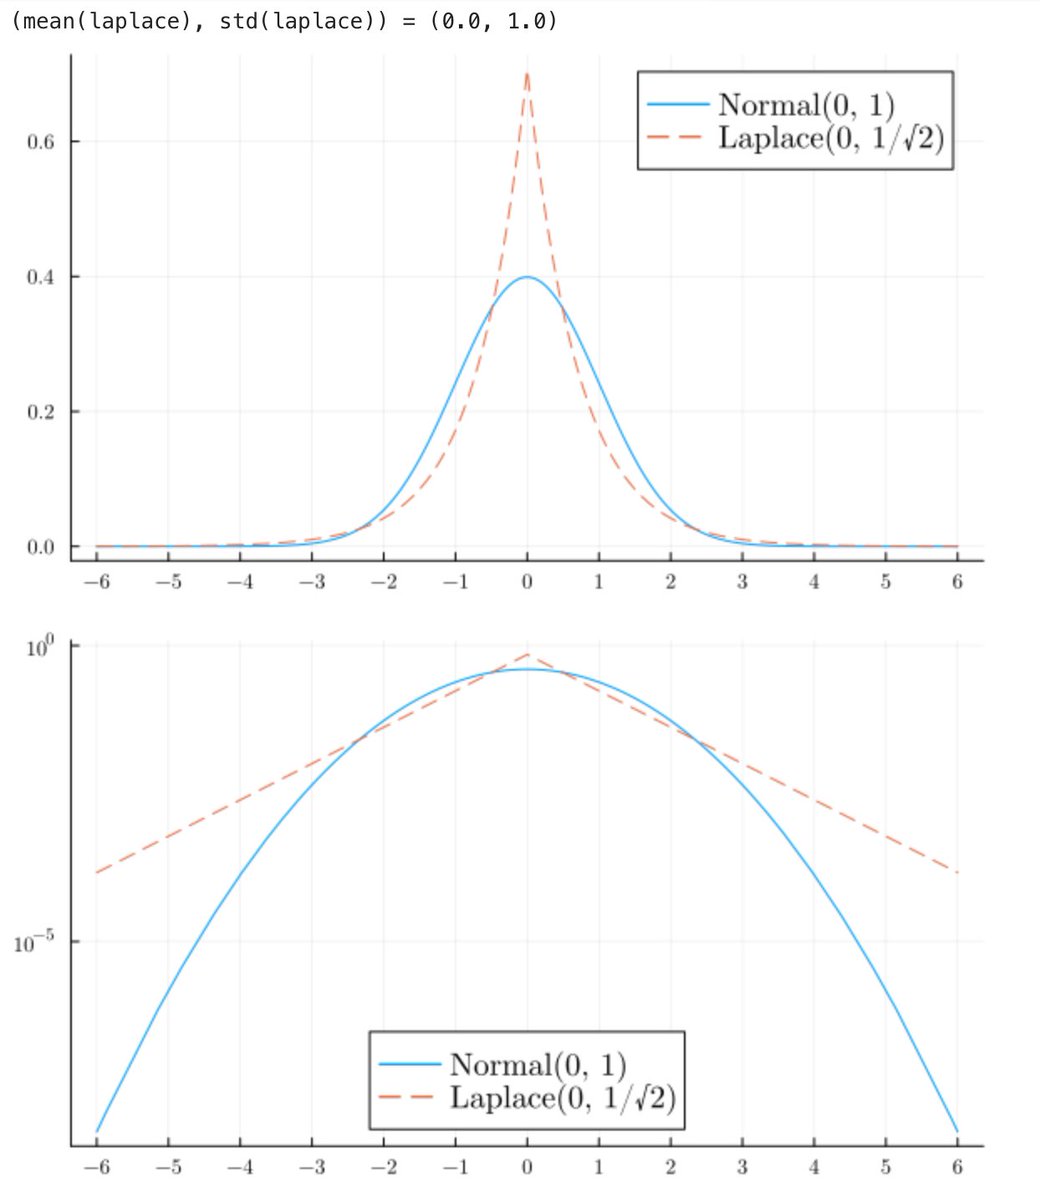
#統計 タランチュラさん、ラプラス分布の裾は正規分布より太いことが分かるグラフを提示しながら、「尾が薄いラプラス分布」のように説明するのはやめた方が良いと思います。
他にも色々おかしなことを次世代に拡散しようとしているように見えるのですが、全部にはコメントできません。続く


他にも色々おかしなことを次世代に拡散しようとしているように見えるのですが、全部にはコメントできません。続く
タランチュラ | データサイエンティスト@tarantula_ds_
【ラプラス事前分布によるLasso回帰】
ラプラス分布は正規分布よりも中心が尖った尾が薄い分布です。
Lasso回帰の事前分布に利用されることにとても納得できますね!
ラプラス分布は正規分布よりも中心が尖った尾が薄い分布です。
Lasso回帰の事前分布に利用されることにとても納得できますね!
136
#統計 #Julia言語 期待値と分散が等しい正規分布とLaplace分布の同時プロット。下段のグラフの縦軸は対数スケール。