#統計 いつも言っていることをそのまま書きます。長めのスレッドになります。 以下スクショによるスライドの引用は...

黒木玄 Gen Kuroki@genkuroki
64 views
Mar 03, 2025
~1 min read
Advertisement
1
#統計 いつも言っていることをそのまま書きます。長めのスレッドになります。
以下スクショによるスライドの引用は speakerdeck.com/shuntaros/jia-… より。赤字と青字は私による書き込みコメント。
まず、p.12について。詳しい解説に続く。


以下スクショによるスライドの引用は speakerdeck.com/shuntaros/jia-… より。赤字と青字は私による書き込みコメント。
まず、p.12について。詳しい解説に続く。
Sato Shuntaro|佐藤俊太朗@Shuntarooo3
たびたび話題になる仮説検定やP値について以前作成した資料を公開します(ぶっ込んでみます).端折るのは無理なので長いです.
こわいよーこわいよー
・検定を繰り返すことで発生する「多重性の問題」について,統計的に制御する方法と考え方で制御する方法をまとめた
shuntaro-sato.studio.site/blog/hypothesi…
こわいよーこわいよー
・検定を繰り返すことで発生する「多重性の問題」について,統計的に制御する方法と考え方で制御する方法をまとめた
shuntaro-sato.studio.site/blog/hypothesi…
2
#統計 「違いがない」の型の帰無仮説のP値をnull P値と呼びます。
null P値は「違いは○○である」の型の仮説に関する無数のP値の特別な場合で、null P値へのこだわりは悪しきnullismである云々とGreenlandさんは言っています。
biostat.ucdavis.edu/sites/g/files/…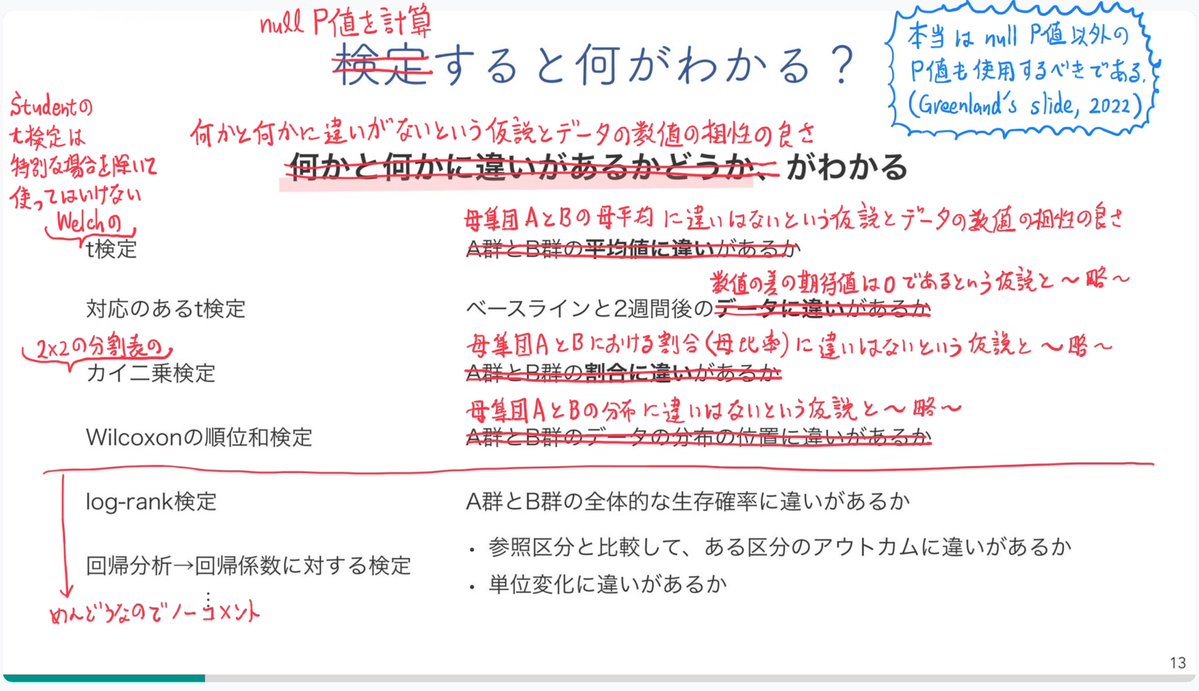
null P値は「違いは○○である」の型の仮説に関する無数のP値の特別な場合で、null P値へのこだわりは悪しきnullismである云々とGreenlandさんは言っています。
biostat.ucdavis.edu/sites/g/files/…
3
#統計 平たく言えば、「違いがない」の型の帰無仮説を「null P値<α」という条件によって棄却して「違いはある」という結論を出すためにP値を単純に使うことはP値の誤用の典型例であり、科学のプロセスを害しています。
biostat.ucdavis.edu/sites/g/files/…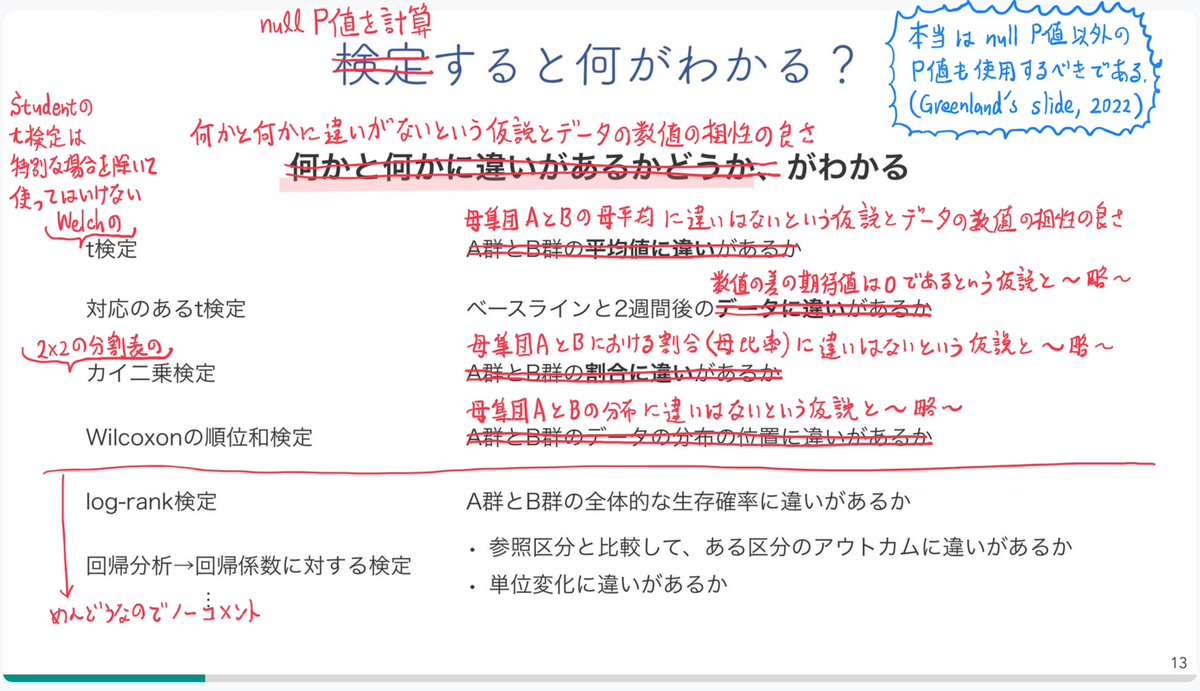
biostat.ucdavis.edu/sites/g/files/…
4
#統計 医療関係者達にはP値を積極的に誤用させる教育が長年されて来たように見えます。
多くの人にとってのデフォルトの知識は、P値を誤用することをまともな統計分析だと信じることである可能性が高く、どう解決したら良いのかさっぱりわからない大問題。
多くの人にとってのデフォルトの知識は、P値を誤用することをまともな統計分析だと信じることである可能性が高く、どう解決したら良いのかさっぱりわからない大問題。
5
#統計 「A群」という言い方は曖昧であり、「A側のデータの数値の集まり」と「A側の母集団」のどちらの意味なのか分かりにくい。
常に「母集団A」と書いたり、「A群はA側の母集団を意味する」のような但し書きを入れるべきだと思います。
統計分析で興味があるのは未知の母集団の様子。続く
常に「母集団A」と書いたり、「A群はA側の母集団を意味する」のような但し書きを入れるべきだと思います。
統計分析で興味があるのは未知の母集団の様子。続く
6
#統計 特殊な場合を除けば、等母分散からの逸脱について脆弱なStudentのt検定ではなく、Welchのt検定を使うべき。
2標本t検定達は、標本平均の差ではなく、母集団の平均(母平均)の差に関する検定法。任意の数値aについて「差=a」のP値が定義される。
2標本t検定達は、標本平均の差ではなく、母集団の平均(母平均)の差に関する検定法。任意の数値aについて「差=a」のP値が定義される。
7
#統計 対応のあるt検定は、例えば「ベースラインの値と投薬後の値の差の期待値μ_Δは0である」という帰無仮説に関する検定法です。
具体的な数値aに関する「μ_Δ=a」の形の仮説のP値も同時に定義されます。
具体的な数値aに関する「μ_Δ=a」の形の仮説のP値も同時に定義されます。
8
#統計 Wilcoxonの順位和検定を「分布の位置」の違いに関する検定法だとみなすためには、
2つの母集団分布の累積分布関数F(x), G(y)についてある定数aでF(x)=G(y+a)を満たすものが存在する
という仮定を使います。しかし、この仮定の成立は現実では期待できないし、保証不可能な条件でしょう。続く
2つの母集団分布の累積分布関数F(x), G(y)についてある定数aでF(x)=G(y+a)を満たすものが存在する
という仮定を使います。しかし、この仮定の成立は現実では期待できないし、保証不可能な条件でしょう。続く
9
#統計 だから、たとえ教科書にそうだと書いてあったとしても、実践的には、Wilcoxonの順位和検定は「分布の位置」の違いに関する検定法では__ない__と教えるべきです。
Wilcoxonの順位和検定のP値は「2つの母集団分布はぴったり等しい」という仮定の下で計算されます。続く
Wilcoxonの順位和検定のP値は「2つの母集団分布はぴったり等しい」という仮定の下で計算されます。続く
10
#統計 だから、Wilcoxonの順位和検定は「2つの母集団分布はぴったり等しい」という超絶強い帰無仮説に関する検定法だとみなすことはできます。
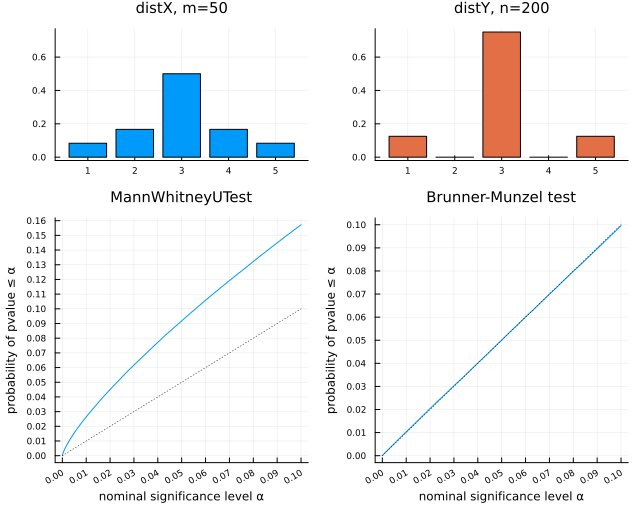
実際、2つの母集団分布の母平均、母中央値、母分散、母歪度が等しくても母尖度が違うせいで有意差が出易くなったりします。続く

実際、2つの母集団分布の母平均、母中央値、母分散、母歪度が等しくても母尖度が違うせいで有意差が出易くなったりします。続く
黒木玄 Gen Kuroki@genkuroki
#統計 添付画像のグラフで示されている分布distXとdistYの中央値と平均値はともに3で互いに等しいです。
どちらも左右対称なので、歪度はともに0で互いに等しい。
実はどちらの分散も1で互いに等しくなるように調節してあります。
(過剰)尖度はそれぞれ0と1で互いに等しくない。
どちらも左右対称なので、歪度はともに0で互いに等しい。
実はどちらの分散も1で互いに等しくなるように調節してあります。
(過剰)尖度はそれぞれ0と1で互いに等しくない。
11
#統計 Wilcoconの順位和検定は2つの母集団の間に優劣をつけるための検定法としては、Studentのt検定と同様な感じで、脆弱な検定法になり、実践的にどのように安全に使えるのかよく分からない検定法になっています。続く

12
#統計 しかし現実には、Wilcoconの順位和検定(=Mann-WhitneyのU検定)は非常に安易に使われており、かなりの割合で誤用されているものと思われます。この点は過去の教育の負の遺産です。相当に酷いことになっている。
代わりに非常に頑健なBrunner-Munzel検定を使うべきです。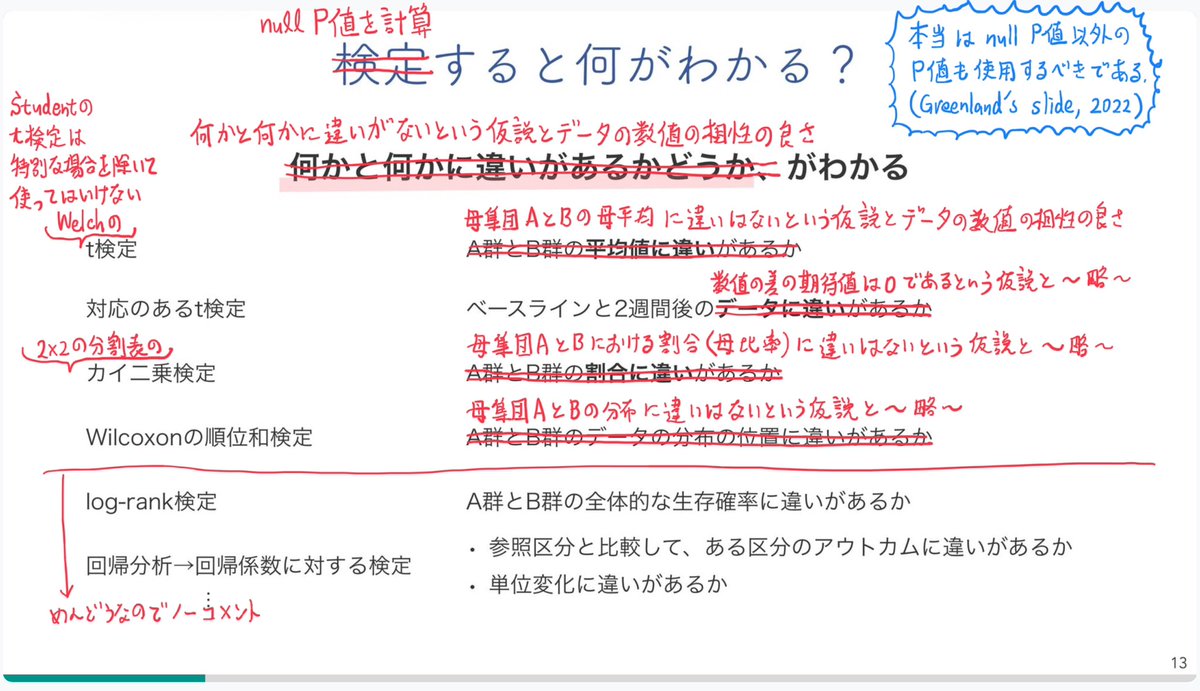
代わりに非常に頑健なBrunner-Munzel検定を使うべきです。
13
#統計 p.18, p.30
『統計的有意性とP値に関するASA声明』翻訳版での「矛盾する程度」は原文では"how incompatible"で、"how inconsistent"ではありません。
P値で矛盾は示せないので「矛盾する程度」と翻訳するのはやめた方が良いと私は思います。私は「相性の悪さの程度」という翻訳を提案。続く

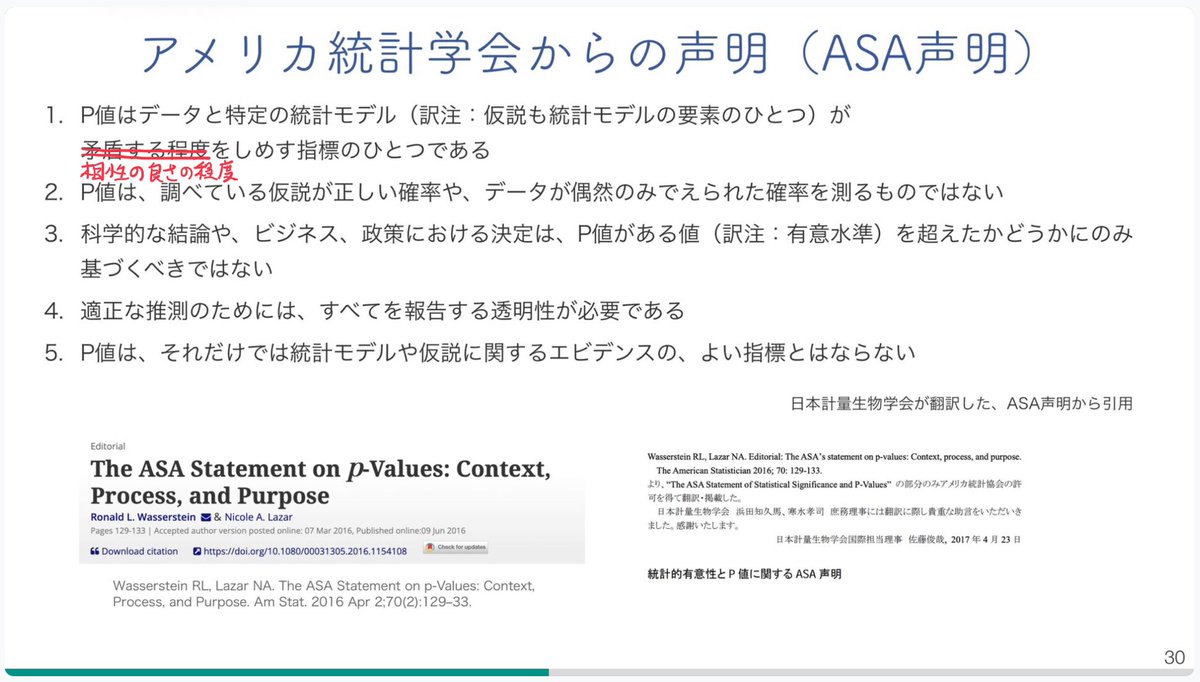
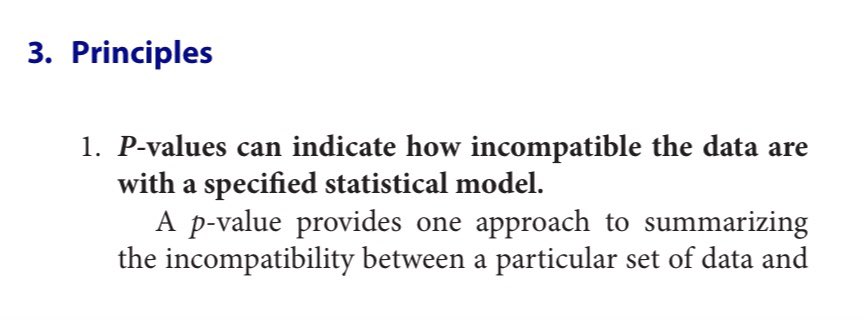
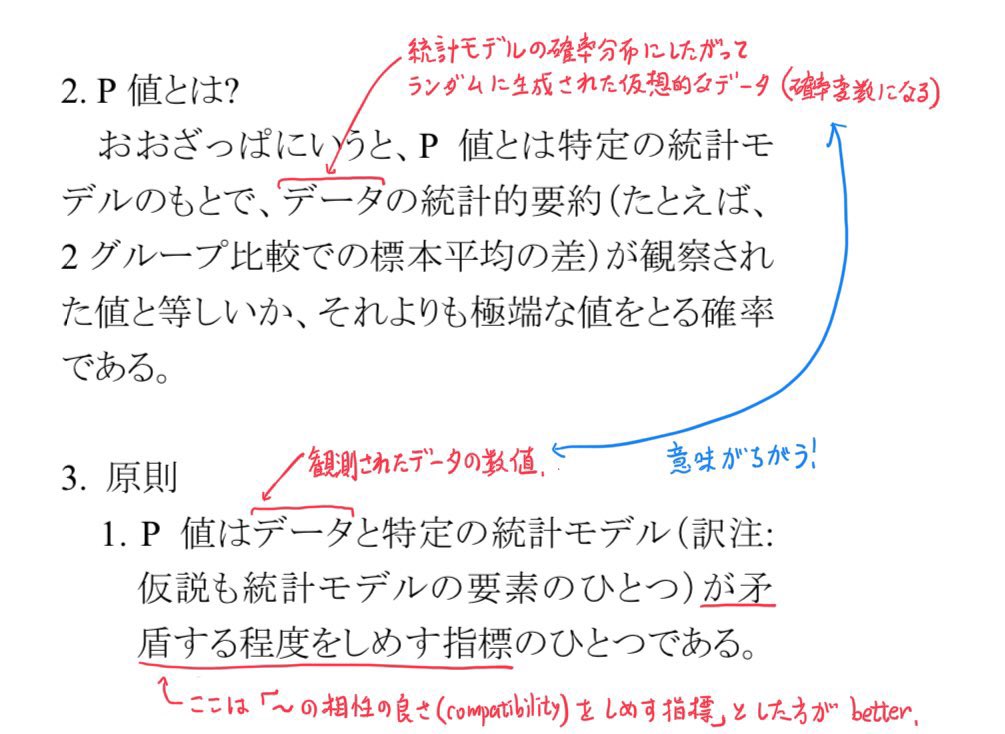
『統計的有意性とP値に関するASA声明』翻訳版での「矛盾する程度」は原文では"how incompatible"で、"how inconsistent"ではありません。
P値で矛盾は示せないので「矛盾する程度」と翻訳するのはやめた方が良いと私は思います。私は「相性の悪さの程度」という翻訳を提案。続く
黒木玄 Gen Kuroki@genkuroki
#統計 ASA声明の原文は scholar.google.co.jp/scholar?cluste… 経由で読めます。その原則の1に原文は
1. P-values can indicate how incompatible the data are with a specified statistical model.
です。incompatibleという単語の翻訳は難しい。佐藤俊哉さんはhow incompatibleを「矛盾する程度」と翻訳。続く
1. P-values can indicate how incompatible the data are with a specified statistical model.
です。incompatibleという単語の翻訳は難しい。佐藤俊哉さんはhow incompatibleを「矛盾する程度」と翻訳。続く
14
#統計 P値は大きいほどcompatibleになる指標なので、原文も素直に"how compatible"とすれば分かり易かった。日本語では
P値はデータの数値と統計モデルと検定したい仮説の組み合わせの相性の良さの程度を示す指標の1つである
のように説明すればぴったりだと思います。


P値はデータの数値と統計モデルと検定したい仮説の組み合わせの相性の良さの程度を示す指標の1つである
のように説明すればぴったりだと思います。
黒木玄 Gen Kuroki@genkuroki
#統計 ASA声明の原文は scholar.google.co.jp/scholar?cluste… 経由で読めます。その原則の1に原文は
1. P-values can indicate how incompatible the data are with a specified statistical model.
です。incompatibleという単語の翻訳は難しい。佐藤俊哉さんはhow incompatibleを「矛盾する程度」と翻訳。続く
1. P-values can indicate how incompatible the data are with a specified statistical model.
です。incompatibleという単語の翻訳は難しい。佐藤俊哉さんはhow incompatibleを「矛盾する程度」と翻訳。続く
15
#統計 p.23
P値単体では矛盾を出す能力はありません。
データ外かつモデル外の知識や特別な状況を利用しないと、P値<αという条件によって、危険率を十分に制御した判断は不可能です。
この点を押さえないと、P値の誤用は決してなくならないでしょう。続く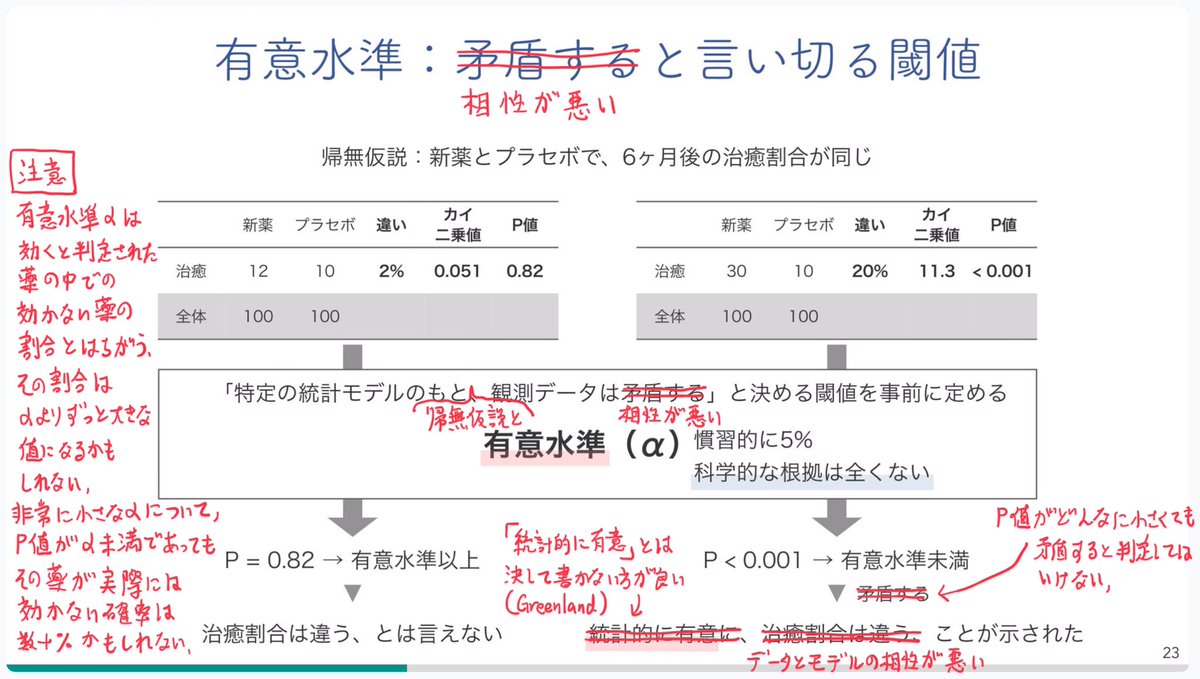
P値単体では矛盾を出す能力はありません。
データ外かつモデル外の知識や特別な状況を利用しないと、P値<αという条件によって、危険率を十分に制御した判断は不可能です。
この点を押さえないと、P値の誤用は決してなくならないでしょう。続く
16
#統計 例えば、「P値<α」という条件によって「薬は効かない」という帰無仮説を棄却して「薬は効く」と判定する状況を考えましょう。
このとき気になるのは、そのようにして「効く」と判定された薬達の中に実際には効かない薬がどの程度の割合で含まれてしまうかです。その割合が大きいなら危険。続く
このとき気になるのは、そのようにして「効く」と判定された薬達の中に実際には効かない薬がどの程度の割合で含まれてしまうかです。その割合が大きいなら危険。続く
17
#統計 例えば、仮にすでに相当に吟味した薬達だけをテストするならば、テストする薬達の半分は効き目があるとしてよいでしょう。
その場合に、有意水準5%、検出力80%の両側検定のいつもの設定で、「効く」と判定された薬達の中での実際には効かない薬の割合は3%程度に抑えられます。
しかし~続く

その場合に、有意水準5%、検出力80%の両側検定のいつもの設定で、「効く」と判定された薬達の中での実際には効かない薬の割合は3%程度に抑えられます。
しかし~続く
黒木玄 Gen Kuroki@genkuroki
#統計 だから、効くと判定された薬に限定したときの効かない薬であることの条件付き確率は
0.025(1-p) / (0.8p + 0.025(1-p)).
p=50%, 10%, 5%, 1%についてこの値を計算すると、それぞれ
3%、22%、37%、76%
になります。続く
0.025(1-p) / (0.8p + 0.025(1-p)).
p=50%, 10%, 5%, 1%についてこの値を計算すると、それぞれ
3%、22%、37%、76%
になります。続く
18
#統計 しかし、テストする薬達の5%しか効き目がない場合には、同設定で、「効く」と判定された薬達の中での実際には効かない薬の割合は37%に跳ね上がります。
このように、P値<αという条件による判定の実践的有効性は、テストする薬の中での効く薬の割合に大きく依存します。
このように、P値<αという条件による判定の実践的有効性は、テストする薬の中での効く薬の割合に大きく依存します。
黒木玄 Gen Kuroki@genkuroki
#統計 だから、効くと判定された薬に限定したときの効かない薬であることの条件付き確率は
0.025(1-p) / (0.8p + 0.025(1-p)).
p=50%, 10%, 5%, 1%についてこの値を計算すると、それぞれ
3%、22%、37%、76%
になります。続く
0.025(1-p) / (0.8p + 0.025(1-p)).
p=50%, 10%, 5%, 1%についてこの値を計算すると、それぞれ
3%、22%、37%、76%
になります。続く
19
#統計 P値<αという条件だけで単純に判断することは、科学の信頼を損なうために非常に有効な方法になります。絶対にやめなければいけない。続く
20
#統計 現実社会での薬の承認制度は第1,2,3相の多段階治験をすべてクリアさせる非常に厳しい試練を課しています。
最終の第3相治験に入る前までにテストしている薬達のうち半分以上が効く薬ならば、第3相の主要評価項目の成否を「P値<α」という条件で判断しても安全性はかなり高くなる。
最終の第3相治験に入る前までにテストしている薬達のうち半分以上が効く薬ならば、第3相の主要評価項目の成否を「P値<α」という条件で判断しても安全性はかなり高くなる。
21
#統計 「P値<5%」という条件で「薬は効く」と判断することは、仮説検定に関わる諸々がすべて理想的になっていたとしても、テストする薬達の中で効く薬の割合が半分以上でなければ危ない、と考える必要があります。
仮説検定は理想的に使ってもそういう制限が入ります。続く
仮説検定は理想的に使ってもそういう制限が入ります。続く
22
#統計 研究では「驚くべき仮説が示された!」と言える結果を出したほうがうれしいので、テストされる(対立)仮説達の中で本当に正しいものの割合は小さくなる可能性が高くなるように私は思います。
実際にそうなら5%の有意水準はザルで発表された統計的有意な結果の数十%は再現不可能になるでしょう。
実際にそうなら5%の有意水準はザルで発表された統計的有意な結果の数十%は再現不可能になるでしょう。
23
#統計 おそらくそういうことは特定の分野達で実際に起こっています。
所謂「再現性の危機」の話。
p-hackingやHARKingなどの不正を防いでも、幾らでも「再現性の危機」は発生しそうです。ベイズ統計を使っても同じことになります。
所謂「再現性の危機」の話。
p-hackingやHARKingなどの不正を防いでも、幾らでも「再現性の危機」は発生しそうです。ベイズ統計を使っても同じことになります。
黒木玄 Gen Kuroki@genkuroki
#統計 上の計算例を見れば、
テストする示したい(対立)仮説が正しい確率p
がどの程度の大きさであるかが非常に重要だと分かります。
この確率pはベイズ統計的には「真の事前確率」とでも呼ぶべきものであることから、ベイズ統計を使っても同様の問題が発生しそうだと分かります。続く
テストする示したい(対立)仮説が正しい確率p
がどの程度の大きさであるかが非常に重要だと分かります。
この確率pはベイズ統計的には「真の事前確率」とでも呼ぶべきものであることから、ベイズ統計を使っても同様の問題が発生しそうだと分かります。続く
24
#統計 p.25
このページのような説明をするくらいなら、null P値だけではなく、信頼区間も使って説明した方が良かったと思いました。
同じくnull P値≥αであっても、信頼区間の幅が広い場合と、null値付近に狭く集中している場合では大違いです。
このページのような説明をするくらいなら、null P値だけではなく、信頼区間も使って説明した方が良かったと思いました。
同じくnull P値≥αであっても、信頼区間の幅が広い場合と、null値付近に狭く集中している場合では大違いです。
25
#統計 p.26
このページの説明はまるっきりナンセンスです。
P値が小さいことと差が大きいことが無関係なことは、FisherとNeyman-Pearsonの違いと関係ありません。
素直に信頼区間を使った説明をした方が良かったと思います。(個人的には信頼区間よりもP値関数を使った方がずっと良いと思いますが)
このページの説明はまるっきりナンセンスです。
P値が小さいことと差が大きいことが無関係なことは、FisherとNeyman-Pearsonの違いと関係ありません。
素直に信頼区間を使った説明をした方が良かったと思います。(個人的には信頼区間よりもP値関数を使った方がずっと良いと思いますが)
26
#統計 p.20, p.29
もしもp.20の意味で「サンプルサイズを大きくすると~P値は小さくなる」ことを理由に、p.29で「サンプルサイズを無視してP値の計算をおこなっている」を悪いことの例として挙げているならナンセンスです。続く


もしもp.20の意味で「サンプルサイズを大きくすると~P値は小さくなる」ことを理由に、p.29で「サンプルサイズを無視してP値の計算をおこなっている」を悪いことの例として挙げているならナンセンスです。続く
Sato Shuntaro|佐藤俊太朗@Shuntarooo3
・考え方の制御に記載した「統計的な意味より臨床的な意味を大事にしよう」,「研究・仮説の位置づけを明確にしよう」は特に強調したい
・統計的に有意でない場合,多重性の制御(制御しない場合も)についての論文記載をまとめた
speakerdeck.com/shuntaros/jia-…
・統計的に有意でない場合,多重性の制御(制御しない場合も)についての論文記載をまとめた
speakerdeck.com/shuntaros/jia-…
27
#統計 添付画像の場合に、データ内での比率を保ったままサンプルサイズを大きくすれば、P値が小さくなるすることは当たり前です。
データ内での比率を保つという条件によって、母集団分布について何も考えずに、そういうそういう当たり前のことを言っても無意味だと思います。続く
データ内での比率を保つという条件によって、母集団分布について何も考えずに、そういうそういう当たり前のことを言っても無意味だと思います。続く
28
#統計 未知の母集団分布を考慮すれば、サンプルサイズを大きくすれば、データ内での比率は大数の法則によって母集団での母比率に近付きます。
2つの母比率が等しいなら、サンプルサイズを増やしてもP値の分布は一様分布に近いままになります。続く
2つの母比率が等しいなら、サンプルサイズを増やしてもP値の分布は一様分布に近いままになります。続く
29
#統計 2つの母比率が等しくないなら、サンプルサイズnを大きくすると、P値の分布は0側にどんどん偏って行き、n→∞では0に集中するようになります。続く
30
#統計 2つの母比率は等しくないが、医療的に無意味なほど小さい場合にも、サンプルサイズn→∞でP値(正確にはnull P値)の分布は0に集中するようになりますが、そこまでnを大きくできることは稀でしょう。
31
#統計 以上のように、きちんと母集団分布を想定してサンプルサイズを大きくしたときに何が起こるかを理解しておくのは大事なことだと思います。
しかし、母集団分布を想定せずに、データ中での割合を保ったままサンプルサイズを大きくしても当たり前のつまらない結果が得られるだけです。
しかし、母集団分布を想定せずに、データ中での割合を保ったままサンプルサイズを大きくしても当たり前のつまらない結果が得られるだけです。
32
#統計 柳川堯著『P値』のp.22にも、データ内比率を一定に保ったままサンプルサイズを大きくするとP値が小さくなる話が書いてあり、P値の誤用と結び付けるナンセンスな議論が書いてあります。

黒木玄 Gen Kuroki@genkuroki
#統計 柳川堯著『P値』のp.22より
割合は等しいが標本サイズは違う2つの分割表のデータについて、片方のP値は36%でもう一方のP値が1.4%であることについて
【矛盾した判定結果】
【サンプルサイズを無視してP値を有意水準5%で判定すると,このような誤用が起こる】
と説明するのは酷すぎ。続く
割合は等しいが標本サイズは違う2つの分割表のデータについて、片方のP値は36%でもう一方のP値が1.4%であることについて
【矛盾した判定結果】
【サンプルサイズを無視してP値を有意水準5%で判定すると,このような誤用が起こる】
と説明するのは酷すぎ。続く
33
#統計 このスレッドの内容は、いつも言っていることの繰り返しにすぎません。だから、
from:genkuroki
付きで適当なキーワードを検索すれば関連のより詳しい内容の発言が見つかる場合は多いと思います。
from:genkuroki
付きで適当なキーワードを検索すれば関連のより詳しい内容の発言が見つかる場合は多いと思います。
34
#統計
現代的なP値に関する考え方の学習のためのお勧めコース
(普及しているよろしくない考え方を防衛せずにきれいさっぱり捨てる決心があれば非常に易しい内容です。)
↓
現代的なP値に関する考え方の学習のためのお勧めコース
(普及しているよろしくない考え方を防衛せずにきれいさっぱり捨てる決心があれば非常に易しい内容です。)
↓
黒木玄 Gen Kuroki@genkuroki
#統計 P値に関するお勧めのコースは
①統計的有意性とP値に関するASA声明にざっと目を通して、翻訳者の佐藤俊哉さんの講義動画を視聴する。
②佐藤俊哉著『統計よりも重要なことを学ぶ』の第1話や『ロスマンの疫学第2版』の第8章を読む。
③オプション: Greenlandさんの講義スライドを読む。
①統計的有意性とP値に関するASA声明にざっと目を通して、翻訳者の佐藤俊哉さんの講義動画を視聴する。
②佐藤俊哉著『統計よりも重要なことを学ぶ』の第1話や『ロスマンの疫学第2版』の第8章を読む。
③オプション: Greenlandさんの講義スライドを読む。
35
#統計
P値を null-hyporhesis significance testing (NHST、差がないという帰無仮説を扱う有意差を示すための検定)のための道具であるかのように説明する不適切な行為
と
Studentのt検定とMann-WhitneyのU検定の不適切な使い方を教える行為
はもはや伝統になっている。崩すことは非常に困難。

P値を null-hyporhesis significance testing (NHST、差がないという帰無仮説を扱う有意差を示すための検定)のための道具であるかのように説明する不適切な行為
と
Studentのt検定とMann-WhitneyのU検定の不適切な使い方を教える行為
はもはや伝統になっている。崩すことは非常に困難。
黒木玄 Gen Kuroki@genkuroki
#統計 他の事例
丹後俊郎『統計学のセンス』(1998)でのWilcoxonの順位和検定(=Mann-WhitneyのU検定)の勧め方(再掲)
Studentのt検定が図の(b)(c)の場合に信頼できなくなったりするという理由でWの順位和検定を勧めている!
これは致命的な誤り!
(b)(c)の場合にWの順位和検定を使ってはいけない。
丹後俊郎『統計学のセンス』(1998)でのWilcoxonの順位和検定(=Mann-WhitneyのU検定)の勧め方(再掲)
Studentのt検定が図の(b)(c)の場合に信頼できなくなったりするという理由でWの順位和検定を勧めている!
これは致命的な誤り!
(b)(c)の場合にWの順位和検定を使ってはいけない。
36
分岐

黒木玄 Gen Kuroki@genkuroki
「P値が小さければ小さいほど、データとモデルの相性が悪い」は正しい。
誤りなのは「null P値が小さければ小さいほど、差が大きい」の方。
「差が0」という仮説のP値(null P値)が同じように小さくても、差の信頼区間が0に近い場合と、差の信頼区間が0から遠くまで広がっている場合の両方がある。
誤りなのは「null P値が小さければ小さいほど、差が大きい」の方。
「差が0」という仮説のP値(null P値)が同じように小さくても、差の信頼区間が0に近い場合と、差の信頼区間が0から遠くまで広がっている場合の両方がある。
37
#統計 分岐
P値の誤用に関する話題の分脈などで、「Fisher vs. Neyman-Pearson」の話が出て来たら警戒する必要がある。
非常に残念なことに、戯画化されたNeyman-Pearsonの説明は伝統的に定番のネタになっている。
P値の誤用に関する話題の分脈などで、「Fisher vs. Neyman-Pearson」の話が出て来たら警戒する必要がある。
非常に残念なことに、戯画化されたNeyman-Pearsonの説明は伝統的に定番のネタになっている。
黒木玄 Gen Kuroki@genkuroki
#統計 統計学教育の分野には、戯画化されたNeyman-Pearsonについて語る人が多い(伝統芸のようになっている!)という深刻な問題があるので、「Fisher vs. Neyman-Pearson」の話を始める人を見かけたら、危険信号が点滅していると判断した方が良いです。
伝統の多くを潰す必要があるが、困難。続く
伝統の多くを潰す必要があるが、困難。続く
38
#統計 おそらく、これが伝統的なP値や検定法に関する教え方が改善されない理由の1つ。
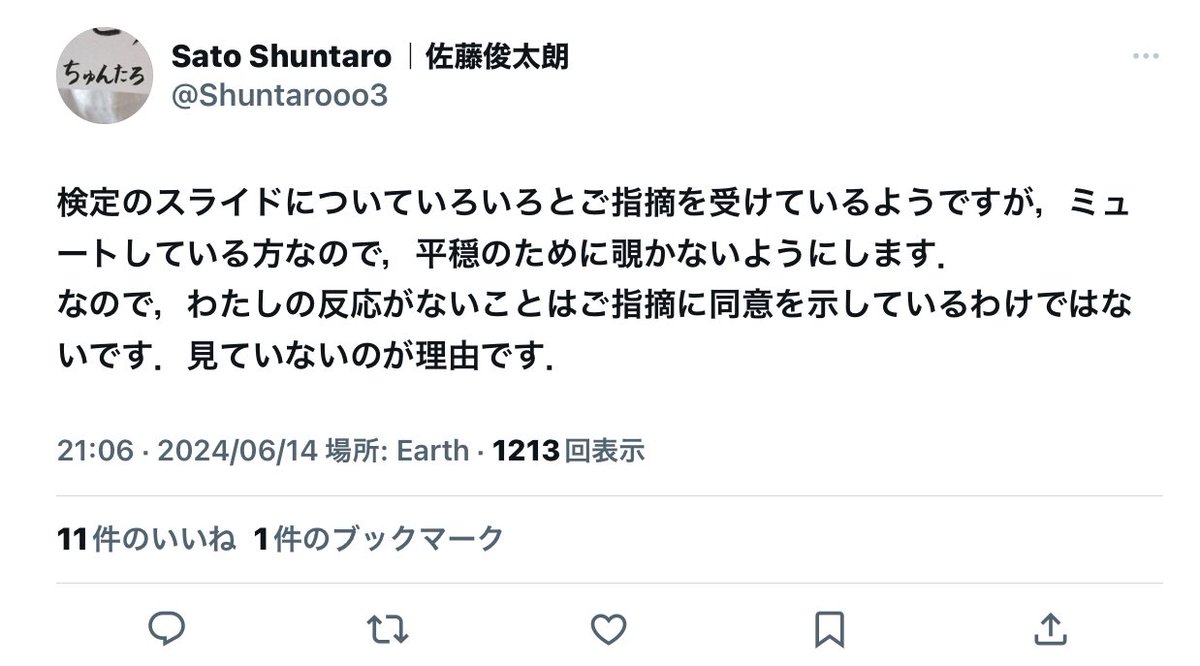
Sato Shuntaro|佐藤俊太朗@Shuntarooo3
検定のスライドについていろいろとご指摘を受けているようですが,ミュートしている方なので,平穏のために覗かないようにします.
なので,わたしの反応がないことはご指摘に同意を示しているわけではないです.見ていないのが理由です.
なので,わたしの反応がないことはご指摘に同意を示しているわけではないです.見ていないのが理由です.
39
#統計 相互リンク
40
#統計 相互リンク2