#統計...

黒木玄 Gen Kuroki@genkuroki
66 views
Mar 03, 2025
~4 min read
Advertisement
1
#統計 【ざっくりいえば、p値(p-value)は「ある結論が、実はただの勘違いである可能性」と解釈できる。(小声でいうと、小さい方がうれしい)】
という説明は、杜撰なP値の説明そのものに見えました。「ざっくり」は言い訳にならない。
具体例による説明の試みは悪くないと思いました。
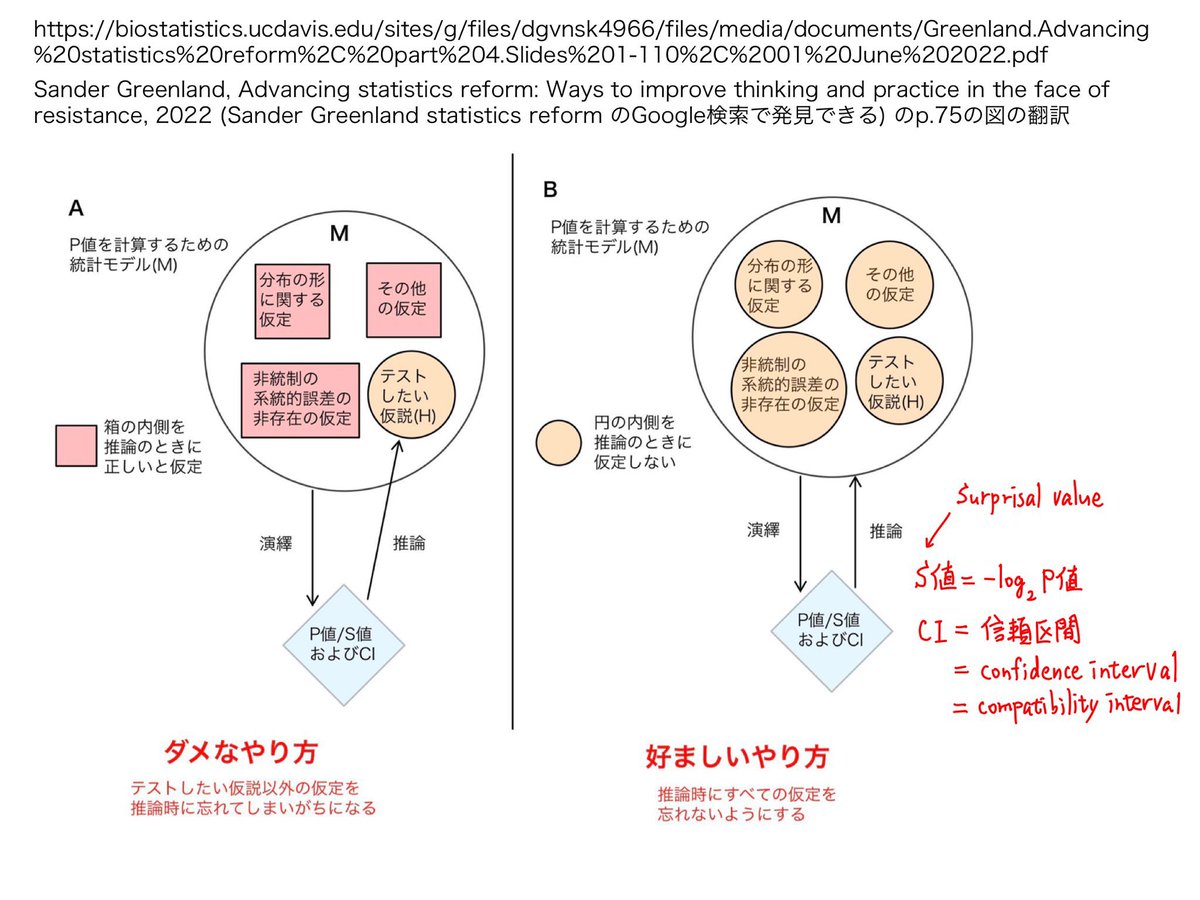
解説に続く


という説明は、杜撰なP値の説明そのものに見えました。「ざっくり」は言い訳にならない。
具体例による説明の試みは悪くないと思いました。
解説に続く
竹内幹@takekan
「p値」って何といわれて全く答えられない人に、計量経済入門の単位とか認定しちゃだめだよなあ、と思っている。
ざっくりいえば、p値(p-value)は「ある結論が、実はただの勘違いである可能性」と解釈できる。(小声でいうと、小さい方がうれしい)
例えば、学生グループAとBのテストの成績差。
ざっくりいえば、p値(p-value)は「ある結論が、実はただの勘違いである可能性」と解釈できる。(小声でいうと、小さい方がうれしい)
例えば、学生グループAとBのテストの成績差。
2
#統計 統計学を教える仕事をする人は
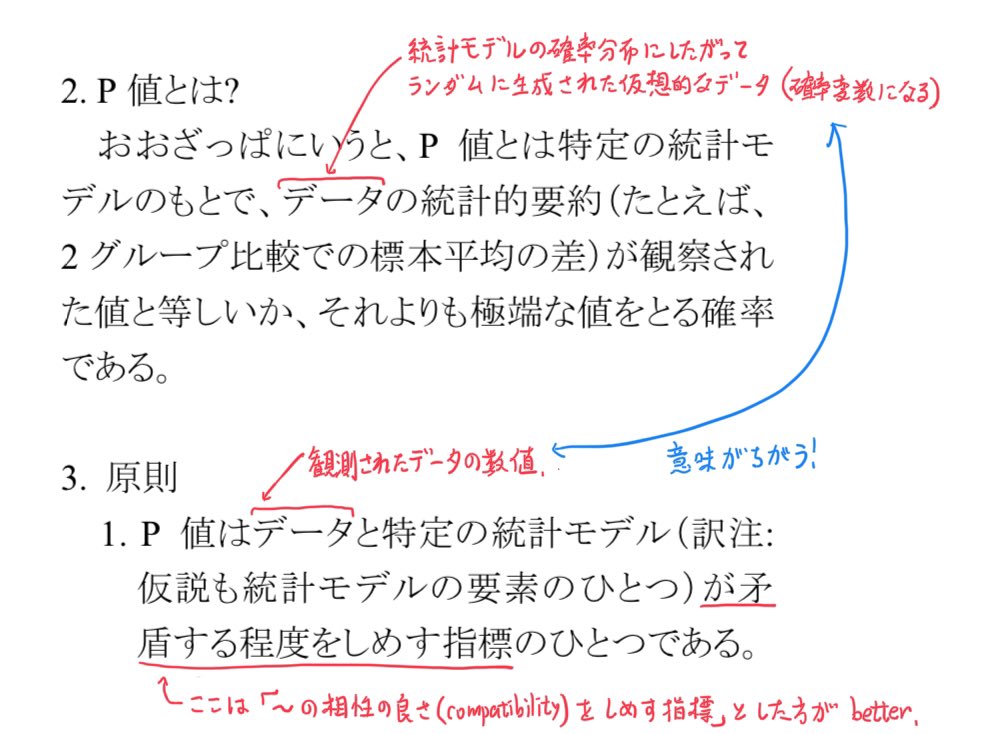
統計的有意性とP値に関するASA声明
biometrics.gr.jp/news/all/ASA
には目を通しておいた方が無難。
これを読めば、P値に関する実践的に十分な説明と解釈法が得られます。
ただし添付画像への追記部分に注意することも必要。
統計的有意性とP値に関するASA声明
biometrics.gr.jp/news/all/ASA
には目を通しておいた方が無難。
これを読めば、P値に関する実践的に十分な説明と解釈法が得られます。
ただし添付画像への追記部分に注意することも必要。
3
#統計 「統計的有意性とP値に関するASA声明」の翻訳者の佐藤俊哉先生による素晴らしい講義動画もよく紹介されています。これも統計学を教える仕事をする人は視聴しておいた方がよい。教科書に誤りが書いてあることを明瞭に説明している。教科書通りに講義をしてはいけない。
youtu.be/vz9cZnB1d1c?si…


youtu.be/vz9cZnB1d1c?si…
黒木玄 Gen Kuroki@genkuroki
#統計 大賛成。
初学者が検索しやすいようにP値関数、P-value functionというキーワードや『ロスマンの疫学第2版』のような書名やGreenlandさんの名前も挙げると親切。
佐藤俊哉さんは講義動画でWaldの信頼区間がよくある誤解の原因になっていそうだと言っています。
youtu.be/vz9cZnB1d1c?si…
初学者が検索しやすいようにP値関数、P-value functionというキーワードや『ロスマンの疫学第2版』のような書名やGreenlandさんの名前も挙げると親切。
佐藤俊哉さんは講義動画でWaldの信頼区間がよくある誤解の原因になっていそうだと言っています。
youtu.be/vz9cZnB1d1c?si…
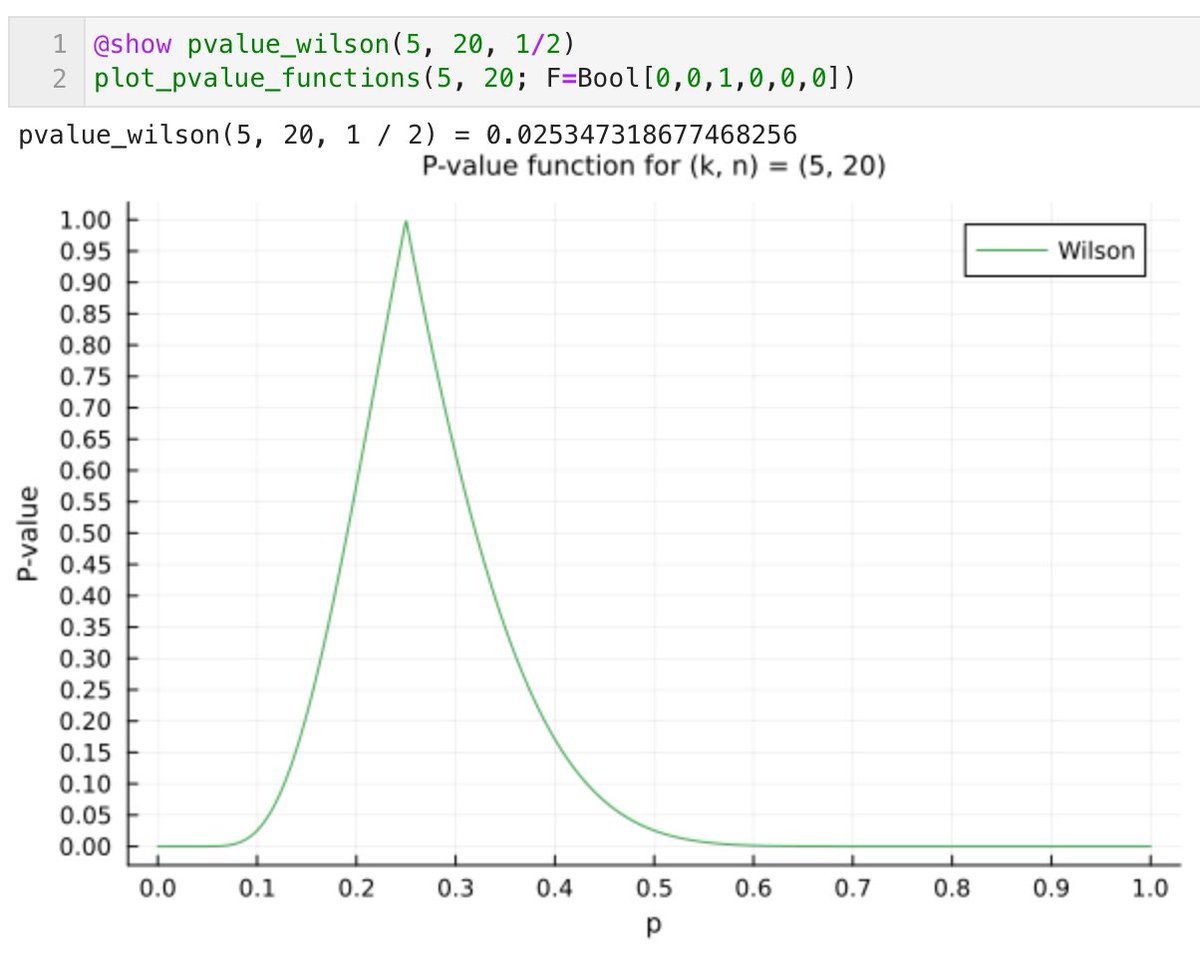
4
#統計 P値は、大雑把には、
観察されたデータの数値以上に極端な値が、検定したい仮説の下でのモデル内確率分布に従って生成される確率もしくはその近似値。
尤度の定義は、
観察されたデータの数値と同じ数値が、モデル内確率分布に従って生成される確率またはその密度。
混同させる説明が多い。
観察されたデータの数値以上に極端な値が、検定したい仮説の下でのモデル内確率分布に従って生成される確率もしくはその近似値。
尤度の定義は、
観察されたデータの数値と同じ数値が、モデル内確率分布に従って生成される確率またはその密度。
混同させる説明が多い。
5
#統計 P値も尤度(ゆうど)も、
観察されたデータの数値とモデル+パラメータの値の設定の相性の良さ(compatibility)の指標
として使われます。
「相性の良さ」の代わりに「整合性」や「適合度」のように言ってもよい。「相性の良さ」は過信を防ぐための言い方。
観察されたデータの数値とモデル+パラメータの値の設定の相性の良さ(compatibility)の指標
として使われます。
「相性の良さ」の代わりに「整合性」や「適合度」のように言ってもよい。「相性の良さ」は過信を防ぐための言い方。
6
#統計 「統計的有意性とP値に関するASA声明」でも他の真っ当なすべての解説でも、P値<αという条件による安易な2値的判断をしてはいけないということになっています。
「統計的有意性」で結論を出すこと自体が有害であるというコンセンサスがすでにあるようにも見える。
biometrics.gr.jp/news/all/ASA
「統計的有意性」で結論を出すこと自体が有害であるというコンセンサスがすでにあるようにも見える。
biometrics.gr.jp/news/all/ASA
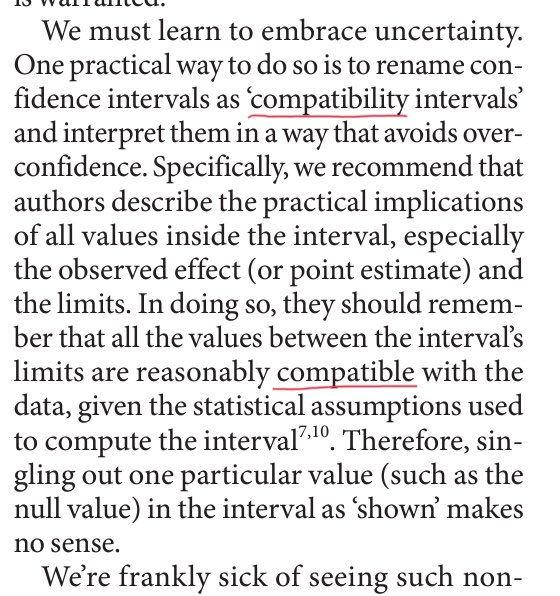
7
#統計 P値と尤度(ゆうど)の違いが明瞭であるような説明をしていない場合はアウト。
P値が、現実においてではなく、検定したい仮説の下でのモデル内確率分布で計算した確率であることが分からない説明もアウト。
統計的有意性(P値<α)によって科学的結論を出すことに否定的でない説明もアウト。
P値が、現実においてではなく、検定したい仮説の下でのモデル内確率分布で計算した確率であることが分からない説明もアウト。
統計的有意性(P値<α)によって科学的結論を出すことに否定的でない説明もアウト。
8
#統計 例えば「回帰係数に関する帰無仮説β₁=0のP値が有意水準未満ならば統計的に有意なのでβ₁≠0であるという結論を出してよい」が正しいと考える生徒には、統計学の単位を出してはいけないと思います。
最初に試験を実施するべきなのは大学の先生達だと思います。
最初に試験を実施するべきなのは大学の先生達だと思います。
9
#統計 P値は、β₁=0のような検定したい仮説だけではなく、モデル全体(β₁=0については回帰モデル全体)と観察データの数値の相性の良さ(整合性、適合度)の指標の1つです。
P値は、検定したい仮説だけではなく、モデル全体を評価している指標であることが忘れられがちなので注意が必要。
P値は、検定したい仮説だけではなく、モデル全体を評価している指標であることが忘れられがちなので注意が必要。
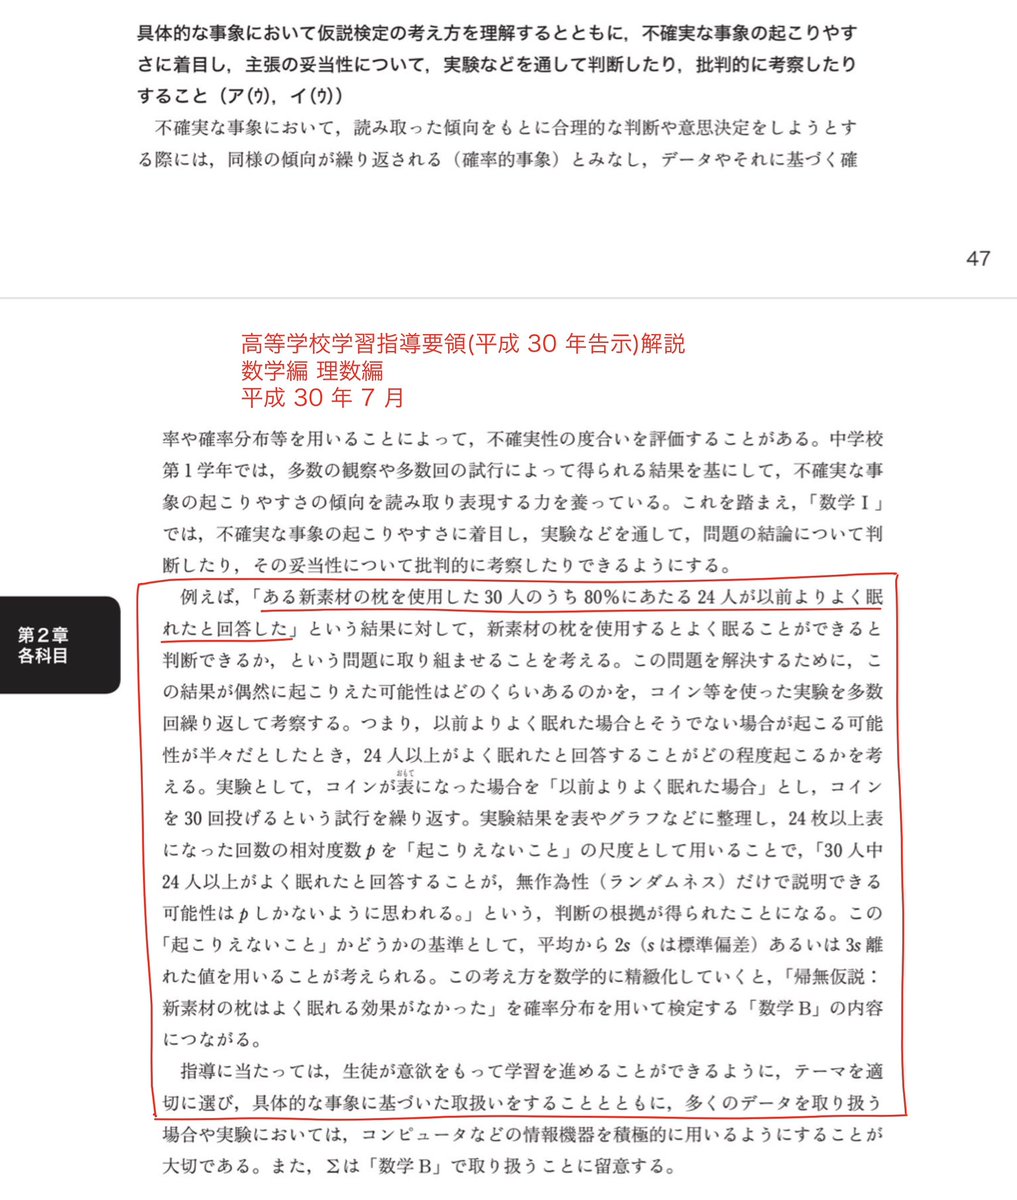
10
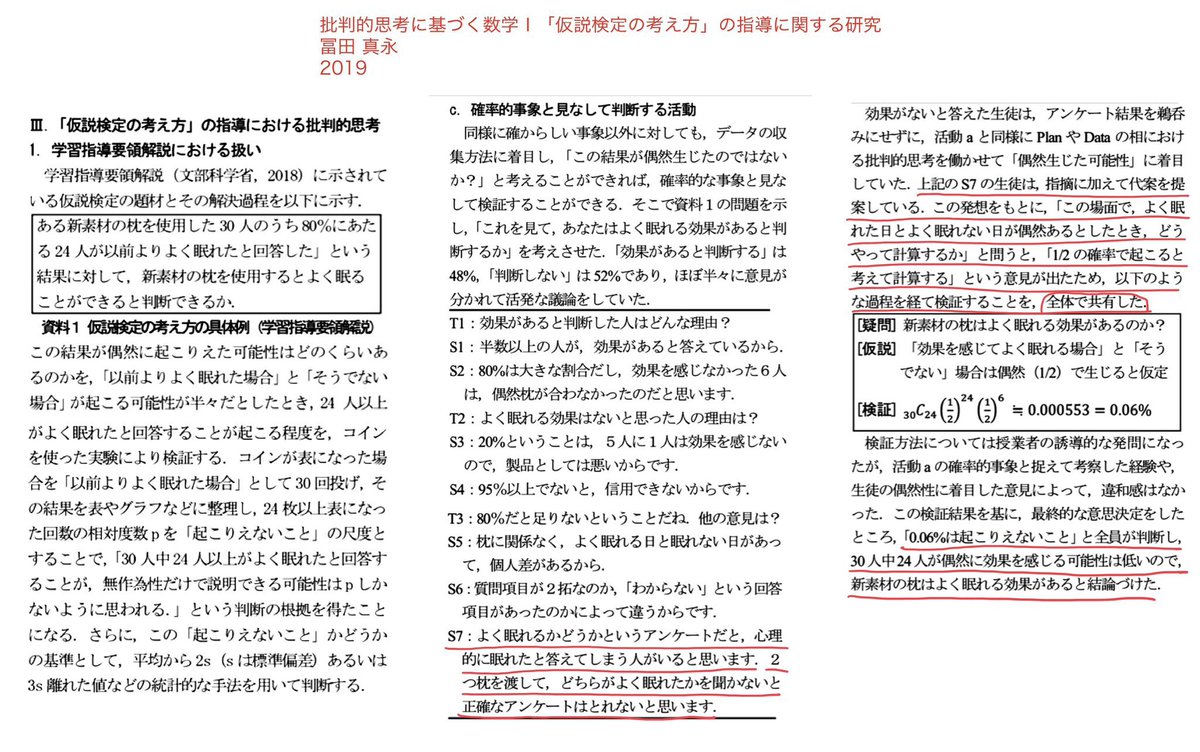
#統計 P値や信頼区間の使い方(もしくは誤用の仕方)に関する決定的な解説がGreenlandさんの講演スライド
biostatistics.ucdavis.edu/sites/g/files/…
にあります。これの発見が遅れて時間を無駄にした。
添付画像はそのp.75の翻訳。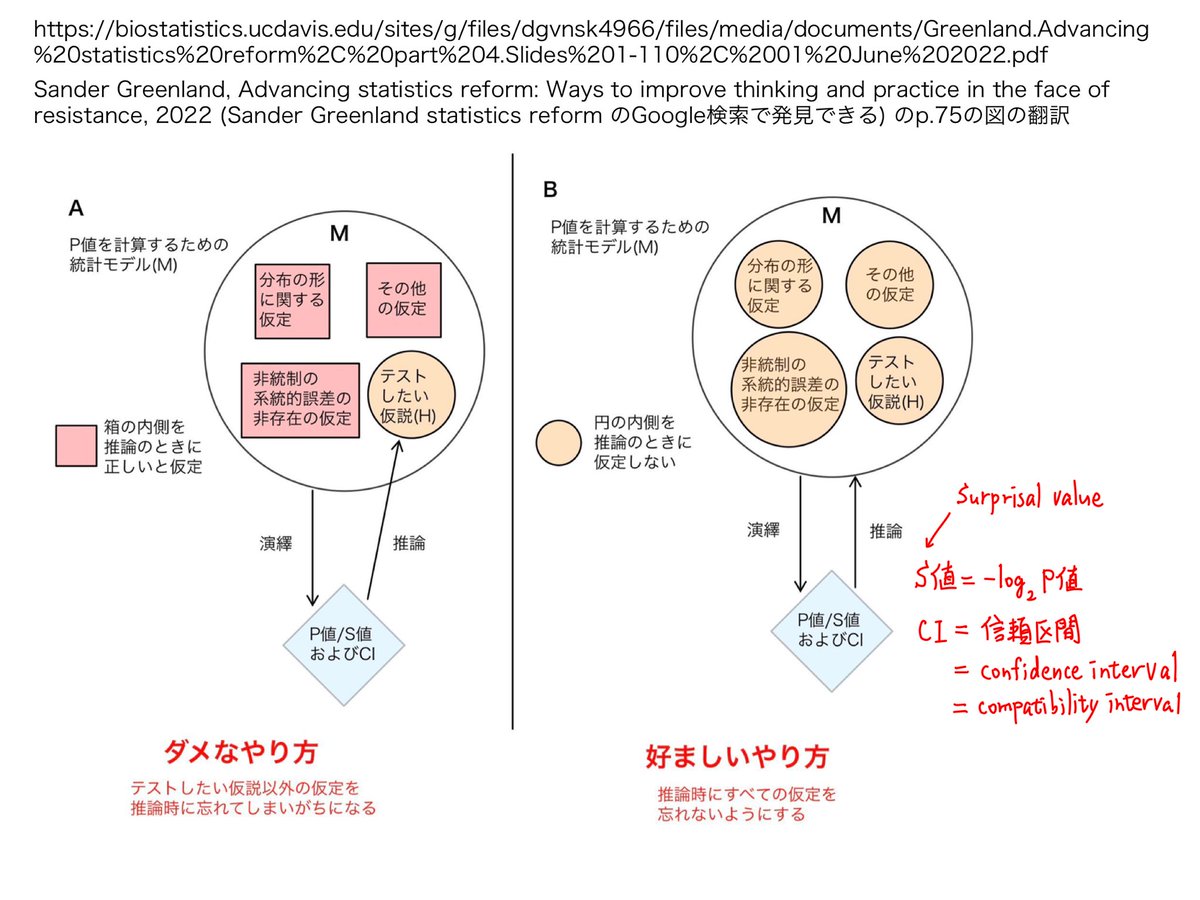
biostatistics.ucdavis.edu/sites/g/files/…
にあります。これの発見が遅れて時間を無駄にした。
添付画像はそのp.75の翻訳。
11
#統計 小さなP値が得られたときには、通常、検定したい仮説だけではなく、「モデルが間違っている」(調整するべき(してはいけない)変数で調節していない(している)ことなども含む)や「データの取得法に問題があった」の可能性も疑ってみるのが普通でしょう。
12
#統計 『ロスマンの疫学第2版』の第8章の解説も非常に有用です。これも統計学を教える仕事をする前に目を通しておくと良いと思います。
宝くじで大当たりしてP値がほぼ0になっても、宝くじがフェアに運用されているという帰無仮説の正しさははびくともしないでしょう。


宝くじで大当たりしてP値がほぼ0になっても、宝くじがフェアに運用されているという帰無仮説の正しさははびくともしないでしょう。
黒木玄 Gen Kuroki@genkuroki
#統計 P値や「統計的に有意」の意味については、『ロスマン疫学第2版』pp.213-214を引用しておけば無難だと思う。
⭕️P値がどんなに小さくても帰無仮説を否定するには不十分である
や
⭕️「統計的有意」は「P値 < α」の言い換えに過ぎず、それを超える意味はない
とかを当然だと思う必要がある。
⭕️P値がどんなに小さくても帰無仮説を否定するには不十分である
や
⭕️「統計的有意」は「P値 < α」の言い換えに過ぎず、それを超える意味はない
とかを当然だと思う必要がある。
13
#統計 P値がデータの数値とモデル+パラメータの値の設定の相性の良さの指標の1つだと解釈できることは回帰の視覚化によっても納得可能。
モデルy=β₀+β₁x+u (u~Normal(0, σ))でのβ₁=0という設定との相性の良さが添付画像中のP値になっています。
添付画像①はP値<5%の、②はP値≥5%の場合。

モデルy=β₀+β₁x+u (u~Normal(0, σ))でのβ₁=0という設定との相性の良さが添付画像中のP値になっています。
添付画像①はP値<5%の、②はP値≥5%の場合。
14
#統計 実はグラフの見た目的には色々微妙で要注意なことも分かる。過信は危ない。
1つ上のグラフを作成するために使った #Julia言語 のコード
↓
github.com/genkuroki/publ…
線形回帰の一般論
↓
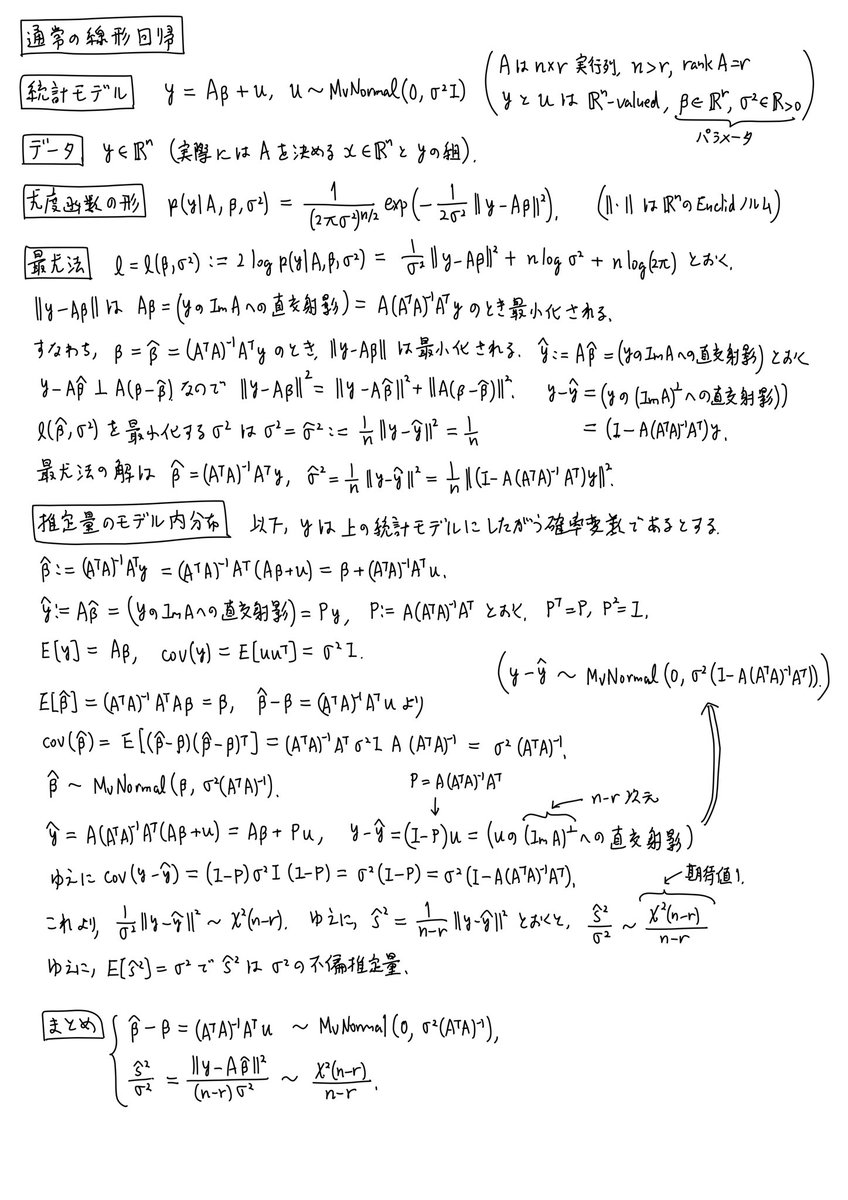

1つ上のグラフを作成するために使った #Julia言語 のコード
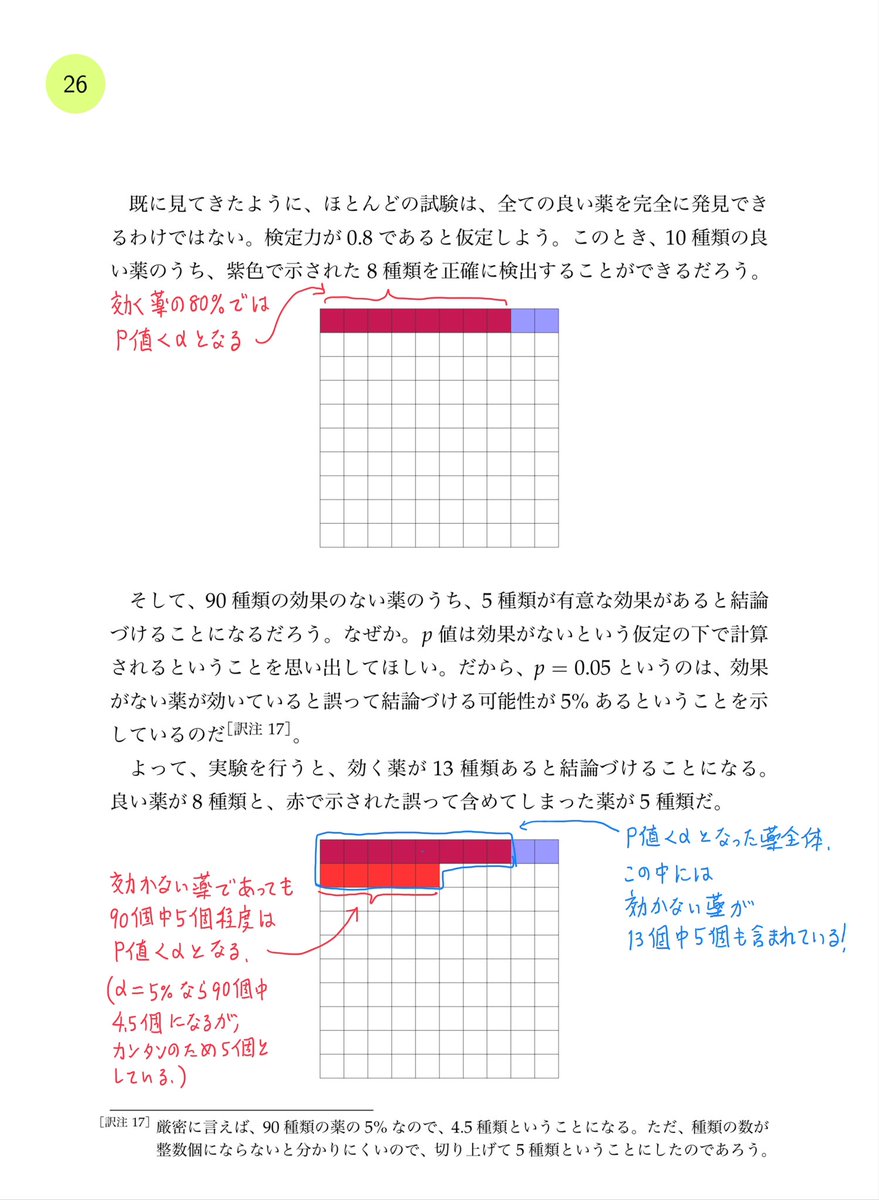
↓
github.com/genkuroki/publ…
線形回帰の一般論
↓
黒木玄 Gen Kuroki@genkuroki
#統計
通常の線形回帰
(残差の分布を正規分布でモデル化したときの最尤法)
と
βとlog σ²に関する平坦事前分布(improper)に関する
ベイズ版線形回帰
の同等性に関する雑なノート。
通常の線形回帰
(残差の分布を正規分布でモデル化したときの最尤法)
と
βとlog σ²に関する平坦事前分布(improper)に関する
ベイズ版線形回帰
の同等性に関する雑なノート。
15
#統計 残差が正規分布以外の分布(添付画像では指数分布)であっても、標本サイズnを十分に大きくすると回帰係数の最小二乗推定量が従う分布は正規分布で近似されるようになります(中心極限定理)。
だから「残差の分布が正規分布でなければ回帰係数に関するt検定は使えない」という主張は誤り。
だから「残差の分布が正規分布でなければ回帰係数に関するt検定は使えない」という主張は誤り。
16
#統計 もちろん無条件でいつでもt検定を使えるわけではありません。
しかし、残差のQQプロットを描いたり、正規性検定をしたりしたがる人達の多くは多分基本的なことを誤解しているだろうとは言えます。
しかし、残差のQQプロットを描いたり、正規性検定をしたりしたがる人達の多くは多分基本的なことを誤解しているだろうとは言えます。
17
#統計 基本:統計学の使い方については、
大学の講義
も
定評ある教科書
も
査読済み出版論文
も
学術雑誌の方針
の内容も必ずしも正しくないので、
権威に従う、権威を信じる
という方針の勉強の仕方は失敗する可能性が高い。
大学の講義
も
定評ある教科書
も
査読済み出版論文
も
学術雑誌の方針
の内容も必ずしも正しくないので、
権威に従う、権威を信じる
という方針の勉強の仕方は失敗する可能性が高い。
18
「ざっくりいえば」という言い方をしたのでよいという言い訳はダメであると最初から述べています。
あと、「統計的有意性とP値に関するASA声明」から引用したP値の説明はP値の定義ではありません。ざっくりした説明にすぎません。
さらに、P値の解釈の仕方も引用してざっくり説明しています。
あと、「統計的有意性とP値に関するASA声明」から引用したP値の説明はP値の定義ではありません。ざっくりした説明にすぎません。
さらに、P値の解釈の仕方も引用してざっくり説明しています。
竹内幹@takekan
@genkuroki ご指摘の通りです。ご説明ありがとうございます。 ただ....、定義の説明をしたいのではなく、定義の前の動機付けとして「[まず]、ざっくりいえば」と起こしたつもりでした。帰無仮説を棄却する結論が"勘違い"だったら? という予告として。 なお、ASAの声明は読んだことあります(本当に)。
19
こちらにもリンク。
ざっくりした説明の内容は、巷に蔓延っているP値の誤用の典型例でしょう。
帰無仮説単体とP値が結びついているのではなく、モデル全体に結びついていることが分かるように説明しないと、「統計的有意性とP値に関するASA声明」のざっくりした説明との整合性がなくなります。
ざっくりした説明の内容は、巷に蔓延っているP値の誤用の典型例でしょう。
帰無仮説単体とP値が結びついているのではなく、モデル全体に結びついていることが分かるように説明しないと、「統計的有意性とP値に関するASA声明」のざっくりした説明との整合性がなくなります。
竹内幹@takekan
@genkuroki 定義にそった説明だけだと理解できず、試験だけはパターンマッチで切り抜けたと思われる学生さんを多数みてきました。
「さて、このざっくり解釈(動機)を数式で表現してみたいがどうする」とつなげていったほうがよいのではと思っており、それをツイートしました。ご丁寧な補足、深謝いたします。
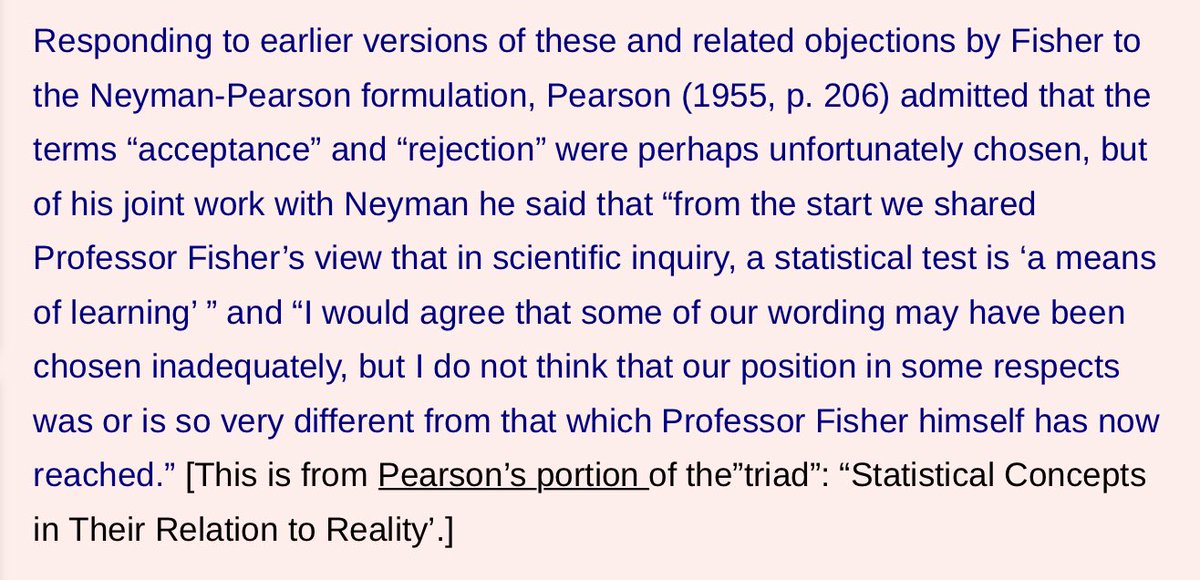
「さて、このざっくり解釈(動機)を数式で表現してみたいがどうする」とつなげていったほうがよいのではと思っており、それをツイートしました。ご丁寧な補足、深謝いたします。
20
#統計 投稿を消したようなので文脈が不明にならないようにスクショを引用。
私も赤で印を付けた部分は、P値ではなく、αエラー率の説明をしているようにも見えました。
こういう説明を学生にしてはいけないと思います。
私も気を付けよう。


私も赤で印を付けた部分は、P値ではなく、αエラー率の説明をしているようにも見えました。
こういう説明を学生にしてはいけないと思います。
私も気を付けよう。
IEN@IEN_enjoy
そしてこれはp値ではなくαエラーの説明になります。
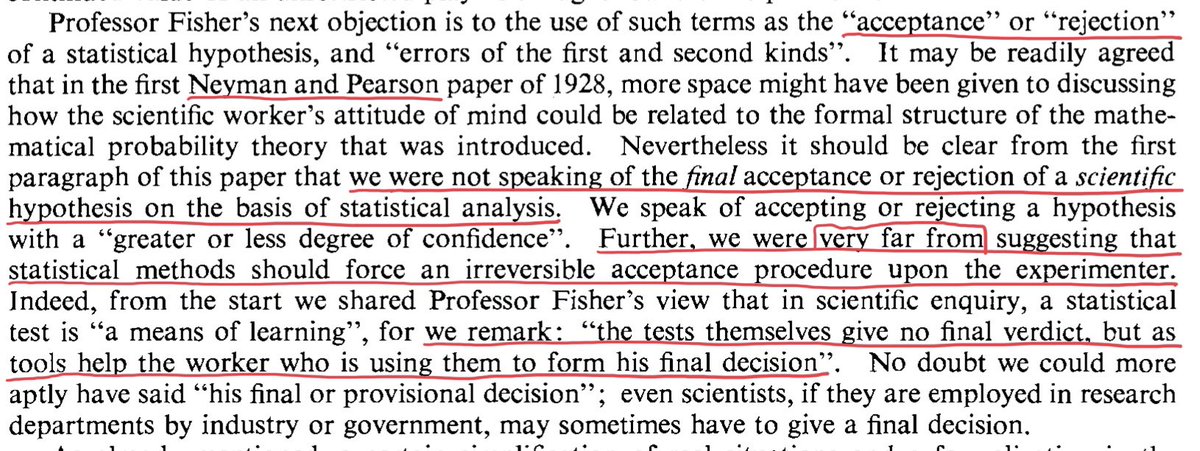
αエラーとは「本当は差がないにも関わらず、差があると主張してしまう誤り」で定義されます。
有意水準5%のもとでは(多重検定をしない限り)αエラーは5%です。
αエラーとは「本当は差がないにも関わらず、差があると主張してしまう誤り」で定義されます。
有意水準5%のもとでは(多重検定をしない限り)αエラーは5%です。
21
#統計 誤りを認めて1つだけ投稿を消したということのようです。
消したのはこれ(「これがp値」と書いてあるこの投稿が見えないと文脈が見え難くなる)
↓

消したのはこれ(「これがp値」と書いてあるこの投稿が見えないと文脈が見え難くなる)
↓
竹内幹@takekan
一部、有意水準とp値を混同した説明をのせていました。私の早とちりと推敲不足によるものです。ご指摘感謝いたします。1つだけツイートを削除しました。
(でてきたp値に応じて、有意水準αを事後的に変えているかのように見えるpracticeはやっぱりいかんと改めて思いました)
(でてきたp値に応じて、有意水準αを事後的に変えているかのように見えるpracticeはやっぱりいかんと改めて思いました)
22
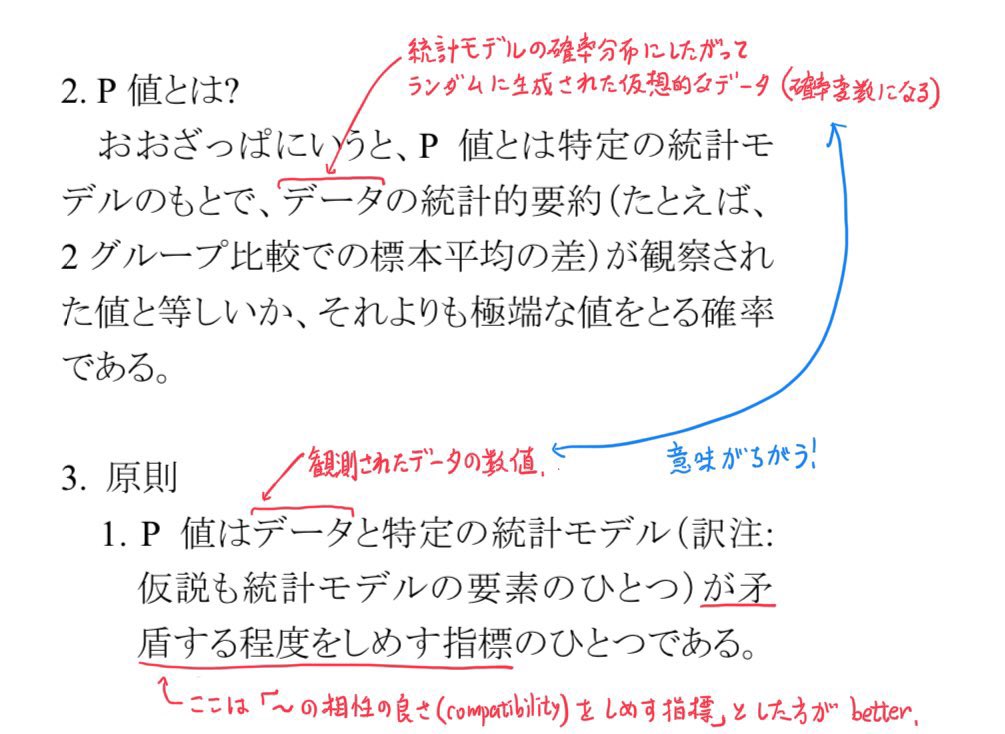
#統計 ASA声明では
1. P値は[観測]データ[の数値]と特定の統計モデル(訳註: [検定したい]仮説も統計モデルの要素)が矛盾する程度[小さい方が矛盾する程度が強い]をしめす指標のひとつである。
と、P値は検定したい仮説単体ではなく、モデル全体に結び付いていると説明しています。これ重要。
訂正版

1. P値は[観測]データ[の数値]と特定の統計モデル(訳註: [検定したい]仮説も統計モデルの要素)が矛盾する程度[小さい方が矛盾する程度が強い]をしめす指標のひとつである。
と、P値は検定したい仮説単体ではなく、モデル全体に結び付いていると説明しています。これ重要。
訂正版
黒木玄 Gen Kuroki@genkuroki
#統計 統計学を教える仕事をする人は
統計的有意性とP値に関するASA声明
biometrics.gr.jp/news/all/ASA
には目を通しておいた方が無難。
これを読めば、P値に関する実践的に十分な説明と解釈法が得られます。
ただし添付画像への追記部分に注意することも必要。
統計的有意性とP値に関するASA声明
biometrics.gr.jp/news/all/ASA
には目を通しておいた方が無難。
これを読めば、P値に関する実践的に十分な説明と解釈法が得られます。
ただし添付画像への追記部分に注意することも必要。
23
#統計 添付画像は上で引用したP値の解釈に関する原則1の終わりの部分です。
P値が、検定したい仮説単体ではなく、P値の計算に使われた仮定の全体(モデル)に結び付いている値であることを強調しているからこそ、こういう結論を容易に述べることができるのです。
biometrics.gr.jp/news/all/ASA
P値が、検定したい仮説単体ではなく、P値の計算に使われた仮定の全体(モデル)に結び付いている値であることを強調しているからこそ、こういう結論を容易に述べることができるのです。
biometrics.gr.jp/news/all/ASA
24
#統計 以下のリンク先で引用翻訳したGreenlandさんの講演スライドにあった図では、P値だけではなく、CI=信頼区間もモデルM全体に結び付いていることを忘れてはいけないことが強調されているとみなせます。
信頼区間もP値と同様に危険な道具で使い方には注意が必要です。
信頼区間もP値と同様に危険な道具で使い方には注意が必要です。
黒木玄 Gen Kuroki@genkuroki
#統計 P値や信頼区間の使い方(もしくは誤用の仕方)に関する決定的な解説がGreenlandさんの講演スライド
biostatistics.ucdavis.edu/sites/g/files/…
にあります。これの発見が遅れて時間を無駄にした。
添付画像はそのp.75の翻訳。
biostatistics.ucdavis.edu/sites/g/files/…
にあります。これの発見が遅れて時間を無駄にした。
添付画像はそのp.75の翻訳。
25
#統計 以上の説明を読めば、P値の真っ当な説明のときに「対立仮説を示すために帰無仮説をP値<αによって否定する」という背理法との類似を強調する説明はやめた方が良いこともわかります。続く
26
#統計 P値から分かることは、データの数値とモデルの相性の良さ(整合性、適合度)だけで、モデルの一部分であるパラメータの値に関する仮説に関する判断にはさらに別の議論が必要になる。
「P値を使えばαの危険率で検定したい仮説の成否を判定できる」という主張も実践的には完全に間違っています。
「P値を使えばαの危険率で検定したい仮説の成否を判定できる」という主張も実践的には完全に間違っています。
黒木玄 Gen Kuroki@genkuroki
#統計 「統計的有意性とP値に関するASA声明」でも他の真っ当なすべての解説でも、P値<αという条件による安易な2値的判断をしてはいけないということになっています。
「統計的有意性」で結論を出すこと自体が有害であるというコンセンサスがすでにあるようにも見える。
biometrics.gr.jp/news/all/ASA
「統計的有意性」で結論を出すこと自体が有害であるというコンセンサスがすでにあるようにも見える。
biometrics.gr.jp/news/all/ASA
27
#統計 最近出版されたしまりす本(「統計的有意性とP値に関するASA声明」の翻訳者の佐藤俊哉さんの著書)もみんなで読む価値があると思います。
試し読みのために公開されている第1話にP値に関する説明があります。
こういう新しい本でP値に関する真っ当な考え方をみんなで身に付けて行けば良い。

試し読みのために公開されている第1話にP値に関する説明があります。
こういう新しい本でP値に関する真っ当な考え方をみんなで身に付けて行けば良い。
黒木玄 Gen Kuroki@genkuroki
#統計 お勧め本。注文した。
宇宙怪人しまりす 統計よりも重要なことを学ぶ asakura.co.jp/detail.php?boo… @AsakuraPubより
添付画像は試し読みより。
95%信頼区間単体よりも情報量が多いP値関数のグラフを描くことを勧めている!
asakura.tameshiyo.me/9784254122978?…
宇宙怪人しまりす 統計よりも重要なことを学ぶ asakura.co.jp/detail.php?boo… @AsakuraPubより
添付画像は試し読みより。
95%信頼区間単体よりも情報量が多いP値関数のグラフを描くことを勧めている!
asakura.tameshiyo.me/9784254122978?…
28
#統計 最新しまりす本と、Greenlandさんの講演スライド biostatistics.ucdavis.edu/sites/g/files/… の内容はかぶっている部分が結構あって、両方読んでおくと色々安心な感じがします。
少なくともそこに書かれていることが孤立した個人の特殊な考え方ではないことが分かります。
少なくともそこに書かれていることが孤立した個人の特殊な考え方ではないことが分かります。
29
#統計 このスレッドの目標は(実際に読めば分かるように)誤りを指摘することではなく、
P値に関する良い解説のありかを紹介すること
です。内容的には一度理解してしまえば全然大したことがない話なのですが、標準的な誤用を誤用でないことにするために頑張ろうとすると当然分からなくなる。
P値に関する良い解説のありかを紹介すること
です。内容的には一度理解してしまえば全然大したことがない話なのですが、標準的な誤用を誤用でないことにするために頑張ろうとすると当然分からなくなる。
30
#統計 #Julia言語
P値に関する誤解のある一部分は、単独のP値ではなく、P値関数の概念を理解すればかなり消えると思う。
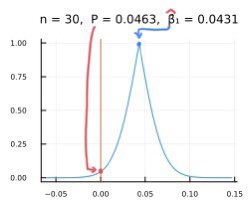
添付画像②は①に対応するP値関数です。横軸は仮説としてのβ₁の値で縦軸がP値です。β₁=0の縦線も追加してあり、P値関数との交点が仮説β₁=0のP値。
github.com/genkuroki/publ…

P値に関する誤解のある一部分は、単独のP値ではなく、P値関数の概念を理解すればかなり消えると思う。
添付画像②は①に対応するP値関数です。横軸は仮説としてのβ₁の値で縦軸がP値です。β₁=0の縦線も追加してあり、P値関数との交点が仮説β₁=0のP値。
github.com/genkuroki/publ…
31
#統計 添付画像②のP値関数のてっぺんの尖っている部分の横軸での値が最小二乗推定値のβ̂₁になります。
仮説β₁=0のP値は横軸の値0におけるP値関数の値。
信頼区間は高さαでP値関数のグラフを切断する線分になります。
P値関数は統計分析の計算結果の優れた要約になっています。
仮説β₁=0のP値は横軸の値0におけるP値関数の値。
信頼区間は高さαでP値関数のグラフを切断する線分になります。
P値関数は統計分析の計算結果の優れた要約になっています。
32
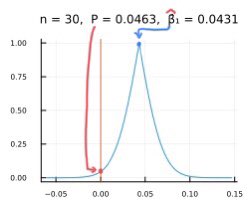
#統計 1つ上の投稿の添付画像①のデータの数値に対応する回帰係数β₁の(両側)P値関数のグラフ。横軸はβ₁で縦軸はP値。
1つ上の投稿の添付画像①のデータの数値とモデルの回帰係数パラメータβ₁の値の設定の相性の良さを示すグラフになっている。
最も相性が良いβ₁の値のは点推定値のβ̂₁=0.0431.
1つ上の投稿の添付画像①のデータの数値とモデルの回帰係数パラメータβ₁の値の設定の相性の良さを示すグラフになっている。
最も相性が良いβ₁の値のは点推定値のβ̂₁=0.0431.
黒木玄 Gen Kuroki@genkuroki
#統計 添付画像②のP値関数のてっぺんの尖っている部分の横軸での値が最小二乗推定値のβ̂₁になります。
仮説β₁=0のP値は横軸の値0におけるP値関数の値。
信頼区間は高さαでP値関数のグラフを切断する線分になります。
P値関数は統計分析の計算結果の優れた要約になっています。
仮説β₁=0のP値は横軸の値0におけるP値関数の値。
信頼区間は高さαでP値関数のグラフを切断する線分になります。
P値関数は統計分析の計算結果の優れた要約になっています。
33
#統計 続き。モデルはy=β₀+β₁x+u, u~Normal(0,σ).
データの数値とβ₁=0という設定(よく「帰無仮説」と呼ばれる)の相性の良さを表すP値関数の値はP=0.0463.
添付画像のP値関数のグラフを見れば、どの辺のβ₁の値がデータの数値との相性が良いか悪いかが一目瞭然。
P値関数は閾値αを必要としない。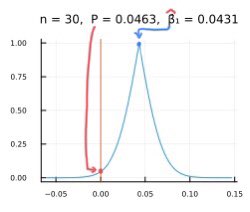
データの数値とβ₁=0という設定(よく「帰無仮説」と呼ばれる)の相性の良さを表すP値関数の値はP=0.0463.
添付画像のP値関数のグラフを見れば、どの辺のβ₁の値がデータの数値との相性が良いか悪いかが一目瞭然。
P値関数は閾値αを必要としない。
34
#統計 帰無仮説(ゼロ仮説)β₁=0単独のP値ではなく、P値関数のグラフを見れば、「P値は閾値αによる2値的判断のために使う」という誤解が訂正されて、「P値は推定のための道具である」というより正しい理解が得られる。
これによってnullism(帰無主義、ゼロ主義)とdichotomania(二分法病)が治療される。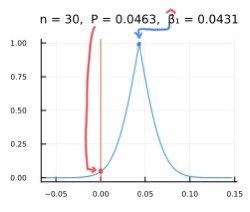
これによってnullism(帰無主義、ゼロ主義)とdichotomania(二分法病)が治療される。
35
#統計 モデル(上の例ではy=β₀+β₁x+u, u~Normal(0,σ))が自分の目的のために妥当ではない可能性も考慮する必要がある。
モデルの仮定を裏に隠して(よく見る!)、モデルと現実を混同させてはいけない。
まとめ: P値教育ではnullism, dichotomania, reificationの3つの症状に注意するべき。

モデルの仮定を裏に隠して(よく見る!)、モデルと現実を混同させてはいけない。
まとめ: P値教育ではnullism, dichotomania, reificationの3つの症状に注意するべき。
黒木玄 Gen Kuroki@genkuroki
#統計 Greenlandさんが要約しているように
* nullism (帰無主義)
* dichotomania (二分法病)
* reification (モデルを疑わない病(意訳))
などに学生を陥らせないように統計学について解説しないと、有害な教育をしてしまったことになります。
biostat.ucdavis.edu/sites/g/files/…
* nullism (帰無主義)
* dichotomania (二分法病)
* reification (モデルを疑わない病(意訳))
などに学生を陥らせないように統計学について解説しないと、有害な教育をしてしまったことになります。
biostat.ucdavis.edu/sites/g/files/…
36
#統計 P値が推定のための道具であることについても、Greenlandさんの講演スライドを参照。
P値は、2値的判断を迫る検定のためにではなく、データの数値との相性の良さを連続的に評価するタイプの推定のための道具として使える。
biostatistics.ucdavis.edu/sites/g/files/…


P値は、2値的判断を迫る検定のためにではなく、データの数値との相性の良さを連続的に評価するタイプの推定のための道具として使える。
biostatistics.ucdavis.edu/sites/g/files/…
黒木玄 Gen Kuroki@genkuroki
#統計 P値を
❌「効果ゼロ」という帰無仮説に関する検定の道具
とみなすのではなく、
⭕️推定の道具
とみなすべきであることについては、Greenlandさんの講演スライドを参照。
この講演スライドに目を通しておくと、P値に関するおかしな議論に関わる時間を減らせます。
biostatistics.ucdavis.edu/sites/g/files/…
❌「効果ゼロ」という帰無仮説に関する検定の道具
とみなすのではなく、
⭕️推定の道具
とみなすべきであることについては、Greenlandさんの講演スライドを参照。
この講演スライドに目を通しておくと、P値に関するおかしな議論に関わる時間を減らせます。
biostatistics.ucdavis.edu/sites/g/files/…
37
#統計 P値について「対立仮説を示すために確率的な背理法を行う」という冷静に考えればいかにも不味そうな解説の文脈で理解したつもりになっている人達にとって、「実はP値は推定のための道具であった」という以上の解説はびっくりするような話だと思う。
しかし、一度理解してしまえば非常に易しい。
しかし、一度理解してしまえば非常に易しい。
黒木玄 Gen Kuroki@genkuroki
#統計 以上の説明を読めば、P値の真っ当な説明のときに「対立仮説を示すために帰無仮説をP値<αによって否定する」という背理法との類似を強調する説明はやめた方が良いこともわかります。続く
38
#統計 以上を理解した人は「P値は所謂NHST(帰無仮説有意性検定)のための道具である」という考え方はもはや論外だと感じるはずです。
「P値は所謂NHSTのための道具である」という間違った思い込みの下で「P値ではなく、ベイズを使え」と言っている人も無教養人扱いで問題ありません。たまに見ます。
「P値は所謂NHSTのための道具である」という間違った思い込みの下で「P値ではなく、ベイズを使え」と言っている人も無教養人扱いで問題ありません。たまに見ます。
39
#統計 #Julia言語
線形回帰のβ₁に関するP値関数
と
βとlog σ²について平坦な事前分布での
ベイズ版線形回帰のβ₁に関する事後分布
は数学的に「同等」なので、
線形回帰に関するP値を使う方法とベイズ法の違い
は
事前分布の平坦分布との違い
にちょうど対応。
github.com/genkuroki/publ…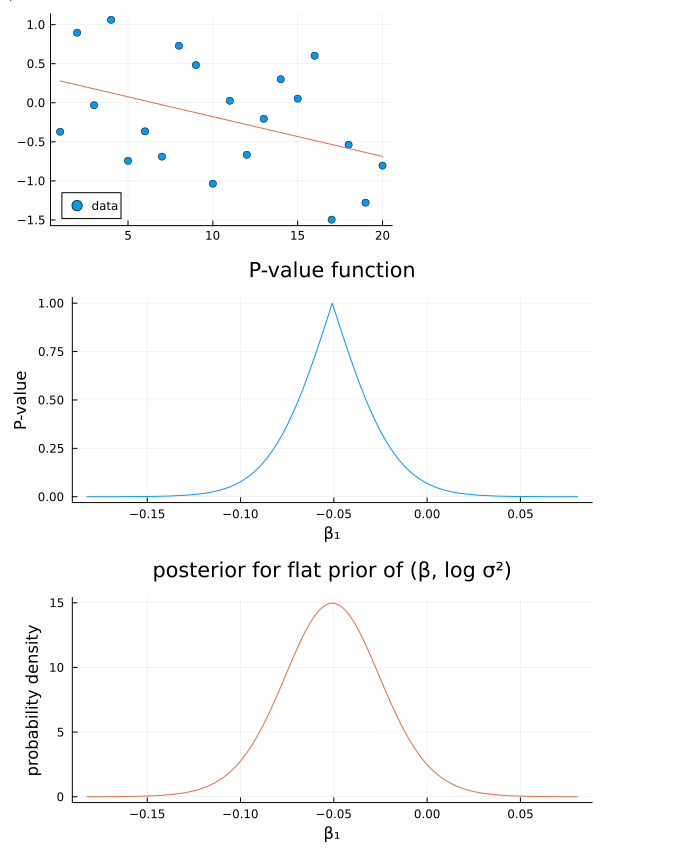
線形回帰のβ₁に関するP値関数
と
βとlog σ²について平坦な事前分布での
ベイズ版線形回帰のβ₁に関する事後分布
は数学的に「同等」なので、
線形回帰に関するP値を使う方法とベイズ法の違い
は
事前分布の平坦分布との違い
にちょうど対応。
github.com/genkuroki/publ…
40
#統計 P値関数と事後分布を並べてプロットすれば、P値関数と事後分布はどちらも同じような使い方をするべきものだということも分かります。
どちらも、データの数値とモデル+パラメータの値の設定の相性の良さの様子を表している。(ベイズのモデルは事後分布を含む)
どちらも、データの数値とモデル+パラメータの値の設定の相性の良さの様子を表している。(ベイズのモデルは事後分布を含む)
黒木玄 Gen Kuroki@genkuroki
#統計 #Julia言語
線形回帰のβ₁に関するP値関数
と
βとlog σ²について平坦な事前分布での
ベイズ版線形回帰のβ₁に関する事後分布
は数学的に「同等」なので、
線形回帰に関するP値を使う方法とベイズ法の違い
は
事前分布の平坦分布との違い
にちょうど対応。
github.com/genkuroki/publ…
線形回帰のβ₁に関するP値関数
と
βとlog σ²について平坦な事前分布での
ベイズ版線形回帰のβ₁に関する事後分布
は数学的に「同等」なので、
線形回帰に関するP値を使う方法とベイズ法の違い
は
事前分布の平坦分布との違い
にちょうど対応。
github.com/genkuroki/publ…
41
#統計 Statistical Rethinking も事後分布から決まる信用区間を compatibility interval (compatiiblity = 相性の良さ)と呼び、ベイズ統計でも「データの数値とモデルの相性の良さ」という見方をしています。

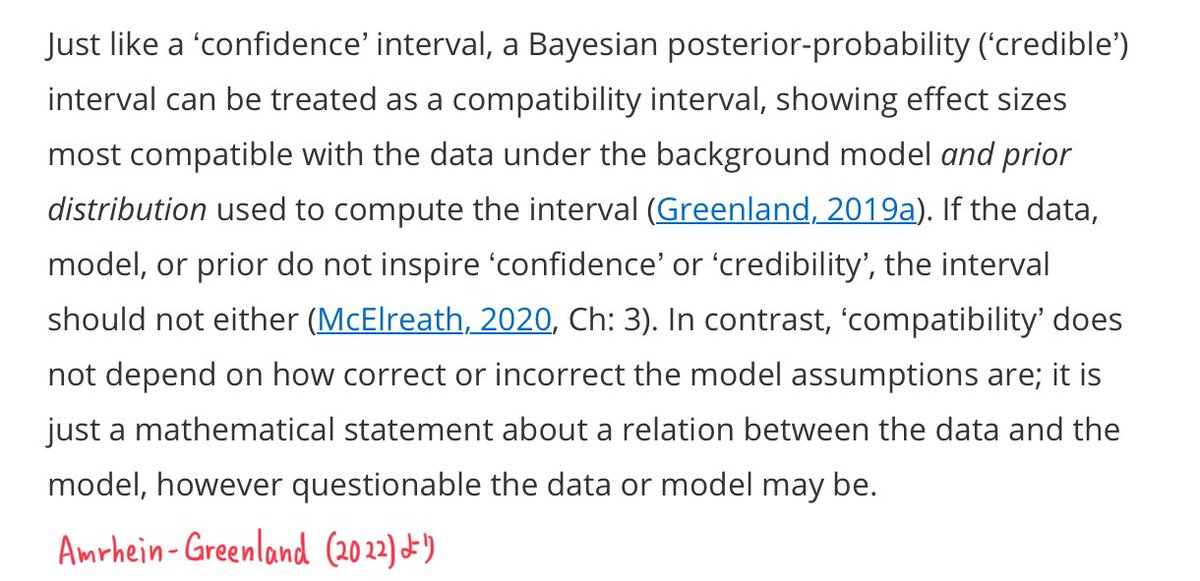
黒木玄 Gen Kuroki@genkuroki
#統計 通常の信頼区間だけではなく、ベイズ版の信用区間も compatibility interval と呼んで同じように解釈することの合理性については、McElreathさんのStatistical Rethinking 2nd ed. の3.2.2 (p.54)を参照。
Amrhein-Greenland (2022) journals.sagepub.com/doi/10.1177/02… も参照。
Amrhein-Greenland (2022) journals.sagepub.com/doi/10.1177/02… も参照。
42
#統計 P値の話を始めると「意識の高い人達」は「ベイズ云々」と言い出したりするのですが、Greenland-McElreath 的な(Statistical Rethinking的な)見方をすれば、P値もベイズ統計の事後分布も「データの数値とモデル+パラメータの値の設定の相性の良さ」という統一的な見方で便利に利用できます。
43
#統計 以上のように、P値はデータの数値とモデル+パラメータの値の設定の相性の良さの指標の1つで、推定の道具として使えることを理解した瞬間に、ベイズ統計の事後分布の使い方も理解したことになるのです。
昔ながらのゼロ仮説単独のP値だけしか見えない人達とは一段階上のレベルに瞬時に到達可能!
昔ながらのゼロ仮説単独のP値だけしか見えない人達とは一段階上のレベルに瞬時に到達可能!
44
#統計 分岐スレッド
シンプルな二項分布モデルの場合を例に使ったP値の使い方に関する解説
シンプルな二項分布モデルの場合を例に使ったP値の使い方に関する解説
黒木玄 Gen Kuroki@genkuroki
@con_advancing #統計 P値は、データの数値とモデル+パラメータの値の設定の相性の良さ(compatibility)の指標の1つです。
例えば、
(1) 20回中5回表が出たというデータの数値
に関する
(2) 二項分布モデル+表の出る確率は1/2という仮説
のWilsonのP値は2.5%で、この値は(1)と(2)の相性の良さを表します。続く
例えば、
(1) 20回中5回表が出たというデータの数値
に関する
(2) 二項分布モデル+表の出る確率は1/2という仮説
のWilsonのP値は2.5%で、この値は(1)と(2)の相性の良さを表します。続く
45
#統計 例えば「差がある」の型の結論が欲しくて、「差がない」の型のP値を計算したら非常に小さな値になったので、「差がある」と結論することがただの勘違いになる可能性は非常に小さくなったと考えるのは誤りです。
P値だけを見てそのように判断してはいけません。「ASA声明」をきちんと読むべき。
P値だけを見てそのように判断してはいけません。「ASA声明」をきちんと読むべき。
黒木玄 Gen Kuroki@genkuroki
#統計 【ざっくりいえば、p値(p-value)は「ある結論が、実はただの勘違いである可能性」と解釈できる。(小声でいうと、小さい方がうれしい)】
という説明は、杜撰なP値の説明そのものに見えました。「ざっくり」は言い訳にならない。
具体例による説明の試みは悪くないと思いました。
解説に続く
という説明は、杜撰なP値の説明そのものに見えました。「ざっくり」は言い訳にならない。
具体例による説明の試みは悪くないと思いました。
解説に続く
46
#統計 P値が非常に小さな値になったことから分かることは
データの数値
と
モデル+検定したい仮説によるパラメータの値の設定
の相性が非常に悪いということだけです。
データ取得法の適切さやモデルの妥当性などの統計分析における本質的なことはP値を見ても何も分からない。
データの数値
と
モデル+検定したい仮説によるパラメータの値の設定
の相性が非常に悪いということだけです。
データ取得法の適切さやモデルの妥当性などの統計分析における本質的なことはP値を見ても何も分からない。
47
#統計 以下のリンク先で引用した「ざっくり」した説明について、少々不正確だが許容範囲の分かり易い説明であると評価するのは誤りです。
「ざっくりした説明としてもまるっきり間違っている」もしくは「よく見る典型的な誤解」のように評価するべきだと私は考えています。
「ざっくりした説明としてもまるっきり間違っている」もしくは「よく見る典型的な誤解」のように評価するべきだと私は考えています。
黒木玄 Gen Kuroki@genkuroki
#統計 【ざっくりいえば、p値(p-value)は「ある結論が、実はただの勘違いである可能性」と解釈できる。(小声でいうと、小さい方がうれしい)】
という説明は、杜撰なP値の説明そのものに見えました。「ざっくり」は言い訳にならない。
具体例による説明の試みは悪くないと思いました。
解説に続く
という説明は、杜撰なP値の説明そのものに見えました。「ざっくり」は言い訳にならない。
具体例による説明の試みは悪くないと思いました。
解説に続く
48
#統計 P値はモデル内部における確率的揺らぎによる評価法の1つ。
統計学の現実での応用で間違った結論を出す可能性を心配するときには、モデル内部における確率的揺らぎ以外のことにも積極的に気を使う必要があります。
だから『統計よりも重要なことを学ぶ』というタイトルの本が出版された。
統計学の現実での応用で間違った結論を出す可能性を心配するときには、モデル内部における確率的揺らぎ以外のことにも積極的に気を使う必要があります。
だから『統計よりも重要なことを学ぶ』というタイトルの本が出版された。
49
#統計 P値を難しく感じる人が多い主な理由は、間違った説明をする側が多数派で、P値に興味を持った人たちが継続的におかしな考え方を吹き込まれているからだと思います。
Greenlandさんの講演スライドのように普通ならおかしいと思うことをおかしいとみなすようにすれば、すべてが易しい話になる。
Greenlandさんの講演スライドのように普通ならおかしいと思うことをおかしいとみなすようにすれば、すべてが易しい話になる。
黒木玄 Gen Kuroki@genkuroki
#統計 Greenlandさんが要約しているように
* nullism (帰無主義)
* dichotomania (二分法病)
* reification (モデルを疑わない病(意訳))
などに学生を陥らせないように統計学について解説しないと、有害な教育をしてしまったことになります。
biostat.ucdavis.edu/sites/g/files/…
* nullism (帰無主義)
* dichotomania (二分法病)
* reification (モデルを疑わない病(意訳))
などに学生を陥らせないように統計学について解説しないと、有害な教育をしてしまったことになります。
biostat.ucdavis.edu/sites/g/files/…
50
#統計 P値に関するお勧めのコースは
①統計的有意性とP値に関するASA声明にざっと目を通して、翻訳者の佐藤俊哉さんの講義動画を視聴する。
②佐藤俊哉著『統計よりも重要なことを学ぶ』の第1話や『ロスマンの疫学第2版』の第8章を読む。
③オプション: Greenlandさんの講義スライドを読む。

①統計的有意性とP値に関するASA声明にざっと目を通して、翻訳者の佐藤俊哉さんの講義動画を視聴する。
②佐藤俊哉著『統計よりも重要なことを学ぶ』の第1話や『ロスマンの疫学第2版』の第8章を読む。
③オプション: Greenlandさんの講義スライドを読む。
TOSH@takashimt
この一連の投稿、自分がP値の扱いにぼんやり感じていた疑問を解決してくれそうなんだけど、なんだか理解が追いつかないのであとで行きつ戻りつしながらじっくり読まねば。
51
#統計 ①のリンク1/2
統計的有意性とP値に関するASA声明
biometrics.gr.jp/news/all/ASA
注意するべき点の修正版(観されたデータの数値→観測されたデータの数値)
↓

統計的有意性とP値に関するASA声明
biometrics.gr.jp/news/all/ASA
注意するべき点の修正版(観されたデータの数値→観測されたデータの数値)
↓
黒木玄 Gen Kuroki@genkuroki
#統計 統計学を教える仕事をする人は
統計的有意性とP値に関するASA声明
biometrics.gr.jp/news/all/ASA
には目を通しておいた方が無難。
これを読めば、P値に関する実践的に十分な説明と解釈法が得られます。
ただし添付画像への追記部分に注意することも必要。
統計的有意性とP値に関するASA声明
biometrics.gr.jp/news/all/ASA
には目を通しておいた方が無難。
これを読めば、P値に関する実践的に十分な説明と解釈法が得られます。
ただし添付画像への追記部分に注意することも必要。
52
#統計 ①のリンク2/2
佐藤俊哉さんの講義動画
youtu.be/vz9cZnB1d1c?si…
仮説検定とP値の誤解
この動画は素晴らしいです。内容も素晴らしいですが,非常に聴きやすい点も驚異的だと思いました。自分の講義を録画したことがある人の多くはそう感じると思います。いやあ、これは本当にすごい。
佐藤俊哉さんの講義動画
youtu.be/vz9cZnB1d1c?si…
仮説検定とP値の誤解
この動画は素晴らしいです。内容も素晴らしいですが,非常に聴きやすい点も驚異的だと思いました。自分の講義を録画したことがある人の多くはそう感じると思います。いやあ、これは本当にすごい。
黒木玄 Gen Kuroki@genkuroki
#統計 「統計的有意性とP値に関するASA声明」の翻訳者の佐藤俊哉先生による素晴らしい講義動画もよく紹介されています。これも統計学を教える仕事をする人は視聴しておいた方がよい。教科書に誤りが書いてあることを明瞭に説明している。教科書通りに講義をしてはいけない。
youtu.be/vz9cZnB1d1c?si…
youtu.be/vz9cZnB1d1c?si…
53
#統計 ②のリンク1/2
asakura.co.jp/detail.php?boo…
佐藤俊哉著『宇宙怪人しまりす 統計よりも重要なことを学ぶ』
P値について解説している第1話を試し読みできます。
第2話以降にも重要な話が書いてあります。
asakura.co.jp/detail.php?boo…
佐藤俊哉著『宇宙怪人しまりす 統計よりも重要なことを学ぶ』
P値について解説している第1話を試し読みできます。
第2話以降にも重要な話が書いてあります。
黒木玄 Gen Kuroki@genkuroki
#統計 最近出版されたしまりす本(「統計的有意性とP値に関するASA声明」の翻訳者の佐藤俊哉さんの著書)もみんなで読む価値があると思います。
試し読みのために公開されている第1話にP値に関する説明があります。
こういう新しい本でP値に関する真っ当な考え方をみんなで身に付けて行けば良い。
試し読みのために公開されている第1話にP値に関する説明があります。
こういう新しい本でP値に関する真っ当な考え方をみんなで身に付けて行けば良い。
54
#統計 ②のリンク2/2
shinoharashinsha.co.jp/Books2.aspx?PI…
『ロスマンの疫学第2版』
この本の第8章「偶然誤差と統計の役割」にP値に関する非常に良い解説があります。お勧め!
shinoharashinsha.co.jp/Books2.aspx?PI…
『ロスマンの疫学第2版』
この本の第8章「偶然誤差と統計の役割」にP値に関する非常に良い解説があります。お勧め!
黒木玄 Gen Kuroki@genkuroki
#統計 『ロスマンの疫学第2版』の第8章の解説も非常に有用です。これも統計学を教える仕事をする前に目を通しておくと良いと思います。
宝くじで大当たりしてP値がほぼ0になっても、宝くじがフェアに運用されているという帰無仮説の正しさははびくともしないでしょう。
宝くじで大当たりしてP値がほぼ0になっても、宝くじがフェアに運用されているという帰無仮説の正しさははびくともしないでしょう。
55
#統計 ③のリンク
Sander Greenlandさんの講演スライド
biostatistics.ucdavis.edu/sites/g/files/…
Advancing statistics reform: Ways to improve thinking and practice in the face of resistance
統計学を既習で英語も読めるなら、これを最初に読んでしまえば時間の節約になると思います。非常に面白いです。


Sander Greenlandさんの講演スライド
biostatistics.ucdavis.edu/sites/g/files/…
Advancing statistics reform: Ways to improve thinking and practice in the face of resistance
統計学を既習で英語も読めるなら、これを最初に読んでしまえば時間の節約になると思います。非常に面白いです。
黒木玄 Gen Kuroki@genkuroki
#統計 P値や信頼区間の使い方(もしくは誤用の仕方)に関する決定的な解説がGreenlandさんの講演スライド
biostatistics.ucdavis.edu/sites/g/files/…
にあります。これの発見が遅れて時間を無駄にした。
添付画像はそのp.75の翻訳。
biostatistics.ucdavis.edu/sites/g/files/…
にあります。これの発見が遅れて時間を無駄にした。
添付画像はそのp.75の翻訳。
56
#統計 おまけのリンク
github.com/rmcelreath/sta…
McElreathさんのStatistical Rethinkingの講義動画 2024年版(英語)
ベイズ統計と因果推論にも興味がある人はこれがお勧め!
以下のリンク先も参照
↓
github.com/rmcelreath/sta…
McElreathさんのStatistical Rethinkingの講義動画 2024年版(英語)
ベイズ統計と因果推論にも興味がある人はこれがお勧め!
以下のリンク先も参照
↓
黒木玄 Gen Kuroki@genkuroki
#統計 Statistical Rethinking も事後分布から決まる信用区間を compatibility interval (compatiiblity = 相性の良さ)と呼び、ベイズ統計でも「データの数値とモデルの相性の良さ」という見方をしています。
x.com/genkuroki/stat…
x.com/genkuroki/stat…
57
#統計
私によるP値に関するざっくりとした説明
↓
私によるP値に関するざっくりとした説明
↓
黒木玄 Gen Kuroki@genkuroki
@con_advancing #統計 P値は、データの数値とモデル+パラメータの値の設定の相性の良さ(compatibility)の指標の1つです。
例えば、
(1) 20回中5回表が出たというデータの数値
に関する
(2) 二項分布モデル+表の出る確率は1/2という仮説
のWilsonのP値は2.5%で、この値は(1)と(2)の相性の良さを表します。続く
例えば、
(1) 20回中5回表が出たというデータの数値
に関する
(2) 二項分布モデル+表の出る確率は1/2という仮説
のWilsonのP値は2.5%で、この値は(1)と(2)の相性の良さを表します。続く
58
#統計 P値に関する細部の説明を省略してざくっと説明するには、適当な具体例を使って
P値は、データの数値とモデル+パラメータの値の設定の相性も良さ(compatibility、整合性、適合度)の指標の1つ
と説明するのが良いと思っています。ただし、モデル=パラメータ付き確率分布の理解が必須になる。
P値は、データの数値とモデル+パラメータの値の設定の相性も良さ(compatibility、整合性、適合度)の指標の1つ
と説明するのが良いと思っています。ただし、モデル=パラメータ付き確率分布の理解が必須になる。
黒木玄 Gen Kuroki@genkuroki
@con_advancing #統計
初学者に向けて「一言二言で説明」することにあたるのはこれ。P値は、一言で言うと、データの数値とのモデル+そのパラメータの値の設定の相性の良さの指標の1つです。理解にはパラメータ付き確率分布の概念は必須。最初は二項分布程度でよい。続く
↓
初学者に向けて「一言二言で説明」することにあたるのはこれ。P値は、一言で言うと、データの数値とのモデル+そのパラメータの値の設定の相性の良さの指標の1つです。理解にはパラメータ付き確率分布の概念は必須。最初は二項分布程度でよい。続く
↓
59
#統計 モデルとしてパラメータ付き確率分布(最初は二項分布でよい)を使うことの理解はP値についてのざっくりとした理解においても必須。
なぜならば、P値は「表の出る確率は1/2である」のような帰無仮説単体に結び付いている値ではなく、モデル全体(とデータの数値)に結び付いている値だからです。
なぜならば、P値は「表の出る確率は1/2である」のような帰無仮説単体に結び付いている値ではなく、モデル全体(とデータの数値)に結び付いている値だからです。
60
#統計 P値について解説している最新の宇宙怪人しまりす本の第1話のタイトルは「背後仮定も含めて解釈することが重要なんですね」です。
背後仮定は数学的にはパラメータ付き確率分布によるモデルとして実装されています。P値を使う場合にはモデル全体を見ないとダメ。
asakura.tameshiyo.me/9784254122978?…
背後仮定は数学的にはパラメータ付き確率分布によるモデルとして実装されています。P値を使う場合にはモデル全体を見ないとダメ。
asakura.tameshiyo.me/9784254122978?…
61
#統計 佐藤俊哉さんの講義動画で
* 有意な検定結果(P≤0.05)は帰無仮説が誤りであり、棄却するべきであることを意味する
は誤解の典型例という扱いになっています。その理由は背後の仮定の全体(モデルの全体)に配慮していない内容になっているからです。

* 有意な検定結果(P≤0.05)は帰無仮説が誤りであり、棄却するべきであることを意味する
は誤解の典型例という扱いになっています。その理由は背後の仮定の全体(モデルの全体)に配慮していない内容になっているからです。
黒木玄 Gen Kuroki@genkuroki
#統計 「統計的有意性とP値に関するASA声明」の翻訳者の佐藤俊哉先生による素晴らしい講義動画もよく紹介されています。これも統計学を教える仕事をする人は視聴しておいた方がよい。教科書に誤りが書いてあることを明瞭に説明している。教科書通りに講義をしてはいけない。
youtu.be/vz9cZnB1d1c?si…
youtu.be/vz9cZnB1d1c?si…
62
#統計 こういう自明でつまらないことを繰り返し指摘する必要がある理由は、統計学入門での伝統的な教え方では、二項分布モデルや正規分布モデルが正しいことを仮定してどんどん先に進み、モデルの妥当性をあたかも当然の前提にしてよいかのように説明する習慣になっているからです。続く
63
#統計 現実の統計学教育はもっと捻れておかしなことになっています。モデルの前提にも気を配ろうとした理解度の低い統計学の解説者達が
正規分布でなければt検定を使えない
Mann-WhitneyのU検定のようなノンパラメトリック検定なら無条件で使える
とデタラメを教えている。
正規分布でなければt検定を使えない
Mann-WhitneyのU検定のようなノンパラメトリック検定なら無条件で使える
とデタラメを教えている。
64
このスレッドを読むときに注意するべきことは、単に今まで聞いたことがなかったという理由で難しいと判断しないようにすることです。
今まで聞いてきたことをことごとく否定しているように見えるので感情的に受け入れられない、ならきっと正しい。
このスレッドの内容は実際には相当に易しいです。
今まで聞いてきたことをことごとく否定しているように見えるので感情的に受け入れられない、ならきっと正しい。
このスレッドの内容は実際には相当に易しいです。
65
#統計 私による
P値はデータの数値とモデル+パラメータの値な設定の相性の良さ(整合性、適合度)の指標の1つである
という説明は、「統計的有意性とP値に関するASA声明」の原則1でのP値の説明と本質的に同じものだとみなされます。
安全牌のASA声明準拠!😁
P値はデータの数値とモデル+パラメータの値な設定の相性の良さ(整合性、適合度)の指標の1つである
という説明は、「統計的有意性とP値に関するASA声明」の原則1でのP値の説明と本質的に同じものだとみなされます。
安全牌のASA声明準拠!😁
黒木玄 Gen Kuroki@genkuroki
#統計 統計学を教える仕事をする人は
統計的有意性とP値に関するASA声明
biometrics.gr.jp/news/all/ASA
には目を通しておいた方が無難。
これを読めば、P値に関する実践的に十分な説明と解釈法が得られます。
ただし添付画像への追記部分に注意することも必要。
統計的有意性とP値に関するASA声明
biometrics.gr.jp/news/all/ASA
には目を通しておいた方が無難。
これを読めば、P値に関する実践的に十分な説明と解釈法が得られます。
ただし添付画像への追記部分に注意することも必要。
66
#統計 例えば、2選択のアンケートについて二項分布モデルを使う場合には、モデルの仮定として
母集団の全体からの無作為抽出
という条件を使うことになりますが、よく知られているように、現実には、目標の母集団全体ではなく、その偏った一部分からの標本抽出になりがちだという問題があります。
母集団の全体からの無作為抽出
という条件を使うことになりますが、よく知られているように、現実には、目標の母集団全体ではなく、その偏った一部分からの標本抽出になりがちだという問題があります。
67
#統計 統計学が本質的に力を発揮するソフトサイエンスの問題では、観察されるなまデータはほぼ確実に偏っています。偏りが小さいデータを得るためには特別な注意が必要。
モデル内部での確率的揺らぎに関するP値を見ても、その外部の「データの取得法の適切さ」「モデルの妥当性」は何も分からない。
モデル内部での確率的揺らぎに関するP値を見ても、その外部の「データの取得法の適切さ」「モデルの妥当性」は何も分からない。
68
#統計 統計学の解説の仕事の前に目を通しておく文献として、nature誌に出た例の800人以上の科学者達が統計的有意性の使用に反対したという記事 scholar.google.co.jp/scholar?cluste… もあります。添付画像はそこからの引用。私が「相性の良さ」と翻訳しているcompatibilityの語がキーワードとして登場しています。


黒木玄 Gen Kuroki@genkuroki
#統計 あと、nature誌に出た800人以上の科学者達が統計的有意性の使用に反対したという次の記事(超有名)も直接関係がある文献だと思います。
Scientists rise up against statistical significance
Valentin Amrhein, Sander Greenland, Blake McShane
nature 2019
↓
検索 scholar.google.co.jp/scholar?cluste…
Scientists rise up against statistical significance
Valentin Amrhein, Sander Greenland, Blake McShane
nature 2019
↓
検索 scholar.google.co.jp/scholar?cluste…
69
#統計 P値は背景となるモデルの下でのデータの数値とパラメータの値の相性の良さの指標でした。
信頼水準1-αの信頼区間は「P値≥αとなるパラメータの値の範囲」なので、「閾値αの設定によってデータの数値と相性が良いと判定されたパラメータの範囲」だと解釈されます。
scholar.google.co.jp/scholar?cluste…
信頼水準1-αの信頼区間は「P値≥αとなるパラメータの値の範囲」なので、「閾値αの設定によってデータの数値と相性が良いと判定されたパラメータの範囲」だと解釈されます。
scholar.google.co.jp/scholar?cluste…
70
#統計 相性の良さ(compatibilty)という弱く響く言葉を使うことの利点は、P値や信頼区間についてありがちな過信の抑制を期待できることです。
データの数値と
背景となるモデルと
そのパラメータの値
の相性が悪いことには、それらのどれかが怪しいことを示唆する程度の強さしかない。
データの数値と
背景となるモデルと
そのパラメータの値
の相性が悪いことには、それらのどれかが怪しいことを示唆する程度の強さしかない。
71
#統計 natureの記事では、信頼区間をconfidence intervalからcompatibility intervalに改名すると良さそうだと書いてあります。compatibility intervalは「閾値αによってデータの数値と相性が良いとみなされたモデルのパラメータの値の区間」という意味です。「良相性区間」
黒木玄 Gen Kuroki@genkuroki
#統計 統計学の解説の仕事の前に目を通しておく文献として、nature誌に出た例の800人以上の科学者達が統計的有意性の使用に反対したという記事 scholar.google.co.jp/scholar?cluste… もあります。添付画像はそこからの引用。私が「相性の良さ」と翻訳しているcompatibilityの語がキーワードとして登場しています。
72
#統計 信頼区間という言い方だと、どうしても「その区間に真の値が入っていることを大雑把になら信頼してよい」のような有害な過信を招きます。
compatibilty intervalなら、単に「データの数値と相性が良いモデルのパラメータの値の範囲」でしかないことが想起されるので、過信のリスクが減ります。
compatibilty intervalなら、単に「データの数値と相性が良いモデルのパラメータの値の範囲」でしかないことが想起されるので、過信のリスクが減ります。
73
#統計 このスレッドを書いていて強く不安に思うことは、私が「誤解」や「過信」のような言い方で明瞭に否定している考え方について、正しいと思い続けたい人達がたくさんいて、私に反感を持ってしまうのではないかということ。
それくらい多勢に無勢な感じがしています。応援が欲しいと思います。
それくらい多勢に無勢な感じがしています。応援が欲しいと思います。
74
#統計 P値や信頼区間を、
データの数値とモデル+パラメータの値の設定の相性の良さ(compatibility)で解釈すること
は、ある意味で、
P値や信頼区間をモデルを使ったデータの数値の要約
という意味での
記述統計的な解釈の仕方
だとも言えます。続く
データの数値とモデル+パラメータの値の設定の相性の良さ(compatibility)で解釈すること
は、ある意味で、
P値や信頼区間をモデルを使ったデータの数値の要約
という意味での
記述統計的な解釈の仕方
だとも言えます。続く
75
#統計 モデルを使ってデータの数値を測った結果としてP値や信頼区間が計算される。
そういう記述統計的な計算からは科学的に弱い結論しか得られません。
強い結論が欲しければ、それ以外の何かが必要になります。
その何かについて書かれた本が『統計よりも重要なことを学ぶ』だと考えられます。
そういう記述統計的な計算からは科学的に弱い結論しか得られません。
強い結論が欲しければ、それ以外の何かが必要になります。
その何かについて書かれた本が『統計よりも重要なことを学ぶ』だと考えられます。
黒木玄 Gen Kuroki@genkuroki
#統計 ②のリンク1/2
asakura.co.jp/detail.php?boo…
佐藤俊哉著『宇宙怪人しまりす 統計よりも重要なことを学ぶ』
P値について解説している第1話を試し読みできます。
第2話以降にも重要な話が書いてあります。
asakura.co.jp/detail.php?boo…
佐藤俊哉著『宇宙怪人しまりす 統計よりも重要なことを学ぶ』
P値について解説している第1話を試し読みできます。
第2話以降にも重要な話が書いてあります。
76
#統計 『統計よりも重要なことを学ぶ』やStatistical Rethinkingなどに書かれていることは、統計学入門の立場からは少し進んだ話題になり、入門的な講義に組み込むのはちょっと大変です。
しかし、入門的な講義をそれらの進んだ話題と矛盾しないような内容にすることならやり易いと思います。
しかし、入門的な講義をそれらの進んだ話題と矛盾しないような内容にすることならやり易いと思います。
黒木玄 Gen Kuroki@genkuroki
#統計 ②のリンク1/2
asakura.co.jp/detail.php?boo…
佐藤俊哉著『宇宙怪人しまりす 統計よりも重要なことを学ぶ』
P値について解説している第1話を試し読みできます。
第2話以降にも重要な話が書いてあります。
asakura.co.jp/detail.php?boo…
佐藤俊哉著『宇宙怪人しまりす 統計よりも重要なことを学ぶ』
P値について解説している第1話を試し読みできます。
第2話以降にも重要な話が書いてあります。
77
#統計 例えば、二項分布モデルや正規分布モデルなどのモデルの妥当性をあたかも当然の前提にできるかのような説明は入門的な講義であっても禁止されるべきです。
P値や信頼区間の解釈も過信に誘導しないようにする必要があると思います。入門なので一時的に過信させてよいということにはならない。
P値や信頼区間の解釈も過信に誘導しないようにする必要があると思います。入門なので一時的に過信させてよいということにはならない。
78
#統計 あるとありがたいのは、統計ソフトによう支援です。
非常に残念なことに、既存のソフトはnullism, dichotomania, reificationの3つの病気を悪化させる仕様になっていることが多い。
例えば、P値関数のプロットが実装済みだと非常にありがたいです。
非常に残念なことに、既存のソフトはnullism, dichotomania, reificationの3つの病気を悪化させる仕様になっていることが多い。
例えば、P値関数のプロットが実装済みだと非常にありがたいです。
黒木玄 Gen Kuroki@genkuroki
#統計 Greenlandさんが要約しているように
* nullism (帰無主義)
* dichotomania (二分法病)
* reification (モデルを疑わない病(意訳))
などに学生を陥らせないように統計学について解説しないと、有害な教育をしてしまったことになります。
biostat.ucdavis.edu/sites/g/files/…
* nullism (帰無主義)
* dichotomania (二分法病)
* reification (モデルを疑わない病(意訳))
などに学生を陥らせないように統計学について解説しないと、有害な教育をしてしまったことになります。
biostat.ucdavis.edu/sites/g/files/…
79
#統計 例えば、統計ソフトが「差がない」を意味するゼロ仮説のP値のみに対応していて、「差は〇〇である」の型のもっと一般的な仮説のP値の計算に対応していない場合が結構多くて、nullismの悪影響が統計ソフトの分野でもはっきり見えます。
黒木玄 Gen Kuroki@genkuroki
#統計 2×2の分割表に関するχ²検定の実装のあるべき仕様は
①デフォルトでは連続性補正を一切適用しない。
②オッズ比、リスク比、リスク差の信頼区間を計算してくれる。
③オッズ比、リスク比、リスク差の値に関する検定仮説のP値を計算してくれる。
④P値関数のグラフを作画してくれる。
①デフォルトでは連続性補正を一切適用しない。
②オッズ比、リスク比、リスク差の信頼区間を計算してくれる。
③オッズ比、リスク比、リスク差の値に関する検定仮説のP値を計算してくれる。
④P値関数のグラフを作画してくれる。
80
#統計 具体例: Rのchisq.testで2×2の分割表の検定を実行すると、独立性の帰無仮説(「差がない」型のゼロ仮説の一種)のP値しか表示してくれない。ゼロ仮説に異様にこだわるnullismにフィットしている。(その上、やめて欲しいYatesの連続性補正をデフォルトで適用してしまう。信頼区間も計算しない。)
黒木玄 Gen Kuroki@genkuroki
#統計 2×2の分割表に関するχ²検定の実装のあるべき仕様は
①デフォルトでは連続性補正を一切適用しない。
②オッズ比、リスク比、リスク差の信頼区間を計算してくれる。
③オッズ比、リスク比、リスク差の値に関する検定仮説のP値を計算してくれる。
④P値関数のグラフを作画してくれる。
①デフォルトでは連続性補正を一切適用しない。
②オッズ比、リスク比、リスク差の信頼区間を計算してくれる。
③オッズ比、リスク比、リスク差の値に関する検定仮説のP値を計算してくれる。
④P値関数のグラフを作画してくれる。
81
#統計 おまけ情報: 2×2の分割表のχ²検定については、コクラン先生自身は過剰に保守的だと言っているのになぜか「コクランルール」と呼ばれる「ルール」が蔓延している。
黒木玄 Gen Kuroki@genkuroki
#統計 「過剰に保守的過ぎる」とコクラン先生が論文の中で述べているルールをその論文を引用して「コクランルール」と名付けて、それに従わない人はχ²検定を誤用していると言い張る解説が容易に見付かる問題。
一人ひとり名指しで厳しく批判しないと誰も訂正しないということなのだろうか?
一人ひとり名指しで厳しく批判しないと誰も訂正しないということなのだろうか?
82
#統計 大学以上での統計学教育の内容は杜撰。そういう環境の中で高校数学のカリキュラムに仮説検定が捩じ込まれた結果、酷いことになっています。
例えば学習指導要領解説(学習指導要領とは厳密に異なる文書)には添付画像のように書いてあります。対照群を設けていない。
mext.go.jp/content/202302…

例えば学習指導要領解説(学習指導要領とは厳密に異なる文書)には添付画像のように書いてあります。対照群を設けていない。
mext.go.jp/content/202302…
黒木玄 Gen Kuroki@genkuroki
#統計 高校での統計学教育の悲惨な現状を示唆する資料1/3
学習指導要領(告示)とは厳密に異なる文書(単なる文科省著作物)の学習指導要領解説(高校の数学編理数編)に書いてある
新素材の枕を使用した30人中80%が以前よりよく眠れた
と回答した件の扱いが酷い。続く
mext.go.jp/content/202302…
学習指導要領(告示)とは厳密に異なる文書(単なる文科省著作物)の学習指導要領解説(高校の数学編理数編)に書いてある
新素材の枕を使用した30人中80%が以前よりよく眠れた
と回答した件の扱いが酷い。続く
mext.go.jp/content/202302…
83
#統計 上で紹介した文科省著作物で示唆された教え方については添付画像のような実践報告がされています。
新素材の枕だけを試させてもダメで比較対象が必要だという非常にもっともな意見を述べている生徒S7の意見は潰されています。
jstage.jst.go.jp/article/jssep/…

新素材の枕だけを試させてもダメで比較対象が必要だという非常にもっともな意見を述べている生徒S7の意見は潰されています。
jstage.jst.go.jp/article/jssep/…
黒木玄 Gen Kuroki@genkuroki
#統計 高校での統計学教育の悲惨な現状を示唆する資料2/3
内容が杜撰な文科省著作物に書いてある教え方を実践する人が出て来た!
これがさらに酷い!
jstage.jst.go.jp/article/jssep/…
批判的思考に基づく数学Ⅰ「仮説検定の考え方」の指導に関する研究
冨田 真永
2019
内容が杜撰な文科省著作物に書いてある教え方を実践する人が出て来た!
これがさらに酷い!
jstage.jst.go.jp/article/jssep/…
批判的思考に基づく数学Ⅰ「仮説検定の考え方」の指導に関する研究
冨田 真永
2019
84
#統計 NHK高校講座はさらに酷いことに!
有意水準5%の片側検定によって
【やっぱりこのコイン、細工されてたんだなあ。うん。ぼくの思った通りだったよ!こんなふうに数学的に確かめる方法があったんですね。すっきり~】
と述べているのは酷い。そんな方法はない。
nhk.or.jp/kokokoza/suuga…


有意水準5%の片側検定によって
【やっぱりこのコイン、細工されてたんだなあ。うん。ぼくの思った通りだったよ!こんなふうに数学的に確かめる方法があったんですね。すっきり~】
と述べているのは酷い。そんな方法はない。
nhk.or.jp/kokokoza/suuga…
黒木玄 Gen Kuroki@genkuroki
#統計 類似の別の事例
NHK高校講座での仮説検定の解説も酷い。
有意水準5%の片側検定によって
【やっぱりこのコイン、細工されてたんだなあ。うん。ぼくの思った通りだったよ!こんなふうに数学的に確かめる方法があったんですね。すっきり~】
と述べているのは酷い。
nhk.or.jp/kokokoza/suuga…
NHK高校講座での仮説検定の解説も酷い。
有意水準5%の片側検定によって
【やっぱりこのコイン、細工されてたんだなあ。うん。ぼくの思った通りだったよ!こんなふうに数学的に確かめる方法があったんですね。すっきり~】
と述べているのは酷い。
nhk.or.jp/kokokoza/suuga…
85
#統計 たまに、高校数学で仮説検定などを教えるようになったことをうらやましがる大人の投稿が流れて来るのですが、現実にはそう良い話ではなくて、相当にまずい統計学教育がされてしまっているように見えます。
しかも、高校数学に仮説検定などを入れた人達はおそらく何も責任を取るつもりはない。
しかも、高校数学に仮説検定などを入れた人達はおそらく何も責任を取るつもりはない。
86
#統計 大学以上でもかなり酷いことになっているのに、高校生にまで杜撰な2値的判断をさせるのは非常にまずい。
各種の報告の統計分析に書いてあるP値や信頼区間を正しく疑う方法を身に付けた人達が大量に育つなら素晴らしいことだと思いますが、現実は逆になっているように思われます。
各種の報告の統計分析に書いてあるP値や信頼区間を正しく疑う方法を身に付けた人達が大量に育つなら素晴らしいことだと思いますが、現実は逆になっているように思われます。
87
#統計 補足説明
黒木玄 Gen Kuroki@genkuroki
@mrhonen 概ねその通りです。
補足
P値が小さいときには、モデルの妥当性だけではなく、データも疑いの対象になる。
モデルの妥当性はモデルの分布で母集団分布を近似できることよりも弱い条件。
モデルもデータも正しくてもP値が小さいだけでは帰無仮説を否定できない。『ロスマンの疫学第2版』を参照。
↓
補足
P値が小さいときには、モデルの妥当性だけではなく、データも疑いの対象になる。
モデルの妥当性はモデルの分布で母集団分布を近似できることよりも弱い条件。
モデルもデータも正しくてもP値が小さいだけでは帰無仮説を否定できない。『ロスマンの疫学第2版』を参照。
↓
88
#統計 「統計的有意性とP値に関するASA声明」には
【「統計的有意性」~は、科学的に結論~を主張するための保証として広く用いられているが、科学のプロセスを著しく損ねている】
と非常に厳しい説明があります。P値をそのように使うことを意図した説明は、ASA声明とは逆の立場での説明になります。
【「統計的有意性」~は、科学的に結論~を主張するための保証として広く用いられているが、科学のプロセスを著しく損ねている】
と非常に厳しい説明があります。P値をそのように使うことを意図した説明は、ASA声明とは逆の立場での説明になります。
黒木玄 Gen Kuroki@genkuroki
#統計 「統計的有意性とP値に関するASA声明」でも他の真っ当なすべての解説でも、P値<αという条件による安易な2値的判断をしてはいけないということになっています。
「統計的有意性」で結論を出すこと自体が有害であるというコンセンサスがすでにあるようにも見える。
biometrics.gr.jp/news/all/ASA
「統計的有意性」で結論を出すこと自体が有害であるというコンセンサスがすでにあるようにも見える。
biometrics.gr.jp/news/all/ASA
89
#統計 P値について説明するときには、一見「P値<α」という条件で科学的な結論を出しているように見える場合であっても、P値以外の部分での様々な工夫によって害が防がれていることを説明する側は理解しておく必要があります。続く
90
#統計 一見「P値<α」という条件で科学的な結論を出しているように見える重要な場合は薬の承認制度です。
もしも薬の承認が、単純にたった一度の治験で薬が効かないことを意味する帰無仮説のP値がα未満になったかどうかだけで行われていれば、実際には効かない薬が大量に承認される可能性が高い。続く
もしも薬の承認が、単純にたった一度の治験で薬が効かないことを意味する帰無仮説のP値がα未満になったかどうかだけで行われていれば、実際には効かない薬が大量に承認される可能性が高い。続く
91
#統計 実際にはそうなっていないわけです。
不正行為を防ぐための事前登録などの工夫だけではなく、第1,2,3相の治験のすべてを勝ち抜いた薬のみが承認されるという制度になっています。
効かない薬が承認されまくることを防ぐには、多段階勝ち抜き戦という厳しい試練を課す必要があるのです。続く
不正行為を防ぐための事前登録などの工夫だけではなく、第1,2,3相の治験のすべてを勝ち抜いた薬のみが承認されるという制度になっています。
効かない薬が承認されまくることを防ぐには、多段階勝ち抜き戦という厳しい試練を課す必要があるのです。続く
92
#統計 統計的に有意だが実際には正しくない結果が記された論文が大量に出版されることを本当に防ぎたいなら、薬の承認制度と同等の厳しい試練を研究に課す必要があります。事前登録制度だけでは足りず、多段階勝ち抜き戦をすべて勝利するという条件を課す必要がある。続く
93
#統計 現実には普通の科学研究にそういう厳しい試練を課すのは苦しすぎるわけです。それが現状なわけ。この問題にシンプルで安価な解決策は多分ない。
P値とは違う部分で様々な工夫(必要なら厳しい試練を課すことを含む)がないと、P値を使った科学研究の信頼性は確保できないのは確かなことです。
P値とは違う部分で様々な工夫(必要なら厳しい試練を課すことを含む)がないと、P値を使った科学研究の信頼性は確保できないのは確かなことです。
94
#統計 P値<5%やらP値<1%は冷静に色々考えてみれば、科学的信頼性を保証するための条件としては弱すぎる条件です。
P値について教える場合には、そういう弱い条件をクリアした程度で自信過剰にならないように注意するべきです。
P値について教える場合には、そういう弱い条件をクリアした程度で自信過剰にならないように注意するべきです。
95
#統計 こういう話をすると「意識の高い」よく分かっていない人たちが「だからP値ではなく、ベイズを使うべきだ」のようにイーカゲンなことを言うのですが、P値の代わりにベイズ統計を使っても以上で述べたような問題は解決しません。
厳しい試練を課すなどの外部での工夫の方が重要。
厳しい試練を課すなどの外部での工夫の方が重要。
黒木玄 Gen Kuroki@genkuroki
#統計 #Julia言語
線形回帰のβ₁に関するP値関数
と
βとlog σ²について平坦な事前分布での
ベイズ版線形回帰のβ₁に関する事後分布
は数学的に「同等」なので、
線形回帰に関するP値を使う方法とベイズ法の違い
は
事前分布の平坦分布との違い
にちょうど対応。
github.com/genkuroki/publ…
線形回帰のβ₁に関するP値関数
と
βとlog σ²について平坦な事前分布での
ベイズ版線形回帰のβ₁に関する事後分布
は数学的に「同等」なので、
線形回帰に関するP値を使う方法とベイズ法の違い
は
事前分布の平坦分布との違い
にちょうど対応。
github.com/genkuroki/publ…
96
#統計 このスレッドを読んで、「P値関数やベイズ統計について学んでも意味がない」のように思った人は誤解しています。
正しい理解の仕方は「P値関数やベイズ統計程度のことさえ理解していないようでは全然ダメ。P値関数やベイズ統計を理解しても全然足りず、それ以上のことも理解する必要がある」
正しい理解の仕方は「P値関数やベイズ統計程度のことさえ理解していないようでは全然ダメ。P値関数やベイズ統計を理解しても全然足りず、それ以上のことも理解する必要がある」
97
#統計 ベイズ統計での事後分布は、データの数値とモデル(事前分布を含む)+パラメータの値の設定の相性の良さの様子を表す。
周辺尤度は、データの数値とモデル(事前分布を含む)の相性の良さ(適合度)の指標。
WAICの差はデータの数値から得られる予測分布達の予測精度の差の推定値。一致性はない。
周辺尤度は、データの数値とモデル(事前分布を含む)の相性の良さ(適合度)の指標。
WAICの差はデータの数値から得られる予測分布達の予測精度の差の推定値。一致性はない。
98
#統計 P値に関する解説の追加
あるルーレットを20回まわしたら当たりが5回出たとする。
このとき、仮に当たりが出る確率が1/2だとしたら、20回中当たりが5回__以下__しか出ない確率は2.07%になり、その2倍の4.14%がClopper-PearsonのP値になります。続く
あるルーレットを20回まわしたら当たりが5回出たとする。
このとき、仮に当たりが出る確率が1/2だとしたら、20回中当たりが5回__以下__しか出ない確率は2.07%になり、その2倍の4.14%がClopper-PearsonのP値になります。続く
99
#統計 正確には二項分布モデルを仮定しているので、二項分布モデルに関するP値になります。
仮に当たりが出る確率が1/2だとしたら、20回中当たりが__ちょうど__5回出る確率は1.48%になり、これは尤度(ゆうど)と呼ばれます。
P値と尤度の違いに注意!続く
仮に当たりが出る確率が1/2だとしたら、20回中当たりが__ちょうど__5回出る確率は1.48%になり、これは尤度(ゆうど)と呼ばれます。
P値と尤度の違いに注意!続く
100
#統計 「20回中当たりが5回」というデータの数値に関する二項分布モデル+「当たりが出る確率は1/2」のClopper-PearsonのP値は4.14%で尤度は1.48%です。
どちらも、データの数値とモデル+パラメータの値の設定の相性の良さの指標として使われます。ただし、P値と尤度は別の取り扱いが必要です。続く
どちらも、データの数値とモデル+パラメータの値の設定の相性の良さの指標として使われます。ただし、P値と尤度は別の取り扱いが必要です。続く
101
#統計 もっと極端に「20回中当たりが2回」というデータ数値が得られた場合には、仮に当たりが1/2の確率で出るなら、20回中2回以下しか当たりが出ない確率は0.02%になり、2倍して得られるCPのP値は0.04%程度の非常に小さな値になります。続く
102
#統計 このことは、
「20回中当たりが2回」というデータの数値
と
二項分布モデル+「当たりが出る確率は1/2」という仮定
の相性が非常に悪いことを意味していると解釈できます。
P値はこういう考え方で得られる値です。もっと一般の場合も数学的にややこしくなるだけで考え方は同じ。
「20回中当たりが2回」というデータの数値
と
二項分布モデル+「当たりが出る確率は1/2」という仮定
の相性が非常に悪いことを意味していると解釈できます。
P値はこういう考え方で得られる値です。もっと一般の場合も数学的にややこしくなるだけで考え方は同じ。
103
#統計 「20回中当たりが2回」というデータの数値と「当たりが出る確率は1/2」という仮説の相性は常識的な感覚でも非常に悪いと感じるのが普通だと思います。
その感覚を二項分布モデルを使って定量化した結果がClopper-PearsonのP値の0.04%になります。
そういう感覚の他の定量化に尤度もある。
その感覚を二項分布モデルを使って定量化した結果がClopper-PearsonのP値の0.04%になります。
そういう感覚の他の定量化に尤度もある。
104
#統計 P値はその絶対的な値自体をデータとモデルの相性の良さの指標として使える点が便利です。
尤度をデータとモデルの相性の良さの指標として使う場合には、2つのモデルの尤度の比を見て、相性の良さの相対的な違いを見るための指標として使われることになります。
尤度をデータとモデルの相性の良さの指標として使う場合には、2つのモデルの尤度の比を見て、相性の良さの相対的な違いを見るための指標として使われることになります。
105
#統計 P値と尤度(ゆうど)の話を同時にしたい理由は、
それらを考える前に「データとモデルの相性の良さ」を考えることには価値があることは明らかであり、そのために使える定量化の自然な方法(もしくは容易に思い付く方法)としてP値や尤度が出て来る
のように考えて欲しいからです。
それらを考える前に「データとモデルの相性の良さ」を考えることには価値があることは明らかであり、そのために使える定量化の自然な方法(もしくは容易に思い付く方法)としてP値や尤度が出て来る
のように考えて欲しいからです。
106
#統計 「データとモデルの相性の良さ」の定量化の仕方としてP値と尤度の2つの方法があることを知れば、
P値を使った場合と尤度を使った場合で異なる結果が得られること
への心配が当然生じます。こういう建設的な疑問が自然に出て来る点もP値と尤度を同時に説明することの利点になる。続く
P値を使った場合と尤度を使った場合で異なる結果が得られること
への心配が当然生じます。こういう建設的な疑問が自然に出て来る点もP値と尤度を同時に説明することの利点になる。続く
107
#統計 中心極限定理を巧妙に使うと、尤度関数の情報だけを使って近似的なP値を定義できます。
二項分布モデルの場合には、確率を正確に計算することによって得られたP値と尤度関数の情報だけを使って計算された近似的なP値が標本サイズが大きいとき近似的に一致することを数学的に証明できます。続く
二項分布モデルの場合には、確率を正確に計算することによって得られたP値と尤度関数の情報だけを使って計算された近似的なP値が標本サイズが大きいとき近似的に一致することを数学的に証明できます。続く
108
#統計 このようにして、尤度関数の情報だけを使った統計分析の結果と、モデル内での確率を正確に計算することによって得られるP値を使った統計分析の結果は、標本サイズを十分に大きくすればほぼ同じになることが保証される。
こういう話を面白いと感じる人は数理統計学に片足を突っ込んでいる。
こういう話を面白いと感じる人は数理統計学に片足を突っ込んでいる。
109
#統計 入門的教科書で天降り的に説明されているP値やら尤度(ゆうど)やらについては、天降り的説明を信じて受け入れるのではなく、もっと素朴で根源的な考え方から自然に出て来るものだと理解できれば、複雑に見えていたことが一挙に単純に見えて来ることになります。ただし数学的スキルは必須。
110
#統計 このスレッドでは、P値について色々な説明を試みているのですが、書いている本人が結構勉強になっている。
「データの数値とモデルの相性の良さ(整合性、適合度)をどのように測るか」という素朴な発想から出発して、P値や尤度を自然に出すというストーリーは悪くなさそう。
「データの数値とモデルの相性の良さ(整合性、適合度)をどのように測るか」という素朴な発想から出発して、P値や尤度を自然に出すというストーリーは悪くなさそう。
111
#統計 補足
『宇宙怪人しまりす 統計よりも重要なことを学ぶ』の試し読み
asakura.tameshiyo.me/9784254122978?…
にも、Pハッキングのような不正がない理想化された状況であっても、「P値<α」という条件で結論を出すと再現性がない場合が大きな割合で生じがちなことを示す計算例が載っています。
『宇宙怪人しまりす 統計よりも重要なことを学ぶ』の試し読み
asakura.tameshiyo.me/9784254122978?…
にも、Pハッキングのような不正がない理想化された状況であっても、「P値<α」という条件で結論を出すと再現性がない場合が大きな割合で生じがちなことを示す計算例が載っています。
黒木玄 Gen Kuroki@genkuroki
#統計 試し読みのpp.4-6での指摘
有意水準5%と検出力80%の伝統的に標準化された設定で理想的に仮説検定を実行可能な場合であっても、テストする薬の中で効く薬の割合が10%の場合には、統計的に有意な結果が得られた薬で再度のテストでも有意になる確率は63%でしかない。
asakura.tameshiyo.me/9784254122978?…
有意水準5%と検出力80%の伝統的に標準化された設定で理想的に仮説検定を実行可能な場合であっても、テストする薬の中で効く薬の割合が10%の場合には、統計的に有意な結果が得られた薬で再度のテストでも有意になる確率は63%でしかない。
asakura.tameshiyo.me/9784254122978?…
112
#統計 相互リンク
黒木玄 Gen Kuroki@genkuroki
#統計 以下のリンク先で示した「P値に関するお勧めコース」を「履修」すれば、P値に関する誤解は、数学的素養が足りないというような問題では__なく__て、科学的に常識的な考え方を統計学の文脈ではなぜかできなくなっているという問題であることが分かると思います。非論理的な常識の欠如の問題。
113
#統計 不正無しであっても、ほぼ確実に帰無仮説が成立していると考えられる状況で仮説検定による2値的な判断をしてはいけないことを示すための例として、私は「財布から無作為に取り出した硬貨」をよく例に使っています。続く
黒木玄 Gen Kuroki@genkuroki
#統計 仮説検定は理想的に行われた場合であっても取り扱い注意です。
教室にいる無作為に選んだ生徒に財布から10円玉または100円玉を無作為に取り出させて5回投げさせたら5回続けて表が出たならば、片側P値は1/32≈3.1%です。これを理由にその硬貨が細工されていると判断するのはナンセンスです。
教室にいる無作為に選んだ生徒に財布から10円玉または100円玉を無作為に取り出させて5回投げさせたら5回続けて表が出たならば、片側P値は1/32≈3.1%です。これを理由にその硬貨が細工されていると判断するのはナンセンスです。
114
#統計 あなたが財布から無作為に取り出した100円玉を10回投げたら10回とも表が出たとします。
そのときの「表の出る確率は1/2である」の両側P値は0.2%程度とかなり小さくなります。
それを理由に「その100円玉は細工されている」と判断することは合理的でしょうか?続く
そのときの「表の出る確率は1/2である」の両側P値は0.2%程度とかなり小さくなります。
それを理由に「その100円玉は細工されている」と判断することは合理的でしょうか?続く
115
#統計 細工された違法100円玉はほぼまったく流通していないので、10回投げて10回全部表が出た程度のことで、その100円玉は細工されていると判断することは不合理です。
P値<αによる2値的判断がそれなりに合理的になるためには、帰無仮説が成立していない可能性が十分に高い必要があります。
P値<αによる2値的判断がそれなりに合理的になるためには、帰無仮説が成立していない可能性が十分に高い必要があります。
116
#統計 条件付き確率(ベイズの定理)の説明のために、
病気かどうかを調べる検査では、検査する人たちの中に実際に病気の人が十分高い割合で含まれていないと、偽陽性率が高くなってしまうこと
をよく例に使います。P値<αという条件を使う仮説検定についても同じことを言えます。
病気かどうかを調べる検査では、検査する人たちの中に実際に病気の人が十分高い割合で含まれていないと、偽陽性率が高くなってしまうこと
をよく例に使います。P値<αという条件を使う仮説検定についても同じことを言えます。
117
#統計 薬の承認のための治験は第1,2,3相に分割された多段階勝ち抜き戦のすべてに勝利する制度になっています。
最終の第3相までに効く可能性が十分にある薬のみを残すことに成功すれば、第3相での最終決着をP値<αを使う仮説検定で行ってもそれなりに合理的だということになります。
最終の第3相までに効く可能性が十分にある薬のみを残すことに成功すれば、第3相での最終決着をP値<αを使う仮説検定で行ってもそれなりに合理的だということになります。
118
#統計 現実には、第2相のデータを見て、第3相での主要評価項目を改めて決めている場合もあって、そういう場合には第3相までに達成されるべきフィルタリングが不十分になっている可能性が高くなり、最終結果の信頼性も低くなるように思えます。
119
#統計 もしかしたら、上で述べた「財布から無作為に取り出した100円玉に関する仮説検定」は研究としてはあり得ない話のように思う人もいるかもしれませんが、世の中には「超能力に関する仮説検定」の結果を論文に書いて投稿する人もいるので、そういう人対策のためには役に立つ話になっています。
120
#統計 P値<αという条件による2値的判断をするときには、帰無仮説が正しくない可能性が十分に高いかどうかを気にする必要があることについては添付画像も参照。このように私が述べていることは有名である。
添付画像は
repun-app.fish.hokudai.ac.jp/pluginfile.php…
アレックス・ラインハート著『ダメな統計学』
より。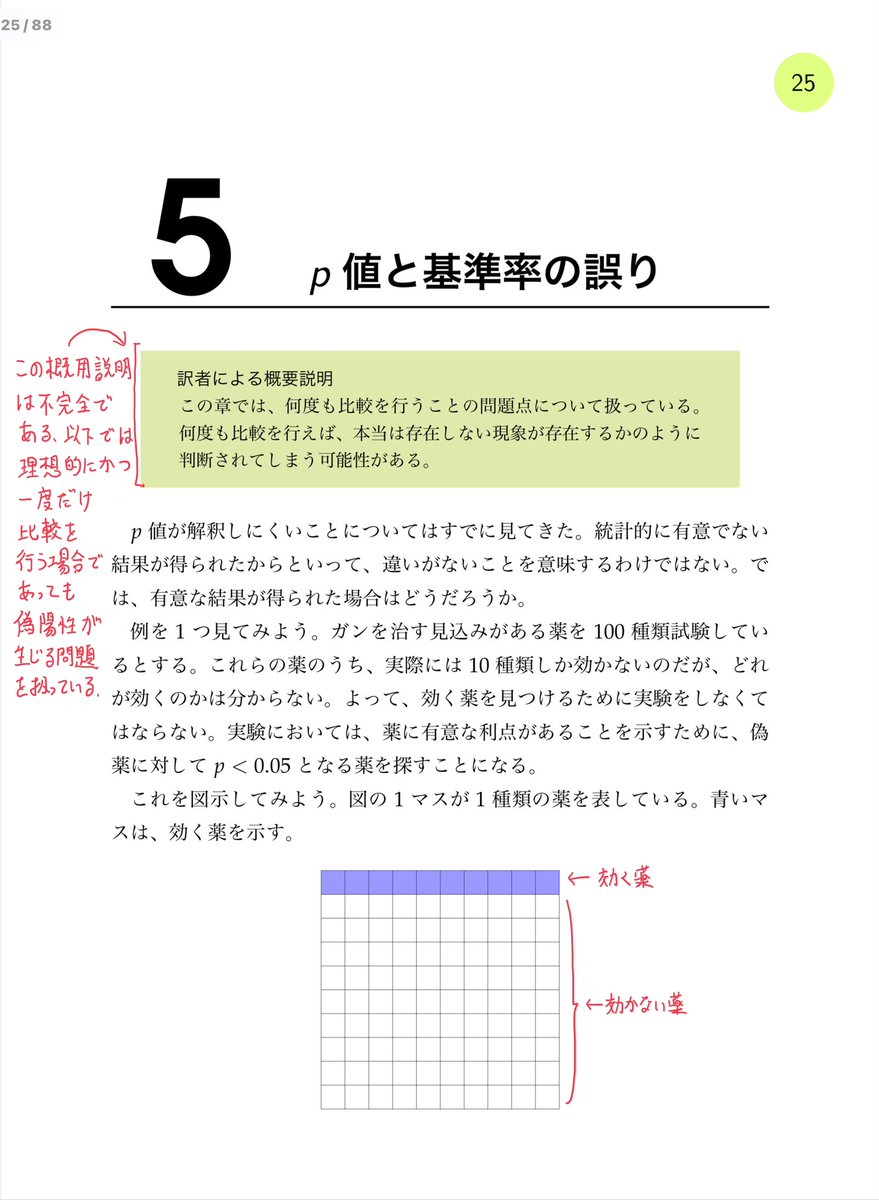

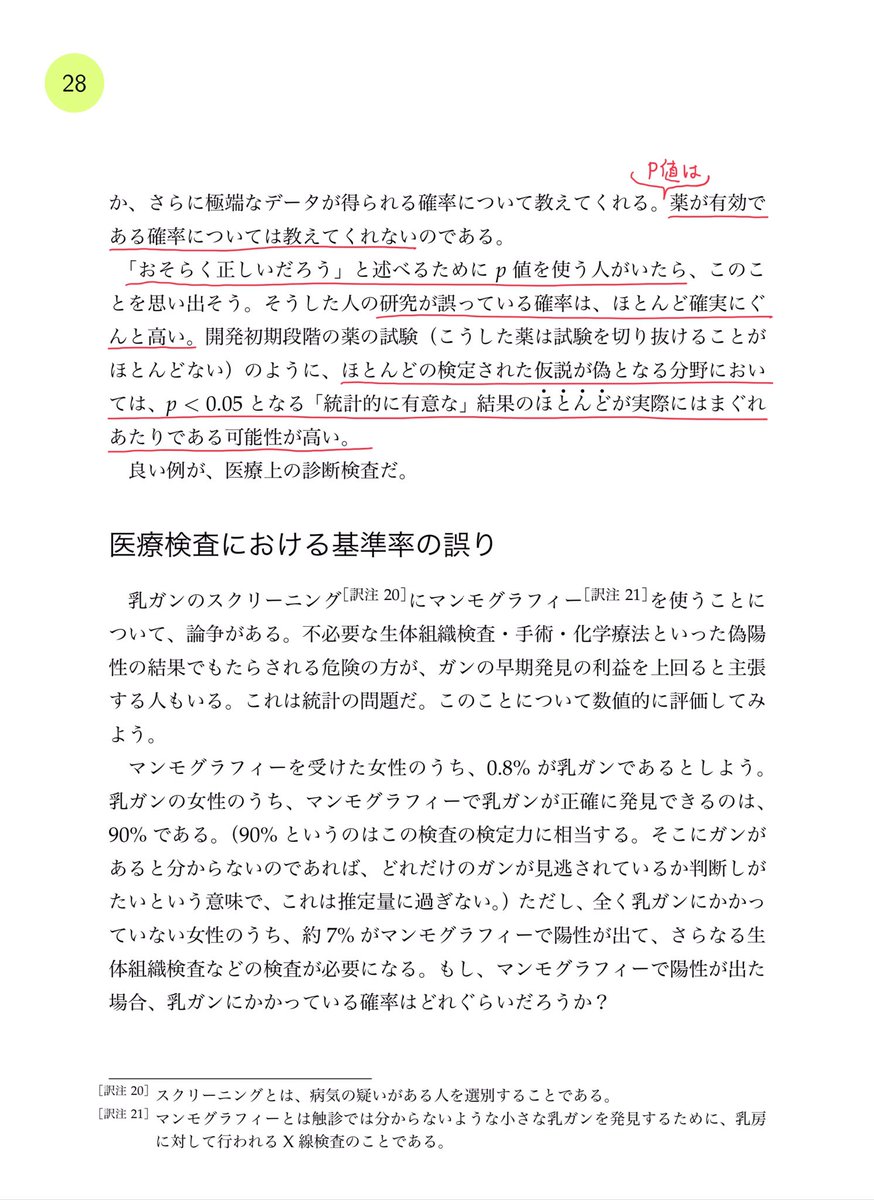
添付画像は
repun-app.fish.hokudai.ac.jp/pluginfile.php…
アレックス・ラインハート著『ダメな統計学』
より。
121
#統計 例えば、超能力実験を誠実に行って一切の不正無しに統計的に有意(P値<α)という結果が得られたという報告を見ても、「超能力はない」を意味する帰無仮説はほぼ絶対的に確実に正しいので、もしかしたら超能力があるかもしれないと考える必要はないということになります。
黒木玄 Gen Kuroki@genkuroki
#統計 もしかしたら、上で述べた「財布から無作為に取り出した100円玉に関する仮説検定」は研究としてはあり得ない話のように思う人もいるかもしれませんが、世の中には「超能力に関する仮説検定」の結果を論文に書いて投稿する人もいるので、そういう人対策のためには役に立つ話になっています。
122
#統計 このスレッドでは普通に常識的に考えればP値<αという条件による2値的判断の危険性は明らかであることを強調しています。
しかし、たまに見る馬鹿げた主張の「P値を使うべきでない」には一切与していません。
P値は尤度(ゆうど)やベイズ統計の事後分布と同様に__便利な道具__です。
しかし、たまに見る馬鹿げた主張の「P値を使うべきでない」には一切与していません。
P値は尤度(ゆうど)やベイズ統計の事後分布と同様に__便利な道具__です。
123
#統計 P値<αという条件による2値的判断のためにP値について説明すると、危険で間違った説明になりがち。安全なP値の説明法が必要です。それが
P値は、データの数値とモデル(検定したい仮説を含む)の相性の良さ(整合性、適合度)の指標の1つである
なのです。この説明は2値的判断を前提にしていない。
P値は、データの数値とモデル(検定したい仮説を含む)の相性の良さ(整合性、適合度)の指標の1つである
なのです。この説明は2値的判断を前提にしていない。
124
#統計 「仮に~ならば、~となる確率(P値と呼ぶ)は小さい」のスタイル(例: 仮に当たりが出る確率が1/2なら、20回中当たりが5回以下しか出ない確率は約2%である)でのP値に関するよく見る説明は、P値が仮説とデータの数値の相性の良さを表すことの説明だとみなせばよい。2値的判断は必須ではない。
黒木玄 Gen Kuroki@genkuroki
#統計 P値に関する解説の追加
あるルーレットを20回まわしたら当たりが5回出たとする。
このとき、仮に当たりが出る確率が1/2だとしたら、20回中当たりが5回__以下__しか出ない確率は2.07%になり、その2倍の4.14%がClopper-PearsonのP値になります。続く
あるルーレットを20回まわしたら当たりが5回出たとする。
このとき、仮に当たりが出る確率が1/2だとしたら、20回中当たりが5回__以下__しか出ない確率は2.07%になり、その2倍の4.14%がClopper-PearsonのP値になります。続く
125
#統計 あと、普通に常識的に考えることができるなら、すぐに有害であることが分かるような説明の仕方を、
分かりやすい大雑把な説明の仕方
であるかのようにみなす行為はやめるべき。
そして、間違いを指摘されることを恐れる暇があるなら、恐れがなくなるような適切な勉強をするべき。
分かりやすい大雑把な説明の仕方
であるかのようにみなす行為はやめるべき。
そして、間違いを指摘されることを恐れる暇があるなら、恐れがなくなるような適切な勉強をするべき。
黒木玄 Gen Kuroki@genkuroki
#統計 以下のリンク先で示した「P値に関するお勧めコース」を「履修」すれば、P値に関する誤解は、数学的素養が足りないというような問題では__なく__て、科学的に常識的な考え方を統計学の文脈ではなぜかできなくなっているという問題であることが分かると思います。非論理的な常識の欠如の問題。
126
#統計 大学の先生が「有意差があることを示すためにP値を計算する」のように説明したら、真っ当な考え方を見つけた若い学生に「先生、P値に関するその説明は間違っています。『統計的有意性とP値に関するASA声明』を読んで下さい」と言われてしまうようになると良いと思います。
127
#統計 P値について有害な解説をずっとして来た大学の先生に対して学生の側が本気で対抗するなら、何度も繰り返し勧めているSander Greenlandさんの講演スライド
biostat.ucdavis.edu/sites/g/files/…
を読んでおくと良いと思います。このスライドには、誤りの指摘だけではなく、適切な説明の仕方も書いてある。
biostat.ucdavis.edu/sites/g/files/…
を読んでおくと良いと思います。このスライドには、誤りの指摘だけではなく、適切な説明の仕方も書いてある。
128
#統計 P値を「有意差を出す」という2値的判断のための道具とみなさずに、Greenlandさんのように、推定の道具だとみなせば良いのです。P値は
背景となるモデルの下でのデータの数値とパラメータの値の相性の良さの指標の1つ
なので、パラメータの値の推定に使えます。
biostat.ucdavis.edu/sites/g/files/…
背景となるモデルの下でのデータの数値とパラメータの値の相性の良さの指標の1つ
なので、パラメータの値の推定に使えます。
biostat.ucdavis.edu/sites/g/files/…
129
#統計 例えば、ルーレットを20回まわしたら5回当たりが出たというデータが得られたときの、横軸に当たりが出る確率pをとったときの二項分布モデルでのP値のグラフは添付画像のようになります。
このグラフを見ればデータの数値と相性が悪くなさそうな当たりが出る確率pの推定値の範囲が分かります。

このグラフを見ればデータの数値と相性が悪くなさそうな当たりが出る確率pの推定値の範囲が分かります。
黒木玄 Gen Kuroki@genkuroki
@con_advancing #統計 P値は、データの数値とモデル+パラメータの値の設定の相性の良さ(compatibility)の指標の1つです。
例えば、
(1) 20回中5回表が出たというデータの数値
に関する
(2) 二項分布モデル+表の出る確率は1/2という仮説
のWilsonのP値は2.5%で、この値は(1)と(2)の相性の良さを表します。続く
例えば、
(1) 20回中5回表が出たというデータの数値
に関する
(2) 二項分布モデル+表の出る確率は1/2という仮説
のWilsonのP値は2.5%で、この値は(1)と(2)の相性の良さを表します。続く
130
#統計 コインを20回投げたら5回表が出た状況で、「表が出る確率はp=1/2」という帰無仮説のP値はグラフから5%未満であることもわかります。
P値を2値的判断の道具とみなす不適切な説明ではそのような単独のP値しか使わない。
だから、ダメなのです。nullismという病気。
P値を2値的判断の道具とみなす不適切な説明ではそのような単独のP値しか使わない。
だから、ダメなのです。nullismという病気。
131
#統計 P値を「P値<α」という条件による2値的判断のための道具としてではなく、推定の道具だとみなることは、教科書には載っていません。
教科書の権威に従いたい人達には難しいことのように感じるかもしれませんが、グラフを描いて素直に見れば何も難しいことはありません。
biostat.ucdavis.edu/sites/g/files/…
教科書の権威に従いたい人達には難しいことのように感じるかもしれませんが、グラフを描いて素直に見れば何も難しいことはありません。
biostat.ucdavis.edu/sites/g/files/…
132
#統計
大学の先生が学生に「差がない」ことを意味する帰無仮説単独のP値を計算するように言ったら、その先生よりも理解度が高い学生の側はP値関数の全体のグラフのプロットも行った
というようなことが普通になれば愉快だと思います。そしてそういう学生が将来大学で教える側になればよい。
大学の先生が学生に「差がない」ことを意味する帰無仮説単独のP値を計算するように言ったら、その先生よりも理解度が高い学生の側はP値関数の全体のグラフのプロットも行った
というようなことが普通になれば愉快だと思います。そしてそういう学生が将来大学で教える側になればよい。
133
#統計 P値もまた推定のための道具であったという説明の仕方は、2値的判断を強いる仮説検定よりも、確率的及びそれ以外の原因で生じる不確定性を考慮した推定の重視への移行という流れにも合致しています。
推定のための基本的な道具としてP値が重要なことを強調すれば良い。
推定のための基本的な道具としてP値が重要なことを強調すれば良い。
134
#統計 「P値を使うのをやめる」というような極端で不合理な意見と違って、「P値は確率的な不確定性を考慮に入れた推定のための道具である」という認識に移行することには、みんながずっと使って来たP値を捨てずにそのまま使い続けられるという利点があります。過去の遺産を捨てずに先に進める。
黒木玄 Gen Kuroki@genkuroki
#統計 P値を「P値<α」という条件による2値的判断のための道具としてではなく、推定の道具だとみなることは、教科書には載っていません。
教科書の権威に従いたい人達には難しいことのように感じるかもしれませんが、グラフを描いて素直に見れば何も難しいことはありません。
biostat.ucdavis.edu/sites/g/files/…
教科書の権威に従いたい人達には難しいことのように感じるかもしれませんが、グラフを描いて素直に見れば何も難しいことはありません。
biostat.ucdavis.edu/sites/g/files/…
135
#統計 ただし「P値は確率的な不確定性を考慮に入れた推定のための道具である」という認識に移行するためには、今まであまり使って来なかったP値も使う必要があります。
「差がない」の型のゼロ仮説のP値だけではなく、任意の数値aに関する「差はaである」の型の検定仮説のP値も扱う必要がある。
「差がない」の型のゼロ仮説のP値だけではなく、任意の数値aに関する「差はaである」の型の検定仮説のP値も扱う必要がある。
136
#統計 P値が確率的な不確定性を考慮した推定のための道具にちょうどなっていることの理解のためには、コイン投げの場合について、「表の出る確率はp=1/2」という仮説だけではなく、「表の出る確率はp=aである」の型の仮説のP値をすべての値aについて考えて、そのグラフをプロットするとよいと思う。
137
#統計 P値は対数スケールで見た方が誤解が減るかもしれないという話もあります。S値
S値 = -log₂ P値 (単位はbit)
とおいて、P値の違いの大きさは、S値の差の大きさで測ると良いです。
80%のP値と40%のP値の違いは1bitに過ぎず、8%のP値と4%のP値の1bitの違いに等しい。
biostat.ucdavis.edu/sites/g/files/…
S値 = -log₂ P値 (単位はbit)
とおいて、P値の違いの大きさは、S値の差の大きさで測ると良いです。
80%のP値と40%のP値の違いは1bitに過ぎず、8%のP値と4%のP値の1bitの違いに等しい。
biostat.ucdavis.edu/sites/g/files/…
138
#統計 5%のP値と7%や3.5%のP値の違いは0.5 bitに過ぎない。
5%の閾値よりP値が大きいから小さいかで勝負している人達はそういう1 bitにも満たない情報量の違いに異様にこだわっていることになります。
そういうのは非常に特別な条件の下でのみ科学的にまとも扱い可能です。大抵の場合はアウト。
5%の閾値よりP値が大きいから小さいかで勝負している人達はそういう1 bitにも満たない情報量の違いに異様にこだわっていることになります。
そういうのは非常に特別な条件の下でのみ科学的にまとも扱い可能です。大抵の場合はアウト。
139
#統計 5%の閾値は、100%との比較で4.3 bitの違う所に境目を設けているに過ぎません(-log₂ 0.05≈4.32)。
4.3 bitの情報量で科学的に信頼できる結論が得られるはずがない。もっとたくさんの情報が必要だと考える方が普通で常識的だと思います。
4.3 bitの情報量で科学的に信頼できる結論が得られるはずがない。もっとたくさんの情報が必要だと考える方が普通で常識的だと思います。
140
#統計 非常に大雑把な話になるのですが、一般に-log(確率)のことを情報量と呼ぶことがあります。(log(確率)はエントロピーと呼ばれることがある。)
情報量を単位bitで表示したいときには、対数の底を2にとる。確率5%に対応する情報量は-log₂(0.05)=4.32 (単位はbit)。
情報量を単位bitで表示したいときには、対数の底を2にとる。確率5%に対応する情報量は-log₂(0.05)=4.32 (単位はbit)。
141
#統計 私がどうして「相性の良さ」という言い方が良いと考えるようになったかについて説明しましょう。
P値はデータの数値とモデル+パラメータの値の設定の相性の良さの指標の1つ。
このようにP値を解釈すると「その解釈は誤り!」と非難される理由がほぼなくなり、ストレスフリーになります!続く
P値はデータの数値とモデル+パラメータの値の設定の相性の良さの指標の1つ。
このようにP値を解釈すると「その解釈は誤り!」と非難される理由がほぼなくなり、ストレスフリーになります!続く
黒木玄 Gen Kuroki@genkuroki
#統計 このスレッドでは、P値について色々な説明を試みているのですが、書いている本人が結構勉強になっている。
「データの数値とモデルの相性の良さ(整合性、適合度)をどのように測るか」という素朴な発想から出発して、P値や尤度を自然に出すというストーリーは悪くなさそう。
「データの数値とモデルの相性の良さ(整合性、適合度)をどのように測るか」という素朴な発想から出発して、P値や尤度を自然に出すというストーリーは悪くなさそう。
142
#統計 「相性の良さ」はどんなものの組み合わせについても語ることができます。
例えば、不適切な方法で取得したデータの数値と妥当でないことが分かっているモデル+パラメータの値の設定についてP値を計算して、それらの相性の良さの度合いを測ることも合法的になります。
続く
例えば、不適切な方法で取得したデータの数値と妥当でないことが分かっているモデル+パラメータの値の設定についてP値を計算して、それらの相性の良さの度合いを測ることも合法的になります。
続く
143
#統計 さらに悪質なことに(笑)、データの数値を見ながら、P値が小さく/大きくなるようにモデルをでっちあげて、相性が悪い/良いと言うことも合法的です。
「データの数値に相性が悪い/良い仮説を考えてみた」というときに、相性の良さをP値で測っているだけなのだから、全然問題がない。続く
「データの数値に相性が悪い/良い仮説を考えてみた」というときに、相性の良さをP値で測っているだけなのだから、全然問題がない。続く
144
#統計 さらに、固定されたモデル+パラメータの値の設定について、データの数値から計算したP値が十分小さくなるまでデータのサイズを順序増やすという悪質な行為をした場合にも、
固定されたモデル+パラメータの値の設定と相性が悪いデータを作れた
と言うこと自体には罪はありません。続く
固定されたモデル+パラメータの値の設定と相性が悪いデータを作れた
と言うこと自体には罪はありません。続く
145
#統計 そのようにして作られたデータの数値を使って何か科学的に意味のある結論が得られたかのように語るのとひじょーによろしくないのですが、「そのようにして作ったデータの数値と固定されたモデル+パラメータの値の設定の相性が悪い」というのは単なる事実なのでそのように言うだけなら罪はない。
146
#統計 怪しげなデータの数値と妥当でなさそうなモデルであっても、それらの相性の良さを測るだけなら害はありません。
本当は怪しげなデータの数値を使って科学的結論を出そうとしたり、妥当でないモデルを妥当でないという事実を隠して使って結論を出そうとすると罪になる。続く
本当は怪しげなデータの数値を使って科学的結論を出そうとしたり、妥当でないモデルを妥当でないという事実を隠して使って結論を出そうとすると罪になる。続く
147
#統計 P値はデータの数値とモデル+パラメータの値の設定の相性の良さの指標の1つである、というP値の解釈の仕方の利点は、P値の使用を科学的結論を出すことから切り離せることにあります。
P値を使うことが即科学的結論を出すことに結び付いているかのような説明とはそこが全然違います。
P値を使うことが即科学的結論を出すことに結び付いているかのような説明とはそこが全然違います。
148
#統計 怪しいデータの数値とモデルの組み合わせのP値も単なる相性の良さだと解釈できる。そういう類のもの単体で科学的結論は出せない。
科学的な結論を出すことはあらゆる知識と情報を使って行うべき困難な仕事です。「相性の良さ」で解釈すればそういう仕事におけるP値の地位は自然に下がります。
科学的な結論を出すことはあらゆる知識と情報を使って行うべき困難な仕事です。「相性の良さ」で解釈すればそういう仕事におけるP値の地位は自然に下がります。
149
#統計 例えば、あるコインを10回投げたら10回とも表が出たとします。そのとき、二項分布モデル+表の出る確率は1/2であるという仮説の組み合わせのP値は約0.2%と非常に小さくなります。
そのことだけを理由に「このコインは細工されているだろう」と結論するのは誤りです。続く
そのことだけを理由に「このコインは細工されているだろう」と結論するのは誤りです。続く
150
#統計 例えば、そのコインがあなたの財布から無作為に取り出した何の変哲もない100円玉だとします。
流通している100円玉で細工されたもの(違法!)はほぼ皆無だと考えられるので、10回連続で表が出た程度で「細工されているだろう」と判断することは不合理です。続く
流通している100円玉で細工されたもの(違法!)はほぼ皆無だと考えられるので、10回連続で表が出た程度で「細工されているだろう」と判断することは不合理です。続く
151
#統計 一方、
10回続けて表が出たというデータの数値と二項分布モデル+表の出る確率は1/2という仮説の組み合わせは相性が非常に悪い
と言っても何ら害はありません。
このように「相性の良さ」というP値の解釈は安全に気軽に使えるので非常に便利だと思います。
10回続けて表が出たというデータの数値と二項分布モデル+表の出る確率は1/2という仮説の組み合わせは相性が非常に悪い
と言っても何ら害はありません。
このように「相性の良さ」というP値の解釈は安全に気軽に使えるので非常に便利だと思います。
152
#統計 相性の良さによるP値の解釈を述べた人は、相手に「単にデータの数値とモデル+パラメータの値の相性に良さの度合いについて述べただけで、科学的な結論をまだ出せていない」という印象を与えることになり、科学的結論が欲しいならばそのために必要な別の困難な議論を強制されることにもなります。
153
#統計 ある新素材の枕を使用した30人中24人が「以前よりよく眠れた」と回答したというデータが得られたとき、二項分布モデル+「以前よりよく眠れたと回答する確率は1/2」という帰無仮説のP値は非常に小さいので、それらの相性が非常に悪いということは正しいが、「効果がある」と即断するのは誤り。
黒木玄 Gen Kuroki@genkuroki
#統計 上で紹介した文科省著作物で示唆された教え方については添付画像のような実践報告がされています。
新素材の枕だけを試させてもダメで比較対象が必要だという非常にもっともな意見を述べている生徒S7の意見は潰されています。
jstage.jst.go.jp/article/jssep/…
新素材の枕だけを試させてもダメで比較対象が必要だという非常にもっともな意見を述べている生徒S7の意見は潰されています。
jstage.jst.go.jp/article/jssep/…
154
#統計 続き。例えば「新素材の枕だ」と言われて渡されたことが原因で生じているプラセボ効果のせいで「以前よりよく眠れた」と答えた人の割合が多めになったのかもしれない。新素材と旧素材の枕をランダムに配布して調査し直す方が良さそうである。いずれにせよ比較対象の設定が必要。
155
#統計 統計的有意性(P値<αとなること)を科学的結論の保証として使うことは科学的に有害です。
だからP値をそのように使うと教えて来た人達は態度を改める必要があります。
そのときP値の解釈の仕方が宙ぶらりんにならないようにするために「相性の良さ」という解釈は非常に便利です。
だからP値をそのように使うと教えて来た人達は態度を改める必要があります。
そのときP値の解釈の仕方が宙ぶらりんにならないようにするために「相性の良さ」という解釈は非常に便利です。
黒木玄 Gen Kuroki@genkuroki
#統計 「統計的有意性とP値に関するASA声明」でも他の真っ当なすべての解説でも、P値<αという条件による安易な2値的判断をしてはいけないということになっています。
「統計的有意性」で結論を出すこと自体が有害であるというコンセンサスがすでにあるようにも見える。
biometrics.gr.jp/news/all/ASA
「統計的有意性」で結論を出すこと自体が有害であるというコンセンサスがすでにあるようにも見える。
biometrics.gr.jp/news/all/ASA
156
#統計 補足。
確定した数値としてのデータの数値ではなく、母集団分布の標本分布に従う確率変数としてデータを扱うことがよくありますが、P値を「データの数値とモデル+パラメータの値の設定の相性の良さの指標」だと解釈するときには、データの数値は確率変数ではなく確定した数値で構いません。
確定した数値としてのデータの数値ではなく、母集団分布の標本分布に従う確率変数としてデータを扱うことがよくありますが、P値を「データの数値とモデル+パラメータの値の設定の相性の良さの指標」だと解釈するときには、データの数値は確率変数ではなく確定した数値で構いません。
黒木玄 Gen Kuroki@genkuroki
#統計 怪しいデータの数値とモデルの組み合わせのP値も単なる相性の良さだと解釈できる。そういう類のもの単体で科学的結論は出せない。
科学的な結論を出すことはあらゆる知識と情報を使って行うべき困難な仕事です。「相性の良さ」で解釈すればそういう仕事におけるP値の地位は自然に下がります。
科学的な結論を出すことはあらゆる知識と情報を使って行うべき困難な仕事です。「相性の良さ」で解釈すればそういう仕事におけるP値の地位は自然に下がります。
157
#統計 その意味で、P値の「相性の良さ」による解釈の仕方は、追加の仮定(例えばデータは確率変数であるとかの追加の仮定)を一切使わずに済む解釈の仕方だと言えます。
この辺も、P値もしくは仮説検定に関する伝統的な(ゆえによろしくない)解説に洗脳された人は難解だと誤解しがちだと思います。
この辺も、P値もしくは仮説検定に関する伝統的な(ゆえによろしくない)解説に洗脳された人は難解だと誤解しがちだと思います。
158
#統計 これは酷い!
「統計的有意性とP値に関するASA声明」には「P値<α」という統計的有意性の条件によってお墨付きが得られたかのようにみなすことは「科学のプロセスを著しく損ねている」と書いてあります。
そういう有害な考え方をリンボーダンスのたとえで読者の心に焼き付けようとしている。

「統計的有意性とP値に関するASA声明」には「P値<α」という統計的有意性の条件によってお墨付きが得られたかのようにみなすことは「科学のプロセスを著しく損ねている」と書いてあります。
そういう有害な考え方をリンボーダンスのたとえで読者の心に焼き付けようとしている。


159
#統計 Googleで"P値" "リンボーダンス"を検索 google.com/search?q=%22P%… すると、P値のダメな使い方をリンボーダンスのたとえで説明している他の事例も見つかりました。
その1つの内容はまるっきり間違っていた。
統計学の入門的解説はこんなのが多数派。深刻な問題だと思います。続く
その1つの内容はまるっきり間違っていた。
統計学の入門的解説はこんなのが多数派。深刻な問題だと思います。続く
160
#統計 istat.co.jp/special/05/2 には添付画像のように、P値の有害な使い方(安易な二分法)をリンボーダンスのたとえによって印象深く説明しようとしています。
ギャグも入れることによって、読者が有害な考え方を信じて忘れないように工夫している。
ある種のちょー算数教師とほぼ同レベル。続く
ギャグも入れることによって、読者が有害な考え方を信じて忘れないように工夫している。
ある種のちょー算数教師とほぼ同レベル。続く
161
#統計 同ページ istat.co.jp/special/05/2 には添付画像のようにまるっきり間違っている解説があります。
信頼区間が重なっていてもP値<0.05となる場合があります。
そういうデータの一例
↓
X = [32, 38, 40, 46, 47, 47, 48, 48, 58, 59]
Y = [34, 41, 47, 50, 51, 58, 58, 61, 62, 63, 67, 72]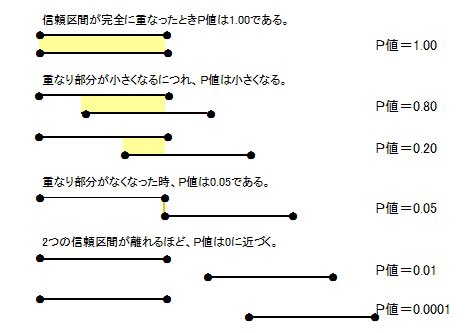
信頼区間が重なっていてもP値<0.05となる場合があります。
そういうデータの一例
↓
X = [32, 38, 40, 46, 47, 47, 48, 48, 58, 59]
Y = [34, 41, 47, 50, 51, 58, 58, 61, 62, 63, 67, 72]
162
#統計 データ
X = [32, 38, 40, 46, 47, 47, 48, 48, 58, 59]
Y = [34, 41, 47, 50, 51, 58, 58, 61, 62, 63, 67, 72]
の母平均の95%信頼区間は重なりを持ちますが、Welchのt検定のP値は約4%になります。
ソースコード
↓
github.com/genkuroki/publ…
X = [32, 38, 40, 46, 47, 47, 48, 48, 58, 59]
Y = [34, 41, 47, 50, 51, 58, 58, 61, 62, 63, 67, 72]
の母平均の95%信頼区間は重なりを持ちますが、Welchのt検定のP値は約4%になります。
ソースコード
↓
github.com/genkuroki/publ…
163
#統計 「統計的有意性とP値に関するASA声明」では、統計的有意性(P値<αという条件)によって科学的にお墨付きが得られたかのように説明することは科学的に有害だと強く非難されています。
しかし、普及しているP値の使い方はまさにその有害なP値の使い方で、有害な使い方の解説の側が圧倒的多数派。
しかし、普及しているP値の使い方はまさにその有害なP値の使い方で、有害な使い方の解説の側が圧倒的多数派。
黒木玄 Gen Kuroki@genkuroki
#統計 「統計的有意性とP値に関するASA声明」でも他の真っ当なすべての解説でも、P値<αという条件による安易な2値的判断をしてはいけないということになっています。
「統計的有意性」で結論を出すこと自体が有害であるというコンセンサスがすでにあるようにも見える。
biometrics.gr.jp/news/all/ASA
「統計的有意性」で結論を出すこと自体が有害であるというコンセンサスがすでにあるようにも見える。
biometrics.gr.jp/news/all/ASA
164
#統計 すでに普及してしまっている「統計的に有意」という言い方について、統計学入門で解説せざるを得ないと思います。
そのときには『ロスマンの疫学第2版』のp.214の説明をそのままするのが良いと思います。この本の第8章のP値に関する解説は非常に良いです。

そのときには『ロスマンの疫学第2版』のp.214の説明をそのままするのが良いと思います。この本の第8章のP値に関する解説は非常に良いです。
黒木玄 Gen Kuroki@genkuroki
#統計 P値や「統計的に有意」の意味については、『ロスマン疫学第2版』pp.213-214を引用しておけば無難だと思う。
⭕️P値がどんなに小さくても帰無仮説を否定するには不十分である
や
⭕️「統計的有意」は「P値 < α」の言い換えに過ぎず、それを超える意味はない
とかを当然だと思う必要がある。
⭕️P値がどんなに小さくても帰無仮説を否定するには不十分である
や
⭕️「統計的有意」は「P値 < α」の言い換えに過ぎず、それを超える意味はない
とかを当然だと思う必要がある。
165
#統計 「真の分布」という言い方を知っている人のための補足
P値を「データの数値とモデル+パラメータの値の設定の相性の良さの指標の1つ」とみなす解釈では、データの数値の背後に真の分布があると仮定する必要はありません。
そういう感じの意味で「相性の良さ」という解釈では追加の仮定は不要。
P値を「データの数値とモデル+パラメータの値の設定の相性の良さの指標の1つ」とみなす解釈では、データの数値の背後に真の分布があると仮定する必要はありません。
そういう感じの意味で「相性の良さ」という解釈では追加の仮定は不要。
黒木玄 Gen Kuroki@genkuroki
#統計 補足。
確定した数値としてのデータの数値ではなく、母集団分布の標本分布に従う確率変数としてデータを扱うことがよくありますが、P値を「データの数値とモデル+パラメータの値の設定の相性の良さの指標」だと解釈するときには、データの数値は確率変数ではなく確定した数値で構いません。
確定した数値としてのデータの数値ではなく、母集団分布の標本分布に従う確率変数としてデータを扱うことがよくありますが、P値を「データの数値とモデル+パラメータの値の設定の相性の良さの指標」だと解釈するときには、データの数値は確率変数ではなく確定した数値で構いません。
166
#統計 P値を「データの数値とモデル+パラメータの値の設定の相性の良さの指標の1つ」だと解釈しても、科学的な結論は何も得られない。この点が非常に重要。
そのお陰でそういうP値の解釈を使う人は科学的結論を出すためには追加の困難な議論を強制されることになる。この点は科学的に非常に好ましい。
そのお陰でそういうP値の解釈を使う人は科学的結論を出すためには追加の困難な議論を強制されることになる。この点は科学的に非常に好ましい。
167
#統計 1つ上のような使い方をするには、P値の解釈ではP値の力が弱いことを示唆する弱い言葉が好ましいと私は思いました。
「相性の良さ」とは別の候補として「整合性」「適合度」のような言葉も十分合理的で有力なのですが、最も弱く響くのは「相性の良さ」なので、「相性の良さ」を多用しています。
「相性の良さ」とは別の候補として「整合性」「適合度」のような言葉も十分合理的で有力なのですが、最も弱く響くのは「相性の良さ」なので、「相性の良さ」を多用しています。
黒木玄 Gen Kuroki@genkuroki
#統計 P値を「データの数値とモデル+パラメータの値の設定の相性の良さの指標の1つ」だと解釈しても、科学的な結論は何も得られない。この点が非常に重要。
そのお陰でそういうP値の解釈を使う人は科学的結論を出すためには追加の困難な議論を強制されることになる。この点は科学的に非常に好ましい。
そのお陰でそういうP値の解釈を使う人は科学的結論を出すためには追加の困難な議論を強制されることになる。この点は科学的に非常に好ましい。
168
#統計 ASA声明の原文は scholar.google.co.jp/scholar?cluste… 経由で読めます。その原則の1に原文は
1. P-values can indicate how incompatible the data are with a specified statistical model.
です。incompatibleという単語の翻訳は難しい。佐藤俊哉さんはhow incompatibleを「矛盾する程度」と翻訳。続く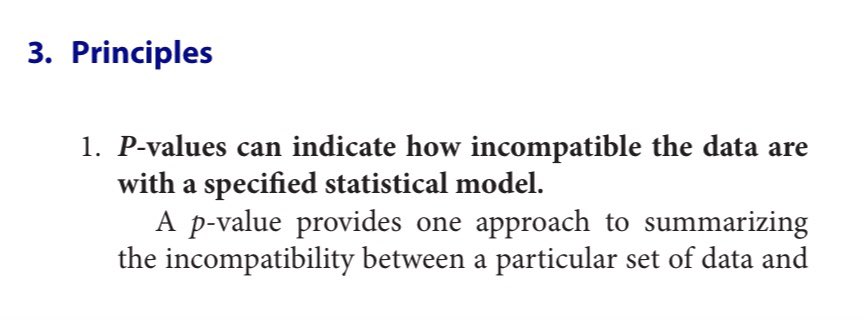
1. P-values can indicate how incompatible the data are with a specified statistical model.
です。incompatibleという単語の翻訳は難しい。佐藤俊哉さんはhow incompatibleを「矛盾する程度」と翻訳。続く
169
#統計 続き。しかし「矛盾する程度」の「矛盾する」は相当に強い響きを持つので、P値単体には大して力はないことを強調したい文書の翻訳では不適切だと私は思いました。
あと、P値は大きい方がよりcompatibleになるので、原則の1のhow incompatibleはhow compatibleとした方が良かったと思います。
あと、P値は大きい方がよりcompatibleになるので、原則の1のhow incompatibleはhow compatibleとした方が良かったと思います。
170
#統計 このスレッドでしている話は、佐藤俊哉さんを除けば、日本語圏にはまだ十分に輸入され切っていない考え方です。だから、翻訳の仕方にも気を使わされており、そういう話もちょっと面白いと思ったので紹介してみた。
compatibilityの翻訳が問題。私は現時点では「相性の良さ」と翻訳している。
compatibilityの翻訳が問題。私は現時点では「相性の良さ」と翻訳している。
171
#統計 ASA声明も厳密に読むと結構酷い書き方になっている部分があります。すぐそばで使われている2つの the data は完全に異なる意味だとする必要があります。
モデル内確率変数としてのデータ
と
実験観察で得られたデータの値
は厳密に無関係だとする必要がある。
scholar.google.co.jp/scholar?cluste…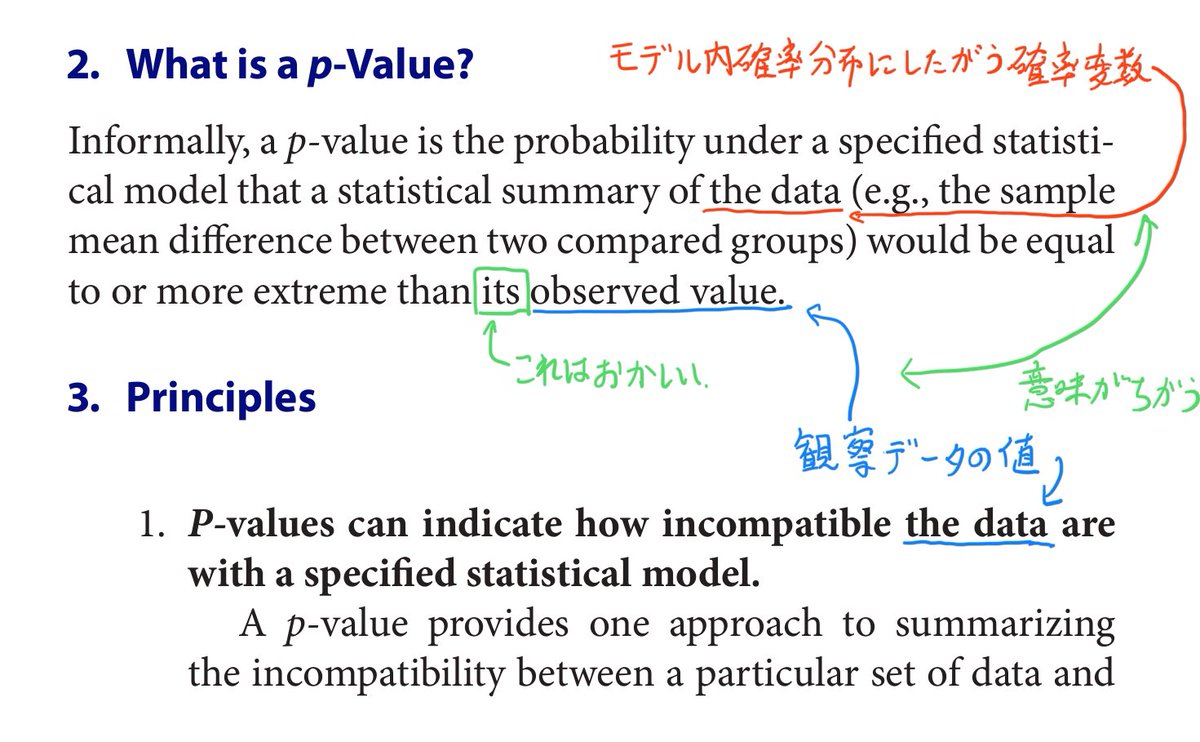
モデル内確率変数としてのデータ
と
実験観察で得られたデータの値
は厳密に無関係だとする必要がある。
scholar.google.co.jp/scholar?cluste…
172
#統計 例えば、S市の高校2年生の男子と女子の平均体重は等しい/等しくないという仮説について調べるために、標本を無作為抽出し、正規分布モデルを使ってWelchにt検定のP値を計算したとする。
そのとき現実で得られた標本の数値は、正規分布の標本分布の実現値ではありません。非常に当たり前の話!
そのとき現実で得られた標本の数値は、正規分布の標本分布の実現値ではありません。非常に当たり前の話!
173
#統計 しかし、伝統的な解説では、現実の母集団からの無作為抽出で得られた標本の数値と、正規分布などのモデルの分布の標本分布に従う確率変数の実現値の区別を曖昧にして話を先に進めたりしています。
そういう悪しき伝統のスタイルはASA声明でも十分に排除できていないのだと思いました。
そういう悪しき伝統のスタイルはASA声明でも十分に排除できていないのだと思いました。
174
#統計 ちなみに、ヒトの体重の分布は近似的にも正規分布に従わないことが知られています。身長の分布は正規分布でよく近似される。
体重の分布が近似的にも正規分布に従わないことが分かっていても、Welchのt検定を使うことは十分に合理的です。間違っているモデルが実践的には妥当な場合がある。
体重の分布が近似的にも正規分布に従わないことが分かっていても、Welchのt検定を使うことは十分に合理的です。間違っているモデルが実践的には妥当な場合がある。
175
#統計 ASA声明での原則の1でのP値の説明で、素直にcompatibleとせずに、incompatibleとした理由も悪しき伝統の踏襲に見えます。
その悪しき伝統とは、「P値<α」という条件で帰無仮説を否定するためにP値を使うことです。だから否定を含むincompatibleという単語を使いたくなってしまったのでしょう。
その悪しき伝統とは、「P値<α」という条件で帰無仮説を否定するためにP値を使うことです。だから否定を含むincompatibleという単語を使いたくなってしまったのでしょう。
黒木玄 Gen Kuroki@genkuroki
#統計 続き。しかし「矛盾する程度」の「矛盾する」は相当に強い響きを持つので、P値単体には大して力はないことを強調したい文書の翻訳では不適切だと私は思いました。
あと、P値は大きい方がよりcompatibleになるので、原則の1のhow incompatibleはhow compatibleとした方が良かったと思います。
あと、P値は大きい方がよりcompatibleになるので、原則の1のhow incompatibleはhow compatibleとした方が良かったと思います。
176
#統計 この投稿を含むスレッドの18個上の投稿で述べたように、リンボーダンスのたとえは、P値を統計的有意性(P値<αという条件)によって二分法的に用いること(ASA声明では有害とされている)を印象付けることになるので、納得した初学者はP値の有害な使い方を教わったことになると思います。

Ryuhei Tsuji 🇨🇭🇺🇸@ryuhei_tsuji
p値をリンボーダンスに例えるのって,もしかしてかなりポピュラーなのかな.(他のところでも見た.)
とりあえず,初学者を納得させるという点ではいいのかもしれないけど,教える側は,これで納得してないよね.
とりあえず,初学者を納得させるという点ではいいのかもしれないけど,教える側は,これで納得してないよね.
177
#統計 「統計的に有意」という言い方は権威的に響く印象的な言い方なので、そういう言い方があることを初学者に教える場合には
* 統計的有意性による科学的結論の保証は科学のプロセスを損ねている。
と強調する必要があると思います。
* 統計的有意性による科学的結論の保証は科学のプロセスを損ねている。
と強調する必要があると思います。
黒木玄 Gen Kuroki@genkuroki
#統計 「統計的有意性とP値に関するASA声明」でも他の真っ当なすべての解説でも、P値<αという条件による安易な2値的判断をしてはいけないということになっています。
「統計的有意性」で結論を出すこと自体が有害であるというコンセンサスがすでにあるようにも見える。
biometrics.gr.jp/news/all/ASA
「統計的有意性」で結論を出すこと自体が有害であるというコンセンサスがすでにあるようにも見える。
biometrics.gr.jp/news/all/ASA
178
#統計 しかし、「統計的に有意」はたとえ科学にとって有害な言い方であったとしても、不幸なことに広く普及してしまっているので、初学者にも教えざるを得ないと思います。
そのときには『ロスマンの疫学第2版』のp.214の説明をそのまま初学者に教えるのが良いと思います。
そのときには『ロスマンの疫学第2版』のp.214の説明をそのまま初学者に教えるのが良いと思います。
黒木玄 Gen Kuroki@genkuroki
#統計 すでに普及してしまっている「統計的に有意」という言い方について、統計学入門で解説せざるを得ないと思います。
そのときには『ロスマンの疫学第2版』のp.214の説明をそのままするのが良いと思います。この本の第8章のP値に関する解説は非常に良いです。
そのときには『ロスマンの疫学第2版』のp.214の説明をそのままするのが良いと思います。この本の第8章のP値に関する解説は非常に良いです。
179
#統計 「統計的有意性」による安易な二分法をやっても良いことかのように教えて来た(教えている)先生達は、「統計的有意性とP値に関するASA声明」でP値の誤用とされていることを生徒に教え込んで来た(教え込んでいる)ことになります。
多分非常に沢山いる。
多分非常に沢山いる。
黒木玄 Gen Kuroki@genkuroki
#統計 「統計的有意性とP値に関するASA声明」でも他の真っ当なすべての解説でも、P値<αという条件による安易な2値的判断をしてはいけないということになっています。
「統計的有意性」で結論を出すこと自体が有害であるというコンセンサスがすでにあるようにも見える。
biometrics.gr.jp/news/all/ASA
「統計的有意性」で結論を出すこと自体が有害であるというコンセンサスがすでにあるようにも見える。
biometrics.gr.jp/news/all/ASA
180
#統計 P値<αという統計的有意性に基く判断がどのようなときに全然有効でないかを説明するための例
↓
↓
黒木玄 Gen Kuroki@genkuroki
#統計 例えば、コインの山があって、その中の1万枚中1枚はイカサマコインであるとします。
イカサマでない大部分のコインでは投げたときに表が出る確率はちょうど0.5で、イカサマコインでは表が出る確率は0.5とは異なるとします。
そのコインの山から1枚のコインを無作為に取り出し、続く
イカサマでない大部分のコインでは投げたときに表が出る確率はちょうど0.5で、イカサマコインでは表が出る確率は0.5とは異なるとします。
そのコインの山から1枚のコインを無作為に取り出し、続く
181
#統計 Sander Greenlandさん(超大物)は、論文の編集時には「有意」(significant)の語をすべて削除して来たそうです。
そういう編集に同意が得られず、共著者から自分の名前を削除させた場合が一度だけあるらしい😅
添付画像 discourse.datamethods.org/t/principles-a… の終わりの2つの段落とその機械翻訳。
そういう編集に同意が得られず、共著者から自分の名前を削除させた場合が一度だけあるらしい😅
添付画像 discourse.datamethods.org/t/principles-a… の終わりの2つの段落とその機械翻訳。
182
#統計 統計的有意性(P値<αという条件)については、以下のリンク先で紹介したNHK高校講座のように教えてしまっている場合が珍しくないと思う。
科学的にはあまりにも非常識で酷いのですが、こういう教わり方で納得した人は、統計学の文脈でなら「すっきり~」できると誤解してしまう。納得しちゃダメ。
科学的にはあまりにも非常識で酷いのですが、こういう教わり方で納得した人は、統計学の文脈でなら「すっきり~」できると誤解してしまう。納得しちゃダメ。
黒木玄 Gen Kuroki@genkuroki
#統計 NHK高校講座はさらに酷いことに!
有意水準5%の片側検定によって
【やっぱりこのコイン、細工されてたんだなあ。うん。ぼくの思った通りだったよ!こんなふうに数学的に確かめる方法があったんですね。すっきり~】
と述べているのは酷い。そんな方法はない。
nhk.or.jp/kokokoza/suuga…
有意水準5%の片側検定によって
【やっぱりこのコイン、細工されてたんだなあ。うん。ぼくの思った通りだったよ!こんなふうに数学的に確かめる方法があったんですね。すっきり~】
と述べているのは酷い。そんな方法はない。
nhk.or.jp/kokokoza/suuga…
183
#統計 それでは、このスレッドの立場で、有意水準一定の条件の下で検出力を最大化するNeyman-Pearson的な考え方の位置付けはどうなるのか?
そういうNP的な考え方は単に「より良いP値関数を使った方が良い」という当たり前の話のより正確な定式化の一つとみなせます。続く
そういうNP的な考え方は単に「より良いP値関数を使った方が良い」という当たり前の話のより正確な定式化の一つとみなせます。続く
184
#統計 P値を実際に2値的判断に使わなくても、効率の悪いP値の構成法を使わない方がよいということには変わりがありません。
よりよいP値の構成のためにNeyman-Pearson的な対立仮説の検出力という指標を考慮することは合理的です。
よりよいP値の構成のためにNeyman-Pearson的な対立仮説の検出力という指標を考慮することは合理的です。
185
#統計 Neyman-PearsonのPearsonさんは、あとでaccept, rejectという用語選択は不幸な選択であったことを認めています。Fisherの考え方にも最初から賛成していたらしい。
Neyman-Pearsonスタイルを単純な二分法に戯画化して、Fisherスタイルと対比するのは不適切な行為だと思います。
Neyman-Pearsonスタイルを単純な二分法に戯画化して、Fisherスタイルと対比するのは不適切な行為だと思います。
黒木玄 Gen Kuroki@genkuroki
#統計 私のお気に入りは添付画像の部分。Pearsonさんは、"accept" "reject" という用語選択が失敗だったことを認め、Fisherさんと次の見方を共有しているとも述べている:
科学研究において統計的検定は"学習の手段"である
戯画化・過激化されたNP流検定とは全然違う。
errorstatistics.com/2017/11/19/eri…
科学研究において統計的検定は"学習の手段"である
戯画化・過激化されたNP流検定とは全然違う。
errorstatistics.com/2017/11/19/eri…
186
#統計 P値と有意水準を混同していたまるっきり間違っている説明を擁護してしまった人たちの不満の1つはこのスレッドが長過ぎることにようです。(長過ぎるのは、別の言葉で易しく説明したり、詳しく説明したりの繰り返しだから。)
私によるP値に関するざっくりとした短めの解説
↓
私によるP値に関するざっくりとした短めの解説
↓
黒木玄 Gen Kuroki@genkuroki
@con_advancing #統計 P値は、データの数値とモデル+パラメータの値の設定の相性の良さ(compatibility)の指標の1つです。
例えば、
(1) 20回中5回表が出たというデータの数値
に関する
(2) 二項分布モデル+表の出る確率は1/2という仮説
のWilsonのP値は2.5%で、この値は(1)と(2)の相性の良さを表します。続く
例えば、
(1) 20回中5回表が出たというデータの数値
に関する
(2) 二項分布モデル+表の出る確率は1/2という仮説
のWilsonのP値は2.5%で、この値は(1)と(2)の相性の良さを表します。続く
187
#統計 上の続き。その私によるざっくりとした説明は「統計的有意性とP値に関するASA声明」の原則の1の部分の具体例を使った説明になっています。
黒木玄 Gen Kuroki@genkuroki
#統計 統計学を教える仕事をする人は
統計的有意性とP値に関するASA声明
biometrics.gr.jp/news/all/ASA
には目を通しておいた方が無難。
これを読めば、P値に関する実践的に十分な説明と解釈法が得られます。
ただし添付画像への追記部分に注意することも必要。
統計的有意性とP値に関するASA声明
biometrics.gr.jp/news/all/ASA
には目を通しておいた方が無難。
これを読めば、P値に関する実践的に十分な説明と解釈法が得られます。
ただし添付画像への追記部分に注意することも必要。
188
#統計 ただし、ASA声明の翻訳の「矛盾する程度」は"how incompatible"なのですが、P値は大きい方がcompatibleなので"how compatible"に直し、さらに「矛盾」は強過ぎる言葉なので使うのをやめて、"how compatible"を「相性の良さ」と翻訳しています。
黒木玄 Gen Kuroki@genkuroki
#統計 続き。しかし「矛盾する程度」の「矛盾する」は相当に強い響きを持つので、P値単体には大して力はないことを強調したい文書の翻訳では不適切だと私は思いました。
あと、P値は大きい方がよりcompatibleになるので、原則の1のhow incompatibleはhow compatibleとした方が良かったと思います。
あと、P値は大きい方がよりcompatibleになるので、原則の1のhow incompatibleはhow compatibleとした方が良かったと思います。
189
#統計 「統計的有意性とP値に関するASA声明」でのP値に関する説明も以下のリンク先添付画像のようにざっくり短いのですが、「データ」が異なる二通りの意味で使われてしまっているので(英語原文もそうなっている)、初学者には解説が必要。
こういう理由からも説明を増やす必要があります。
こういう理由からも説明を増やす必要があります。
黒木玄 Gen Kuroki@genkuroki
#統計 統計学を教える仕事をする人は
統計的有意性とP値に関するASA声明
biometrics.gr.jp/news/all/ASA
には目を通しておいた方が無難。
これを読めば、P値に関する実践的に十分な説明と解釈法が得られます。
ただし添付画像への追記部分に注意することも必要。
統計的有意性とP値に関するASA声明
biometrics.gr.jp/news/all/ASA
には目を通しておいた方が無難。
これを読めば、P値に関する実践的に十分な説明と解釈法が得られます。
ただし添付画像への追記部分に注意することも必要。
190
#統計 このスレッドを書き始めた直後に、仕事で統計学を教えている人であっても、
「統計的有意性とP値に関するASA声明」を読んでも全然理解できない人達が結構いるのではないか
と思うようになりました。ASA声明はすでに持っているP値に関する間違った考え方を捨てることを要求している。
「統計的有意性とP値に関するASA声明」を読んでも全然理解できない人達が結構いるのではないか
と思うようになりました。ASA声明はすでに持っているP値に関する間違った考え方を捨てることを要求している。
191
#統計 ASA声明では、P値は、観察データの数値と統計モデル(検定したい仮説を含む)の相性の良さの程度の指標の1つなので、その理解には、パラメータ付き確率分布で記述された統計モデルの概念を知っていることが必須。
パラメータ付き確率分布について何も理解していない人はP値を利用できない。続く
パラメータ付き確率分布について何も理解していない人はP値を利用できない。続く
黒木玄 Gen Kuroki@genkuroki
@con_advancing #統計 P値は、データの数値とモデル+パラメータの値の設定の相性の良さ(compatibility)の指標の1つです。
例えば、
(1) 20回中5回表が出たというデータの数値
に関する
(2) 二項分布モデル+表の出る確率は1/2という仮説
のWilsonのP値は2.5%で、この値は(1)と(2)の相性の良さを表します。続く
例えば、
(1) 20回中5回表が出たというデータの数値
に関する
(2) 二項分布モデル+表の出る確率は1/2という仮説
のWilsonのP値は2.5%で、この値は(1)と(2)の相性の良さを表します。続く
192
#統計 パラメータ付き確率分布の概念の習得は統計学を使いたいと思っている多くの人達にとって結構高いハードルになります。しかし、P値を解釈して使うためには必須。
以下のリンク先では、パラメータ付き確率分布が高校でも習っているはずの二項分布の場合を例に使ってざっくりと説明しています。
以下のリンク先では、パラメータ付き確率分布が高校でも習っているはずの二項分布の場合を例に使ってざっくりと説明しています。
193
#統計 リンク先のざっくりした説明での重要なポイントの1つは、よく見るP値に関する有害な説明「P値は有意差を出すために使われる」に一切触れずに、それとは完全に異なる説明の仕方をしていることです。
有害な説明に洗脳済みの人にとっては脱洗脳が必要な分だけ理解が難しくなる。これが大問題。
有害な説明に洗脳済みの人にとっては脱洗脳が必要な分だけ理解が難しくなる。これが大問題。
黒木玄 Gen Kuroki@genkuroki
@con_advancing #統計 P値は、データの数値とモデル+パラメータの値の設定の相性の良さ(compatibility)の指標の1つです。
例えば、
(1) 20回中5回表が出たというデータの数値
に関する
(2) 二項分布モデル+表の出る確率は1/2という仮説
のWilsonのP値は2.5%で、この値は(1)と(2)の相性の良さを表します。続く
例えば、
(1) 20回中5回表が出たというデータの数値
に関する
(2) 二項分布モデル+表の出る確率は1/2という仮説
のWilsonのP値は2.5%で、この値は(1)と(2)の相性の良さを表します。続く
194
#統計 「P値は有意差を出すために使われる」のようなざっくりとした説明が有害な理由は、そのように説明された人は「差がある」「差がない」の杜撰な二分法に陥り易くなり、P値だけを使って安易に杜撰な二分法を実行するようになるから。
「統計的有意性とP値に関するASA声明」が出た理由そのもの。
「統計的有意性とP値に関するASA声明」が出た理由そのもの。
195
#統計 私が、P値に関する説明から「矛盾」という言葉を取り除いて、曖昧で弱い意味に聞こえる「相性の良さ」という言い方を使うようになった理由は「矛盾」という言葉は悪しき二分法を誘発するように思ったからです。
P値単体には確率的な危険性を考慮しながら矛盾を扱う力はありません。
P値単体には確率的な危険性を考慮しながら矛盾を扱う力はありません。
黒木玄 Gen Kuroki@genkuroki
#統計 ただし、ASA声明の翻訳の「矛盾する程度」は"how incompatible"なのですが、P値は大きい方がcompatibleなので"how compatible"に直し、さらに「矛盾」は強過ぎる言葉なので使うのをやめて、"how compatible"を「相性の良さ」と翻訳しています。
196
#統計 統計学における悪しき二分法の由来は、Neyman-Pearsonの仮説検定の戯画化(ぎがか)がまるで本物のように流布されたことです。
Pearsonさん自身は、仮説検定の意味での採択と棄却は最終的な採択と棄却を意味せず、仮説検定は不可逆な決定を強制しないという意味のことを言っています。
Pearsonさん自身は、仮説検定の意味での採択と棄却は最終的な採択と棄却を意味せず、仮説検定は不可逆な決定を強制しないという意味のことを言っています。
197
#統計 大学での統計学の講義で、Neyman-Pearsonの仮説検定では帰無仮説と対立仮説の片方を選択する2値的な決定を下すと教わった人は多いと思いますが、そういう教え方はNeyman-PearsonのPearsonさんの発言にもろに反しています。
まるっきりのデタラメを習ったと考えて良いと思います。
まるっきりのデタラメを習ったと考えて良いと思います。
198
#統計 Neyman-Pearsonの仮説検定であっても、仮説検定の意味での採択と棄却はそのような決定を実務的にも行うことを意味せず、仮説検定の結果は実務的には参考情報の1つでしかありません。
P値も明記することとNeyman-Pearsonの仮説検定は何も矛盾しない。
みんな大学でデタラメを習って来た。
P値も明記することとNeyman-Pearsonの仮説検定は何も矛盾しない。
みんな大学でデタラメを習って来た。
黒木玄 Gen Kuroki@genkuroki
#統計 Pearson (1955)には
NeymanとPearsonは「__最終的な__採択と棄却の話をしていない」し、「仮説検定が不可逆な採択の手続きを強制するべきだとは全然示唆していない」
とはっきり書いてあります。証拠提示終了!
戯画化されたNPについて騙る行為は滅びるべき!
NeymanとPearsonは「__最終的な__採択と棄却の話をしていない」し、「仮説検定が不可逆な採択の手続きを強制するべきだとは全然示唆していない」
とはっきり書いてあります。証拠提示終了!
戯画化されたNPについて騙る行為は滅びるべき!
199
#統計 「P値単体には確率的な危険性を考慮しながら矛盾を扱う力はない」ことには複数の理由があるが、P値がたとえ理想的に使用されたとしても(p-hackingのようなことをしていなくて、使用しているモデルも妥当であっても)、そういう力がないことの定量化による説明が以下のリンク先スレッドにある。
↓
↓
黒木玄 Gen Kuroki@genkuroki
#統計 簡単のため、候補の薬達は効く薬と効かない薬に単純に分かれており、両側検定で有意水準としてα=5% (効かない薬が効くと判定される確率はその半分の2.5%)を採用し、検出力はすべての場合で1-β=80%(効く薬が効くと判定される確率)だと仮定します。
この設定はスタンダードです。続く
この設定はスタンダードです。続く
200
#統計
追加の計算
↓
追加の計算
↓
201
#統計 このスレッドの主旨は、P値について概ね正しい説明をしている人に厳密な説明を強いることではなく、
P値について沢山の人達が長年に渡ってひどく有害な説明を信じて来たことを指摘すると同時に、厳密さにはこだわらずに無難で安全な代替的な説明の仕方を示すこと
です。
P値について沢山の人達が長年に渡ってひどく有害な説明を信じて来たことを指摘すると同時に、厳密さにはこだわらずに無難で安全な代替的な説明の仕方を示すこと
です。