#統計 東京大学出版会の『統計学入門』を警告抜きに他人に勧めるような人は統計学を全然理解していない人の可能性が高く要注意です。...

黒木玄 Gen Kuroki@genkuroki
65 views
Apr 02, 2025
~1 min read
Advertisement
1
#統計 東京大学出版会の『統計学入門』を警告抜きに他人に勧めるような人は統計学を全然理解していない人の可能性が高く要注意です。
あちこちにおかしな説明が地雷のように敷設されている本です。
例えば、『統計学入門』でのWelchのt検定での自由度の扱いもなぜか整数化しており、おかしいです。

あちこちにおかしな説明が地雷のように敷設されている本です。
例えば、『統計学入門』でのWelchのt検定での自由度の扱いもなぜか整数化しており、おかしいです。
黒木玄 Gen Kuroki@genkuroki
東京大学出版会の『統計学入門』を運悪く「真面目」に読んでしまい、それに従って、「確率ではなく、割合だ」というスタイルで「信頼区間警察」をやっている側が狼藉之義也の「ヒャッハー」達だという問題。
へたをするとこれが高校数学にも伝搬する恐れがある。
へたをするとこれが高校数学にも伝搬する恐れがある。
2
#統計 東京大学出版会『統計学入門』での統計学における基本概念(信頼区間、尤度、最尤法、パラメトリック、…)の解説はことごとく不適切なのですが、ついさっき、
よく使われているWelchのt検定さえ
まともに解説されていない
ことに気付きました。
この本を他人に勧めるときには警告が必要。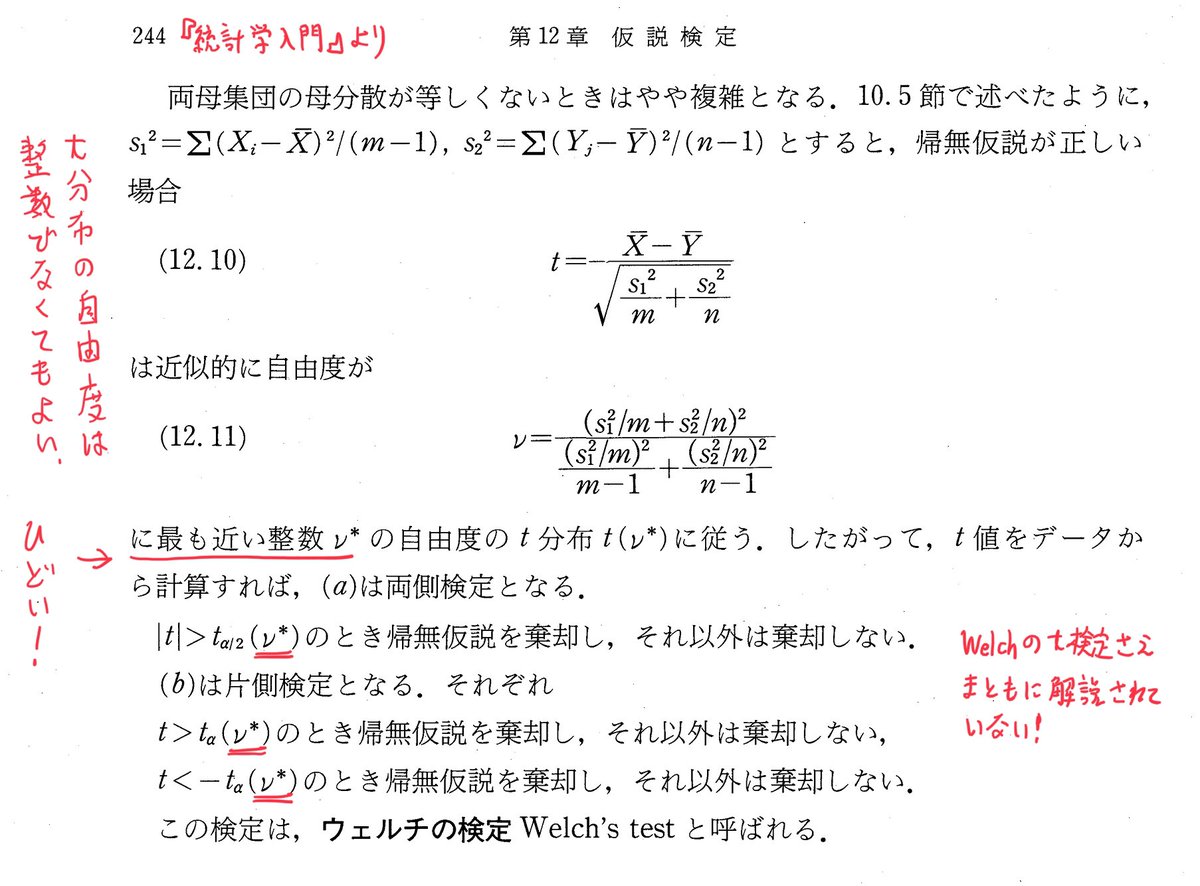
よく使われているWelchのt検定さえ
まともに解説されていない
ことに気付きました。
この本を他人に勧めるときには警告が必要。
3
#統計 以前からなぜかWelchのt検定での使う自由度を四捨五入などによって整数にすることにこだわる酷い解説があることは知っていましたが、東京大学出版会の『統計学入門』にもそういう酷い説明があったんですね。
この本で勉強した人はどこで恥をかくことになるか予測不可能かもしれません。
この本で勉強した人はどこで恥をかくことになるか予測不可能かもしれません。
4
#統計 私自身はやる気になれないのですが、東京大学出版会の『統計学入門』については、
読者が注意するべき不適切な説明のリスト
を誰か作った方が良いと思います。
この本は多くの人が読んでいるので、すでにそういうリストを作った人がいても不思議ではないです。是非とも公開して欲しいです。
読者が注意するべき不適切な説明のリスト
を誰か作った方が良いと思います。
この本は多くの人が読んでいるので、すでにそういうリストを作った人がいても不思議ではないです。是非とも公開して欲しいです。
5
#統計
不適切な説明が多いことを承知で読む
のと、
そうとは知らずに
内容をそのまま受け入れてしまう読み方を
不幸にもしてしまって、
この本の説明はあちこちとても酷いことを後で知って
がっかりする
のでは、その後のやる気が大きく違って来ると思います。
不適切な説明が多いことを承知で読む
のと、
そうとは知らずに
内容をそのまま受け入れてしまう読み方を
不幸にもしてしまって、
この本の説明はあちこちとても酷いことを後で知って
がっかりする
のでは、その後のやる気が大きく違って来ると思います。
6
#統計 『統計学入門』における「対立仮説」(p.235)と「検出力」(p.251)の説明も不明瞭もしくは不適切です。その説明で理解できたと感じる人が論理的に考えていないことになると思います。
よく分からない説明については正直に「分からない」ことを認めるべき。それくらいまずい説明。続く
よく分からない説明については正直に「分からない」ことを認めるべき。それくらいまずい説明。続く
7
#統計 例えば、平均パラメータμに関して、
帰無仮説 H₀: μ=15
対立仮説 H₁: μ≠15
という両側検定の設定を考えましょう(『統計学入門』p.237)。
問題:対立仮説はμ≠15という数式で表される単独の仮説であるか?
この問題に即答できないと対立仮説について理解したことになりません。
続く
帰無仮説 H₀: μ=15
対立仮説 H₁: μ≠15
という両側検定の設定を考えましょう(『統計学入門』p.237)。
問題:対立仮説はμ≠15という数式で表される単独の仮説であるか?
この問題に即答できないと対立仮説について理解したことになりません。
続く
8
#統計 答えは「いいえ」です。両側検定の設定における対立仮説は単独の仮説ではありません。
帰無仮説μ=15の両側検定の設定における対立仮説の正体は、
15以外の数値aで決まる仮説μ=aの
全体で構成された仮説の集合
になります。
この設定は検出力の話に繋がって行きます。続く
帰無仮説μ=15の両側検定の設定における対立仮説の正体は、
15以外の数値aで決まる仮説μ=aの
全体で構成された仮説の集合
になります。
この設定は検出力の話に繋がって行きます。続く
9
#統計 実際、『統計学入門』p.251には添付画像のように、検出力の説明のところで「複合仮説」という用語が説明されています。
両側検定や片側検定における対立仮説は単独の仮説ではなく、複数の仮説からなる複合仮説になります。
こういうことが分かるような説明になっていないと思います。
両側検定や片側検定における対立仮説は単独の仮説ではなく、複数の仮説からなる複合仮説になります。
こういうことが分かるような説明になっていないと思います。
10
#統計 帰無仮説μ=15の両側検定の検定法の検出力は、15以外の任意の数値aごとに決まる仮説μ=aごとに決まります。
検出力の定義は、μ=aと設定された統計モデル内で生成されたデータにその検定法を適用したときに帰無仮説μ=15が棄却される確率です。
つまり、検出力はaの函数になる。続く
検出力の定義は、μ=aと設定された統計モデル内で生成されたデータにその検定法を適用したときに帰無仮説μ=15が棄却される確率です。
つまり、検出力はaの函数になる。続く
11
#統計 aの函数である検出力はできるだけaについて一様に大きくなって欲しいわけです。
しかし、両側検定の場合にはその意味でベストな検定法は存在しない。
一方、片側検定ではaの動く範囲が15未満または15より大きいの片方に制限されるので、上の意味でベストの検定法を尤度比検定として作れます。
しかし、両側検定の場合にはその意味でベストな検定法は存在しない。
一方、片側検定ではaの動く範囲が15未満または15より大きいの片方に制限されるので、上の意味でベストの検定法を尤度比検定として作れます。
12
#統計 このように、複数ある対立仮説を決めるパラメータ値aごとに決まる検出力をできるだけ高くしたいという要求をしたとき、両側検定と片側検定でがaを動かす範囲が違うので、そこで両側検定と片側検定の違いが生じるわけです。
13
#統計 こういうことは、
複合仮説としての対立仮説
と
検出力を高くしたいという要請
の関係について考察して初めて理解できることです。
両側検定の対立仮説をμ≠15と書かれる単独の仮説だと誤解させるような説明はやめるべきです。
複合仮説としての対立仮説
と
検出力を高くしたいという要請
の関係について考察して初めて理解できることです。
両側検定の対立仮説をμ≠15と書かれる単独の仮説だと誤解させるような説明はやめるべきです。
14
#統計 以上を読めば、
帰無仮説 μ=15
対立仮説 μ≠15
は、対立仮説が「μは15でない」という単独の仮説であることを意味せず、対立仮説は数値a≠15に関するμ=aという仮説全体であることを理解できると思う。
この辺は多くの人が誤解しており、そにせいで両側検定を理解できなくなっていると思う。
帰無仮説 μ=15
対立仮説 μ≠15
は、対立仮説が「μは15でない」という単独の仮説であることを意味せず、対立仮説は数値a≠15に関するμ=aという仮説全体であることを理解できると思う。
この辺は多くの人が誤解しており、そにせいで両側検定を理解できなくなっていると思う。
15
#統計 以上で説明した複合仮説が出てくる仮説検定については、超有名な教科書の初版
Lehmann, Testing Statistical Hypotheses, 1959 (初版)
でクリアに説明されています。
twilog.org/genkuroki/sear…
Lehmann, Testing Statistical Hypotheses, 1959 (初版)
でクリアに説明されています。
twilog.org/genkuroki/sear…
16
#統計 講義で「普通は両側検定を使う」「帰無仮説がμ=μ₀のとき両側検定の対立仮説はμ≠μ₀になる」(←不適切な説明)と習った人が、検出力では「帰無仮説μ=μ₀、対立仮説μ=μ₁の場合には~」と説明されて、最も普通の両側検定はどこに行ったんだとなる。😅
このスレッドでこの不満を解消したつもり。
このスレッドでこの不満を解消したつもり。
17
#統計 そういう概念的なことに限らず、正規分布モデルを使った検定や区間推定が、全然正規分布でない母集団分布にどれだけ適用可能かに一切触れていない点は、統計学の実践的な応用時には非常に困った状態を作り出すことに貢献していると思います。
黒木玄 Gen Kuroki@genkuroki
#統計 正規分布モデルとt分布を使った平均の信頼区間では、中心極限定理が効いて来る状況なので、母集団分布が正規分布から少しだけずれている程度なら、95%信頼区間の95%は信頼できる数値になります。
しかしずれが大きいとアウトになります。
詳しくはツイログを参照
↓
twilog.org/genkuroki/sear…
しかしずれが大きいとアウトになります。
詳しくはツイログを参照
↓
twilog.org/genkuroki/sear…
18
#統計 竹内啓『数理統計学−データ解析の方法』の第19章には添付画像のように「正規分布の仮定の意味」の簡単な説明があります。
しかしそこに書いてあることだけで実践に役に立つレベルに理解には至らないと思います。コンピュータを使って、非正規母集団の場合に関する数値実験の経験が必要。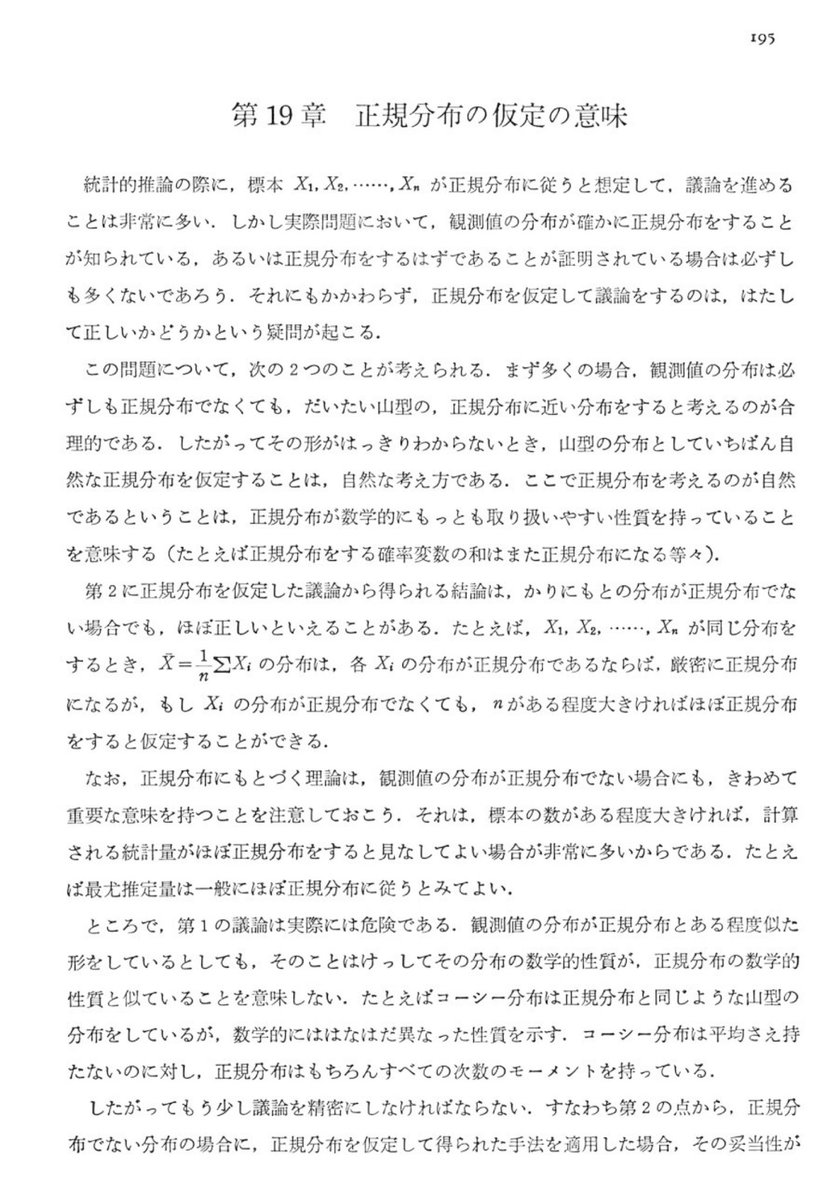
しかしそこに書いてあることだけで実践に役に立つレベルに理解には至らないと思います。コンピュータを使って、非正規母集団の場合に関する数値実験の経験が必要。
19
#統計 竹内啓『数理統計学−データ解析の方法』は古い本でかつ入門レベルの易しい本ではないのですが、色々面白く読めるように書かれていると個人的には思います。
20
#統計 下から7行目【ところで,第1の議論は実際には危険である】について
例えば、正規分布から少し違う母集団分布に、正規分布モデルを使った分散の区間推定を適用すると誤差が大きくなり易く危険です。
それとは対照的に、正規分布モデルを使った平均の区間推定は誤差が小さくなり易いです。
例えば、正規分布から少し違う母集団分布に、正規分布モデルを使った分散の区間推定を適用すると誤差が大きくなり易く危険です。
それとは対照的に、正規分布モデルを使った平均の区間推定は誤差が小さくなり易いです。
黒木玄 Gen Kuroki@genkuroki
#統計 竹内啓『数理統計学−データ解析の方法』の第19章には添付画像のように「正規分布の仮定の意味」の簡単な説明があります。
しかしそこに書いてあることだけで実践に役に立つレベルに理解には至らないと思います。コンピュータを使って、非正規母集団の場合に関する数値実験の経験が必要。
しかしそこに書いてあることだけで実践に役に立つレベルに理解には至らないと思います。コンピュータを使って、非正規母集団の場合に関する数値実験の経験が必要。
21
#統計 『統計学入門』p.217
最尤法の説明も酷いです。
尤度(ゆうど)は、データの数値と統計モデルの適合度(もしくは相性の良さ)の指標の1つとみなせる場合が多いのですが、オーバーフィッティングの問題を無視して尤度を「もっともらしさ」とみなすことは不適切です。続く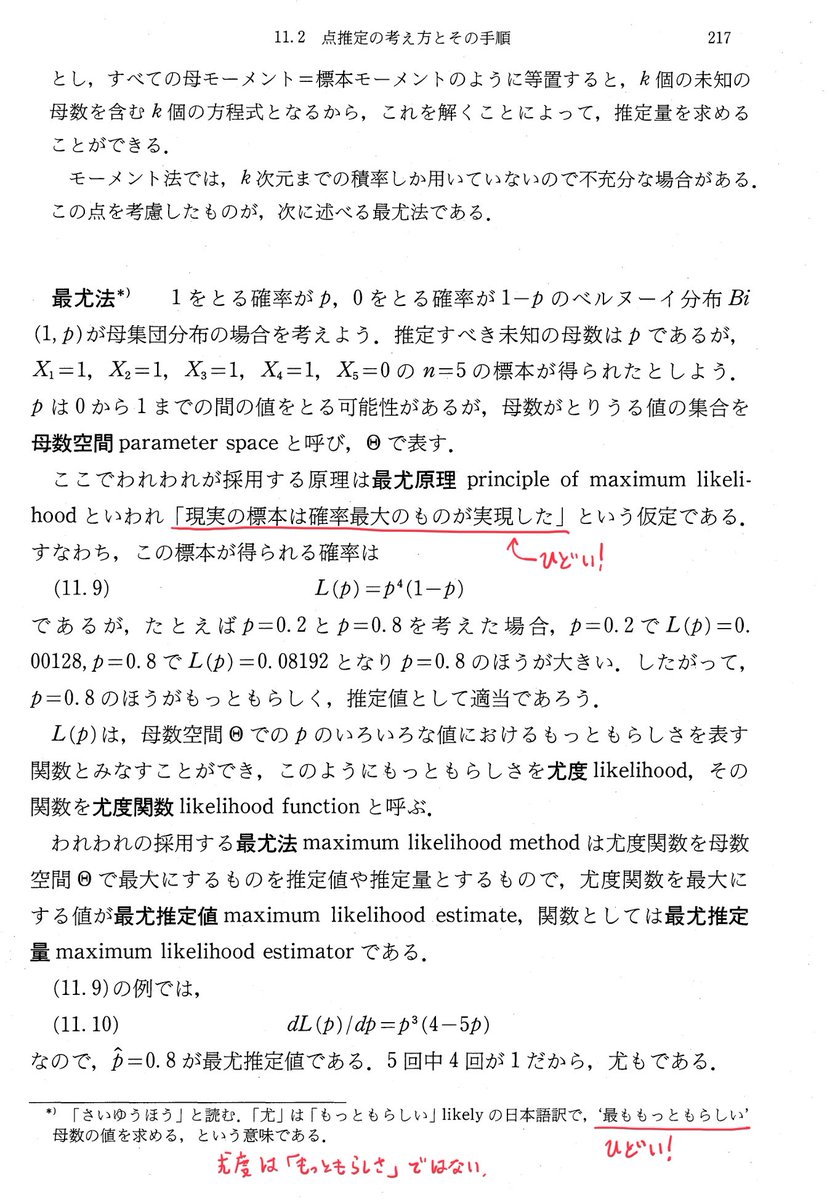
最尤法の説明も酷いです。
尤度(ゆうど)は、データの数値と統計モデルの適合度(もしくは相性の良さ)の指標の1つとみなせる場合が多いのですが、オーバーフィッティングの問題を無視して尤度を「もっともらしさ」とみなすことは不適切です。続く
22
#統計 『統計学入門』p.217
「現実の標本は確率最大のものが実現した」という仮定をすることがあたかもまともな行為であるかのように説明していることは非常識の極みで論外だと思います。続く
「現実の標本は確率最大のものが実現した」という仮定をすることがあたかもまともな行為であるかのように説明していることは非常識の極みで論外だと思います。続く
23
#統計 例えば、現実でコインを2回投げてどちらの表面が出たとします。
そのとき、Bernoulli分布モデルの尤度函数(=モデル内での表の出る確率を意味するパラメータ0≤p≤1にモデル内で2回続けて表が出る確率を対応させる函数)はp↦p²です。
これを最大化するpはp=1になります。続く
そのとき、Bernoulli分布モデルの尤度函数(=モデル内での表の出る確率を意味するパラメータ0≤p≤1にモデル内で2回続けて表が出る確率を対応させる函数)はp↦p²です。
これを最大化するpはp=1になります。続く
24
#統計 そういう理由で「この現実のコインでは表の出る確率は1だろう」などと言うことは非常識極まりないことでしょう。
仮に最尤法がそういうものなら、最尤法はクズ同然であり、存在意義はないと結論できます。続く
仮に最尤法がそういうものなら、最尤法はクズ同然であり、存在意義はないと結論できます。続く
25
#統計 もちろんそんなことはなくて、最尤法は単にデータの数値に(尤度の意味で)最も相性の良いパラメータ値を求めているだけだと解釈すれば、最尤法はクズではなく、特定の条件の下で強力な点推定の方法だと分かります。続く
26
#統計 上での最尤法の結果を、「コインを2回投げたら2回とも表が出た」というデータの数値に最も相性が良いBernoulli分布モデルのパラメータ値はp=1になる、と解釈すれば非常識な話にならずに済みます。
これだけの話なのだから教科書でもそのように説明して欲しいものだと思います。続く
これだけの話なのだから教科書でもそのように説明して欲しいものだと思います。続く
27
#統計 データの数値に尤度の意味で最も相性が良いパラメータ値としてのモデル内で表が出る確率(数学的フィクション)と、現実のコインに関する表が出る確率が全然別物です。
その区別を明瞭にしていれば、非常識な考え方を受け入れる失敗を犯さずに済むと思います。
その区別を明瞭にしていれば、非常識な考え方を受け入れる失敗を犯さずに済むと思います。
28
#統計 あと、最尤法に限らず、点推定の結果だけを報告することは、通常は非常識な行為だとされています。
点推定は確率的に誤差を含むので、その誤差の程度が分かるような情報と合わせて報告することが普通です。多くの場面で、信頼区間も同時に報告する習慣になっています。
点推定は確率的に誤差を含むので、その誤差の程度が分かるような情報と合わせて報告することが普通です。多くの場面で、信頼区間も同時に報告する習慣になっています。
29
#統計 Bernoulli分布モデルでは「n回中k回成功」というデータの数値から得られる最尤推定値は p = k/n になります。すなわち、「n回中k回成功」というデータの数値に尤度の意味で最も相性が良いパラメータ値は「モデル内での成功確率はk/nである」になります。続く
30
#統計 シンプルなモデルでの最尤推定はこういう自然な推定法を与えることが多いです。
正規分布モデルにおける平均μと分散σ²の最尤推定の結果=標本に尤度の意味で最も相性の良いパラメータ値は、μ=(標本平均)、σ²=(不偏補正無しの標本分散)になります。
正規分布モデルにおける平均μと分散σ²の最尤推定の結果=標本に尤度の意味で最も相性の良いパラメータ値は、μ=(標本平均)、σ²=(不偏補正無しの標本分散)になります。
31
#統計 シンプルなモデルでかつ標本サイズが十分に大きな場合には、最尤法は自然で強力な点推定法になります。
モデルが複雑になると最尤法の適用が不適切になることがあります。そのような場合には事前分布を使う方法が有用になることが多い。ベイズ主義と無関係にベイズ統計は強力な方法です。
モデルが複雑になると最尤法の適用が不適切になることがあります。そのような場合には事前分布を使う方法が有用になることが多い。ベイズ主義と無関係にベイズ統計は強力な方法です。
32
#統計 『統計学入門』での信頼区間の解説を訂正したい人は以下のリンク先スレッドを参照。
黒木玄 Gen Kuroki@genkuroki
#統計 正しい考え方
* 信頼区間の計算では通常パラメータを持つモデル(例えば正規分布モデルや二項分布モデルなど)が使われる。
* 95%信頼区間の95%はそのモデル内での標本分布で測った確率(の近似値)になる。
* 使用したモデルが現実において妥当でなければ、信頼区間は信頼できないものになる。
* 信頼区間の計算では通常パラメータを持つモデル(例えば正規分布モデルや二項分布モデルなど)が使われる。
* 95%信頼区間の95%はそのモデル内での標本分布で測った確率(の近似値)になる。
* 使用したモデルが現実において妥当でなければ、信頼区間は信頼できないものになる。
33
#統計 『統計学入門』では解説されていない現代的なP値、検定、信頼区間の解釈の仕方については、以下のリンク先で紹介した文献と講義動画を参照。
黒木玄 Gen Kuroki@genkuroki
#統計 P値や信頼区間に関するより現代的な知識は論文 journals.sagepub.com/doi/10.1177/02… で得られる。
統計的有意性とP値に関するASA声明 biometrics.gr.jp/news/all/ASA.p… は必読で、講義動画 ocwcentral.com/subjects/01GB4… には時代遅れな説明が書いてある教科書に批判的コメントがある。
これらの代替案に従えば無難。
統計的有意性とP値に関するASA声明 biometrics.gr.jp/news/all/ASA.p… は必読で、講義動画 ocwcentral.com/subjects/01GB4… には時代遅れな説明が書いてある教科書に批判的コメントがある。
これらの代替案に従えば無難。
34
#統計 何はともあれ、これを最初に視聴するべきかも。

黒木玄 Gen Kuroki@genkuroki
#統計 非常に素晴らしい講義が行われている証拠も容易に見つかるので、素晴らしい講義の側を繰り返し拡散するべきだとも思いました。
例えば、統計学入門の教科書によく書いてある誤解が素晴らしい講義で指摘されていたりする。
↓
ocwcentral.com/subjects/01GB4…
例えば、統計学入門の教科書によく書いてある誤解が素晴らしい講義で指摘されていたりする。
↓
ocwcentral.com/subjects/01GB4…
35
#統計 P値と信頼区間の組み合わせの使い方については以下のリンク先で紹介した論文が参考になります。
黒木玄 Gen Kuroki@genkuroki
#統計 McShane-Gelman stat.columbia.edu/~gelman/resear… では、「統計的に有意なだけではなく、大きな効果の推定値が得られた研究に大きな価値がある」としてしまうと、発表される研究結果に有害な偏りが生じることなどが指摘されています。
偏っている研究群についてのメタアナリシスは偏りを強化する。
偏っている研究群についてのメタアナリシスは偏りを強化する。
36
#統計 『統計学入門』のような問題のある教科書で勉強してしまってもそう落ち込む必要はないと思います。
統計学への入門時にしんどい思いをさせられる面倒な計算の経験は、『統計学入門』のような問題のある教科書を読んだ場合であっても、そのまま活きます!
知識の訂正は比較的容易だと思います。
統計学への入門時にしんどい思いをさせられる面倒な計算の経験は、『統計学入門』のような問題のある教科書を読んだ場合であっても、そのまま活きます!
知識の訂正は比較的容易だと思います。
37
#統計 そして『統計学入門』のような問題のある教科書で勉強させられてしまった恨みは、自分の後輩達が同じ目に合わないようにすることで晴らせば良いと思います。
実際にそうなればめっちゃ建設的。
実際にそうなればめっちゃ建設的。
38
#統計 『統計学入門』とは無関係に、ノンパラメトリック検定に関する解説もまずものが非常に多い。
例えば、丹後俊郎『統計学のセンス』(1998)の1.3節でのWilcoxonの順位和検定の解説は、よく見る誤用そのものです。
統計学入門書の説明の中にはこのように有害な解説がよく見つかる。


例えば、丹後俊郎『統計学のセンス』(1998)の1.3節でのWilcoxonの順位和検定の解説は、よく見る誤用そのものです。
統計学入門書の説明の中にはこのように有害な解説がよく見つかる。
黒木玄 Gen Kuroki@genkuroki
#統計 おまけ
以下のリンク先のリンク先で引用されている丹後俊郎『統計学のセンス』(1998)では
❌母分散が大きく異なる図(b)(c)の場合への対策として、Wilcoxonの順位和検定の使用
を勧めています。これはかなり酷いです。
統計学入門の本の多くは結構基本的な事柄について有害な説明を含みます。
以下のリンク先のリンク先で引用されている丹後俊郎『統計学のセンス』(1998)では
❌母分散が大きく異なる図(b)(c)の場合への対策として、Wilcoxonの順位和検定の使用
を勧めています。これはかなり酷いです。
統計学入門の本の多くは結構基本的な事柄について有害な説明を含みます。
39
#統計 ノンパラメトリック検定については以下のリンク先スレッドも参照。
黒木玄 Gen Kuroki@genkuroki
#統計 【ノンパラメトリック検定は仮定を持ちません】はよく見る誤解。
多分、Wilcoxonの順位和検定=Mann-WhitneyのU検定などのノンパラメトリック検定に関する最も有害な誤解。
この最悪の誤解のせいで、統計学の誤用が大量発生していると思われる。
多分、Wilcoxonの順位和検定=Mann-WhitneyのU検定などのノンパラメトリック検定に関する最も有害な誤解。
この最悪の誤解のせいで、統計学の誤用が大量発生していると思われる。
40
#統計 別スレッドでのコメント

黒木玄 Gen Kuroki@genkuroki
@tomoak1n @tbs_i いいえ。『統計学入門』の説明では、
整数とは限らない自由度νのt分布に近似的に従う。
数表を使う計算ではνの代わりにνに最も近い整数を使うことがある。
と正しく説明せずに、
近似的に~ν~に最も近い整数の自由度のt分布~に従う
となっているので、32年前の時点でもアウトです。
整数とは限らない自由度νのt分布に近似的に従う。
数表を使う計算ではνの代わりにνに最も近い整数を使うことがある。
と正しく説明せずに、
近似的に~ν~に最も近い整数の自由度のt分布~に従う
となっているので、32年前の時点でもアウトです。
41
#統計 信頼区間について真っ当な説明をしている日本語の本もあります。
パラメータθに関する仮説の検定
と
パラメータθの信頼区間
が表裏一体であることが分かる解説であれば真っ当な解説だとみなせると思います。
パラメータθに関する仮説の検定
と
パラメータθの信頼区間
が表裏一体であることが分かる解説であれば真っ当な解説だとみなせると思います。
42
#統計 有意水準5%の検定との関係を使った95%信頼区間の定義の仕方(もしくは特徴付けの仕方)については、既出の以下の講義動画も参照。
これをスタンダードな説明にするべき。
「自動書き起こし」にある文をクリックすると動画も該当箇所に移動できます。
ocwcentral.com/subjects/01GB4…
これをスタンダードな説明にするべき。
「自動書き起こし」にある文をクリックすると動画も該当箇所に移動できます。
ocwcentral.com/subjects/01GB4…
43
#統計 添付画像に引用した講義動画の部分を見れば分かるように、「信頼区間の方を使うべきなので、仮説検定は無用である」というような意見は統計学教育的に有害であることも分かります。
ocwcentral.com/subjects/01GB4…
ocwcentral.com/subjects/01GB4…
44
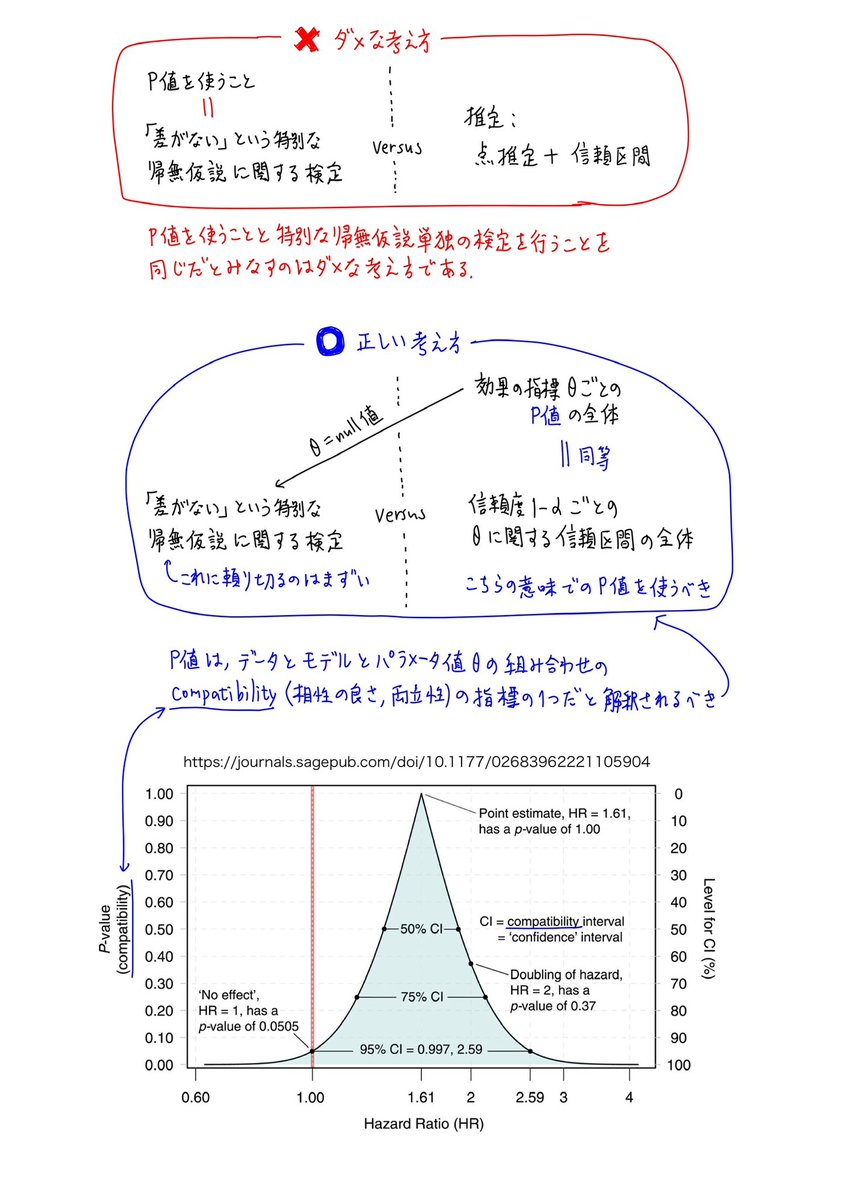
#統計 検定もしくはP値を使うことと、信頼区間を使うことの関係については以下のリンク先スレッドを参照。
黒木玄 Gen Kuroki@genkuroki
#統計 natureのその記事を読んでいるならば、P値のcompatibilityとしての解釈について知り、添付画像のように、ダメな考え方と正しい考え方を区別できるようになっているはずなのです。
否定するべき対象にP値そのものが含まれていないことに注目!
続く
否定するべき対象にP値そのものが含まれていないことに注目!
続く
45
#統計 以下のリンク先の添付画像中では、ざくっと「矛盾」という日本語が使われていますが、「矛盾」は多分強過ぎる言葉です。
Greenlandさん達やMcElreathさんはその意味での「矛盾」の反対の意味で「compatible」という単語を使っています。
その意味でのcompatibleの日本語訳が悩ましい。
Greenlandさん達やMcElreathさんはその意味での「矛盾」の反対の意味で「compatible」という単語を使っています。
その意味でのcompatibleの日本語訳が悩ましい。
46
#統計 compatibleの訳語として最頻出なのは「互換」なのですが、
データの数値とモデル+パラメータ値のcompatibility
の意味でのcompatibilityを「互換性」と訳すのは多分まずい。
「相性のよさ」と緩く訳すか、「両立性」と堅めに訳すか?
この辺、ずっと揺れ動いている。
データの数値とモデル+パラメータ値のcompatibility
の意味でのcompatibilityを「互換性」と訳すのは多分まずい。
「相性のよさ」と緩く訳すか、「両立性」と堅めに訳すか?
この辺、ずっと揺れ動いている。
47
#統計 注意・警告:
引用
❌両側5%水準の検定で、有意にならない真の値の範囲
における「真の値の範囲」は誤りで正しくは「モデルのパラメータ値の範囲」です。
⭕️両側5%水準の検定で、有意にならないモデルのパラメータ値の範囲
どんなに素晴らしい講義でも全てが正しいと信じて聴くと危ない。
引用
❌両側5%水準の検定で、有意にならない真の値の範囲
における「真の値の範囲」は誤りで正しくは「モデルのパラメータ値の範囲」です。
⭕️両側5%水準の検定で、有意にならないモデルのパラメータ値の範囲
どんなに素晴らしい講義でも全てが正しいと信じて聴くと危ない。
黒木玄 Gen Kuroki@genkuroki
#統計 有意水準5%の検定との関係を使った95%信頼区間の定義の仕方(もしくは特徴付けの仕方)については、既出の以下の講義動画も参照。
これをスタンダードな説明にするべき。
「自動書き起こし」にある文をクリックすると動画も該当箇所に移動できます。
ocwcentral.com/subjects/01GB4…
これをスタンダードな説明にするべき。
「自動書き起こし」にある文をクリックすると動画も該当箇所に移動できます。
ocwcentral.com/subjects/01GB4…
48
#統計 例えば、正規分布モデルを使って、標本の数値から分散の95%信頼区間を求めたとします。
その信頼区間は標本を取得した母集団の分散の真の値の範囲ではありません。
その信頼区間は、閾値5%で標本の数値と相性が悪過ぎないと判定された正規分布モデルの分散パラメータの範囲です。
その信頼区間は標本を取得した母集団の分散の真の値の範囲ではありません。
その信頼区間は、閾値5%で標本の数値と相性が悪過ぎないと判定された正規分布モデルの分散パラメータの範囲です。
49
#統計 全て正しいと信じてはいけないという原則は『統計的有意性とP値に関するASA声明』についても言える。
ASA声明でのP値のおおざっぱな定義中の「データ」という語は「統計モデル内の確率分布に従ってランダムに生成されたデータ」という意味です。観察データではない。
biometrics.gr.jp/news/all/ASA.p…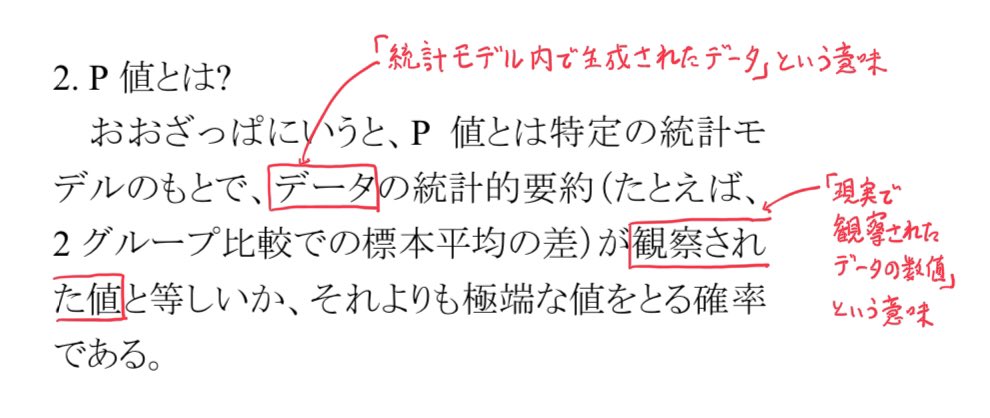
ASA声明でのP値のおおざっぱな定義中の「データ」という語は「統計モデル内の確率分布に従ってランダムに生成されたデータ」という意味です。観察データではない。
biometrics.gr.jp/news/all/ASA.p…
50
#統計 モデル内ではデータの数値をモデルの確率分布に従ってランダムに無数に生成できる。
一方、現実でのデータの取得は予算や倫理や物理的制約によってかなり大変。
統計分析の数学的仕組みの基本は、モデル内で無数に生成可能な仮想的データと現実から得た1組のデータの数値を比較することです。
一方、現実でのデータの取得は予算や倫理や物理的制約によってかなり大変。
統計分析の数学的仕組みの基本は、モデル内で無数に生成可能な仮想的データと現実から得た1組のデータの数値を比較することです。
51
#統計 例えば、多くの場合に、P値は、
現実から得たデータの値D以上に極端なデータの値がモデル内で生成される確率もしくはその近似値。
尤度の定義は、
現実から得たデータの値Dと同じ数値のデータがモデル内で生成される確率または確率密度。
現実のデータとモデル内データの比較が基本。
現実から得たデータの値D以上に極端なデータの値がモデル内で生成される確率もしくはその近似値。
尤度の定義は、
現実から得たデータの値Dと同じ数値のデータがモデル内で生成される確率または確率密度。
現実のデータとモデル内データの比較が基本。
52
#統計 ベイズ統計では、データとパラメータの同時確率分布をモデルとして用い、
現実から得たデータの値Dと同じ数値がモデル内で生成された場合に制限することによって、モデルの確率分布の条件付き確率分布を構成する。
これがベイズ法での、現実のデータとモデル内データ生成の比較法です。
現実から得たデータの値Dと同じ数値がモデル内で生成された場合に制限することによって、モデルの確率分布の条件付き確率分布を構成する。
これがベイズ法での、現実のデータとモデル内データ生成の比較法です。
53
#統計 ベイズであろうが、非ベイズであろうが、まずがモデルを考えて、モデル内でのデータの生成のされ方と、現実から得た1組のデータの数値を比較することが基本になる。
比較して相性が滅茶苦茶悪いとわかった場合には、モデルまたは現実から取得したデータの少なくとも一方は疑わしいと分かる。
比較して相性が滅茶苦茶悪いとわかった場合には、モデルまたは現実から取得したデータの少なくとも一方は疑わしいと分かる。
54
#統計 モデル内でのデータ生成法と現実から得たデータの数値の相性のよさは、グラフを描いて視認しても結構分かるし、やる価値があります。
しかし、視認だけに頼るのは危険なので、相性のよさの指標を適切に定義して計算する仕組みを整備しておくべきです。
それが、P値や尤度や事後分布です。
しかし、視認だけに頼るのは危険なので、相性のよさの指標を適切に定義して計算する仕組みを整備しておくべきです。
それが、P値や尤度や事後分布です。
55
#統計 P値も尤度(ゆうど)も事後分布も、
現実から得たデータの数値
と
モデル内でのデータの生成法
の相性のよさの指標になっています。
主義思想哲学原理でどの道具を選択すると非科学的な思考に陥るので控えた方が良いです。
自分の目的のために適切で楽に使えるものを使えばよい。
現実から得たデータの数値
と
モデル内でのデータの生成法
の相性のよさの指標になっています。
主義思想哲学原理でどの道具を選択すると非科学的な思考に陥るので控えた方が良いです。
自分の目的のために適切で楽に使えるものを使えばよい。
56
#統計 現実から得たデータの数値
と
モデル内でのデータの生成法
の相性のよさの指標にはP値と尤度と事後分布の3つがある。
その3つの定義は全然異なるのですが、モデルがシンプルで尤度函数が短峰型の釣鐘型になっている場合には、その3つはどれを使っても結果は大して変わらないことを示せます。
と
モデル内でのデータの生成法
の相性のよさの指標にはP値と尤度と事後分布の3つがある。
その3つの定義は全然異なるのですが、モデルがシンプルで尤度函数が短峰型の釣鐘型になっている場合には、その3つはどれを使っても結果は大して変わらないことを示せます。
57
#統計 現実の統計分析でもそう珍しくない特定の状況では、「どれを使っても結果に大差はない」となることを数学的に証明できるわけです。
モデルがちょっと複雑になるとそれが崩れて、ベイズ統計を適切に使うことを検討した方が無難になります。主義思想哲学原理でそうなるのではない。数学が大事。
モデルがちょっと複雑になるとそれが崩れて、ベイズ統計を適切に使うことを検討した方が無難になります。主義思想哲学原理でそうなるのではない。数学が大事。
58
#統計 Greenlandさん達は、
現実から得たデータの数値とモデル内でのデータの生成法の相性のよさの指標
が基本的であるというアイデアを、compatibilityという用語を使って普及させようとして来たとみなせます。
「有意」や「信頼」よりもcompatibleの方がニュートラルな用語で好ましい。
現実から得たデータの数値とモデル内でのデータの生成法の相性のよさの指標
が基本的であるというアイデアを、compatibilityという用語を使って普及させようとして来たとみなせます。
「有意」や「信頼」よりもcompatibleの方がニュートラルな用語で好ましい。
59
#統計 そういうcompatibilityという用語の使い方をそのままベイズ統計の場合にも輸入して見せたのが、McElreathさんのStatistical Rethinking 2nd ed.なわけです。
私はこの辺に新時代の統計学教育のスタイルの収束を期待しています。
主義哲学思想原理で考えることは最初から相手にされていない。

私はこの辺に新時代の統計学教育のスタイルの収束を期待しています。
主義哲学思想原理で考えることは最初から相手にされていない。
黒木玄 Gen Kuroki@genkuroki
#統計 Statistical Rethinking, 2nd ed.を見ると、添付画像のようにGreenlandさん達に従って、ベイズ信用区間をも「両立区間(compatibility interval)」と呼んでいます。添付画像のように書いてある。
compatibilityはGreenlandさん達の論文 journals.sagepub.com/doi/10.1177/02… のキーワードでもあります。
compatibilityはGreenlandさん達の論文 journals.sagepub.com/doi/10.1177/02… のキーワードでもあります。
60
#統計 もしも、Statistical Rethinkingの著者のMcElreathさんが主義哲学思想原理で考える人ならば、「頻度論」の文脈でGreenlandさん達が普及させようとしているcompatibilityの概念をベイズ統計にも気軽に導入するというようなことはしなかったでしょう。
我々もこういう方向に一緒に進むべき。
我々もこういう方向に一緒に進むべき。