#統計 豊田秀樹『統計学入門Ⅱ』 asakura.co.jp/detail.php?boo…...

黒木玄 Gen Kuroki@genkuroki
69 views
Oct 21, 2024
~1 min read
Advertisement
1
#統計
豊田秀樹『統計学入門Ⅱ』
asakura.co.jp/detail.php?boo…
という有害に見える本が出版されていたのでコメントしておきます。
添付画像は試し読みに最初の2ページ分。
赤と青の字は私によるコメント。
豊田さんは、P値の使用を否定しながら、本質的にP値を使うことを勧めている!(笑)
豊田秀樹『統計学入門Ⅱ』
asakura.co.jp/detail.php?boo…
という有害に見える本が出版されていたのでコメントしておきます。
添付画像は試し読みに最初の2ページ分。
赤と青の字は私によるコメント。
豊田さんは、P値の使用を否定しながら、本質的にP値を使うことを勧めている!(笑)
2
#統計 豊田秀樹さんの問題点を要約するとこうです。
(1) P値の概念と使い方に関する誤解に基いて、P値を使う統計学を否定している。
(2) 豊田さん自慢のphcとやらが、実質的にP値になっていることに気付いていない。
P値を誤解して否定して、P値を使おうと提案していることになる。救いようがない。
(1) P値の概念と使い方に関する誤解に基いて、P値を使う統計学を否定している。
(2) 豊田さん自慢のphcとやらが、実質的にP値になっていることに気付いていない。
P値を誤解して否定して、P値を使おうと提案していることになる。救いようがない。
3
#統計 豊田さんが、ASA声明で誤用扱いされているP値の使い方を前提にして、P値を不当に攻撃していることは、
P値に関するASA声明
biometrics.gr.jp/news/all/ASA.p…
(その2ページ目を添付画像①に引用)
と豊田さんのまえがきでの説明(添付画像②)を比較すれば明瞭でしょう。
これは相当にひどいです。

P値に関するASA声明
biometrics.gr.jp/news/all/ASA.p…
(その2ページ目を添付画像①に引用)
と豊田さんのまえがきでの説明(添付画像②)を比較すれば明瞭でしょう。
これは相当にひどいです。
4
#統計 一方には、P値の誤用を嘆いて、それを訂正するために声明を出したり、翻訳したりしてくれる人たちがいる。
別の一方では、豊田秀樹さんのように、P値の誤用の側を当然の前提として、P値の使用を否定する言論活動を積極的にしている人がいる。
私は豊田さんの側は極めて有害だと思います。
別の一方では、豊田秀樹さんのように、P値の誤用の側を当然の前提として、P値の使用を否定する言論活動を積極的にしている人がいる。
私は豊田さんの側は極めて有害だと思います。
5
#統計 P値の正しい使い方に関する議論の最前線については、繰り返し紹介している最近の次の論文が短くて分かり易いのでお勧めです。
豊田さんはこういう方面の議論に無知であるように見えます。
Amrhein-Greenland June 3, 2022
journals.sagepub.com/doi/10.1177/02…

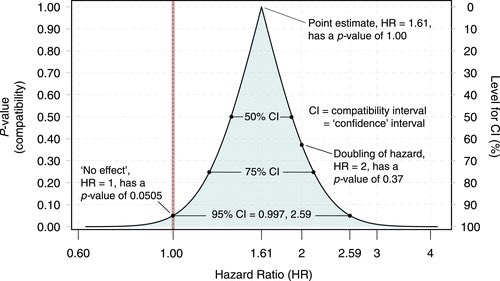
豊田さんはこういう方面の議論に無知であるように見えます。
Amrhein-Greenland June 3, 2022
journals.sagepub.com/doi/10.1177/02…
黒木玄 Gen Kuroki@genkuroki
#統計 代替となる正しくてかつ実用的な信頼区間の解釈の仕方(confidence intervalではなく、compatibility intervalと解釈すること)については、最新の論文で滅茶苦茶わかりやすく解説されています。
Amrhein-Greenland June 3, 2022
journals.sagepub.com/doi/10.1177/02…
Amrhein-Greenland June 3, 2022
journals.sagepub.com/doi/10.1177/02…
6
#統計 そして、さらに豊田さんがイタいのは、豊田さん自慢の
phc=研究科説が正しい確率
とやらは、統計学入門に出て来るシンプルなモデルでは、Pと本質的に同じであることを全然理解していないように見えることです。
P値を否定して、P値を勧めるという救いようがない滑稽なことをしている!
phc=研究科説が正しい確率
とやらは、統計学入門に出て来るシンプルなモデルでは、Pと本質的に同じであることを全然理解していないように見えることです。
P値を否定して、P値を勧めるという救いようがない滑稽なことをしている!
7
#統計 実質的には豊田さんが否定しているP値に過ぎないphcをあたかも新しい話であるかのように説明してしまっている。
確率論のような解析学の世界では、定義が全く異なる 2つの量がある条件の下で互いに相手を近似し合うことがよく起こります。
P値とphcはちょうどそういう関係になっています。
確率論のような解析学の世界では、定義が全く異なる 2つの量がある条件の下で互いに相手を近似し合うことがよく起こります。
P値とphcはちょうどそういう関係になっています。
8
#統計 phcは上で紹介した「Ⅱ」の前巻の
豊田秀樹『統計学入門Ⅰ』
asakura.co.jp/detail.php?boo…
ですでに導入されています。添付画像はこちらの試し読みからの目次の引用です。
読者は「phc」という文字列を「P値」に置換して読む必要があります(笑)。
豊田秀樹『統計学入門Ⅰ』
asakura.co.jp/detail.php?boo…
ですでに導入されています。添付画像はこちらの試し読みからの目次の引用です。
読者は「phc」という文字列を「P値」に置換して読む必要があります(笑)。
9
#統計 統計学入門的なシンプルなモデルでパラメータθを持つものについて、θ≤cという仮説について考える。
このとき、おとなしめの事前分布と十分大きな標本から得られる事後分布について、
phc = 事後分布で仮説θ≤cが成立する確率
と
仮説θ≤cの(片側検定の)P値
は互いに相手をよく近似します。
このとき、おとなしめの事前分布と十分大きな標本から得られる事後分布について、
phc = 事後分布で仮説θ≤cが成立する確率
と
仮説θ≤cの(片側検定の)P値
は互いに相手をよく近似します。
10
#統計 普通によく使われている方のP値は両側検定のP値なのですが、両側検定のP値の1つの作り方は、片側検定のP値の2倍なので、1つ前のツイートの内容を理解していれば、通常の両側検定のP値のphcによる近似的な解釈も得られます。
11
#統計 要するに、非常に有名なASA声明で解説されているようなP値の使い方や、特にGreenlandさん達が勧めているようなP値の使い方に無知なままで、誤解に基いてP値の使用を否定している豊田さんは、結果的にP値の使用に舞い戻って来ているわけです。
これは滅多にない滑稽な話だと思います。
これは滅多にない滑稽な話だと思います。
12
#統計 しかし、もしも豊田さんが自分自身のP値に関する無知と誤りを認めることがあれば、上で紹介した最新の論文 journals.sagepub.com/doi/10.1177/02… の線に沿った考え方で、(P値と信頼区間ではなく)ベイズ統計の使い方を解説できるようになる可能性はあります。
個人的にはそうなってほしいと思います。
個人的にはそうなってほしいと思います。
13
#統計 P値とphcが互いに相手を近似し合う状況では、パラメータをP値に対応させるP値函数とベイズ統計での事後分布の密度函数を同じように使える場合になっています。続く
14
#統計 だから、論文 journals.sagepub.com/doi/10.1177/02… で提案されているP値をデータとモデル+パラメータ値のcompatibilityの指標として使うという提案は、その場合には、ベイズ統計まで拡張されることになります。
こういう思考法は主義に基く統計学に心が侵されている人達には不可能なことかもしれません。
こういう思考法は主義に基く統計学に心が侵されている人達には不可能なことかもしれません。
15
#統計 しかし、主義に心がおかされてしまった人達が考え方を改めて、主義に依存せずに、穏健で合理的な考え方をすることを目指して、統計学入門おける基本概念について教えるようになれば、そのインパクトは大きいと予想されます。続く
16
#統計 実際にそうなれば、おそらく学生だけではなく、P値や信頼区間を使って立派な仕事をして来た研究者達が、ベイズ統計の技術についても抵抗なく学ぶようになると思われます。
誤解に基いて自分がやって来たことを否定しているような解説を読むことに時間をかけるのは普通は嫌でしょう。
誤解に基いて自分がやって来たことを否定しているような解説を読むことに時間をかけるのは普通は嫌でしょう。
17
#統計 逆に、豊田秀樹さんの著書を若い人たちがこぞって読むことになって、しかも、そこに書いてあるP値に関する前提(ASA声明的にはひどい誤解になっている前提)を受け入れて、phc万歳ということになると、我々の社会は頭が悪くなった有害な若い人たちを抱え込むことになります。
これは最悪。
これは最悪。
18
#統計 豊田秀樹さんのように誤解に基いて攻撃的なことを述べるのではなく、
今までみんなが使って来た道具
(P値もベイズ統計も両方含む)は
適材適所でどれも有用である
というスタイルの穏健で合理的な解説が普及する必要があると思います。
今までみんなが使って来た道具
(P値もベイズ統計も両方含む)は
適材適所でどれも有用である
というスタイルの穏健で合理的な解説が普及する必要があると思います。
19
#統計 そういう穏健で合理的な解説の普及のためには論文 journals.sagepub.com/doi/10.1177/02… に書いてある考え方はキーになり得ると思います。
20
#統計 論文 journals.sagepub.com/doi/10.1177/02… では、そのタイトルの後半
not only on point estimates and null p-values
を見ればわかるように、仮説「効果はゼロ」以外に「効果は○○である」という仮説達のP値達の利用を提案している。
豊田さんのphcでも「効果はゼロ」以外の仮説も扱う点が本質的です。
not only on point estimates and null p-values
を見ればわかるように、仮説「効果はゼロ」以外に「効果は○○である」という仮説達のP値達の利用を提案している。
豊田さんのphcでも「効果はゼロ」以外の仮説も扱う点が本質的です。
21
#統計 論文 journals.sagepub.com/doi/10.1177/02… と豊田秀樹さんは、扱う仮説を「効果はゼロである」に限らない点で共通しているのですが、豊田秀樹さんは閾値の設定へのこだわりを捨て切れていないようにも見える。前者では無駄なこだわりが消えてよりすっきりしています。
22
#統計 以上のような話をすると、Modern EpidemiologyにおけるGreenlandさんが著者の
Chap.24. Introduction to Bayesian Statistics
へのコメントもしろ、と言われるかもしれません。続く
Chap.24. Introduction to Bayesian Statistics
へのコメントもしろ、と言われるかもしれません。続く
23
#統計 その章の内容はフェアでかつ示唆的で非常に面白いのですが,非常に残念なことに、
❌ベイズ統計=主観ベイズ主義
という解釈を当然視しており、その点は統計学教育的には致命的な弱点になる可能性が高いと思いました。
それにもかかわらず非常に面白い所がすごいのですが。続く
❌ベイズ統計=主観ベイズ主義
という解釈を当然視しており、その点は統計学教育的には致命的な弱点になる可能性が高いと思いました。
それにもかかわらず非常に面白い所がすごいのですが。続く
24
#統計 例えば、赤池弘次さんや渡辺澄夫さん(『ベイズ統計の理論と方法』を参照)のように、主観ベイズ主義的なベイズ統計学解釈にこだわることを完全にやめてしまえば(算数教育でかけ算順序固定にこだわることをやめることに似ている)、第23章の内容は大幅に改善されるのではないかと思いました。
25
#統計 既存のシンプルなモデルで現実が近似できているという感覚を捨てて、より複雑なモデルを使うようになったら、渡辺澄夫さんの本の第4章で指摘されていることから、事前分布を使う方法を用いた方がより信頼できる結果が得られる可能性が増えます。
26
#統計 Stein推定からの流れ(事前分布を使ってオーバーフィッティングを緩和すること)や、構造を持つモデルで発生するモデルが特異になってしまう危険性への備えや、信頼区間をよく近似する区間推定が技巧的にならずに可能になること(P値を使う方法は技巧的になりがち)を軽視しているのではないか?
27
#統計 しかし、内容的に面白く読めるので、翻訳するならそのまま忠実に翻訳して欲しいと思います。
28
#統計 その23章では、事前分布を頻度論的に解釈できる場合があることも扱っているのですが、そういう話をするなら、ベイズ統計の解釈を主観ベイズ主義に固定することへのこだわりを捨てる方がすっきりしています。
赤池弘次さんあたりは40年以上前の論争ですでにそういう立場を採用していました。
赤池弘次さんあたりは40年以上前の論争ですでにそういう立場を採用していました。
29
#統計 さらに欲を言えば、frequentist (頻度論者)やBayesian(ベイズ主義者)という悪しき「主義に基く統計学」の手垢のついた用語も使うのをやめてしまった方がよいと思う。
単に、事前分布を使うか否か、事前分布をどのように使うか、という数学的道具の違いに過ぎないという立場で押し通せばよい。
単に、事前分布を使うか否か、事前分布をどのように使うか、という数学的道具の違いに過ぎないという立場で押し通せばよい。
30
#統計 少なくとも、
⭕️文脈ごとに事前分布などのモデルの構成要素の解釈は様々でよい
という原則だけは徹底しておかないと、算数でのかけ算順序問題(「3×4は3個の4つ分であり、4+4+4のように解釈してはいけない」とするナンセンスな話)のようにおかしなことになります。
⭕️文脈ごとに事前分布などのモデルの構成要素の解釈は様々でよい
という原則だけは徹底しておかないと、算数でのかけ算順序問題(「3×4は3個の4つ分であり、4+4+4のように解釈してはいけない」とするナンセンスな話)のようにおかしなことになります。
31
#統計 通常の信頼区間とベイズ統計での事後分布で計算した信用区間が(数学的理由で近似的に)一致する場合には、両方を通常の信頼区間的な解釈をしても良いし、両方をベイズ的に解釈しても良い。
一致しているのに、ベイズ信用区間だからベイズ的解釈をしなければいけない、という考え方は誤りです。
一致しているのに、ベイズ信用区間だからベイズ的解釈をしなければいけない、という考え方は誤りです。
32
#統計 シンプルに無駄なこだわりを捨てて(主義に基く統計学的な考え方を捨てて)、各種の道具がどのように有用でどのような欠点を持つかを説明すればすっきりする。
第23章はそれに近いことをやりかけていて面白いのですが、ベイズ統計の主観ベイズ主義的な解釈が必須でないことへの理解が不十分。
第23章はそれに近いことをやりかけていて面白いのですが、ベイズ統計の主観ベイズ主義的な解釈が必須でないことへの理解が不十分。
33
#統計 豊田『統計学入門Ⅰ』の話に戻る。
『I』を読むときには、まず「21.3 比率の推測」に関する通常のP値と豊田さん的phcが互いに相手をよく近似していることをコンピュータで確認するとよいと思います。
私によるその場合の取り扱いについては以下のリンク先を参照。


『I』を読むときには、まず「21.3 比率の推測」に関する通常のP値と豊田さん的phcが互いに相手をよく近似していることをコンピュータで確認するとよいと思います。
私によるその場合の取り扱いについては以下のリンク先を参照。
黒木玄 Gen Kuroki@genkuroki
例えば豊田『瀕死本』の図5.2, 5.3のphc=「仮説が正しい確率」はそれぞれに対応するP値にほぼぴったり一致しています。
添付画像のグラフとソースコード nbviewer.jupyter.org/gist/genkuroki… を見て下さい。
この一致は偶然ではなく、一般的に成立しています。
添付画像のグラフとソースコード nbviewer.jupyter.org/gist/genkuroki… を見て下さい。
この一致は偶然ではなく、一般的に成立しています。
34
#統計 2×2の分割表( 2つの二項分布)の場合の、リスク比に関するP値の話とベイズ統計での事後分布の話の一致については以下のリンク先を参照。
私のツイログを検索すれば「P値を使う方法≈ベイズ統計の事後分布を使う方法」については他にも色々出て来るはず。


私のツイログを検索すれば「P値を使う方法≈ベイズ統計の事後分布を使う方法」については他にも色々出て来るはず。
黒木玄 Gen Kuroki@genkuroki
@EinekleineNach @mepbphhond_ @YakiPulin nejm.org/doi/full/10.10… ではベイズ統計の方法を使ったお陰で容易に同じ結果を再現できました(添付画像①)。
添付画像②③は通常の信頼区間(とP値函数)の計算です。
論文でのRRに関するベイズ信用区間と通常の信頼区間は数学的理由でほぼ一致します。添付画像を見比べて下さい。続く #統計
添付画像②③は通常の信頼区間(とP値函数)の計算です。
論文でのRRに関するベイズ信用区間と通常の信頼区間は数学的理由でほぼ一致します。添付画像を見比べて下さい。続く #統計
35
#統計 1標本の場合の母平均の推定の場合のP値を使う方法とベイズ統計を使う方法の近似的一致は以下のリンク先スレッドにある。
私のこの手の話は使用した #Julia言語 のコードが丸ごと実行可能な形式(要Jupyter)で公開されています。
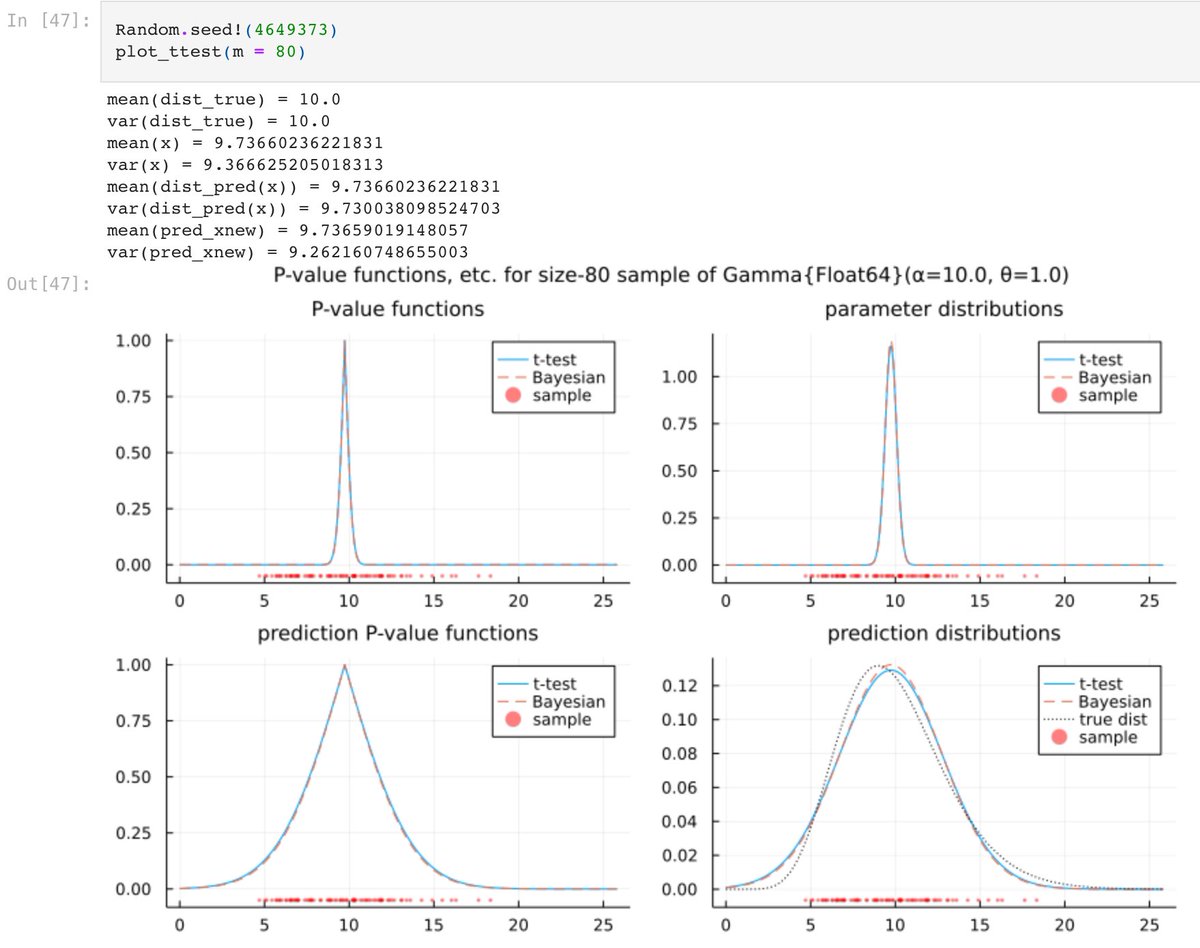
私のこの手の話は使用した #Julia言語 のコードが丸ごと実行可能な形式(要Jupyter)で公開されています。
黒木玄 Gen Kuroki@genkuroki
#統計 サンプルサイズm=80
ここまで一致すれば、
t検定とベイズ法は同じことをやっている
と言って良いと思う。
右下の予測分布は真の分布(今の場合はGamma(10,1))にKL情報量の意味で最も近い正規分布に近付きます。正規分布モデルではこうなる。
ここまで一致すれば、
t検定とベイズ法は同じことをやっている
と言って良いと思う。
右下の予測分布は真の分布(今の場合はGamma(10,1))にKL情報量の意味で最も近い正規分布に近付きます。正規分布モデルではこうなる。
36
#統計 訂正
❌ Chap.24. Introduction to Bayesian Statistics
⭕️ Chap.23. Introduction to Bayesian Statistics
Modern Epidemiology, Fourth Editon です。
❌ Chap.24. Introduction to Bayesian Statistics
⭕️ Chap.23. Introduction to Bayesian Statistics
Modern Epidemiology, Fourth Editon です。
黒木玄 Gen Kuroki@genkuroki
#統計 以上のような話をすると、Modern EpidemiologyにおけるGreenlandさんが著者の
Chap.24. Introduction to Bayesian Statistics
へのコメントもしろ、と言われるかもしれません。続く
Chap.24. Introduction to Bayesian Statistics
へのコメントもしろ、と言われるかもしれません。続く
37
#統計 その23章のどこが面白いか。例えば
It is often said (incorrectly) that “parameters are treated as fixed by the frequentist but as random by the Bayesian.”
と書いてあります!
incorrectly の部分をもっと強調したい!(笑)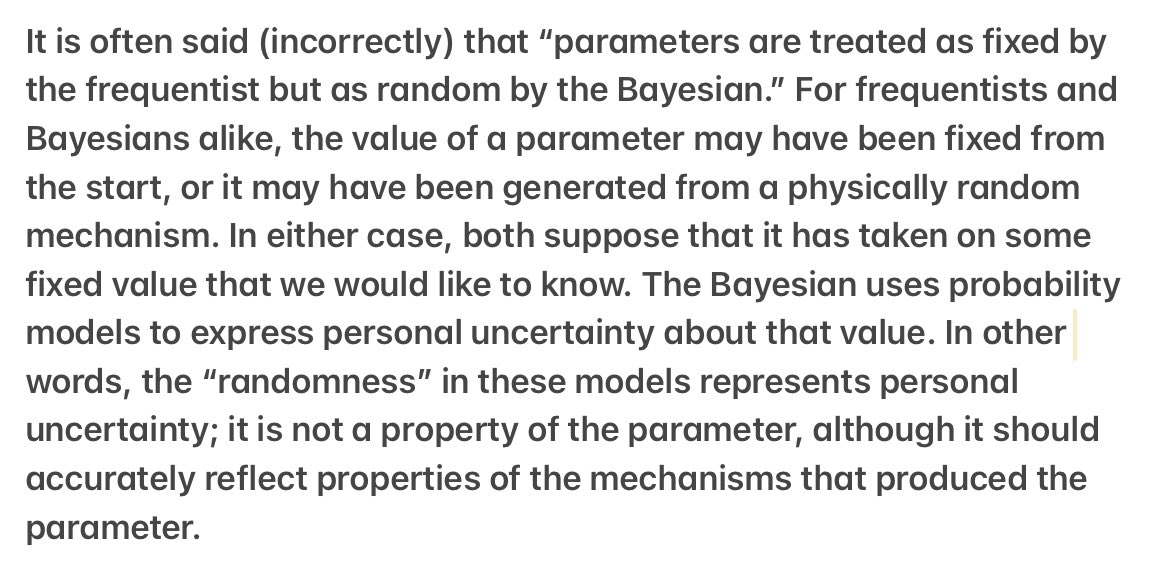
It is often said (incorrectly) that “parameters are treated as fixed by the frequentist but as random by the Bayesian.”
と書いてあります!
incorrectly の部分をもっと強調したい!(笑)
38
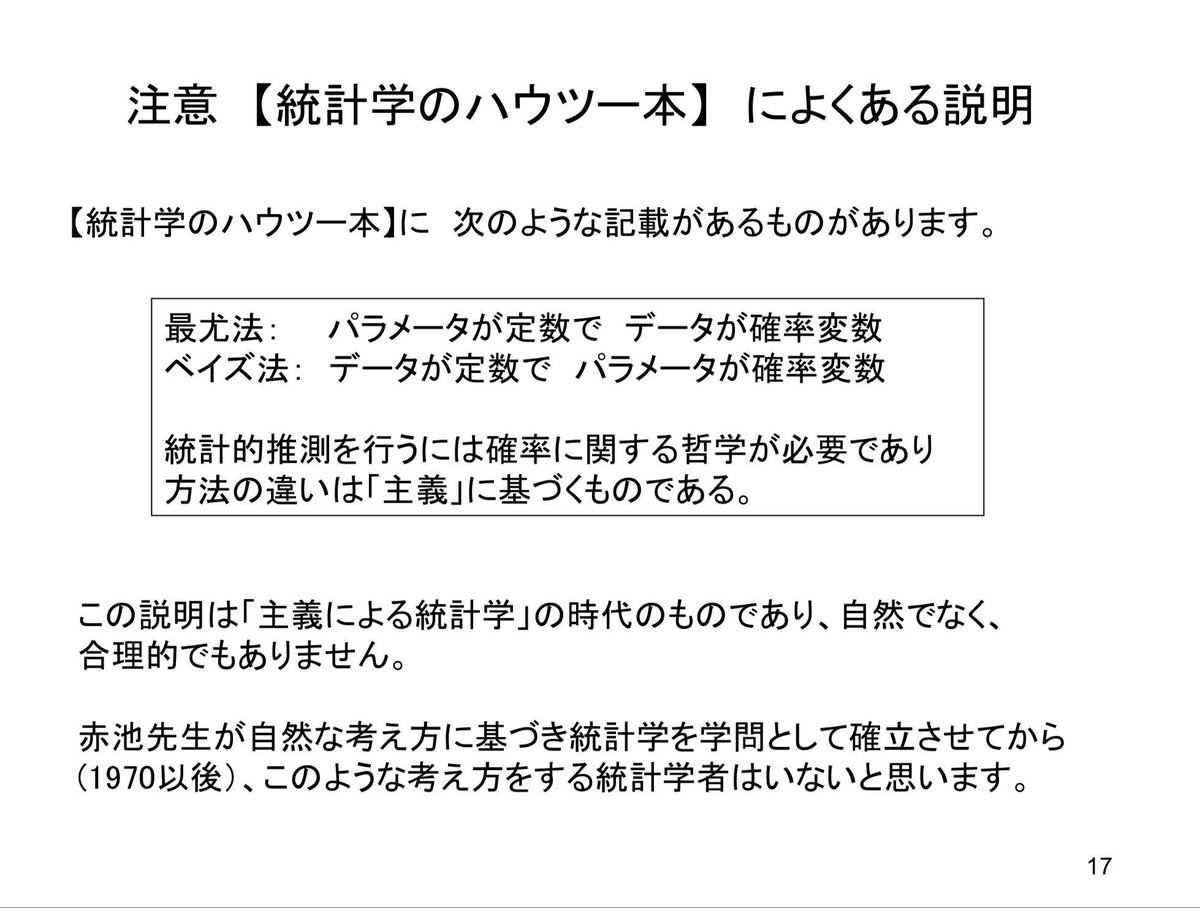
#統計 翻訳【「パラメータは頻度論者には定数として扱われるが、ベイズ主義者に確率変数として扱われる」とよく(間違って)言われている】😊
「間違って」の部分を強調したい。
以下も参照。
watanabe-www.math.dis.titech.ac.jp/users/swatanab…
渡辺澄夫さん曰く
↓
「間違って」の部分を強調したい。
以下も参照。
watanabe-www.math.dis.titech.ac.jp/users/swatanab…
渡辺澄夫さん曰く
↓
39
#統計 さらにその23章には続けて添付画像のように書いてあります。
頻度論とベイズの両方で統計モデルの選択は難しい。疫学では、ロジスティック、ポアソン,比例ハザードモデルなどの既存のモデルが正当化されることはほとんどない、というようなことがずばっと書かれている。
非常に面白く読める。
頻度論とベイズの両方で統計モデルの選択は難しい。疫学では、ロジスティック、ポアソン,比例ハザードモデルなどの既存のモデルが正当化されることはほとんどない、というようなことがずばっと書かれている。
非常に面白く読める。
40
#統計 こういう話をするなら、主義に基く統計学へのこだわりを完全に捨てた方がうまく行くと思う。
41
分岐スレッド
42
#統計 常識的でかつ論理的な人には理解不能な言説群によって無駄にややこしく見えるようにされていることが統計学の周辺には色々あって、そういうのをrespectするようになると、常識と論理に基く理解ではなく、権威に頼るスタイルにどうしてもなってしまう。
おそらくそうなっている人の方が多数派。
おそらくそうなっている人の方が多数派。
43
#統計 だから、統計学に関することで何が正しいかに疑問を持った人達の多くは、自分で計算して確かめることから始めるのではなく、検索で見つかったら各種言説を整理することから始めて、自分で計算して確認することにはたどりつかない人が多い。
検索で見つけるたびにがっかりしている。
検索で見つけるたびにがっかりしている。
44
#統計 偉い先生が何を言っているかとか、私のような非専門家が繰り返し言っていることだとか、教科書にどう書いてあるかだとかをどんなに集めても何が本当に正しいかは永久にわかりません。
自分で確認するステップが必要。
こういう当たり前のことを言わざるを得ないこと自体が異常。
自分で確認するステップが必要。
こういう当たり前のことを言わざるを得ないこと自体が異常。
45
#統計 自分による確認自体が間違っていることもよくあります。それは人間だから仕方がないです。間違うのは仕方がない。
合っているかどうか分からない自分による確認を適当な場所で公開しておけば、誤りを指摘してもらったり、独立に同じ結果を得た人に大丈夫そうだと教えてもらったりできます。
合っているかどうか分からない自分による確認を適当な場所で公開しておけば、誤りを指摘してもらったり、独立に同じ結果を得た人に大丈夫そうだと教えてもらったりできます。
46
#統計 実際には、大っぴらに自分の結果を公開したおかげで、自分自身で誤りを見つけることが多い。場合によっては数年後になる場合もあるが、それも仕方がない。
誤りの指摘は具体的なものがありがたいです。誤りであることの確認のために必要な計算例をコード込みで示してもらえるとベスト。
誤りの指摘は具体的なものがありがたいです。誤りであることの確認のために必要な計算例をコード込みで示してもらえるとベスト。
47
#統計 偉い先生や普及している教科書の権威に頼って間違ってしまうことは科学的にとても恥ずかしいことだと思いますが、全部自分で考え直した上で間違うのであれば普通のことなので大して恥ずかしくない。
こういう価値観を持つ仲間が増えるとうれしいです。
こういう価値観を持つ仲間が増えるとうれしいです。