#統計...

黒木玄 Gen Kuroki@genkuroki
62 views
Mar 03, 2025
~1 min read
Advertisement
1
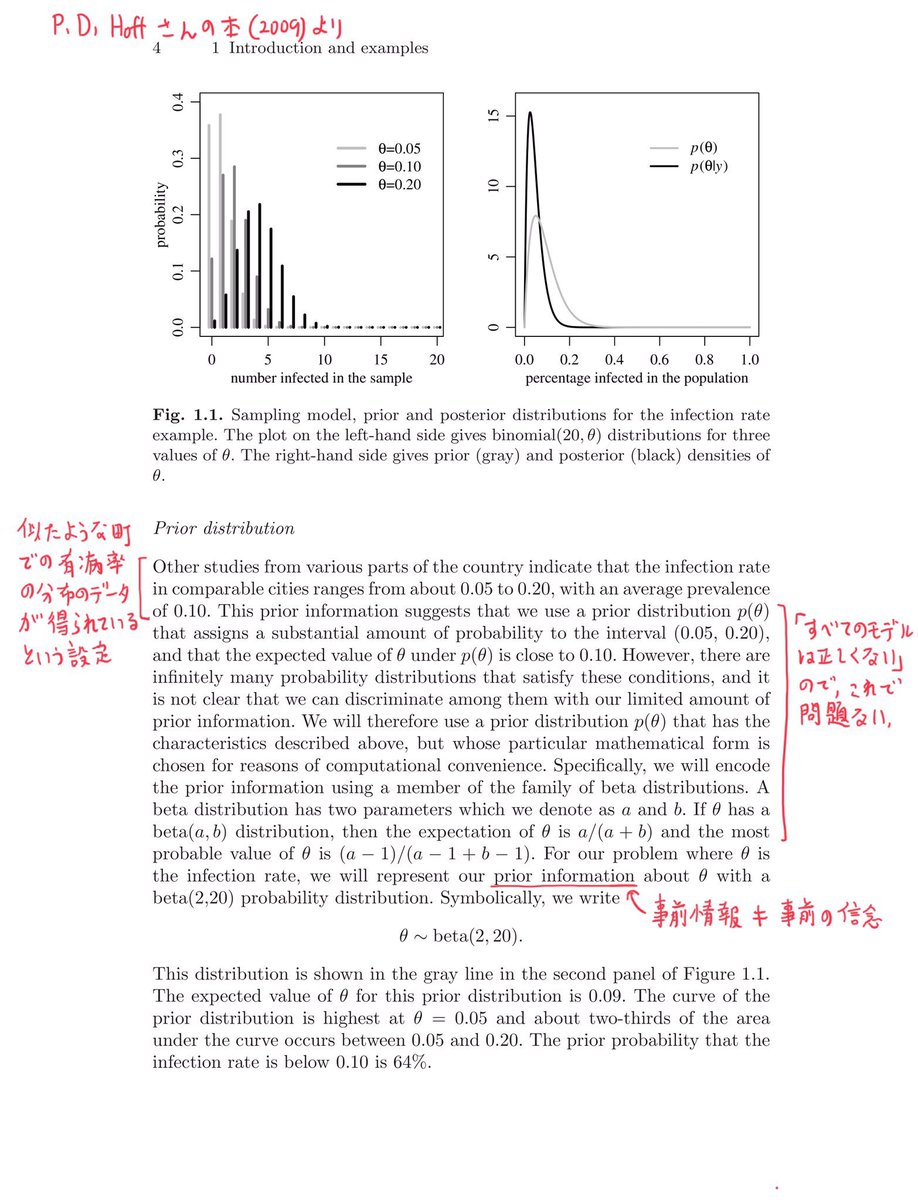
#統計 P.D.Hoffさんの本(なぜか『標準ベイズ統計学』という挑発的な題で翻訳された)からの非ベイズ的方法との比較の節の引用。赤字は私によるコメント。
この部分はひどくミスリーディングなので、この本を読む人は騙されないように注意した方がよいと思いました。
よりにもよってWaldの信頼区間!😱
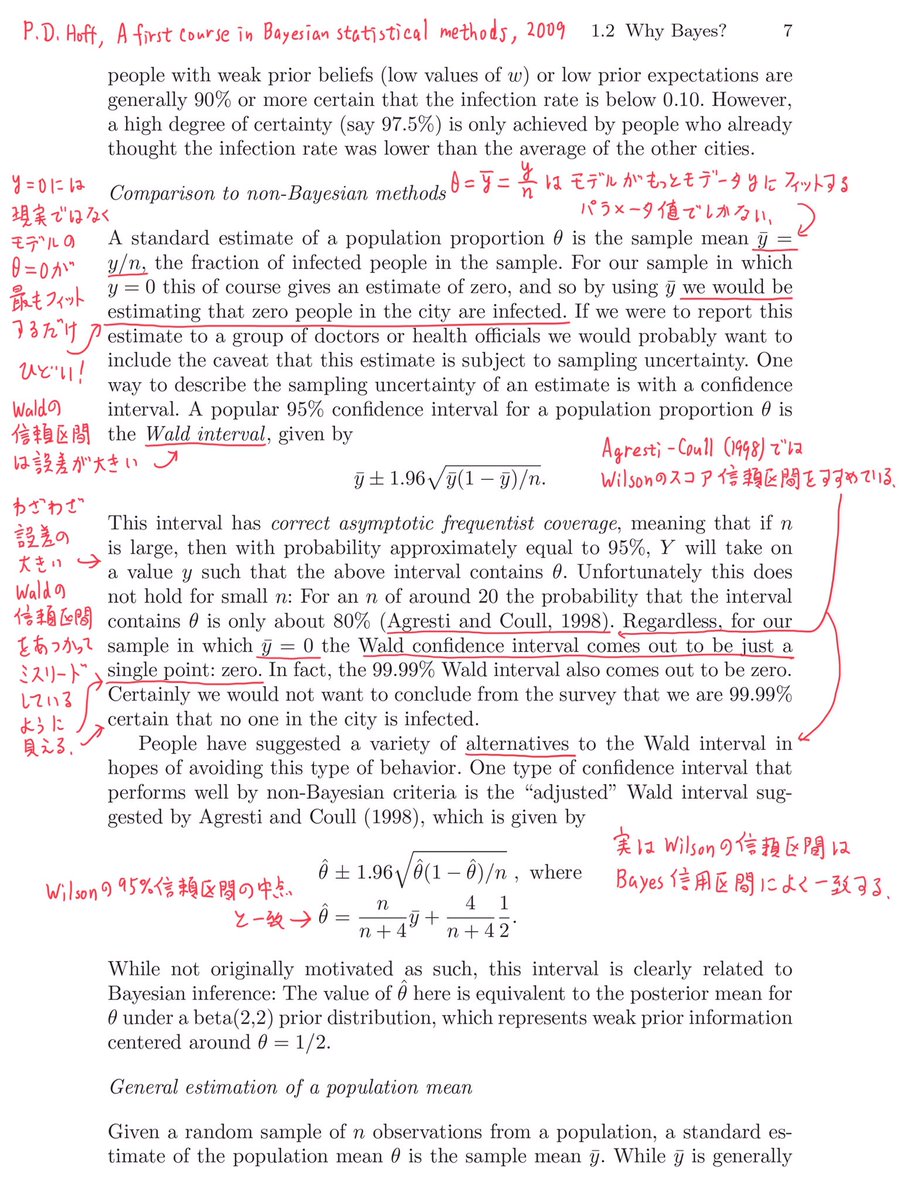
この部分はひどくミスリーディングなので、この本を読む人は騙されないように注意した方がよいと思いました。
よりにもよってWaldの信頼区間!😱
黒木玄 Gen Kuroki@genkuroki
#統計 こういうことを知っているのに、信頼区間が現実の何かの値の区間であるかのように説明する人達を放置しておくと、専門家は誤解していないが、理系高学歴者も含む多くの一般市民は誤解したままになるという、社会的に非常によろしくない状況が維持され続けることになると思いました。
2
#統計 n人中0人というデータから、割合パラメータθの推定値を0/n=0とすることの解釈。これは最尤推定値。
⭕️正しい解釈:n人中0人というデータに最もモデルがフィットする割合パラメータ値は0である。
❌現実の割合を0だと推定した。
モデルと現実を混同することは典型的に非科学的です。
⭕️正しい解釈:n人中0人というデータに最もモデルがフィットする割合パラメータ値は0である。
❌現実の割合を0だと推定した。
モデルと現実を混同することは典型的に非科学的です。
3
#統計 尤度は単にモデルのデータへのフィッティングの度合いの指標に過ぎなかったことを思い出しましょう。
n人中感染者は0人というデータから尤度最大化で求めた割合の推定値0/n=0は、単にモデルがデータに最も適合するパラメータ値を求めただけで、現実の感染者の割合を求めているのではないです。
n人中感染者は0人というデータから尤度最大化で求めた割合の推定値0/n=0は、単にモデルがデータに最も適合するパラメータ値を求めただけで、現実の感染者の割合を求めているのではないです。
4
#統計 こういう尤度の定義と意味に戻れば当たり前の話を蔑ろにするから、添付画像に引用した部分のようなおかしな説明になってしまうのです。
尤度は決して「もっともらしさ」ではありません。
モデルのデータの数値への適合度の指標の1つでしかない。
尤度は決して「もっともらしさ」ではありません。
モデルのデータの数値への適合度の指標の1つでしかない。
5
#統計 非ベイズの代表例としてWaldの信頼区間を出して来たのもかなり酷い。その理由:
* Waldの信頼区間は二項分布モデルでの信頼区間の中では特に性質が悪い(有名)。
* Agresti-Coull(1998)ではWilsonのスコア信頼区間を勧めている。添付画像②
* Wilsonの信頼区間とBayes信用区間は非常に近い。

* Waldの信頼区間は二項分布モデルでの信頼区間の中では特に性質が悪い(有名)。
* Agresti-Coull(1998)ではWilsonのスコア信頼区間を勧めている。添付画像②
* Wilsonの信頼区間とBayes信用区間は非常に近い。
6
#統計 非ベイズ的方法との比較で、引用しているAgresti-Coull(1998)でお勧めになっているWilsonのスコア信頼区間を扱わずに、誤差の大きなWaldの信頼区間の誰も使っていない補正を取り上げていることが不可解に見える理由は添付画像を見れば一目でわかります!続く
github.com/genkuroki/publ…
github.com/genkuroki/publ…
7
#統計 添付画像は二項分布モデルでのP値函数のプロットです。
ベイズ信用区間も区間推定の一種なので、対応するP値函数を定義できます。それがグラフ中の橙色のdashdot line.
WilsonとBayesianがほぼぴったり一致しています!
補正されたWaldとの違いは非常に大きい。
github.com/genkuroki/publ…
ベイズ信用区間も区間推定の一種なので、対応するP値函数を定義できます。それがグラフ中の橙色のdashdot line.
WilsonとBayesianがほぼぴったり一致しています!
補正されたWaldとの違いは非常に大きい。
github.com/genkuroki/publ…
8
#統計 このように、ベイズ統計との一致について印象的で、参照している文献も勧めているWilsonのスコア信頼区間を取り上げずに、誤差が大きいことが知られているWaldの信頼区間を取り上げ、さらに全然普及していないその補正を取り上げて、ベイズ統計と関連付けている。
物凄いバイアスを感じます。
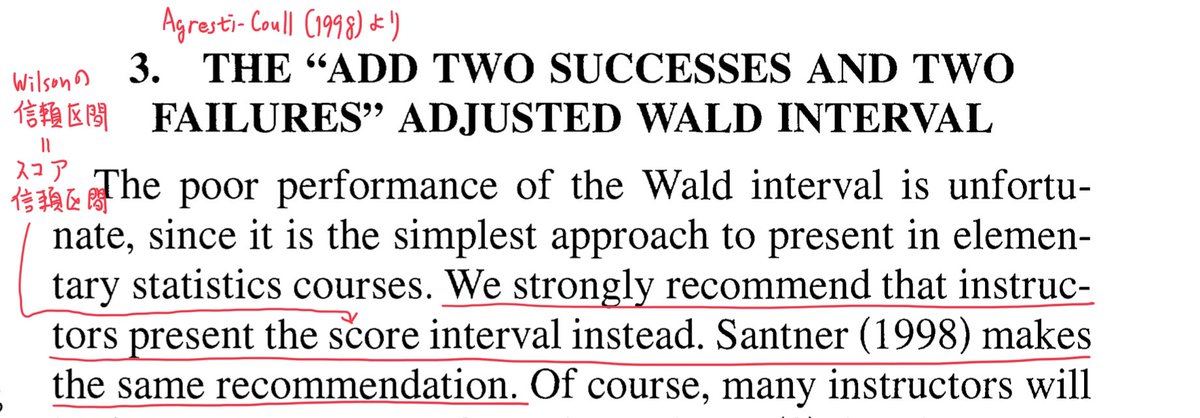

物凄いバイアスを感じます。
9
#統計 以下のようなことをやっているように見える!😱
* 誤差の大きなWaldの信頼区間を目立つように取り上げ、非ベイズ的方法に問題があることを印象付けようとしている。
* その非ベイズ的方法の補正方法がベイズ的な方法になっていることに言及し、ベイズ的方法の優位性を印象付けようとしている。
* 誤差の大きなWaldの信頼区間を目立つように取り上げ、非ベイズ的方法に問題があることを印象付けようとしている。
* その非ベイズ的方法の補正方法がベイズ的な方法になっていることに言及し、ベイズ的方法の優位性を印象付けようとしている。
10
#統計 しかし、R言語のprop.testで採用されているWilsonのスコア信頼区間(ただしcorrest=Fで連続性補正はオフにすること!)が、ベイズ的な信用区間に非常によく一致しており、これがダメなら、ベイズ統計もダメだということになります。
方法の選択はトレーフォオフの問題でしかない。
方法の選択はトレーフォオフの問題でしかない。
11
#統計 こういうクォリティの「非ベイズ的方法との比較」が翻訳されて普及してしまうことは、我々の社会にとって損失になるのではないかと思いました。
妙なバイアスをかけずに、比較すれば面白い話になるし、実用的な知識にもなるのに困ったことだと思います。

妙なバイアスをかけずに、比較すれば面白い話になるし、実用的な知識にもなるのに困ったことだと思います。
12
2つ前のツイートの訂正
❌correst=F
⭕️correct=F
この連続性補正がデフォルトでオンになっている仕様の普及はかなり困ったことだと個人的に思っています。
連続性補正を入れて使うくらいなら、確率を正確に計算する方法を使った方がお得だと思い。
Agresti-Coull(1998)で勧めているのも補正無版。
❌correst=F
⭕️correct=F
この連続性補正がデフォルトでオンになっている仕様の普及はかなり困ったことだと個人的に思っています。
連続性補正を入れて使うくらいなら、確率を正確に計算する方法を使った方がお得だと思い。
Agresti-Coull(1998)で勧めているのも補正無版。
13
14
#統計 P値函数と信頼区間の関係については以下のリンク先を参照。
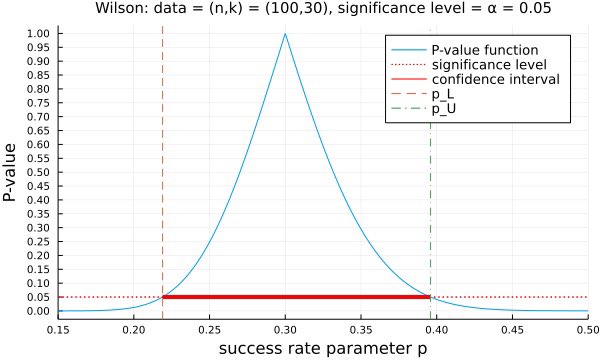
黒木玄 Gen Kuroki@genkuroki
#統計 P値函数と95%信頼区間の関係
P値函数経由での信頼区間の視覚的把握は極めて易しい。
これを理解した人が信頼区間について誤解することは難しいように思われる。
信頼区間の上には「とんがり帽子」がのっかっています(笑)
Rothmanさん達の教科書経由で普及すると良いと思う。
P値函数経由での信頼区間の視覚的把握は極めて易しい。
これを理解した人が信頼区間について誤解することは難しいように思われる。
信頼区間の上には「とんがり帽子」がのっかっています(笑)
Rothmanさん達の教科書経由で普及すると良いと思う。
15
相互リンク
16
#統計
各種P値函数の実装は添付画像の通り。
WaldよりもWilson (score)の方がシンプルまたは同じ程度。
信頼区間を計算する函数の実装では、Wilsonの側は二次方程式を解く必要が生じるので、Waldよりも少しだけ面倒になる。
github.com/genkuroki/publ…

各種P値函数の実装は添付画像の通り。
WaldよりもWilson (score)の方がシンプルまたは同じ程度。
信頼区間を計算する函数の実装では、Wilsonの側は二次方程式を解く必要が生じるので、Waldよりも少しだけ面倒になる。
github.com/genkuroki/publ…
黒木玄 Gen Kuroki@genkuroki
#統計 添付画像は二項分布モデルでのP値函数のプロットです。
ベイズ信用区間も区間推定の一種なので、対応するP値函数を定義できます。それがグラフ中の橙色のdashdot line.
WilsonとBayesianがほぼぴったり一致しています!
補正されたWaldとの違いは非常に大きい。
github.com/genkuroki/publ…
ベイズ信用区間も区間推定の一種なので、対応するP値函数を定義できます。それがグラフ中の橙色のdashdot line.
WilsonとBayesianがほぼぴったり一致しています!
補正されたWaldとの違いは非常に大きい。
github.com/genkuroki/publ…
17
#統計 Waldの信頼区間は「n人中y人」についてy/nが0と1から離れている場合にのみ有効な近似法を使っていることはよく知られているのに、y=0だとWaldの信頼区間が0の一点になってしまうことをわざわざ述べている。
狙って誤誘導している、または、入門レベルの知識が足りないのどちらかに見える。続く
狙って誤誘導している、または、入門レベルの知識が足りないのどちらかに見える。続く
18
#統計 添付画像は「n=20人中0人」というデータに対応するP値函数のプロット。Wilsonのスコア信頼区間を与えるP値函数の台はθ=0の一点に縮まっていない。Waldの信頼区間を与えるP値函数はθ=0で1になり、0<θ≤1で0になる。
本で引用されているAgresti-Coull 1998もWilsonの信頼区間を勧めている。
本で引用されているAgresti-Coull 1998もWilsonの信頼区間を勧めている。
19
#統計 件の本の件の部分で引用されているAgresti-Coull 1998では、2次方程式を解いて求めるWilsonの信頼区間が優れていることを強調した上で、シンプルに計算できるWaldの信頼区間の補正を
中点(両端の値の平均)がWilsonの信頼区間と一致する
という条件でシンプルに定義しています。続く
中点(両端の値の平均)がWilsonの信頼区間と一致する
という条件でシンプルに定義しています。続く
20
#統計 z = quantile(Normal(0,1), 1-α/2)とおいたとき、n回中k回成功というデータに関するWilsonの信頼区間の中点は、
p̃ = (k + z²/2)/(n + z²) = mean(Beta(k+z²/2, n-k+z²/2))
になります。続く
p̃ = (k + z²/2)/(n + z²) = mean(Beta(k+z²/2, n-k+z²/2))
になります。続く
21
#統計 だから、αごとに、最尤推定p̂=k/nの代わりに、事前分布Beta(z²/2,z²/2)の事後分布の期待値p̃=(k+z²/2)/(n+z²)を使うように、Waldの信頼区間を修正すれば、修正版Waldの信頼区間(左右対称になる)の中点をWilsonの信頼区間の中点に一致させることができます。
α=5%ならz²/2≈2でシンプル。
続く
α=5%ならz²/2≈2でシンプル。
続く
22
#統計 通常のケースでこの修正版Waldの信頼区間を使いたい人はいないと思います。Wilsonの信頼区間をそのまま使った方がよいと普通は考える。
しかし、k/nが0または1に近いときに暗算で使える簡便法としては意味を持つかもしれない。
しかし、k/nが0または1に近いときに暗算で使える簡便法としては意味を持つかもしれない。
23
#統計 Wilsonの信頼区間はベイズ統計での信用区間に非常に近くなり、件の本が件の部分で引用している論文Agresti-Coull 1998でも勧めている。その論文では、Waldの信頼区間は非ベイズ的方法としても性能が低いので、シンプルな計算法である利点を殺さない修正法を考えた。続く
24
#統計 大部分の普通の一版読者は、二項分布モデルでの信頼区間には同値でない構成法が沢山あって、各々の構成法ごとにどのような利点と欠点があるかを知らないだろうし、引用されている論文も見ないと思います。
その結果、まんまと誤誘導されてしまうことになる。
そうならないように注意が必要。
その結果、まんまと誤誘導されてしまうことになる。
そうならないように注意が必要。
25
#統計 現実はさらに厳しくて、このスレッドのようにこれ以上ないくらい詳しく問題点を指摘しても、それを理解できる人は少数派で、このスレッドが目にとまっても、自分が誤誘導されているかどうかもわからないまま終わり、素晴らしい内容だったと思い続けるかもしれない。
26
訂正
❌一版読者
⭕️一般読者
書籍だけではなく、読者の側にも第一版、第二版、…とかあったらちょっと面白いかも。
❌一版読者
⭕️一般読者
書籍だけではなく、読者の側にも第一版、第二版、…とかあったらちょっと面白いかも。
27
#統計 『標準ベイズ統計学』の試し読み部分 asakura.tameshiyo.me/9784254122671 を確認してみた。
添付画像①は試し読み部分のスクショにコメントを入れたもので、②は原著の対応部分。
prior informationを「事前の信念」と訳していますが、これって大丈夫なのかな?
悪質な誤誘導になりかねない部分!続く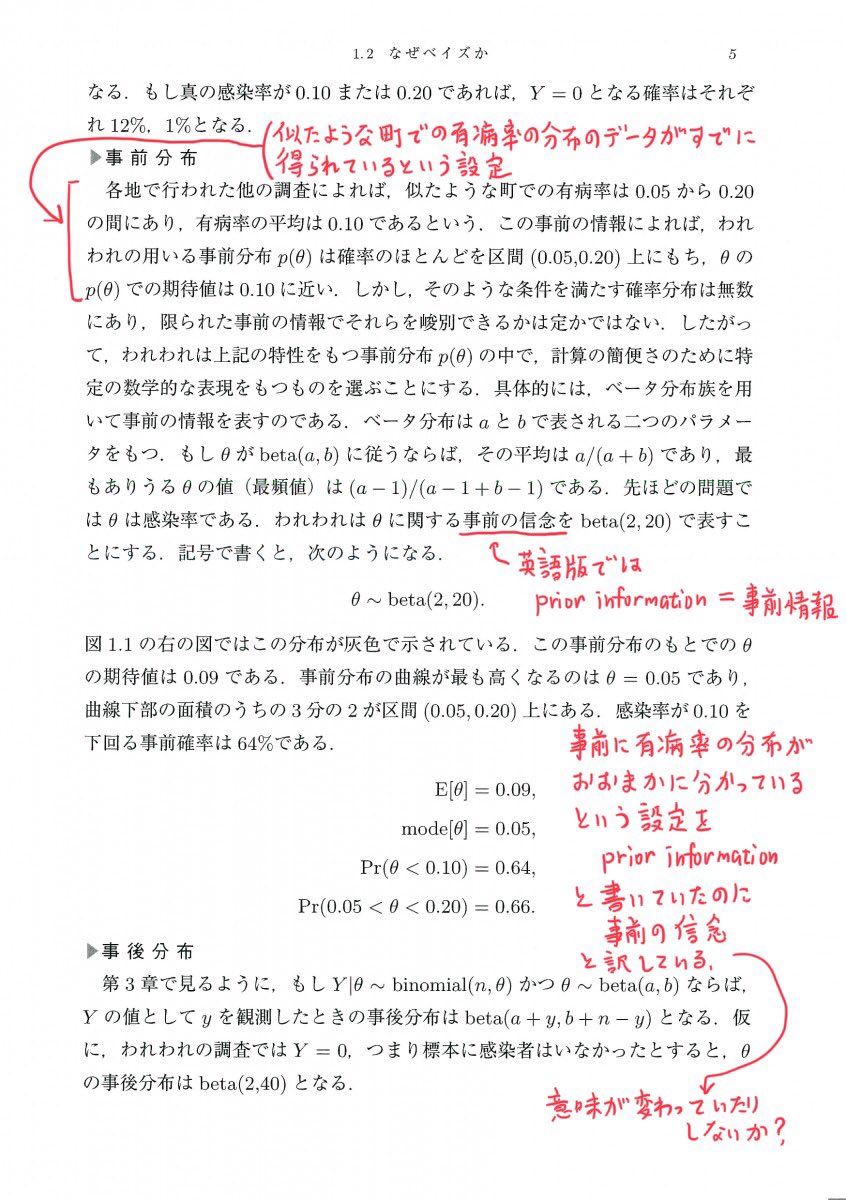

添付画像①は試し読み部分のスクショにコメントを入れたもので、②は原著の対応部分。
prior informationを「事前の信念」と訳していますが、これって大丈夫なのかな?
悪質な誤誘導になりかねない部分!続く
28
#統計 本のその部分では、
似たような町での有病率のデータがすでにある
という設定。その事前情報に基いて、町ごとの有病率のばらつき具合の分布がおおまかに分かっているので、「すべてのモデルは正しくない」という考え方に基いて大雑把にベータ分布で推定した状況ともみなせる。続く
似たような町での有病率のデータがすでにある
という設定。その事前情報に基いて、町ごとの有病率のばらつき具合の分布がおおまかに分かっているので、「すべてのモデルは正しくない」という考え方に基いて大雑把にベータ分布で推定した状況ともみなせる。続く
29
#統計 そうやって、得た有病率の分布をモデルに組み込んで、
異なる有病率を持つ町達から無作為に1つの町を選び、
選んだ町から無作為にn人選んで感染しているかを調べた
というモデルで有病率の分布の推定を普通に(ベイズ統計と言う必要無しに)行なっている状況だとみなせます。続く
異なる有病率を持つ町達から無作為に1つの町を選び、
選んだ町から無作為にn人選んで感染しているかを調べた
というモデルで有病率の分布の推定を普通に(ベイズ統計と言う必要無しに)行なっている状況だとみなせます。続く
30
#統計 似たような町での有病率のデータを使って、ざくっとベータ分布で有病率の分布を推定し、それをモデルに組み込んだとみなせる。
これを「事前情報(prior information)をベータ分布で表す」と説明しているのに、「事前の信念をベータ分布で表す」と翻訳すると意味が変わってしまうように思える。
これを「事前情報(prior information)をベータ分布で表す」と説明しているのに、「事前の信念をベータ分布で表す」と翻訳すると意味が変わってしまうように思える。
31
#統計 この辺は、ベイズ統計を「データによる信念の更新」で説明しなければダメだと考えている人達(かけ算の順序は単価×数量でなければいけないと考えている人達に似ている)によるベイズ統計のおかしな説明の仕方との関連で、結構重要なポイントになります。続く
32
#統計
有病率の分布が~であるような町達の集団から町を無作為に選び、選んだ町から無作為抽出で選んだ人について感染状況を調べた
という内容のモデル(≠現実)による推定だともみなせることを、
データによる信念の更新
とみなさなければいけないかのように誘導することは、悪質な誤誘導です。
有病率の分布が~であるような町達の集団から町を無作為に選び、選んだ町から無作為抽出で選んだ人について感染状況を調べた
という内容のモデル(≠現実)による推定だともみなせることを、
データによる信念の更新
とみなさなければいけないかのように誘導することは、悪質な誤誘導です。
33
#統計
有病率の分布が~であるような町達の集団から町を無作為に選び、選んだ町から無作為抽出で選んだ人について感染状況を調べた
という内容のモデル(≠現実)による当該の町の有病率の分布の推定は、大学入試にも出るような条件付き確率の単純な応用に過ぎません。信念の更新とみなす必要はない。
有病率の分布が~であるような町達の集団から町を無作為に選び、選んだ町から無作為抽出で選んだ人について感染状況を調べた
という内容のモデル(≠現実)による当該の町の有病率の分布の推定は、大学入試にも出るような条件付き確率の単純な応用に過ぎません。信念の更新とみなす必要はない。
34
#統計 もちろん、信念の更新とみなしたい人はみなしてもよいのですが(単価×数量の順序でかけ算の式を書いてもよいことと似ている)、レトリックを駆使して、そうしなければいけないかのように読者を誘導することは有害であり、やっちゃいけないことだと思います。
35
#統計 この辺の話題は、条件付き確率の定義を知っていればただちに得られる自明でつまらな結果であるベイズの定理について、無用なおまけをつけてあたかも深淵な定理であるかのように見せる解説の普及という問題とも関係があります。
そういう杜撰な解説が「標準」になってしまっているという問題。
そういう杜撰な解説が「標準」になってしまっているという問題。
36
#統計 以前、割合について習った後のとある小学生に添付画像の問題をやらせてみました。ただし、確率の意味は割合と同じだと説明した。
すると予想通り解けました。
これ、割合について習った後の小学生が割合について理解しているかの確認にはちょうどよい問題だと思う。役に立つ知識にもなるし!
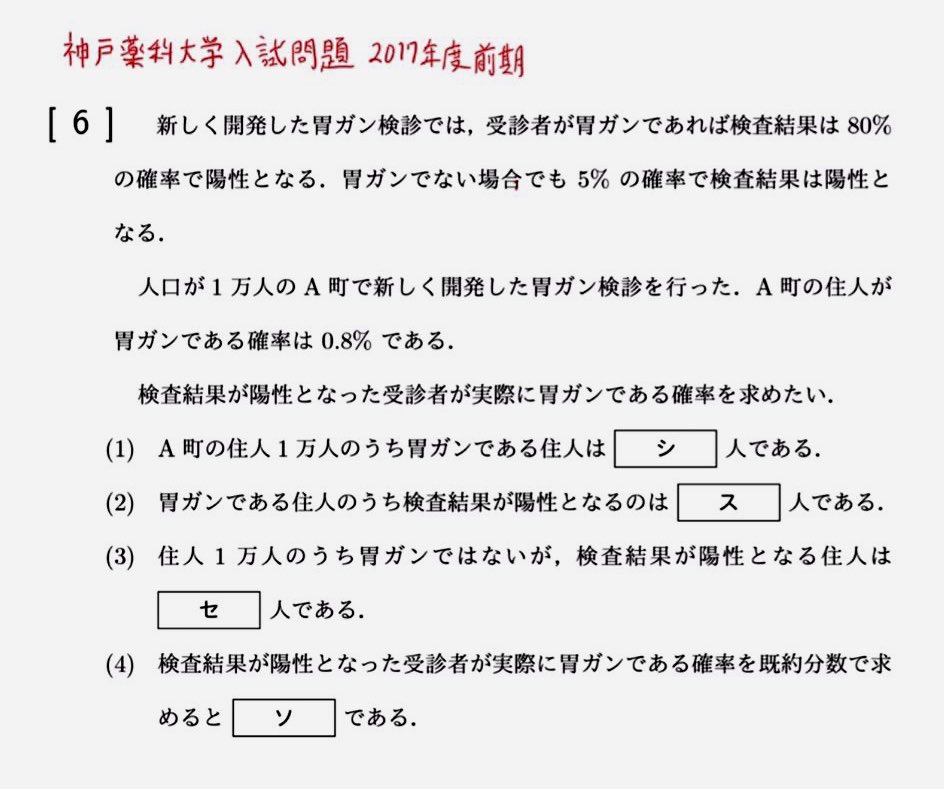
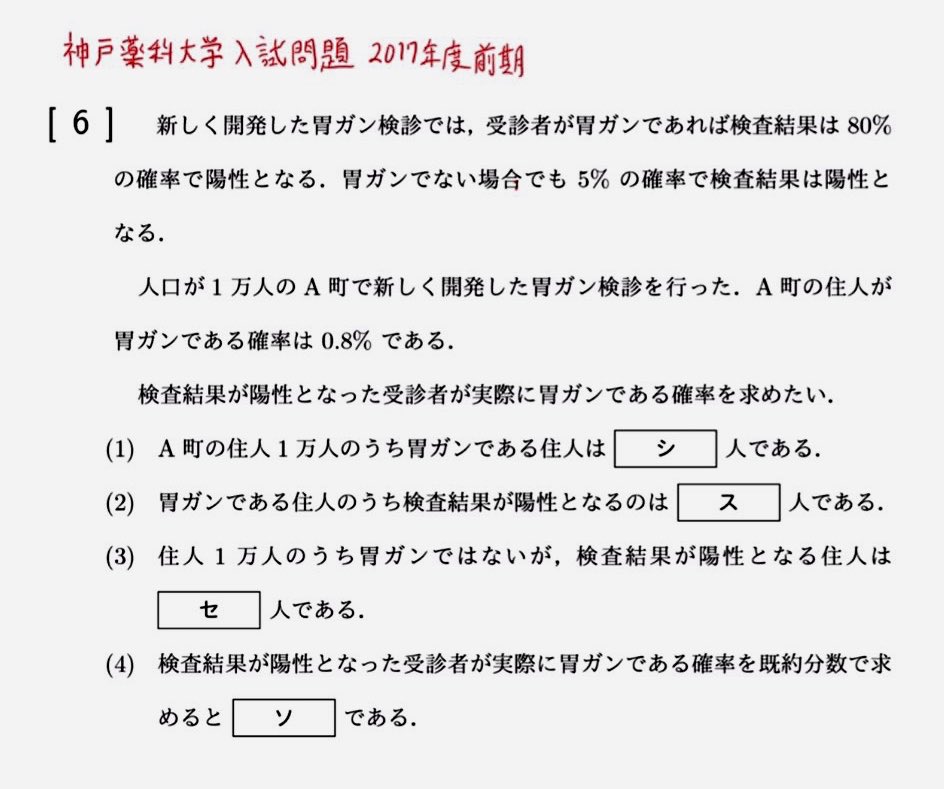
すると予想通り解けました。
これ、割合について習った後の小学生が割合について理解しているかの確認にはちょうどよい問題だと思う。役に立つ知識にもなるし!
黒木玄 Gen Kuroki@genkuroki
#統計 しばらく前に某小学生に添付画像の問題(適当な仮定のもとで検査陽性となった人が実際に胃ガンである確率を求める問題)を解かせてみました。「確率」などの意味はその場で口頭で説明した。
この問題、小学生でも解けることが分かりました。
要するに陽性的中率の話は小学生レベルの話題。
この問題、小学生でも解けることが分かりました。
要するに陽性的中率の話は小学生レベルの話題。
37
#統計 割合を習った後のとある小学生が解けた問題と、少し上の方で触れた町の有病率の分布の推定は本質的に同じ問題です。
有病率の分布の方はベータ分布なんかが出て来て各数学的パーツは難しくなっていますが、考え方的には何も難しくなっていない。
そういう扱い方を積極的にした方がよい。
有病率の分布の方はベータ分布なんかが出て来て各数学的パーツは難しくなっていますが、考え方的には何も難しくなっていない。
そういう扱い方を積極的にした方がよい。
38
#統計 この辺に関する高等教育は結構まずいことになっていて、
⭕️小学生レベルの問題
に過ぎないのに、
❌ベイズの定理という深淵な定理を使って解く問題
という扱いをされている場合が結構あるように思われます。
こういう問題が発生するのは「標準」的なベイズ統計の解説が伝統的に酷いから。
⭕️小学生レベルの問題
に過ぎないのに、
❌ベイズの定理という深淵な定理を使って解く問題
という扱いをされている場合が結構あるように思われます。
こういう問題が発生するのは「標準」的なベイズ統計の解説が伝統的に酷いから。
39
#統計 添付画像①は翻訳版試し読み asakura.tameshiyo.me/9784254122671 より。②は原書の対応部分。
「用語の定義が甘い」が具体的にどういうことなのかは分かりませんが、原書のprior informationを必然性抜きに「事前の信念」に置き換えている部分があったので、原書と比較が必要かもしれないと思いました。


「用語の定義が甘い」が具体的にどういうことなのかは分かりませんが、原書のprior informationを必然性抜きに「事前の信念」に置き換えている部分があったので、原書と比較が必要かもしれないと思いました。
Yuta Nonomiya@NonoStatMD
標準ベイズ統計学ちょっと読んでみたのですが、読みにくいですね。所々説明がはしょられてて論証が甘いというか用語の定義が甘いというか...はしょるならはしょるでどの知識は前提としているとか前書きにでも書いといて欲しいところです。初学者には荷が重そう。
※2章まで読んだ感想です。
※2章まで読んだ感想です。
40
#統計 「信念」は主観ベイズ主義の文脈では要注意なテクニカルワードなので、翻訳するときに information を勝手に「信念」に置き換えるのはやめて欲しいと思いました。
これに気付いて私は翻訳版の購入を見送りました。
悪質な誤誘導になりかねない。
これに気付いて私は翻訳版の購入を見送りました。
悪質な誤誘導になりかねない。
黒木玄 Gen Kuroki@genkuroki
#統計 『標準ベイズ統計学』の試し読み部分 asakura.tameshiyo.me/9784254122671 を確認してみた。
添付画像①は試し読み部分のスクショにコメントを入れたもので、②は原著の対応部分。
prior informationを「事前の信念」と訳していますが、これって大丈夫なのかな?
悪質な誤誘導になりかねない部分!続く
添付画像①は試し読み部分のスクショにコメントを入れたもので、②は原著の対応部分。
prior informationを「事前の信念」と訳していますが、これって大丈夫なのかな?
悪質な誤誘導になりかねない部分!続く
41
#統計 ベイズ統計入門の解説の仕方のサンプルとして検討したのですが、試し読みの部分がちょうどそういうサンプルにもなっており、原書と比較したら、翻訳版を引用して論争的な話をするのは非常に危険だと気付けた。
prior informationと「事前の信念」では入門的解説として印象がまったく違う。
prior informationと「事前の信念」では入門的解説として印象がまったく違う。
42
#統計 よくある「頻度論vs.ベイズ主義」の話で、頻度論者が事前分布を嫌うのは、証拠に欠けた事前確率を前提にすることであり、証拠があるprior informationを統計モデルに組み込むことであれば頻度論者も「当然そうする」ということになると思います。informationと「信念」では印象が違い過ぎ。
43
#統計 ベイズ統計の面白い所の1つは、データによって根拠付けられた事前分布でなくても、予測誤差を減らすというような理由で事前分布を利用できる場合があることです。
事前分布という自由度が増えたメリットは結構大きい。
詳しくは渡辺澄夫『ベイズ統計の理論と方法』の第4章を参照。
事前分布という自由度が増えたメリットは結構大きい。
詳しくは渡辺澄夫『ベイズ統計の理論と方法』の第4章を参照。
44
#統計 Waldの信頼区間を「上手に利用」しているように見える点はかなりの悪印象。
ベイズ統計の入門的な説明部分にはおかしな説明が普遍的に観察される。
テクニカルな話だけで済ませてくれた方が多分好印象になる。
しかし、数学的能力のせいで多くの人達は問題のある解説を鵜呑みして終わりそう。
ベイズ統計の入門的な説明部分にはおかしな説明が普遍的に観察される。
テクニカルな話だけで済ませてくれた方が多分好印象になる。
しかし、数学的能力のせいで多くの人達は問題のある解説を鵜呑みして終わりそう。
黒木玄 Gen Kuroki@genkuroki
#統計 P.D.Hoffさんの本(なぜか『標準ベイズ統計学』という挑発的な題で翻訳された)からの非ベイズ的方法との比較の節の引用。赤字は私によるコメント。
この部分はひどくミスリーディングなので、この本を読む人は騙されないように注意した方がよいと思いました。
よりにもよってWaldの信頼区間!😱
この部分はひどくミスリーディングなので、この本を読む人は騙されないように注意した方がよいと思いました。
よりにもよってWaldの信頼区間!😱
45
#統計 このスレッドの内容は、「ベイズ統計入門のための解説としてどうか?」に全振りする偏った内容なので注意。
テクニカルな事柄に関する解説の仕方については一切触れていない。
テクニカルな事柄に関する解説の仕方については一切触れていない。
46
#統計 pに関するWaldの95%信頼区間の定義不等式は
|k - np|/√(n(k/n)(1-k/n)) ≤ 1.96.
分布の標準誤差がデータ「n回中k回」から推定されている。
より良い性質を持つWilsonの95%信頼区間の定義不等式は
|k - np|/√(np(1-p)) ≤ 1.96.
pに関する2次不等式。
高校で2次不等式について習う。
|k - np|/√(n(k/n)(1-k/n)) ≤ 1.96.
分布の標準誤差がデータ「n回中k回」から推定されている。
より良い性質を持つWilsonの95%信頼区間の定義不等式は
|k - np|/√(np(1-p)) ≤ 1.96.
pに関する2次不等式。
高校で2次不等式について習う。
47
#統計 |k - np|/√(n(k/n)(1-k/n)) ≤ 1.96 で定義されるWaldの95%信頼区間はデータ「n回中k回」のkが0またはnのとき破綻する。そういう場合をわざわざ持ち出すのはちょっとアレ過ぎ。
pについてWilsonの95%信頼区間 |k - np|/√(np(1-p)) ≤ 1.96 が良い性質を持つことを、コンピュータで確認可能。
pについてWilsonの95%信頼区間 |k - np|/√(np(1-p)) ≤ 1.96 が良い性質を持つことを、コンピュータで確認可能。
48
#統計 Waldの信頼区間は単に性質が悪い(しかし使える場合が多く、計算も簡単)なだけではなく、信頼区間の概念を誤解させる原因になっている可能性もあります。
例の佐藤俊哉さんも動画中でそう言っている。
youtu.be/vz9cZnB1d1c
例の佐藤俊哉さんも動画中でそう言っている。
youtu.be/vz9cZnB1d1c
49
#統計 ただし、シンプルなモデルでは、通常の95%信頼区間とベイズ版95%信用区間は数学的必然性によって近似的に一致するので、
⭕️ベイズ統計の事後分布で測った(ベイズ版ではない通常の)95%信頼区間にパラメータθが含まれる確率は約95%になる
という主張は正しいです(笑)。
⭕️ベイズ統計の事後分布で測った(ベイズ版ではない通常の)95%信頼区間にパラメータθが含まれる確率は約95%になる
という主張は正しいです(笑)。
50
#統計
⭕️ベイズ統計の事後分布で測った(ベイズ版ではない通常の)95%信頼区間にパラメータθが含まれる確率は約95%になる
はパラメータθが事後分布に従う確率変数であるという設定で正しい。
こういう数学的事実に反する解説は単純に間違っています。多くの立派な人達がおかしなことを言っている話。
⭕️ベイズ統計の事後分布で測った(ベイズ版ではない通常の)95%信頼区間にパラメータθが含まれる確率は約95%になる
はパラメータθが事後分布に従う確率変数であるという設定で正しい。
こういう数学的事実に反する解説は単純に間違っています。多くの立派な人達がおかしなことを言っている話。
51
#統計 定義もモチベーションも全く異なる 2つの値が数学的必然性によって近似的に一致することがある、という解析学的事実に無頓着で、定義やモチベーション(場合によっては主義)の違いのみに注目して正しい議論をできると思っている考えが足りない人達の多くが失敗している。
52
#統計 #超算数 定義が異なる 2つの量が数学的必然性によって近似的に一致する場合に、
❌定義が異なるので違う量であり、解釈も異なるという考え方にこだわり続けること
は
❌3×4の定義は3+3+3+3であり、4+4+4ではないので、3×4を4+4+4だと解釈すると誤りになる。
という誤解と同様の誤りになる。
❌定義が異なるので違う量であり、解釈も異なるという考え方にこだわり続けること
は
❌3×4の定義は3+3+3+3であり、4+4+4ではないので、3×4を4+4+4だと解釈すると誤りになる。
という誤解と同様の誤りになる。
53
関連